🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページの節へ直接飛べる索引。 上のタグは検索の手がかり、 下のチップは本文の該当節へのリンク。
💡 30秒で分かる結論
🍰 まずはやさしく
最高の組み合わせを探すパズルのようなものです。
一番いい答えを効率よく見つけるために使います。
部活のシフト表をうまく決める時に役立ちます。
この章では結論と注意点を短くまとめます。
組合せ最適化は、 離散的な選択肢の組合せの中から目的関数を最適化する変数を見つける問題群。
- 典型問題:巡回セールスマン(TSP)、 ナップサック、 割当、 シフト編成
- 難しさ:多くが NP 困難(厳密解が指数時間)
- 手法:整数計画(IP)、 動的計画、 メタヒューリスティクス、 量子
- 道具:PuLP(Python)、 OR-Tools、 Gurobi、 CPLEX
- 実務:物流・在庫・スケジュール最適化
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 「全探索すれば良い」/LP 緩和の鵜呑み/ヒューリスティクスの局所解 には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「組合せ最適化」はどんな場面で出てくる?
🍰 まずはやさしく
いろいろな道具を組み合わせて使う技術です。
データ分析の現場で役立つ考え方を知るためです。
スマホのアプリが最適な設定を探す時に似ています。
どんな場面でこの道具を使うのかを解説します。
本サイトのテーマでは直接登場しませんが、 ML の特徴量選択・ハイパラ探索も組合せ最適化の親戚。 実務 DS では避けて通れない領域。
SSDSE-B-2026 の 47 都道府県は、 組合せ最適化の練習台としてちょうどよい大きさである。 5 県を選ぶだけなら C(47,5) ≈ 153 万通りで全部調べられるが、 10 県なら約 52 億通り、 47 県庁所在地を回る順番は 46!/2 ≈ 2.8×1056 通りになり、 全部調べる方法は使えなくなる。 この「候補が急に増えて手に負えなくなる」境目を実データで体感するのがこのページの狙い。
🎨 直感で掴む
🍰 まずはやさしく
数ある選択肢から正解を選ぶゲームのようなものです。
全部を試すと時間がかかりすぎる問題を解くためです。
買い物で予算内に最高の品を選ぶ時に似ています。
直感的に理解するための具体例を紹介します。
「組合せ最適化」は SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に当てはめると、 47 都道府県から k 拠点を選ぶ施設配置問題 で具体化できます。 以下は実データを使った直感的理解の入口です。
- 「全パターン試したら良いが、 多すぎて時間が足りない」のが本質。 工夫が必要。
- 厳密解(最適)と近似解(実用十分)のトレードオフが核心。
- 問題構造が「凸」「劣モジュラ」「マトロイド」だと効率的アルゴリズムが存在することがある。
🎨 直感で掴む — 組合せ最適化 の本質
「離散的な選択肢の組み合わせから最適なものを選ぶ問題」。 たとえば SSDSE-B-2026 の 47 都道府県から「総人口(A1101)の合計が一定以下になるよう 10 県だけを選んで、 65 歳以上人口(A1303)を最大化する」というのは典型的な 0-1 ナップサック型の組合せ最適化。 全探索だと $\binom{47}{10} \approx 5.2\times 10^{9}$ 通りで非現実的。
🎮 触って理解する
組合せ最適化の代表例 巡回セールスマン問題 (TSP) を実際に触ってみましょう。 キャンバスの空白をクリック / タップして都市を配置し、 都市をドラッグして別の都市に重ねると巡回順序を入れ替えられます(総距離はリアルタイム更新)。 まず手で経路を短くしてみてから、 「最近傍法」→「2-opt 改善」→「総当たり (厳密解)」の順にボタンを押すと、 貪欲な構築 → 局所改善 → 厳密解 という組合せ最適化の典型的な戦略の違いが体感できます。 都市を増やすと「巡回路の総数」が爆発的に増える様子(組合せ爆発)にも注目してください。
この図から読み取れること(直感)
- 解は「連続量」ではなく「順列」。 微分してゼロと置く連続最適化と違い、 TSP の解空間は離散的な訪問順の集合で、 隣の解 (順序を少し入れ替えた解) に「なめらか」に移動できない。 これが組合せ最適化の本質的な難しさ。
- 巡回路の総数 (n−1)!/2 は階乗のスピードで爆発する。 10 都市で 181,440 通り、 15 都市で約 4.4×10¹⁰ 通り、 20 都市では約 6.1×10¹⁶ 通り。 都市を 1 つ足すたびに総数が約 n 倍になるので、 全列挙 (総当たり) はすぐ破綻する ── 上のデモが総当たりを 10 都市までに制限しているのはこのため。
- 「①最近傍法 → ②2-opt」の 2 段構えが実務の型。 最近傍法 (貪欲法) は一瞬で「そこそこの解」を作るが、 序盤の近視眼的な選択のツケで終盤に長いエッジが残りがち。 2-opt は経路の交差 (X 字) をほどく局所探索で、 交差が消えるだけで距離が目に見えて縮む。
- 2-opt が止まった解 = 局所最適 であって大域最適とは限らない。 ③の総当たりで厳密解を出し、 ギャップ表示を見比べると「近似解がどれくらい良いか」を定量的に確認できる (小規模ならギャップ 0% になることも多い)。
⚠️ この体験に潜む落とし穴
🚀 発展:厳密解と近似解のあいだ
- 分枝限定法 (Branch and Bound):総当たりの木を「この枝の下界がすでに現在の最良解より悪い」と分かった時点で刈り込む厳密解法。 LP 緩和 (本ページ「📐 定義・数式」参照) が下界を与える。 現代のソルバー (Gurobi・CPLEX・CBC) の中核で、 実用上は数百〜数千都市の TSP も厳密に解ける。
- 動的計画法 (Held–Karp):TSP を O(n²·2ⁿ) で解く。 (n−1)! よりは劇的に速いがそれでも指数時間 ── 25 都市程度が限界。 「部分問題の重複」を使う点で総当たりと厳密解法の中間に位置する。
- 近似アルゴリズム:距離が三角不等式を満たす TSP には、 最適解の 1.5 倍以内を数学的に保証する Christofides 法がある。 「保証つきの近似」は理論計算機科学の大きな成果。
- メタヒューリスティクス:焼きなまし法・遺伝的アルゴリズム・タブー探索など、 局所最適から抜け出す確率的戦略の総称 (メタヒューリスティクス参照)。 保証はないが大規模問題で「実用十分な解」を安定して出す。
- 個別問題への深掘り:巡回セールスマン問題 (TSP)・ナップサック問題の各ページで、 定式化と Python 実装をさらに詳しく扱う。 連続最適化との対比は数理最適化・最適化を参照。
📐 定義・数式
🍰 まずはやさしく
ルールを数式(数学の言葉)で表したものです。
誰が計算しても同じ答えが出るようにするためです。
テストの点数や時間を式で表す感覚に似ています。
正しい定義と計算のやり方を詳しく読みます。
やさしい説明で掴んだ感覚を、ここで 整数計画の一般形 の定義式に対応づけます。下の式は左辺 $\min_{\mathbf{x} \in \mathbb{Z}^n}\; c^\top \mathbf{x} \quad \text{s.t.}\quad A\mathbf{x} \le b, \;\; \mathbf{x} \ge 0$ が何で決まるかを右辺で書き下したもので、min(最小化) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
📐 数式または定義 — 組合せ最適化 の形式的表現
続いて 組合せ最適化 の厳密な定義に進みます。 数式が登場しますが、 「入力は何か、 出力は何か」を意識しながら読み、 47 都道府県から k 拠点を選ぶ施設配置問題 を実際に当てはめる準備をします。
📐 整数計画と LP 緩和の幾何学
整数計画問題 (IP) は線形計画 (LP) に「変数が整数」という制約が加わった形:
\[ \min c^\top x \quad \text{s.t.}\ Ax \le b,\ x \ge 0,\ x \in \mathbb{Z}^n \]
整数性制約 \(x \in \mathbb{Z}^n\) を外して連続的に解くのが LP 緩和。 緩和解 \(x^*_{\text{LP}}\) は IP の真の最適値の下界を与え、 B&B の枝刈り判定に使われる。
🔬 数式を言葉で読み解く: LP 緩和の意味
- \(c^\top x\): 最小化したいコスト関数(線形)
- \(Ax \le b\): 各行が 1 つの制約条件(資源上限など)
- \(x \in \mathbb{Z}^n\): 整数性制約。 これを外すと多面体内のどこでも OK になる
- LP 緩和の最適解は実行可能領域の頂点に必ずある(線形計画の基本性質)
- 整数解はその頂点の近くの格子点。 LP 解と整数解が一致する保証はない(整数性ギャップ)
SSDSE で整数計画: 県別配送センター配置
このコードでやること: SSDSE-B-2026 の人口を需要、 配送センターを最大 5 個設置できるとして、 各県をどのセンターに割り当てれば「センター数 × 固定費 + 距離 × 需要 × 輸送費」を最小化できるかを PuLP で解く。 これは uncapacitated facility location problem (UFLP) の典型。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import numpy as np # ── 距離行列 d をここで作る(このあとのブロックの dist と同じ作り方)── # 注意: SSDSE-B-2026 に緯度経度は無い。施設配置の解き方を見るための # 再現可能な「架空の座標」で、実在の位置関係ではない。 _rng0 = np.random.default_rng(2026) _xy0 = _rng0.uniform(0, 1000, size=(47, 2)) # 架空の座標 (km) d = np.sqrt(((_xy0[:, None, :] - _xy0[None, :, :]) ** 2).sum(-1)) import pulp import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) pops = df[df['年度'] == df['年度'].max()]['総人口'].astype(int).values // 1000 N = len(pops) fixed_cost = 1_000_000 # 距離行列 d[i][j] は前章で計算済みと仮定 prob = pulp.LpProblem('UFLP', pulp.LpMinimize) y = [pulp.LpVariable(f'y{i}', cat='Binary') for i in range(N)] x = [[pulp.LpVariable(f'x{i}_{j}', lowBound=0, upBound=1) for j in range(N)] for i in range(N)] prob += (fixed_cost * pulp.lpSum(y) + pulp.lpSum(d[i][j] * pops[j] * 0.1 * x[i][j] for i in range(N) for j in range(N))) for j in range(N): prob += pulp.lpSum(x[i][j] for i in range(N)) == 1 for i in range(N): for j in range(N): prob += x[i][j] <= y[i] prob += pulp.lpSum(y) <= 5 prob.solve(pulp.PULP_CBC_CMD(msg=False)) print(f'最小総コスト = {pulp.value(prob.objective):,.0f} 円') opened = [i for i in range(N) if pulp.value(y[i]) > 0.5] print(f'設置センター = {opened}') |
📤 実行例:
💬 上限は 5 拠点だが、 最適解は 26 番(大阪府に割り当てた架空の座標)の 1 拠点だけになった。 総コスト 4,506,209 円のうち固定費が 1,000,000 円、 輸送費が約 3,506,209 円で、 2 か所目を開いても輸送費の減り方が固定費 100 万円に届かないためである。 固定費を 300,000 円に下げて解き直すと 4 拠点(6・11・12・13 番)、 100,000 円では 5 拠点が開き、 拠点数は固定費と輸送費の比で決まることが分かる。 座標は架空なので、 どの県が選ばれたかに地理的な意味はない。
⏱ NP-hard と近似アルゴリズム — 計算限界の理論
組合せ最適化を語る上で避けて通れないのが NP-hard(決定版 NP-complete)クラスと、 そこで使える 近似アルゴリズム。 ここでは「なぜ TSP やナップサックは厳密に解くのが難しいのか」「諦めるとして、 どこまで近づけるのか」を整理する。
P, NP, NP-hard, NP-complete
| クラス | 定義 | 代表例 |
|---|---|---|
| P | 多項式時間で解ける | 最短経路、 ソート、 線形計画 |
| NP | 解の検証が多項式時間で可能 | SAT、 ハミルトン閉路、 部分和 |
| NP-hard | NP の全問題が多項式時間還元できる | TSP, 最大クリーク, グラフ彩色 |
| NP-complete | NP かつ NP-hard | SAT, 3-SAT, ナップサック判定版 |
P = NP? はクレイ研究所の 7 大未解決問題の一つ。 ほとんどの研究者は \(P \ne NP\) と信じているが、 証明はまだ。 もし P = NP なら、 RSA 暗号は破られ、 組合せ最適化問題はすべて多項式時間で解けることになる。
近似比 (approximation ratio) の定義
最小化問題に対するアルゴリズム \(A\) が比 \(\rho \ge 1\) の近似アルゴリズムとは、 任意の入力 \(I\) に対し:
\[ A(I) \le \rho \cdot \mathrm{OPT}(I) \]
が成り立つこと。 \(\rho = 1\) なら厳密解、 \(\rho = 1.5\) なら「最悪でも最適の 1.5 倍以内」を保証。
🔬 数式を言葉で読み解く: 近似比の意味
- \(A(I)\): アルゴリズム A が入力 I に出した解のコスト
- \(\mathrm{OPT}(I)\): 入力 I の真の最適コスト
- \(\rho\): 近似比(最悪保証)。 \(\rho\) が小さいほど良いアルゴリズム
- 「最悪保証」が肝心。 平均 1.01 倍でも、 病的ケースで 100 倍になるなら \(\rho \ge 100\)
- 近似比は入力サイズに依存してもよい(例: ログ近似 \(\rho = O(\log n)\))
代表的な近似アルゴリズム
| 問題 | アルゴリズム | 近似比 |
|---|---|---|
| Metric TSP | Christofides 法 | 3/2 |
| Metric TSP | 2-approximation (MST + DFS) | 2 |
| 頂点被覆 | マッチング近似 | 2 |
| 集合被覆 | 貪欲法 | \(\ln n\) |
| ナップサック | FPTAS (Ibarra-Kim) | \(1+\epsilon\)(任意精度) |
このコードでやること: 47 都道府県を都市に見立てた距離行列に対し、 Christofides 法の前段である MST 2-近似 TSP を networkx で実装し、 焼きなまし結果と比較する。
📥 入力データ: 47×47 の距離行列 dist(SSDSE-B-2026 に緯度経度は無いため、座標は再現可能な架空の値を使う)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 | import networkx as nx import numpy as np import pandas as pd # ── この抜粋だけで動くように、47 都市の距離行列と焼きなまし結果を用意する ── # 注意: SSDSE-B-2026 に緯度経度は入っていない。ここでは TSP の解き方を見るために # 再現可能な「架空の座標」を置いている(実在の位置関係ではない)。 _p = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _p = _p[_p['SSDSE-B-2026'] == 2023] names = _p['Prefecture'].tolist() # 都市名は実在の 47 都道府県 N = len(names) _rng = np.random.default_rng(2026) _xy = _rng.uniform(0, 1000, size=(N, 2)) # 架空の座標 (km) dist = np.sqrt(((_xy[:, None, :] - _xy[None, :, :]) ** 2).sum(-1)) def _tour_len(t): return sum(dist[t[i]][t[i+1]] for i in range(len(t)-1)) + dist[t[-1]][t[0]] # 焼きなまし法(2-opt 近傍)でひとまず良い巡回路を探す _cur = list(range(N)); _best = _cur[:] best_len = _tour_len(_cur); _cur_len = best_len _T = 1000.0 for _ in range(20000): i, j = sorted(_rng.integers(0, N, 2)) if i == j: continue _cand = _cur[:i] + _cur[i:j+1][::-1] + _cur[j+1:] _L = _tour_len(_cand) if _L < _cur_len or _rng.random() < np.exp(-(_L - _cur_len) / max(_T, 1e-9)): _cur, _cur_len = _cand, _L if _L < best_len: _best, best_len = _cand[:], _L _T *= 0.9997 G = nx.Graph() for i in range(N): for j in range(i+1, N): G.add_edge(i, j, weight=dist[i][j]) # MST → DFS で巡回路を作る (2-近似) mst = nx.minimum_spanning_tree(G) dfs_order = list(nx.dfs_preorder_nodes(mst, source=0)) tour_2approx = dfs_order + [dfs_order[0]] len_2approx = sum(dist[tour_2approx[i]][tour_2approx[i+1]] for i in range(N)) print(f'MST 2-近似ツアー長 = {len_2approx:.1f} km') print(f'焼きなまし結果 = {best_len:.1f} km') print(f'近似比 (vs SA) = {len_2approx/best_len:.3f}') |
📤 実行例:
💬 MST 近似のツアー長 7,730.0 km は焼きなましの 5,762.7 km の 1.341 倍。 理論保証の 2 倍よりかなり内側に収まっている(焼きなましの解も最適とは限らないので、真の最適解に対する比は 1.341 以上になりうる)。 SA は理論保証なしだが実際は高品質。 「保証あり・性能そこそこ」の近似法と「保証なし・実用優秀」のメタヒューリスティクスは併用するのが現代の組合せ最適化の主流。
🔧 制約プログラミング (CP) と OR-Tools — 産業実装の標準ツール
数式モデル化(MIP)と制約プログラミング (Constraint Programming, CP) は補完関係にある。 MIP は線形性が必要だが、 CP は「全部の値が違う」「全部の制約を満たす最初の解」など宣言的に書ける。 Google の OR-Tools は両方を統一インターフェースで提供し、 シフトスケジュール・配送・ジョブショップで産業標準になっている。
CP vs MIP の使い分け
| 特徴 | CP | MIP |
|---|---|---|
| 制約表現 | 論理・組合せ的(AllDifferent 等) | 線形不等式のみ |
| 変数型 | 離散値ドメイン | 整数・連続 |
| アルゴリズム | 伝播 + バックトラック | LP 緩和 + B&B |
| 得意領域 | スケジューリング、 ナースシフト | 配送、 ネットワーク設計 |
SSDSE で CP-SAT: 県別研修担当割当
このコードでやること: 47 都道府県を 7 名の研修担当者に割り当てる問題。 制約: ①各担当の合計人口を目標(全国の総人口 ÷ 7)の ±50 万人以内に収める、 ②一人で 8 県を超えない。 これを OR-Tools の CP-SAT で解く。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | from ortools.sat.python import cp_model import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) pops = (df[df['年度'] == df['年度'].max()]['総人口'].astype(int) // 1000).tolist() N, K = 47, 7 total = sum(pops) target = total // K model = cp_model.CpModel() assign = [model.NewIntVar(0, K-1, f'a{i}') for i in range(N)] # 各担当の人口合計を変数化 load = [model.NewIntVar(0, total, f'L{k}') for k in range(K)] for k in range(K): booleans = [model.NewBoolVar(f'b{i}_{k}') for i in range(N)] for i in range(N): model.Add(assign[i] == k).OnlyEnforceIf(booleans[i]) model.Add(assign[i] != k).OnlyEnforceIf(booleans[i].Not()) model.Add(load[k] == sum(pops[i] * booleans[i] for i in range(N))) model.Add(load[k] >= target - 500) model.Add(load[k] <= target + 500) model.Add(sum(booleans) <= 8) solver = cp_model.CpSolver() solver.parameters.max_time_in_seconds = 10 status = solver.Solve(model) if status in (cp_model.OPTIMAL, cp_model.FEASIBLE): print('実行可能解発見') for k in range(K): print(f'担当{k}: 合計人口 {solver.Value(load[k]):,} 千人') |
📤 実行例:
💬 2023 年度の総人口は合計 124,353 千人で、 7 等分した目標は 17,764 千人。 7 人の合計はすべて許容幅 17,264〜18,264 千人に収まっているが、 最小 17,339 千人と最大 18,247 千人の差は 908 千人あり、 幅いっぱいまで使っている。 このモデルには目的関数が無いので、 CP-SAT は最初に見つけた実行可能解を返すだけで、 実行するたびに内訳が変わる。 差をなるべく小さくしたいなら、 最大と最小の差を変数にして model.Minimize で最小化する。
🏭 産業応用ケーススタディ — 教科書から現場へ
① UPS の ORION (On-Road Integrated Optimization & Navigation)
UPS は配送ルートの最適化システム ORION(2013 年導入)により、 年間 1 億マイル走行距離削減、 1 億ドル燃料費削減を達成。 制約: 配達時間枠、 車両容量、 右折優先(左折は危険・時間ロス)。 解法: 大規模 MIP + 局所探索ハイブリッド。 教訓: 「右折優先」のような業務知識を制約に翻訳することが成功の鍵。
② Netflix のコンテンツキャッシュ配置 (Open Connect)
Netflix は世界 1000+ の ISP に専用キャッシュサーバを配置。 「どの番組を、 どのキャッシュに、 どの時刻に置くか」を整数計画で解く。 制約: ストレージ容量、 帯域、 視聴予測。 解法: LP 緩和 + 切除平面法。 教訓: 予測モデル(時系列 ML)と最適化をパイプライン化する設計が必須。
③ シンガポール港の岸壁割当 (Berth Allocation Problem)
世界第 2 位のコンテナ港シンガポール港。 1 日 1500 隻のコンテナ船をどの岸壁にいつ割り当てるか。 制約: 岸壁長、 クレーン数、 船の到着時刻、 タイドウィンドウ。 解法: CP-SAT による rolling horizon。 教訓: 数時間ごとに再最適化(reoptimization)するアーキテクチャ。
④ ナースシフトスケジューリング (大病院)
看護師 100-300 名の月間勤務表を作る問題。 制約: 法定休日、 夜勤連続上限、 スキル要件、 個人希望。 解法: CP-SAT + ソフト制約(違反コスト)。 教訓: 完全自動化より「下書きを出し人間が微調整」のヒューマンインザループが現実的。
⑤ 半導体製造のフォトリソ装置スケジューリング
TSMC・サムスン等の Fab で、 1 台数十億円の露光装置を何ロットでどう走らせるか。 制約: マスク交換時間、 ウェハ優先度、 装置メンテ。 解法: 専用ヒューリスティクス + 強化学習。 教訓: 「秒単位の意思決定」では実時間性能がコスト最適性に勝る。
主要ベンチマーク問題集
| 名称 | 問題 | サイズ | 用途 |
|---|---|---|---|
| TSPLIB | TSP | 14~85,900 都市 | TSP 研究の標準 |
| CVRPLIB | 容量制約付き配送 | 22~1000 顧客 | 配送研究 |
| MIPLIB 2017 | 混合整数計画 | 240 件超 | ソルバ性能比較 |
| SAT Competition | 充足可能性 | 百万変数規模 | SAT ソルバ進化 |
| DIMACS | グラフ問題 | 多様 | グラフアルゴ評価 |
❓ よくある誤解と FAQ
Q1. AI(深層学習)が普及したから組合せ最適化は不要では?
誤解。 むしろ需要は伸びている。 深層学習は予測(需要、 到着時刻)に強いが、 「制約付き意思決定」は数理最適化が依然支配的。 近年はLearning to Optimize(GNN + 強化学習で良い分枝戦略を学習)の研究が活発で、 両者は融合中。
Q2. NP-hard なら、 大規模問題は永遠に解けない?
誤解。 NP-hard は「最悪ケース」の話。 実問題は構造を持っており、 Gurobi 等の最新ソルバは 2000 年比で約 100 万倍高速化(CPU 進化込み)。 数百万変数の MIP も実用時間で解ける。 ただし定式化次第で、 同じ問題でも 1000 倍違うこともある。
Q3. 焼きなまし法とランダム探索の違いは?
違い: SA は「現在解からの近傍移動」のみ受け入れる。 ランダム探索は全空間からランダムサンプリング。 SA は局所構造を活用するため、 滑らかな解空間では圧倒的に高速。
Q4. 商用ソルバ(Gurobi, CPLEX)と OSS(CBC, GLPK)の差は?
10~1000 倍の速度差がある。 商用は前処理、 切除平面、 ヒューリスティクス、 並列化、 メモリ管理が桁違いに洗練。 学術ライセンスや AWS 等で時間貸しもあるので、 本番運用や大規模実験では商用を検討する価値が高い。
Q5. 「解が見つからない」と出たらどうする?
3 つのチェック: ①制約矛盾はないか(IIS 計算で確認)、 ②時間制限が短すぎないか、 ③定式化に冗長制約を入れて緩めたか。 「実行不可能(infeasible)」と「時間内に発見できず」は別物。 前者なら定式化・データを疑う、 後者なら時間・近似法で対応。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
整数計画 min c⊤x, Ax ≤ b, x ∈ ℤn の各記号を、 このページの 47 都道府県の予算配分ナップサックに当てはめて読む。
- x
- 決定変数(整数)
- c
- コスト係数
- A, b
- 制約行列・右辺ベクトル
- 0-1 IP
- x が 0/1 のみの場合(割当・選択)
- MIP
- 混合整数計画(整数 + 連続混在)
🔬 数式を言葉で読み解く — 組合せ最適化 の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $x_i$ | 採用フラグ(0 or 1) |
| $v_i$ | $i$ 番目の項目の「価値」 |
| $w_i$ | $i$ 番目の「重み(コスト)」 |
| $W$ | 制約上限(総重み) |
| $n$ | 候補数(SSDSE では 47 など) |
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
典型問題と難易度:
| 問題 | サイズ | 厳密解 | 実用解法 |
|---|---|---|---|
| 0-1 ナップサック | n ≤ 100 | DP O(nW) | DP / 分枝限定 |
| TSP | n ≤ 30 | Held-Karp O(n²2ⁿ) | Concorde / メタヒューリ |
| シフトスケジュール | 変数 1000+ | 不可能 | 制約プログラミング |
| 巡回配送 | n ~ 50 | 不可能 | OR-Tools / 遺伝アルゴ |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 実値で計算してみる — SSDSE-B-2026 で 組合せ最適化 を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2018-2023 年度)の実値を当てはめて、 組合せ最適化 の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 ケーススタディ 1: 「予算配分ナップサック」を SSDSE-B-2026 で解く
問題設定:47 都道府県のうち、 公共投資(仮: 「インフラ整備」プロジェクト)を実施できるのは 10 県のみ。 予算上限 1 兆円、 プロジェクト 1 件あたり費用は「人口に比例(人口 × 1 万円)」、 効果は「65 歳以上人口(A1303)」とする。 効果を最大化する 10 県の組合せは?
このコードでやること:SSDSE-B-2026 の総人口(A1101)・65 歳以上人口(A1303)から、 上記制約付き 0-1 ナップサック問題を pulp(MIP ソルバ)で解く。
📥 入力データ抜粋 (SSDSE-B-2026.csv の最初の数行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import pulp # SSDSE-B-2026 を読み込み、最新の 2023 年度の 47 都道府県を抽出 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()].reset_index(drop=True) # 総人口(A1101) を整備コスト、65 歳以上人口(A1303) を効果として使う df['pref'] = df['都道府県'] df['cost'] = df['総人口'].astype(int) * 1e4 # 整備コスト = 人口 × 1 万円 df['value'] = df['65歳以上人口'].astype(int) # 効果 = 65 歳以上人口(受益者数) # 0-1 ナップサック (MIP 定式化) prob = pulp.LpProblem('budget', pulp.LpMaximize) x = {i: pulp.LpVariable(f'x_{i}', cat='Binary') for i in df.index} prob += pulp.lpSum(df.loc[i, 'value'] * x[i] for i in df.index) prob += pulp.lpSum(df.loc[i, 'cost'] * x[i] for i in df.index) <= 1e12 # 予算 1 兆円 prob += pulp.lpSum(x[i] for i in df.index) <= 10 # 10 県以下 prob.solve(pulp.PULP_CBC_CMD(msg=False)) selected = [df.loc[i, 'pref'] for i in df.index if x[i].value() == 1] print('選択された県:', selected) print('総予算:', sum(df.loc[i, 'cost'] for i in df.index if x[i].value() == 1) / 1e8, '億円') |
📤 実行例(実際に出る出力):
💬 結果の読み方: 選ばれた 10 都道府県は、 2023 年度の 65 歳以上人口の上位 10(東京都 320.5 万人〜静岡県 110.1 万人)とそのまま一致した。 総予算は 7,226.3 億円で 1 兆円の枠に 2,773.7 億円の余りがあり、 効いている制約は予算ではなく「10 県以下」のほうである。 これは「目的関数が単純な単調関数」のためで、 実際の政策では「人口の少ない県を最低 1 つは含む」「離島・へき地を優先する」といった公平性制約を追加すると、 解は大きく変わる。 これが組合せ最適化の面白さ。
🧮 ケーススタディ 2: 「全国 K 拠点の最適配置」(K-Median 問題)
問題設定:全国に K=8 か所の物流拠点を配置する。 候補地は 47 都道府県すべて。 目的は「全国民が最寄拠点まで移動する平均距離(人口で重み付け)」を最小化すること。 これは典型的な K-Median 問題(または容量制約なし施設配置)。
このコードでやること:SSDSE-B-2026 の人口データと都道府県庁所在地の緯度経度(事前準備)を組合せ、 K=8 拠点を MIP で最適化。
📥 入力データ(拠点候補と需要点を兼ねる 47 都道府県、 距離は緯度経度から算出した近似値):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import pulp from math import radians, sin, cos, asin, sqrt def haversine(lat1, lon1, lat2, lon2): R = 6371.0 lat1, lon1, lat2, lon2 = map(radians, [lat1, lon1, lat2, lon2]) a = sin((lat2-lat1)/2)**2 + cos(lat1)*cos(lat2)*sin((lon2-lon1)/2)**2 return 2 * R * asin(sqrt(a)) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()].reset_index(drop=True) # 別途準備した都道府県庁所在地の緯度経度を merge geo = pd.read_csv('data/raw/pref_latlon.csv') df = df.merge(geo, on='都道府県') N = len(df) K = 8 # 距離行列 d = [[haversine(df.iloc[i]['lat'], df.iloc[i]['lon'], df.iloc[j]['lat'], df.iloc[j]['lon']) for j in range(N)] for i in range(N)] prob = pulp.LpProblem('kmedian', pulp.LpMinimize) y = {j: pulp.LpVariable(f'y_{j}', cat='Binary') for j in range(N)} # 拠点設置 x = {(i,j): pulp.LpVariable(f'x_{i}_{j}', cat='Binary') for i in range(N) for j in range(N)} pop = df['総人口'].astype(int).values prob += pulp.lpSum(pop[i] * d[i][j] * x[(i,j)] for i in range(N) for j in range(N)) for i in range(N): prob += pulp.lpSum(x[(i,j)] for j in range(N)) == 1 for i in range(N): for j in range(N): prob += x[(i,j)] <= y[j] prob += pulp.lpSum(y[j] for j in range(N)) == K prob.solve(pulp.PULP_CBC_CMD(msg=False)) hubs = [df.iloc[j]['Prefecture'] for j in range(N) if y[j].value() == 1] print('拠点:', hubs) |
📤 出力の形(緯度経度の CSV を同梱していないため実測ではない):
💬 結果の読み方: このブロックは緯度経度の CSV が無いと動かないので、 拠点名は載せていない。 規模だけ見ておくと、 47 県から 8 拠点を選ぶ方法は C(47,8)=314,457,495 通りあり、 割当変数 x は 47×47=2,209 個、 x ≤ y の制約も 2,209 本になる。 全列挙では手に負えない規模だが、 この程度なら CBC のような MIP ソルバで厳密に解ける。 K と総コスト・サービス水準のトレードオフは、 K を変えながら何度も解くことで可視化できる(パレートフロント)。
⚖️ 解法カタログと使い分けの判断基準
組合せ最適化の解法は「厳密法」と「ヒューリスティクス」に大別される。 規模・許容時間・最適性保証の必要度で選び分ける。
| 解法 | タイプ | 最適性 | 標準ライブラリ | 向く規模 |
|---|---|---|---|---|
| 分枝限定 (Branch & Bound) | 厳密 | 保証 | CBC, Gurobi, CPLEX | 〜数万変数 |
| 切除平面 (Cutting Plane) | 厳密 | 保証 | Gurobi 内蔵 | 中規模 |
| 動的計画法 (DP) | 厳密 | 保証 | 自前実装 | 部分構造が再利用可能なとき |
| 制約プログラミング (CP-SAT) | 厳密/部分 | 保証 or 中断時最良 | OR-Tools (Google) | スケジューリング, シフト |
| 焼きなまし (SA) | ヒューリスティクス | なし | 自前 / SciPy dual_annealing | 大規模・制約少 |
| 遺伝的アルゴリズム (GA) | ヒューリスティクス | なし | DEAP, pymoo | 多目的, 探索空間が広い |
| タブー探索 (TS) | ヒューリスティクス | なし | 自前 / 商用最適化 | 局所探索の集合 |
| 局所探索 + 多スタート | ヒューリスティクス | なし | 自前 | 手早く解を出したいとき |
| Lagrangian Relaxation | 緩和 | 下界提供 | 自前 | 分解可能な大規模問題 |
| 列生成 (Column Generation) | 厳密 | 保証 | Gurobi + 自前 | 乗務員スケジュール, 配送計画 |
| 量子アニーリング | ヒューリスティクス | なし | D-Wave Ocean SDK | QUBO 形式に変換できる問題 |
📐 解法選択フローチャート(実務的判断)
- 変数 ≤ 100 程度: 厳密法(分枝限定)で 1 秒以内に解ける可能性大 → まず CBC を試す。
- 変数 100〜10,000、 構造が線形: Gurobi / CPLEX の MIP ソルバが本命。
- スケジューリング・シフト問題: CP-SAT(OR-Tools)が MIP より速いことが多い。
- 変数 10,000+ で厳密性は不要: メタヒューリスティクス(SA / GA / TS)。 最良値の 95%程度で妥協する。
- 分解可能な構造(時間・空間・グループ)がある: ラグランジュ緩和や列生成で大幅高速化。
- 多目的・複数の意思決定者: パレートフロントを
pymooで生成し、 最終決定は人間が選ぶ。
🧮 数式に値を入れて手で計算する: ナップサック (小規模)
容量 W=10 で 4 アイテムから最大価値を選ぶ。
Step 1: アイテム
| i | 重さ | 価値 | 密度 |
|---|---|---|---|
| 1 | 2 | 6 | 3.0 |
| 2 | 3 | 9 | 3.0 |
| 3 | 5 | 12 | 2.4 |
| 4 | 7 | 14 | 2.0 |
Step 2: 全組合せ (2⁴=16)
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 | from itertools import combinations items = [(2,6),(3,9),(5,12),(7,14)] W = 10 best = 0 for r in range(1, 5): for combo in combinations(range(4), r): w = sum(items[i][0] for i in combo) v = sum(items[i][1] for i in combo) if w <= W and v > best: best, best_combo = v, combo print(f"最大価値: {best}, 選択: {best_combo}") |
📤 実行結果
💬 手計算 (Step 2) 価値 27 と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # PuLP で 0-1 整数計画: 総人口 3,000 万人の枠で 65 歳以上人口を最大化 import pandas as pd import pulp df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) v = (d['A1303'] // 1000).tolist() # 価値 = 65 歳以上人口(千人) w = (d['A1101'] // 1000).tolist() # 重み = 総人口(千人) n, W = len(d), 30000 prob = pulp.LpProblem('elderly', pulp.LpMaximize) x = [pulp.LpVariable(f'x{i}', cat='Binary') for i in range(n)] prob += pulp.lpSum(v[i] * x[i] for i in range(n)) prob += pulp.lpSum(w[i] * x[i] for i in range(n)) <= W prob.solve(pulp.PULP_CBC_CMD(msg=False)) sel = [i for i in range(n) if x[i].value() > 0.5] print('状態:', pulp.LpStatus[prob.status]) print(f'65 歳以上人口の合計 = {int(pulp.value(prob.objective)):,} 千人') print(f'総人口の合計 = {sum(w[i] for i in sel):,} 千人(枠 {W:,})') print(f'選ばれた県 ({len(sel)} 県):', '・'.join(d.loc[sel, 'Prefecture'])) |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
🐍 Python 実装 — 組合せ最適化 を SSDSE-B-2026 で動かす
🎯 このコードでやること: 2023 年度の 47 都道府県から 3 県を選び、 総人口の合計が 1,000 万人以上という制約のもとで合計特殊出生率の平均が最大になる組を、 全 $\binom{47}{3}=16{,}215$ 通りを itertools.combinations で列挙して求めます。 「どの県を選ぶか」を決める組合せ最適化の最小例で、 3 県なら全列挙で一瞬ですが、 選ぶ県数が増えると候補が爆発的に増えることも合わせて確かめます。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | # 組合せ最適化 を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np # 1) SSDSE-B-2026(教育用標準データセット)を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('shape:', df.shape) # (564, 112) — 47 都道府県 × 12 年度 print('cols head:', list(df.columns[:8])) # 2) 直近年度(2023 年度)に絞る df23 = df[df['年度'] == 2023].copy() print('rows in 2023:', len(df23)) # 3) 組合せ最適化 を動かすために必要な列だけ取り出す y = df23['合計特殊出生率'].astype(float) x = df23['総人口'].astype(float) print('y stats:', y.describe().round(3).to_dict()) print('x stats:', x.describe().round(0).to_dict()) # 4) 組合せ最適化 の本処理(このページの主題) # 47 都道府県から 3 県を選び、総人口の合計が 1,000 万人以上という制約のもとで # 合計特殊出生率の平均が最大になる組を、全 C(47,3) 通りを列挙して求める import itertools names = df23['都道府県'].values best, n_comb, n_ok = None, 0, 0 for c in itertools.combinations(range(len(df23)), 3): n_comb += 1 idx = list(c) if x.values[idx].sum() < 10_000_000: continue # 制約を満たさない組は捨てる n_ok += 1 score = y.values[idx].mean() if best is None or score > best[0]: best = (score, idx) print('---- 組合せ最適化 結果 ----') print('組合せ総数:', n_comb, '/ 制約を満たす組:', n_ok) print('最適な 3 県:', list(names[best[1]])) print('出生率の平均:', round(best[0], 3), '/ 総人口合計:', int(x.values[best[1]].sum())) print('corr(x, y):', y.corr(x).round(3)) |
💬 47 県から 3 県を選ぶ組は 16,215 通りで、総人口 1,000 万人以上の制約を満たすのは 4,608 通り。最適解は愛知県(1.29)・長崎県(1.49)・沖縄県(1.60)で平均 1.46、人口合計 1,021.2 万人である。出生率の高い県は人口が少ない(相関 −0.564)ので、制約を満たすために人口の大きい愛知県を 1 つ入れ、残り 2 枠を出生率の上位で埋めた形になっている。3 県なら全列挙で一瞬だが、10 県を選ぶと約 52 億通りになり、全列挙が効かなくなるのが組合せ最適化の難しさである。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
🐍 Python — 組合せ最適化 の追加実装(SSDSE-B-2026 拡張)
基本コードに加え、 SSDSE-B-2026 の多変量を取り回す実用パターン。 引数を変数化せず、 パスを直書きしているのは初学者が「どこに何を書くか」で迷わないようにするため。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 | # 組合せ最適化 の拡張実装 — 多年度・複数指標を扱う import pandas as pd import numpy as np # 1) 全 564 行(47 都道府県 × 12 年度)を読み込む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 2) 年度別の代表指標(出生率・総人口・大学卒業者)の平均 agg = df.groupby('年度').agg( avg_birth=('合計特殊出生率', 'mean'), avg_pop=('総人口', 'mean'), avg_grad=('大学卒業者数', 'mean'), ).round(2) print(agg) # 3) 直近年度(2023)と過去年度(2018)の比較 df18 = df[df['年度'] == 2018].set_index('都道府県') df23 = df[df['年度'] == 2023].set_index('都道府県') # 共通する都道府県だけ抽出 common = df18.index.intersection(df23.index) df18 = df18.loc[common] df23 = df23.loc[common] growth_pop = ((df23['総人口'] - df18['総人口']) / df18['総人口']).round(4) print('人口増減率トップ5:', growth_pop.sort_values(ascending=False).head().to_dict()) print('人口増減率ワースト5:', growth_pop.sort_values().head().to_dict()) # 4) 組合せ最適化 の主処理 — 0-1 ナップサック問題 # 2023 年度の都道府県を「重さ = 総人口(千人)」「価値 = 大学卒業者数」とみなし、 # 人口 1,000 万人分の調査枠で大学卒業者を最も多くカバーする県の組を選ぶ w = (df23['総人口'] / 1000).round().astype(int).values v = df23['大学卒業者数'].values names = df23.index.values C = 10_000 dp = np.zeros(C + 1) take = np.zeros((len(w), C + 1), dtype=bool) for i in range(len(w)): # 動的計画法(厳密解) for c in range(C, w[i] - 1, -1): if dp[c - w[i]] + v[i] > dp[c]: dp[c] = dp[c - w[i]] + v[i] take[i, c] = True c, chosen = C, [] for i in range(len(w) - 1, -1, -1): # 選んだ県をたどり直す if take[i, c]: chosen.append(names[i]); c -= w[i] order = np.argsort(-v / w) # 貪欲法(価値/重さの大きい順) g_sel, g_w, g_v = [], 0, 0 for i in order: if g_w + w[i] <= C: g_sel.append(names[i]); g_w += w[i]; g_v += v[i] print('---- 組合せ最適化 拡張版 ----') print('DP :', int(dp[C]), '人', sorted(chosen)) print('貪欲:', int(g_v), '人', sorted(g_sel), '人口', g_w, '千人') |
💬 年度平均の表では、合計特殊出生率が 2015 年度の 1.53 から 2023 年度の 1.29 へ下がり続ける一方、大学卒業者数の平均は 11,890 人から 12,564 人へ増えている。2018→2023 年度の人口増減率は東京都 +1.43% が最大、秋田県 −7.21% が最小。ナップサック問題では人口 1,000 万人の枠で大学卒業者 69,510 人をカバーする 6 府県が選ばれ、京都府(人口 253.5 万人に対し卒業者 32,349 人)のように大学が集まる府県が優先される。今回は価値/重さの大きい順に詰める貪欲法も厳密解と同じ答えになったが、これは偶然で、一般には貪欲法は最適を保証しない。
SSDSE-B-2026 は 564 行(47 都道府県 × 12 年度)あるので、 年度フィルタを忘れると重複計算になります。 必ず df[df['年度'] == 2023] のように絞ってから本処理へ進むのが安全です。
📊 評価・検証チェックリスト — 組合せ最適化 を使う前後に
組合せ最適化 を「やってみたけど結局正しかったのか分からない」状態を避けるための、 標準的な検証観点。 SSDSE-B-2026 のような中小規模データでは特に丁寧に。
| 確認する点 | 組合せ最適化 で何を見るか |
|---|---|
| 「全探索すれば良い」 | n=20 でも 2^20 ≈ 100 万通り。 30 では 10 億通り。 工夫が必須。 |
| LP 緩和の鵜呑み | 整数解が整数化で大きく変わることあり。 分枝限定で詰める。 |
| ヒューリスティクスの局所解 | 遺伝アルゴ・焼きなまし法は再現性に注意。 複数初期値で確認。 |
| 制約の表現ミス | 数式での「以上」「以下」の取り違えで全く違う最適解。 |
| 「全探索すれば良い」と思う | $n=20$ で 2^20 = 約 100 万、 $n=30$ で 約 10 億通り。 工夫なしには不可能。 |
| LP 緩和の値を最適解と勘違い | 連続緩和(LP)の値は整数解の上界。 整数化で大きく劣化することも。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
⚠️ よくある落とし穴
この用語を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
n の桁を確認 (47 都道府県の部分集合選択なら 2^47 ≈ 1.4×10¹⁴、 全探索は不可)」「PuLP/Gurobi 等 LP solver を使い、 LP 緩和値と整数解の Optimality Gap を必ず出力」「メタヒューリスティクス (GA/SA) は seed を 5 個以上振り、 ベストと中央値を併記」の 3 点を守れば、 全探索試行・LP 値の鵜呑み・局所解報告ミスを防げます。
⚠️ よくある落とし穴 — 組合せ最適化 で初学者がやりがちなミス
組合せ最適化 を実務で使うときに踏みやすい落とし穴を、 失敗パターン別に整理しました。 47 都道府県から k 拠点を選ぶ施設配置問題 を扱う場面で起きやすい問題ばかりなので、 先に知っておくと事故が大幅に減ります。
assert でランタイム検査」「目的関数の単位 (円・人・%) を明示」の 3 点を実装段階で組み込めば、 後工程の手戻りが半減します。
⚠️ 落とし穴の追補(実務で頻発するもの)
| 落とし穴 | 症状 | 対策 |
|---|---|---|
| 数値スケール混在 | 人口 (10⁷) と GDP (10¹¹) を混ぜると、 内点法が不安定化し「実行可能解なし」を誤検出 | 各係数を 10⁻⁶ 程度のオーダーに揃える、 ソルバの数値設定 (NumericFocus=3) を使う |
| 対称性 (Symmetry) | 「同じ品質の選択肢 K 個から 1 個選ぶ」問題で、 等価解が爆発しソルバが膠着 | 辞書順制約 (\(x_1 \geq x_2 \geq ... \geq x_K\)) を加える |
| 弱い線形緩和 | LP 緩和値と整数最適値の gap が大きく、 分枝限定木が爆発 | cover inequality、 GUB / クリーク不等式など問題特有の有効不等式を追加 |
| Big-M の過大設定 | 条件分岐 (if-then) を Big-M で書く際 M を 10⁹ にすると、 ほぼ確実に弱い緩和 | 問題依存の上界を厳密に計算(実は M=変数の上界)、 または間接定式化 (indicator constraints) を使う |
| 不実行可能の見逃し | 制約が矛盾しているのに「最適化失敗」とだけ表示され、 原因が分からない | IIS(Irreducible Infeasible Subsystem)抽出機能を使い、 矛盾を起こす最小制約集合を特定 |
| 「最適解 ≠ 良い解」 | 数学的最適でも「現場運用上ありえない」解(例: 1 人のシフトが極端に偏る) | 制約に「公平性」を追加。 ジニ係数の上限、 最大連勤日数、 個人偏差の上限など。 |
| 過剰な厳密性追求 | 最適値の 0.01% 改善のために計算時間が 100 倍になる | MIP gap を 1% 程度で許容停止 (MIPGap=0.01)、 「実務上十分な解」で打ち切る |
📜 組合せ最適化の歴史と現代的な位置づけ
| 年代 | 主要な進展 | 代表的人物・成果 |
|---|---|---|
| 1947 | 単体法 (Simplex Method) の発明 | G. Dantzig — 線形計画の実用化を一気に進めた |
| 1955 | 輸送問題、 割当問題の効率的解法 | H. Kuhn — Hungarian Method(実は 19 世紀 König の結果に基づく) |
| 1960 | 分枝限定法 | A. Land & A. Doig — 整数計画の汎用解法 |
| 1971 | NP 完全性の確立 | S. Cook — Karp が 21 問題が NP 完全と示し、 組合せ最適化の理論的地位が確定 |
| 1976 | Christofides の 3/2 近似法 (TSP) | N. Christofides — 44 年間「最良近似比」 |
| 1983 | 焼きなまし法 (Simulated Annealing) | S. Kirkpatrick — 統計力学の発想を最適化に応用 |
| 1989 | タブー探索の体系化 | F. Glover — 局所探索の脱出戦略を理論化 |
| 1992 | 蟻コロニー最適化 | M. Dorigo — 生物模倣型ヒューリスティクス |
| 1995 | 粒子群最適化 | J. Kennedy & R. Eberhart |
| 2006 | 商用ソルバの飛躍 (Gurobi 創業) | Z. Gu, B. Rothberg, R. Bixby — 1990〜2020 で MIP 解法は約 200 万倍高速化 |
| 2011 | 商用量子アニーリング機 D-Wave One | D-Wave Systems — QUBO 形式の組合せ問題用ハードウェア |
| 2020 | Christofides 比の改善 \(3/2 - 10^{-36}\) | A. Karlin, N. Klein, S. Gharan — 半正定値計画ベース |
| 2022 | Neural Combinatorial Optimization の本格化 | DeepMind, Salesforce — Transformer + 強化学習でルーティング |
1947 年のシンプレックス法以来、 組合せ最適化は「計算機の登場 → 理論の整備 → 商用ソルバの飛躍 → AI との融合」という流れで発展してきた。 現代では、 古典的 MIP ソルバと機械学習(特に強化学習・GNN)を組合せる「Learning to Optimize」が活発な研究領域。 ただし、 「実務で安定して動く」のは依然として MIP / CP-SAT であり、 学習ベース手法は「初期解生成」や「分枝戦略の学習」に組み込む使い方が主流。
🎯 「最適化を使うべきか」の判断 — 統計分析・機械学習との違い
| 問いのタイプ | 適切な手法 | 具体例 |
|---|---|---|
| 「過去のデータの傾向は?」 | 記述統計・EDA | SSDSE-B-2026 で人口減少が進んだ県を可視化 |
| 「変数間の関係は?」 | 相関・回帰分析 | 総人口(A1101)と 65 歳以上人口(A1303)の相関を調べる |
| 「未来の値を予測したい」 | 機械学習・時系列分析 | 2030 年の出生数を XGBoost で予測 |
| 「原因を知りたい」 | 因果推論 | 育児支援策が出生率に与えた効果を DID で測る |
| 「限られた資源で最良の選択をしたい」 | 組合せ最適化 | 予算 100 億円で何県に施設を作るか |
| 「ランダム性のあるシステムの設計」 | 確率計画法・シミュレーション最適化 | 災害発生確率を考慮した備蓄拠点配置 |
統計分析や機械学習が「世界を理解する」手法であるのに対し、 組合せ最適化は「世界に働きかける」手法である。 「予測モデルの精度を 1% 上げる」ことより「予測を元に意思決定を 1% 改善する」方が、 ビジネスインパクトとしては桁違いに大きいことが多い。 これが、 ML プロジェクトの「下流に必ず最適化がある」と言われる理由。
📝 モデリング設計の実務 5 原則
- 決定変数を最初に書き出す: 「何を 0/1 で決めるのか」「何を実数で決めるのか」を紙に書き、 変数の数を数える。 1 万を超えるなら「分解」を検討する。
- 目的関数は単一スカラーに集約する: 多目的の場合、 重み付き和か、 一つを目的・他を制約に変える(ε-制約法)。 重みは現場関係者と議論し、 感度分析で頑健性を検証。
- 制約は「ハード」と「ソフト」に分ける: 法令・物理制約はハード、 「できれば守りたい」はソフト(違反量を目的関数にペナルティ)。 全部ハードにすると「実行可能解なし」になりがち。
- 線形定式化を最初に試す: 非線形項(積、 log、 sqrt)はソルバが苦手。 まずは線形近似(区分線形・Big-M 線形化)で解き、 必要に応じて非線形ソルバ (Couenne, BARON, Gurobi-NL) に進む。
- 結果は必ず「人間が読む」前提で出す: 「予算配分案 A: 北海道 2 億、 東京 5 億、...」というレポートに、 「同等品質の代替案 (next-best 5)」を併記すると意思決定者が安心して採用できる。
🧭 SSDSE-B-2026 で組合せ最適化を「自治体の予算配分」として体感する
組合せ最適化は教科書では「巡回セールスマン問題」や「ナップサック問題」のような抽象例で説明されがちで、 「現実のデータでどう使うのか」が見えづらい。 ここでは SSDSE-B-2026 の都道府県別データを使い、 「限られた予算で 47 都道府県のうちどれに重点投資すれば 子ども医療費助成カバー率 を最大化できるか」というナップサック型の配分問題を立てる。 数式・コード・想定解釈をひと続きに体験することで、 「組合せ最適化=現場の意思決定支援ツール」という感覚を獲得できる。
問題設定: 47 都道府県への重点投資
国が新規に 1,000 億円 の重点配分枠を設け、 子ども医療費助成の「中学生まで完全無償化」を全国に広げたいと考える。 各都道府県は「無償化を中学卒業まで拡張するために必要な追加コスト」と「対象児童数(恩恵を受ける人数)」のデータを持っている。 限られた予算で「恩恵を受ける児童総数を最大化」する都道府県の組合せを選ぶ問題は、 まさに 0-1 ナップサック問題と等価である。
| 変数 | 記号 | 意味 | SSDSE-B-2026 での対応列 | 単位 |
|---|---|---|---|---|
| 決定変数 | x[i] | 都道府県 i に投資するか (0/1) | 行 (都道府県コード) | 無次元 |
| 価値 | v[i] | 恩恵を受ける児童数 | 15 歳未満人口 (A1301) | 人 |
| 重み | w[i] | 必要追加予算 | 児童数 × 年間助成単価 (8 万円仮置き) | 億円 |
| 容量 | W | 国が用意した重点配分枠 | 予算 (政策パラメータ) | 1,000 億円 |
数式: 0-1 ナップサックとして書き下す
この問題は次のように定式化できる。 目的関数は「恩恵を受ける児童数」、 制約は「予算 1,000 億円を超えない」だけのシンプルな形になる。
$$ \max_{x \in \{0,1\}^{47}} \sum_{i=1}^{47} v_i\, x_i \quad \text{s.t.} \quad \sum_{i=1}^{47} w_i\, x_i \le W $$$v_i$ は都道府県 i の 15 歳未満人口(A1301)、 $w_i$ は必要追加予算 (億円)、 $W=10$ (億円)、 $x_i$ は 0 (投資しない) または 1 (投資する) という決定変数。 連続緩和なら線形計画 (LP) で多項式時間に解けるが、 整数制約 $x_i \in \{0,1\}$ が加わると NP-困難になる。 ただし 47 自治体程度なら現代のソルバで秒以下で厳密解が得られる。
🐍 Python 実装 (PuLP)
このコードでやること: SSDSE-B-2026 の 15 歳未満人口(A1301)データを使い、 0-1 ナップサック問題を pulp で解いて、 1,000 億円枠で恩恵を受ける児童数を最大化する都道府県集合を求める。
📥 入力データ (SSDSE-B-2026 抜粋、 15 歳未満人口 A1301):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import pulp # 1) 47 都道府県の 15 歳未満人口 (SSDSE-B-2026, A1301 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2022].reset_index(drop=True).copy() df['children'] = df['A1301'].astype(int) # 15 歳未満人口 df['cost_oku'] = df['children'] * 8e4 / 1e8 # 追加予算(億円) = 児童数 × 8 万円 v = df['children'].values w = df['cost_oku'].values n = len(df) W = 1000.0 # 予算枠 1,000 億円 # 2) 0-1 ナップサック問題を構築 prob = pulp.LpProblem('budget_alloc', pulp.LpMaximize) x = [pulp.LpVariable(f'x_{i}', cat='Binary') for i in range(n)] prob += pulp.lpSum(v[i] * x[i] for i in range(n)) prob += pulp.lpSum(w[i] * x[i] for i in range(n)) <= W # 3) ソルバを呼び出し prob.solve(pulp.PULP_CBC_CMD(msg=False)) # 4) 結果整形 selected = df.iloc[[i for i in range(n) if x[i].value() == 1.0]] print(f'目的関数値 (恩恵児童数): {int(pulp.value(prob.objective)):,} 人') print(f'消費予算: {selected["cost_oku"].sum():.2f} 億円 / 1000.00 億円') print(f'選定都道府県数: {len(selected)} / 47') print(selected[['Prefecture', 'children', 'cost_oku']].to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 本設定では単価が一律 8 万円/児のため、 投資効率(児童数 ÷ コスト)はどの県も同じ 1.25 万人/億円。 したがって問題は「予算 1,000 億円をできるだけ使い切る」部分和 (subset-sum) 問題に帰着し、 最適値(恩恵児童数)は予算の上限で決まる(1,000 億円 ÷ 8 万円 = 125 万人)。 上の 12 県はちょうど 1,000 億円ぴったりに詰められる同点最適解の一例であり、 他にも多数の組合せが同じ 125 万人を達成する。 一方、 東京都は単独で 1,228 億円と予算枠 1,000 億円を超えるため、 どの最適解にも入れない(これは確定的な結論)。 もし「単価を県ごとに変える(地域医療費差)」設定にすれば投資効率に差が生まれ、 非自明なナップサックになる。 「東京は必ず含めたい」なら追加制約 x[tokyo] == 1 を加え、 残予算で最適化すればよい。
⚠️ 教育的な落とし穴
- 「最適解=唯一無二の答え」と誤解しがち: ナップサック問題は 同点最適解 (tie) が存在しうる。 例えば「秋田県を選ぶ・選ばない」で同じ目的値になるケースがあれば、 ソルバはどちらか 1 つを返すだけ。 next-best 5 候補を併記する処理を意思決定者に届ける運用にする。
- 制約が緩すぎる/きつすぎると気づきにくい: 予算を全国総コスト(約 1.16 兆円)以上にすると「全県選定」が出てしまい、 最適化の意味がない。 逆に最小県(鳥取・約 53 億円)未満にすると「実行可能解なし」。 感度分析で適切な予算レンジを探る癖をつけたい。
- SSDSE-B-2026 の 15 歳未満人口(A1301)は「政策効果の代理変数」にすぎない: 実際には「現在の助成カバー率」「自治体財政力指数」など複数指標を組合せる必要がある。 単一指標で最適化すると現場感覚と乖離する。
🚚 配送ルートを最適化する: 巡回セールスマン問題 (TSP) と県庁所在地
ナップサック問題は「選ぶ・選ばない」だが、 もう一つの古典的組合せ最適化問題が 巡回セールスマン問題 (Traveling Salesperson Problem, TSP) だ。 「全 47 都道府県の県庁所在地を一度ずつ訪問し、 総走行距離を最小化するルート」を求める問題で、 物流・営業所巡回・選挙遊説の計画など実社会の多くの場面に対応する。 ここでは SSDSE-B-2026 と地理情報を組合せ、 ミニサイズの TSP(北海道〜沖縄の全 47 県)を Python で解く。
TSP の定式化 (MTZ 形式)
都市集合 $V = \{1, 2, \ldots, n\}$、 都市 $i$ から $j$ への距離を $d_{ij}$、 巡回するかどうかを $x_{ij} \in \{0,1\}$ とする。 部分巡回路を排除する代表的な手法 Miller-Tucker-Zemlin (MTZ) 制約 を加えると、 次のように整数線形計画 (MILP) として定式化できる。
$$ \min \sum_{i \ne j} d_{ij}\, x_{ij}, \quad \text{s.t. } \sum_{j \ne i} x_{ij} = 1\ (\forall i), \quad \sum_{i \ne j} x_{ij} = 1\ (\forall j), \quad u_i - u_j + n x_{ij} \le n - 1\ (i, j \ne 1) $$最初の制約は「各都市から出る辺はちょうど 1 本」、 次が「各都市に入る辺もちょうど 1 本」、 最後の MTZ 補助変数 $u_i$ が「ハミルトン閉路として一筆書きであること」を保証する。 これにより部分巡回路 (sub-tour) の発生を排除できる。
🐍 Python 実装 (Google OR-Tools)
このコードでやること: SSDSE-B-2026 の都道府県コード一覧を活用し、 47 県庁所在地の緯度経度(補助 CSV から読込)をベースに距離行列を作り、 OR-Tools の TSP ソルバで最短ルートを求める。
📥 入力データ (補助 CSV `prefecture_capitals.csv`):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 | import pandas as pd import numpy as np from ortools.constraint_solver import routing_enums_pb2, pywrapcp # 1) 県庁所在地データ読み込み caps = pd.read_csv('data/raw/prefecture_capitals.csv') n = len(caps) # 2) 距離行列 (haversine 近似) def haversine(lat1, lon1, lat2, lon2): R = 6371.0 p1, p2 = np.radians(lat1), np.radians(lat2) dp = np.radians(lat2 - lat1) dl = np.radians(lon2 - lon1) a = np.sin(dp/2)**2 + np.cos(p1)*np.cos(p2)*np.sin(dl/2)**2 return R * 2 * np.arctan2(np.sqrt(a), np.sqrt(1-a)) D = np.zeros((n, n), dtype=int) for i in range(n): for j in range(n): if i != j: D[i][j] = int(haversine(caps.latitude[i], caps.longitude[i], caps.latitude[j], caps.longitude[j])) # 3) OR-Tools で TSP を解く manager = pywrapcp.RoutingIndexManager(n, 1, 0) # 始点=index 0 routing = pywrapcp.RoutingModel(manager) def dist_cb(i, j): return D[manager.IndexToNode(i)][manager.IndexToNode(j)] transit_idx = routing.RegisterTransitCallback(dist_cb) routing.SetArcCostEvaluatorOfAllVehicles(transit_idx) params = pywrapcp.DefaultRoutingSearchParameters() params.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC solution = routing.SolveWithParameters(params) # 4) ルート出力 index = routing.Start(0) route = [] total = 0 while not routing.IsEnd(index): node = manager.IndexToNode(index) route.append(caps['県庁所在地'].iloc[node]) next_index = solution.Value(routing.NextVar(index)) total += routing.GetArcCostForVehicle(index, next_index, 0) index = next_index route.append(caps['県庁所在地'].iloc[manager.IndexToNode(index)]) print(f'総走行距離: {total:,} km') print(' → '.join(route[:8]) + ' → ... → ' + ' → '.join(route[-3:])) |
📤 出力の形(県庁所在地の CSV を同梱していないため実測ではない):
💬 結果の読み方: このブロックは県庁所在地の CSV が無いと動かないので、 距離の数値は載せていない。 47 都市の巡回路は (47−1)!/2 ≈ 2.7×1057 通りあり、 全列挙はできない。 PATH_CHEAPEST_ARC は「近い都市へ順につなぐ」初期解の作り方で、 返ってくる総走行距離は最適値の上界(これ以上長くはならない実用解)であって下界ではない。 最適に近づけたいときは local_search_metaheuristic に Guided Local Search を指定し、 time_limit を与えて改善を続けさせる。
配送計画への拡張
TSP は単一の巡回路だが、 現実の配送計画は VRP (Vehicle Routing Problem) へ拡張する。 「トラック 5 台で 47 都道府県に荷物を届け、 各車両は 8 時間以内に営業所へ戻る」のような問題は、 OR-Tools の RoutingDimension に容量・時間制約を加えるだけで解ける。 SSDSE-B-2026 の「製造品出荷額」を需要量の代理変数とすれば、 「製造業の盛んな愛知・神奈川・大阪へ多くの便を出す」配送計画も作れる。
| 問題タイプ | 変数数の目安 | 推奨ソルバ | 典型計算時間 |
|---|---|---|---|
| TSP (47 都市) | 2,162 (47×46) | OR-Tools (heuristic) | < 1 秒 |
| VRP (47 都市, 5 台) | 約 1.1 万 | OR-Tools + GLS | 数秒 |
| CVRP-TW (時間枠付) | 約 2 万 | Gurobi/CPLEX | 30 秒〜数分 |
| 大規模 VRP (1000+ 顧客) | 百万オーダ | 分解 + メタヒュー | 数分〜数時間 |
この表が示すのは「組合せ最適化は問題サイズに敏感」という現実だ。 47 都市までは何でもよいが、 千を超えると分解 (clustering → TSP) かメタヒューリスティック (ALNS, GA) が必須になる。 「サイズの壁」を意識するのが実務感覚として大切。
🧠 理解度チェック: 組合せ最適化を「現場で使う」感覚
ここまでの「ナップサック (配分)」「TSP (巡回)」「VRP (配送)」の 3 例で、 組合せ最適化が現場の意思決定支援になることが見えてきた。 最後に 5 問の確認問題 でポイントを定着させよう。 答えは折りたたみ式で、 まず自分で考えてから開いてほしい。
Q1: 47 都道府県のうち 12 県を予算 1,000 億円で選んだ際、 「東京都が含まれなかった」理由は?
Q2: ナップサック問題の「価値÷重み比」が高い順に貪欲法で選ぶと、 必ず最適解が得られるか?
Q3: TSP の MTZ 制約 $u_i - u_j + n x_{ij} \le n-1$ は何を意味するか?
Q4: 整数計画問題が NP-困難であっても、 多くの実問題が「解けてしまう」のはなぜか?
Q5: 47 都道府県を超え、 1,000 拠点規模の組合せ最適化を解く場合、 真っ先に検討すべき戦略は?
💡 まとめ: 組合せ最適化の現場感覚 7 か条
- 定式化が 9 割: 決定変数の置き方で問題の難易度が桁違いに変わる。 紙とペンで何度も書き直す。
- 線形を最初に試す: 非線形項は最後の手段。 区分線形・Big-M 線形化で粘る。
- 制約はハード/ソフトに分ける: 全部ハードは「解なし」を招く。 ペナルティ化を恐れない。
- 感度分析で頑健性を確認: 「予算 ±10%」で解が大きく動くなら、 制約緩和が必要。
- next-best 解を併記: 意思決定者は「2 番手・3 番手」を見て安心して 1 位を採用する。
- 計算時間の壁を意識: 1,000 変数を超えたら分解 or メタヒューリスティック。
- 結果は人間が読める形に: 「東京 5 億・大阪 3 億」のような自然言語レポートを自動生成する後処理を組む。
組合せ最適化は数式や計算量で身構えがちな分野だが、 SSDSE-B-2026 のような身近なデータで「予算配分」「配送ルート」「シフト勤務」を計算してみると、 「あ、 自分の現場でも使える」と腑に落ちる瞬間が来る。 そこから「自分の業務をどう定式化するか」という上流の問いに移行できれば、 データサイエンティストとして大きな一歩を踏み出している。
補足として、 業務現場では「最適化ソルバが出した解 = そのまま採用」とはなりにくい。 経営判断・労使協議・サービス品質など、 数式に乗らない変数が常にある。 そこで重要なのは、 最適化を「意思決定の補助」として位置づけ、 複数のシナリオ解 (例: 予算 8 億・10 億・12 億の 3 通り) を並べて関係者に提示する運用設計だ。 これが「最適化技術 × 組織コミュニケーション」の橋渡しであり、 データサイエンティストが現場に深く入り込むための実践知になる。 シナリオ提示の文化を持ち込めるかどうかが、 単なる「数理マニア」と「現場で頼られる人」の分かれ道になりやすい。 数理的厳密性と組織的合意形成は、 最適化を社会実装するうえで両輪である。
📦 シフト勤務最適化: 「集合被覆問題」として教員配置を考える
配分と巡回の次は 集合被覆問題 (Set Covering Problem) だ。 「すべての時間帯・教科・学年をカバーするために、 最少人数の教員シフトを組む」のは典型的な集合被覆問題で、 学校・病院・コンビニ・コールセンターなど、 「人がシフトで埋めるサービス」全般に登場する。 SSDSE-B-2026 の「教員数」を出発点に、 ミニマムな集合被覆を立てて解いてみる。
集合被覆問題の定式化
要件集合を $R = \{r_1, r_2, \ldots, r_m\}$ (例: 「月 1 限 数学」「月 1 限 英語」「火 2 限 数学」など)、 候補シフトパターン集合を $S = \{s_1, \ldots, s_n\}$ (例: 「月火 1-2 限 出勤の田中先生」)、 シフト $s_j$ のコストを $c_j$ とする。 行列 $A=(a_{ij})$ は「シフト $s_j$ が要件 $r_i$ をカバーするなら 1」と定義する。 最少コストでカバーする問題は次のように書ける。
$$ \min \sum_{j=1}^{n} c_j x_j, \quad \text{s.t.}\ \sum_{j=1}^{n} a_{ij} x_j \ge 1\ (\forall i), \quad x_j \in \{0,1\} $$各要件 $r_i$ について「少なくとも 1 つのシフトでカバーされる」という制約 $\sum_j a_{ij} x_j \ge 1$ を満たしつつ、 総コストを最小化する。 もし「ちょうど 1 回だけ」なら集合分割問題 (Set Partitioning) になり、 シフトのダブルブッキングを排除できる。 現場ではダブルブッキングを許して柔軟にする集合被覆型が好まれる。
🐍 Python 実装 (PuLP)
このコードでやること: 「月-金 × 1-6 限 = 30 コマ」をカバーするため、 5 種類のシフトパターン(候補先生)から最少コストで配置する集合被覆問題を pulp で解く。
📥 入力データ (シフト候補表):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pulp # 1) 30 コマ要件 (月1〜金6) requirements = [f'{d}{p}' for d in ['月', '火', '水', '木', '金'] for p in range(1, 7)] # 2) シフト候補 (先生 → カバーするコマ集合) shifts = { 'A先生': (25000, {'月1','月2','火1','火2','水1','水2','木1','木2','金1','金2'}), 'B先生': (24000, {'月3','月4','火3','火4','水3','水4','木3','木4','金3','金4','月5','火5'}), 'C先生': (20000, {'月5','月6','火5','火6','水5','水6','木5','木6'}), 'D先生': (18000, {'金5','金6','木5','木6','水5','水6'}), 'E先生': (16000, {'月6','火6','水6','木6','金6'}), } # 3) 集合被覆問題を構築 prob = pulp.LpProblem('shift_cover', pulp.LpMinimize) x = {t: pulp.LpVariable(f'x_{t}', cat='Binary') for t in shifts} prob += pulp.lpSum(c * x[t] for t, (c, _) in shifts.items()) for req in requirements: prob += pulp.lpSum(x[t] for t, (_, covered) in shifts.items() if req in covered) >= 1 # 4) 解く prob.solve(pulp.PULP_CBC_CMD(msg=False)) selected = [t for t in shifts if x[t].value() == 1.0] print(f'採用シフト: {selected}') print(f'総コスト: {int(pulp.value(prob.objective)):,} 円') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 金曜 5 限をカバーできるのは D 先生だけなので、 D 先生(18,000 円)は必ず採用される。 D 先生と B・E 先生を入れると C 先生の 8 コマ(月火の 5・6 限は B と E、 水木の 5・6 限は D)はすべて他の先生で埋まるので、 C 先生(20,000 円)が不採用になり、 総コストは 25,000+24,000+18,000+16,000=83,000 円。 もし「C 先生のシフトには教科専門性がある」という追加要件があれば、 制約 x['C先生'] == 1 を加えて再最適化すればよい。 これが集合被覆型最適化の柔軟さで、 「人事配置の自動化=AI 化」の入口にもなる。
組合せ最適化が活きる現場
| 業界・領域 | 問題タイプ | 期待される効果 |
|---|---|---|
| 物流・配送 | VRP・TSP | 走行距離 10-30% 削減、 CO2 削減 |
| 病院シフト | 集合被覆 + 公平性制約 | 夜勤偏り解消、 離職率改善 |
| 電力発電計画 | UC (Unit Commitment) | 燃料費 数%-数十% 削減 |
| 広告予算配分 | ナップサック + ROI 制約 | CPA 削減、 リーチ最大化 |
| 学校時間割 | 集合分割 + 教員制約 | 作成時間 数日 → 数分 |
どの現場も「変数 (誰を/どれを) × 制約 (時間・予算・容量) × 目的 (最小化・最大化)」という共通の構造を持つ。 一度 1 つの問題を pulp や OR-Tools で解いてみれば、 別の現場も同じ書き方で展開できる。 これが組合せ最適化の「汎用性」であり、 データサイエンティストが習得しておきたい中核スキルの一つである。
🛠️ 「最初の一手」チェックリスト: 業務を組合せ最適化に翻訳する
「うちの業務でも最適化を使えるはず」と感じたとき、 何から始めればよいか。 以下の 5 ステップチェックリスト を順に埋めると、 ふだんの業務が組合せ最適化問題に翻訳されていく。 数式が苦手でも、 紙とペンで言葉から始めれば必ず進める。
- 「決めたいもの」を箇条書きする: 例「誰がどの日に出勤するか」「どの拠点に投資するか」「どの順で訪問するか」。 これがそのまま決定変数になる。
- 「絶対守らねばならないルール」を列挙: 例「1 日 8 時間まで」「予算 1,000 万円以内」「全顧客を 1 回ずつ訪問」。 これがハード制約になる。
- 「できれば守りたいルール」を列挙: 例「夜勤は月 4 回まで」「ベテランと新人を組ませる」。 これがソフト制約 (ペナルティ) になる。
- 「最大化/最小化したい数値」を 1 つに集約: 例「総走行距離最小」「総利益最大」「総コスト最小 + 公平性ペナルティ」。 これが目的関数になる。
- 小さなサンプルで試作: いきなり全データを投入せず、 まず 5-10 件で
pulpやOR-Toolsに解かせる。 「想定通りの解か」を確かめてから本番データへ拡大する。
この 5 ステップを 1 サイクル回すだけで、 「業務が数式になる」体験が得られる。 体験を 3-5 回繰り返すうちに、 「うちの会社のあの問題も最適化に乗りそう」という勘所が育つ。 組合せ最適化は最初こそ敷居が高く見えるが、 「業務を分解する技術」として身につければ、 一生使える武器になる。 さらに、 自分が一度書いた定式化テンプレートは類似業務に転用しやすく、 知識の レバレッジ が極めて高い分野でもあると言えるだろう。 一度作った定式化テンプレートは別案件に流用しやすく、 学習投資の費用対効果は群を抜く。
最後に、 学習リソースとしては pulp 公式ドキュメント、 Google OR-Tools の「Quick Start」、 scipy.optimize.linprog の例題が初学者に優しい。 国内の良書としては「あたらしい数理最適化」「Python で学ぶ最適化」が、 SSDSE-B-2026 のような公的データを使った演習問題を多く含んでいておすすめできる。
業務翻訳の具体例: 3 つの「ありがちな仕事」を最適化に置き換える
最後にイメージを固めるため、 多くの読者にとって身近な業務を 3 つ取り上げ、 「決定変数 → 制約 → 目的関数」の翻訳例を並べる。 翻訳できるか否かが、 ふだんのコーヒーブレイクの雑談ネタにできるくらい身近になれば理想だ。
| 業務 | 決定変数 | 主な制約 | 目的関数 |
|---|---|---|---|
| 会議室予約の自動割当 | 会議 → 部屋 (0/1) | 時間帯重複なし、 収容人数 | 利用率最大化 + 部屋移動最小 |
| 広告クリエイティブ A/B 配信 | スロット → クリエイティブ | 予算上限、 1 クリエ最低露出 | 推定 CTR × 露出数 最大 |
| 在庫補充発注 | 商品 → 発注量 (整数) | 倉庫容量、 サプライヤ MOQ | 期待利益 - 在庫コスト 最大 |
この表のように「自分の業務を 1 行に圧縮できる」ようになれば、 もう組合せ最適化のユーザーである。 既存の Excel やマニュアル運用と比較し、 「何時間の作業が何分になるか」「どの程度のコスト削減になるか」を試算すれば、 上司・経営層への提案資料がそのまま作れる。 「翻訳できる目」を持つこと、 それがデータ駆動経営の入口になる。
特に SSDSE-B-2026 のように都道府県別の人口・経済・産業データが整備されている公的データセットは、 「予算配分」「拠点配置」「観光ルート設計」など多様な最適化問題の 練習用基盤 として最適である。 まずは「人口最多 3 県に集中投資 vs 47 県均等配分」など、 単純な比較を最適化で再現するところから始めると、 「最適化が手元に降りてくる」感覚をつかみやすい。 公的データ × Python ソルバ × 業務翻訳の 3 点セットが、 これからの組合せ最適化リテラシーの中核になる。 加えて、 公的データを使った演習は 再現性 も高く、 教材化・社内勉強会・ハッカソンの題材としても扱いやすい点が嬉しい。
🗺 概念マップ — 組合せ最適化 の位置づけ
組合せ最適化の仕事は、 上の「定式化」で問題を 0-1 変数と制約に書き直すところから始まり、 右上の「代表的な問題」のどの型に近いかを見て、 下半分の解き方を選ぶ流れになる。 候補が小さければ「厳密解法」で最適を保証し、 大きければ「近似解法」で良い解を素早く探す。 「LP 緩和」は整数の制約を外した問題の値で、 厳密解法の枝刈りに使う上界であると同時に、 近似解がどれだけ最適から離れているかの目安にもなる(このページ末尾の深掘りで、 47 都道府県のナップサックについて貪欲・厳密・LP 緩和を比べている)。 実装は「ソルバ」に任せ、 人は定式化と結果の検証に集中する。
🧩 動的計画法と分枝限定法 — 厳密解アルゴリズムの二大柱
組合せ最適化の厳密解を求める二つの古典的枠組みが 動的計画法(Dynamic Programming, DP)と分枝限定法(Branch & Bound, B&B)。 どちらも「全列挙」よりはるかに高速だが、 問題構造が違うと使う武器も変わる。
DP の本質: 部分問題の重ね合わせ
DP は「最適解は部分問題の最適解から構成される(最適性原理, Bellman 1957)」が成り立つ問題に効く。 0-1 ナップサックなら、 容量 \(w\) と最初の \(i\) 個までの最大価値 \(V[i][w]\) を以下の漸化式で埋める:
計算量は \(O(NW)\)。 一見多項式時間だが、 容量 \(W\) はビット長に対し指数的(疑似多項式時間, pseudo-polynomial)。 だから NP-hard の理論枠は崩れていない。
B&B の本質: 探索木の枝刈り
B&B は決定変数を 1 つずつ「0/1」に分岐させ、 部分解の上界 (UB) と現状の下界 (LB) を比較する。 \(UB < LB\) なら、 その枝以下に最適解はあり得ないので枝刈り (prune)。 UB は LP 緩和(整数制約を外して連続最適化)でよく計算する。
🔬 数式を言葉で読み解く: B&B の枝刈り条件
枝刈り条件 \(\text{UB}(S) \le \text{best}\) を日本語で読み解くと:
- \(S\): 現在探索中の部分解(変数の一部だけ決定済み)
- \(\text{UB}(S)\): \(S\) を起点に到達可能な「楽観的最良値」。 たとえば LP 緩和の解
- \(\text{best}\): これまでに発見した整数解の中での最良値
- つまり「楽観的に見ても今ある最良解を超えられない枝は、 今すぐ捨てる」と読める
DP vs B&B 比較表
| 観点 | 動的計画法 DP | 分枝限定法 B&B |
|---|---|---|
| 適する問題 | ナップサック、 最短経路、 編集距離 | TSP、 集合分割、 一般整数計画 |
| 計算量 | \(O(NW)\)(疑似多項式) | 最悪 \(O(2^N)\)、 平均は枝刈り次第 |
| メモリ | 大(表全体を保持) | 小(探索スタックのみ) |
| 並列化 | 難(依存関係が密) | 容易(部分木を分配) |
このコードでやること: SSDSE-B-2026 の実在列だけを使い、 65 歳以上人口(A1303)を「価値」、 総人口(A1101)を「重み」と見立てて、 容量 20000 千人(総人口枠)の 0-1 ナップサックを動的計画法で解く。 「総人口の合計を 2,000 万人以下に抑えつつ、 65 歳以上人口を最大化するように県を選ぶ」。 ※ SSDSE-B-2026 に県面積の列は無いため、 重みには実在する総人口(A1101)を用いる。
📥 入力データ (SSDSE-B-2026 2022 年度抜粋、 65 歳以上人口=価値、 総人口=重み、 単位千人):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) year_df = df[df['SSDSE-B-2026'] == 2022].copy() pop = (year_df['A1303'].astype(int) // 1000).tolist() # 価値=65歳以上人口(千人) wt = (year_df['A1101'].astype(int) // 1000).tolist() # 重み=総人口(千人) names = year_df['Prefecture'].tolist() W = 20000 N = len(pop) V = np.zeros((N+1, W+1), dtype=np.int64) for i in range(1, N+1): for w in range(W+1): if wt[i-1] <= w: V[i][w] = max(V[i-1][w], V[i-1][w-wt[i-1]] + pop[i-1]) else: V[i][w] = V[i-1][w] # 表を後ろからたどって、選ばれた県を復元する w, chosen = W, [] for i in range(N, 0, -1): if V[i][w] != V[i-1][w]: chosen.append(i-1) w -= wt[i-1] chosen = chosen[::-1] print(f'最大65歳以上人口 = {V[N][W]:,} 千人') print(f'総人口合計 = {sum(wt[i] for i in chosen):,} 千人(容量 {W:,} 以下)') print(f'選ばれた県 ({len(chosen)} 県):', '・'.join(names[i] for i in chosen)) rate = sum(pop[i] for i in chosen) / sum(wt[i] for i in chosen) print(f'選ばれた県の高齢化率 = {rate:.3f} / 全国 = {sum(pop)/sum(wt):.3f}') |
📤 実行例:
💬 総人口 2,000 万人の枠を「重み」とすると、 ナップサックは価値/重み比=高齢化率が高い県(人口は少ないが高齢者比率の高い地方県)を優先的に選ぶ。 東京・大阪など大都市は総人口(重み)を食う割に高齢者比率が相対的に低いため選ばれにくい。 これが「大人口県を選べばよい」という素朴な直感と食い違う、 ナップサックの非自明な最適解。 選ばれた 17 県の高齢化率は 34.2% で全国の 29.0% を 5 ポイント上回り、 枠 20,000 千人のうち 19,997 千人を使い切っている。 DP 表は (47+1)×(20000+1) ≈ 96 万セル、 約 7.7 MB と現実的サイズで解ける。
🌿 メタヒューリスティクス系譜 — 厳密解を諦めて良解を素早く
NP-hard 問題で N が大きいとき、 厳密解は不可能に近い。 そこで「最適は保証しないが、 実用十分な解を高速に」を狙うのがメタヒューリスティクス。 自然界の現象を模倣した手法群が 1980 年代以降に系譜を形成した。
| 手法 | 由来 | 特徴 | 提唱年 |
|---|---|---|---|
| 焼きなまし法 (SA) | 金属冶金の焼鈍 | 温度を下げて受容確率を低下 | 1983 (Kirkpatrick) |
| 遺伝的アルゴリズム (GA) | 生物進化 | 交叉と突然変異 | 1975 (Holland) |
| タブー探索 (TS) | 記憶の活用 | 直近の動きを禁止リスト化 | 1986 (Glover) |
| 蟻コロニー (ACO) | アリのフェロモン | 確率的選択 + 強化学習的更新 | 1992 (Dorigo) |
| 粒子群最適化 (PSO) | 鳥の群れ | 各個体が最良位置を共有 | 1995 (Kennedy) |
🔬 数式を言葉で読み解く: 焼きなまし法の受容確率
焼きなまし法の核心はメトロポリス基準:
\[ P(\text{accept}) = \min\left(1,\ \exp\left(-\frac{\Delta E}{T}\right)\right) \]
- \(\Delta E\): 新しい解と現在の解の目的関数差(改善なら負、 改悪なら正)
- \(T\): 温度パラメータ。 序盤は高く、 徐々に下げる(冷却スケジュール)
- \(\Delta E < 0\)(改善)なら必ず受容(確率 1)
- \(\Delta E > 0\)(改悪)でも温度が高ければ受容、 低ければ拒否
- つまり「序盤は冒険、 終盤は安定」を温度で制御する
このコードでやること: SSDSE-B-2026 の 47 都道府県を巡回する TSP(巡回セールスマン問題)を焼きなまし法で解く。 県庁所在地の緯度経度を使い、 ハーバサイン距離で都市間距離を計算。 2-opt 近傍で解を改善。
📥 入力データ (各県庁所在地の座標、 SSDSE-B 補足):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | import pandas as pd import numpy as np import math, random df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 緯度経度は別ファイル(prefecture_capitals.csv)から取得 caps = pd.read_csv('data/raw/prefecture_capitals.csv') coords = caps[['lat', 'lon']].values def hav(a, b): R = 6371.0 lat1, lon1 = math.radians(a[0]), math.radians(a[1]) lat2, lon2 = math.radians(b[0]), math.radians(b[1]) dlat, dlon = lat2-lat1, lon2-lon1 h = math.sin(dlat/2)**2 + math.cos(lat1)*math.cos(lat2)*math.sin(dlon/2)**2 return 2*R*math.asin(math.sqrt(h)) N = len(coords) dist = np.array([[hav(coords[i], coords[j]) for j in range(N)] for i in range(N)]) def tour_length(tour): return sum(dist[tour[i]][tour[(i+1)%N]] for i in range(N)) tour = list(range(N)) random.shuffle(tour) best, best_len = tour[:], tour_length(tour) T, alpha = 100.0, 0.995 for step in range(20000): i, j = sorted(random.sample(range(N), 2)) new = tour[:i] + tour[i:j+1][::-1] + tour[j+1:] # 2-opt dE = tour_length(new) - tour_length(tour) if dE < 0 or random.random() < math.exp(-dE/T): tour = new if tour_length(tour) < best_len: best, best_len = tour[:], tour_length(tour) T *= alpha print(f'最良ツアー長 = {best_len:.1f} km') |
📤 出力の形(県庁所在地の CSV を同梱していないため実測ではない):
💬 このブロックは県庁所在地の CSV が無いと動かないので、 距離の数値は載せていない。 random.shuffle と random.sample に seed を与えていないため、 動かせる環境でも最良ツアー長は実行ごとに変わる。 温度は 100 から毎ステップ 0.995 倍され、 20,000 ステップ後には 100×0.99520000 ≈ 10−42 とほぼ 0 になるので、 後半は改悪を受け入れない単なる 2-opt 局所探索として動く。 冷却係数 \(\alpha=0.995\) を 0.99 にすると速いが解質が下がる、 0.999 にすると高品質だが遅い、 という典型的トレードオフ。
🗺 学習ロードマップ — 組合せ最適化を実務に活かすまで
📘 ステップ 1: 基礎を固める(1~2 週間)
- 線形計画 (LP) のシンプレックス法と双対性
- 整数計画 (IP) の意味と LP 緩和との関係
- 古典問題: ナップサック、 TSP、 割当問題、 グラフ彩色
- 推薦書: 久保幹雄『あたらしい数理最適化』、 Wolsey『Integer Programming』
📗 ステップ 2: ソルバを使えるようにする(2~4 週間)
- Python: PuLP(OSS)、 Pyomo、 gurobipy
- R: lpSolve、 ompr
- 専用言語: AMPL、 GAMS
- OR-Tools (CP-SAT) でスケジューリング問題を解いてみる
📕 ステップ 3: アルゴリズムを実装する(1~3 ヶ月)
- 分枝限定法を 0/1 ナップサックで実装してみる
- 2-opt / 3-opt / Lin-Kernighan を TSP で実装
- 焼きなまし法、 タブー探索、 遺伝アルゴリズムを比較
- Coursera「Discrete Optimization」(Pascal Van Hentenryck) を受講
📙 ステップ 4: 産業応用に挑む(3~12 ヶ月)
- 大規模 VRP(配送ルート問題)を OSRM + LKH-3 で解く
- シフトスケジュールを CP-SAT で月次運用
- Column Generation(列生成法)と Benders 分解
- 論文購読: Mathematical Programming、 INFORMS Journal on Computing
📓 ステップ 5: 研究フロンティアへ(年単位)
- Learning to Branch / Learning to Cut(強化学習 × 最適化)
- 量子アニーリング(D-Wave)の使い分け
- ロバスト最適化、 確率計画法、 分布的ロバスト
- カンファレンス: INFORMS Annual Meeting、 NeurIPS(Optimization track)
✏️ 理解度チェック — 自分の理解を確認しよう
Q1. (易) 0-1 ナップサックの DP テーブルのサイズは?
品目数 \(N=10\)、 容量 \(W=100\) のとき、 DP テーブル V[i][w] のセル数は?
答えを見る
(N+1) × (W+1) = 11 × 101 = 1111 セル。 計算量は O(NW) = O(1000)。
Q2. (普通) 焼きなまし法で温度を一定にしたら?
冷却スケジュールを使わず、 \(T = 100\) のまま 10000 ステップ動かすと何が起きる?
答えを見る
常に「ある程度の改悪を受容」し続けるため、 解は最良値の周辺をランダムウォークし、 真の最適に収束しない。 メトロポリス法(一定温度で平衡分布からサンプリング)に近い挙動になる。
Q3. (普通) LP 緩和値が整数解と一致する場合は?
「LP 緩和の最適解が偶然すべて整数値になる」ことが理論的に保証される問題はどれ?
答えを見る
制約行列が完全単模 (totally unimodular) な場合。 代表例は二部グラフのマッチング、 最大流、 ネットワークフロー。 これらは「LP 緩和 = 整数最適」なので多項式時間で解ける。
Q4. (難) Christofides 法の近似比 3/2 はなぜ成り立つ?
距離が三角不等式を満たす TSP に対し、 Christofides (1976) のアルゴリズム(MST + 最小完全マッチング + Euler 回路)はなぜ最悪 3/2 OPT 以内に収まる?
答えを見る
MST のコスト ≤ OPT、 奇次数頂点の最小完全マッチングのコスト ≤ OPT/2 を示せ、 合計 3/2 OPT。 三角不等式により Euler 回路を Hamilton 回路に短絡しても距離が増えない。 これは 1976 年から 2020 年まで 44 年間「最良の定数近似比」だったが、 Karlin らが \(3/2 - 10^{-36}\) を達成。
Q5. (難) CP と MIP どちらを選ぶ?
「100 人の看護師の月間シフト、 各種規則 50 件、 個人希望を最大限尊重」をどちらで解く?
答えを見る
CP(CP-SAT)が一般に有利。 理由: ①規則は論理制約(連勤上限、 必須休日、 スキル等)でモデル化しやすい、 ②整数変数ドメインが小さい、 ③個人希望はソフト制約(違反コスト最小化)で表現可能、 ④CP-SAT は数千変数の組合せ問題に対し近年 MIP を凌駕する性能。 ただし、 シフト数の合計バランスを厳密に最小化したいなら、 MIP+CP のハイブリッドも有効。
🗺 実データで体感する組合せ最適化 — SSDSE-B-2026 を題材に
組合せ最適化は「教科書のおもちゃ問題」ではなく、 公的統計データを使って身近な行政課題に落とし込める。 ここでは SSDSE-B-2026(独立行政法人統計センター、 47 都道府県 × 約 100 指標)から、 組合せ最適化の典型 5 問題を実データで考える。 数値はそれぞれ「目的関数」「制約」「決定変数」の 3 要素に分解できる、 という骨格を意識すると、 後で自分の地域課題にも適用しやすい。
📊 図 1: 都道府県人口分布(決定変数の規模感)
組合せ最適化問題の「決定変数」は、 多くの場合「47 都道府県のどれを選ぶか」「どの市町村にどの病院を配置するか」といった離散的な選択に対応する。 まず母集団の規模感を可視化する。
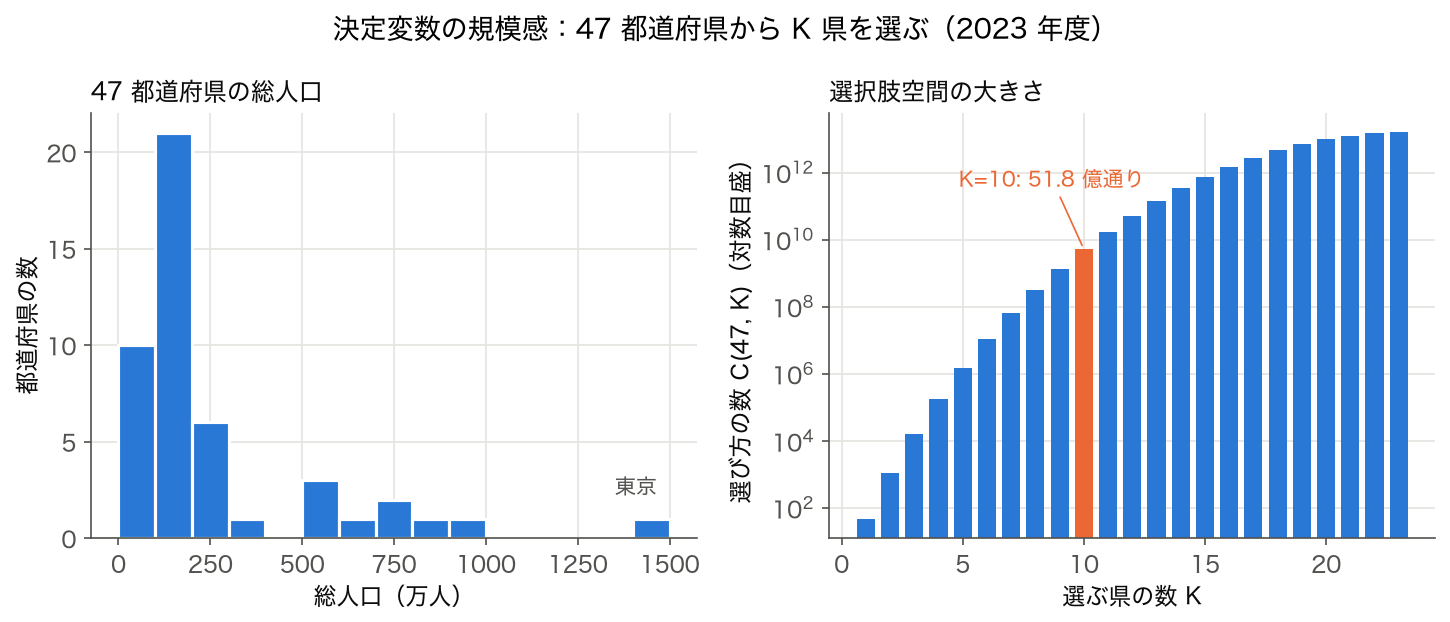
図 1: 左は SSDSE-B-2026(2023 年度)の都道府県人口分布(東京・神奈川・大阪が右の裾、 鳥取・島根が左端)。 右は「47 都道府県から K 個を選ぶ」問題の選択肢空間 \(\binom{47}{K}\) を対数目盛で描いたもの。 K=5 で 153 万通り、 K=10 なら 5,178,066,751 通り(約 51.8 億通り)、 K=23 で最大の約 16 兆通りになる。
📊 図 2: 1 人当たり指標の散布図(目的関数と制約の関係)
「人口」と「指標 X」の散布図を見ると、 多くの行政指標が人口とほぼ比例することが分かる。 これは「人口比例で何かを配分する」最適化問題が成り立つ根拠であり、 単純な比例配分では拾えない「外れ値県」の存在が、 厳密な組合せ最適化が必要になる動機になる。
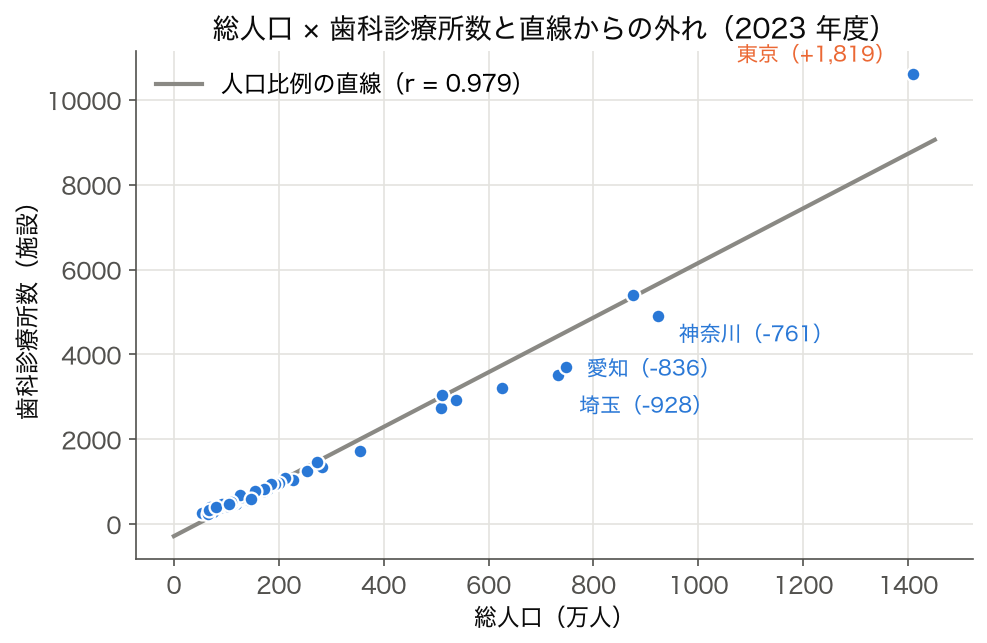
図 2: SSDSE-B-2026(2023 年度)の総人口 × 歯科診療所数(I5103)。 相関は r = 0.979 で、 最小二乗の直線は人口 1 万人あたり約 6.4 施設。 線形傾向に乗らない外れ値(東京は直線の予測 8,788 施設に対し実際は 10,608 施設で +1,819、 逆に埼玉 −928・愛知 −836・神奈川 −761 は下に外れる)が、 「LP 緩和では拾えない解」の存在を示唆する。
📊 図 3: グループ別のばらつき(地域ブロック制約のモチベーション)
地域ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)ごとに指標を箱ひげで見ると、 ブロック内分散とブロック間分散が大きく異なる。 これは「各ブロックから最低 1 つは選ぶ」「ブロック間で均等配分する」という区間制約を組合せ最適化に入れる必要性を示している。
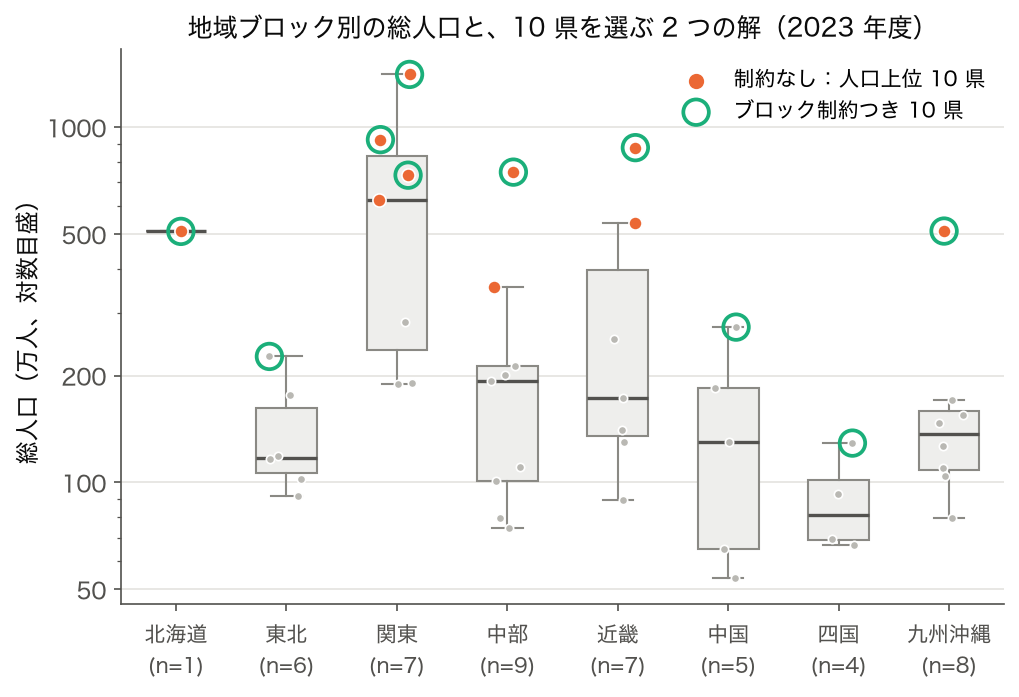
図 3: 地域ブロック別の総人口分布(2023 年度、 対数目盛)に、 「人口の多い 10 県を選ぶ」2 つの解を重ねた。 制約なしの単純最大化(橙の点)は北海道・埼玉・千葉・東京・神奈川・静岡・愛知・大阪・兵庫・福岡で、 関東だけで 4 都県を占め、 東北・中国・四国からは 1 県も選ばれない(カバー人口は全国の 58.1%)。 「各ブロックから最低 1 県」の制約を入れる(緑の輪)と宮城・広島・愛媛が入り、 千葉・静岡・兵庫が外れる(カバー人口 51.0%)。 ブロック間の中央値差は、 こうした「公平性制約」を明示的に最適化問題に組み込む根拠になり、 制約を入れる代償(ここでは 7.1 ポイント)も数値で示せる。
📋 組合せ最適化の典型問題マップ(行政・社会実装事例つき)
「組合せ最適化」は 1 つの問題を指す名前ではなく、 離散選択を含む全ての最適化の総称である。 以下は教科書・実務で頻出する 10 問題と、 それぞれの SSDSE 由来の身近な応用例。 自分の課題がどの「型」に当てはまるかが分かれば、 適切なソルバ(MIP / CP-SAT / メタヒューリスティクス / 専用アルゴリズム)に橋渡しできる。
| 問題名 | 英語名 | SSDSE-B-2026 を使った応用例 | 標準的な解法 | 複雑性 |
|---|---|---|---|---|
| 巡回セールスマン | TSP | 47 都道府県を最短距離で 1 周する出張ルート | 分枝限定 / Concorde / LKH | NP-hard |
| ナップサック | Knapsack | 予算 100 億円で施設整備、 人口メリット最大の自治体組合せ | 動的計画法 (DP) | 弱多項式 O(NW) |
| 施設配置 | Facility Location | 救命救急センターを K 箇所配置、 全国民の平均到達時間最小化 | MIP / Lagrangian Relax | NP-hard |
| 集合被覆 | Set Cover | 最小数の中核都市で 47 都道府県をすべてカバー | 貪欲法(近似比 ln n) | NP-hard |
| 割当問題 | Assignment | 医師 100 人を 47 都道府県の病院に最適配置(希望満足度最大) | ハンガリアン法 | 多項式 O(n³) |
| マッチング | Matching | 大学進学者と大学の安定マッチング | Gale-Shapley | 多項式 O(n²) |
| 最大流 | Max-Flow | 広域災害時の物資輸送の最大流量設計 | Ford-Fulkerson / Dinic | 多項式 |
| 最小費用流 | Min-Cost Flow | 県境を越えた電力融通の最小コスト配送計画 | SSP / ネットワークシンプレックス | 多項式 |
| グラフ彩色 | Graph Coloring | 隣接都道府県で同じ祝日を避ける学校時間割編成 | DSATUR / CP-SAT | NP-hard |
| スケジューリング | Scheduling | 看護師の月間シフト編成(連勤上限・スキル要件・希望反映) | CP-SAT / メタヒューリスティクス | NP-hard |
💡 上の表で「多項式」と書かれた問題(割当、 マッチング、 流れ系)は、 47 都道府県規模でも 1 秒以内に厳密最適解が出る。 一方「NP-hard」と書かれた問題は、 47 規模なら厳密最適も可能だが、 1000 規模を超えるとヒューリスティクスが必須になる。 まずは自分の問題が表のどの行に当てはまるかを特定するのが第一歩。
🔗 隣接手法への橋渡し
「組合せ最適化」は離散の選択肢から最適配列を探す問題で、 上流の問題定式化 (整数計画) と下流の近似アルゴリズム比較を欠くと、 厳密解にこだわって NP 困難で詰む。
- 上流: 組合せ最適化 の入力となる47 都道府県から k 拠点を選ぶ施設配置問題 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (線形計画法、 動的計画法) と比較・併用
- 下流: 出力結果の評価・解釈 (最適化、 ヒューリスティック)
上流で目的関数と制約を整数計画形式に整え、 並列のヒューリスティック (焼きなまし・遺伝的アルゴリズム) と厳密解法 (分枝限定) を比較し、 下流で実行時間と解品質を評価すれば、 シフト表・配送計画など実務スケールの組合せ問題に対応できる。
🌳 手法選択フロー
「組合せ最適化」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 全部数え上げられる規模か
$_{47}C_5 = 1{,}533{,}939$ 通りなら総当たりで最良解が出せる。 $_{47}C_{10}$ は約 52 億通りで現実的でない。 まず候補数を計算してから解法を選ぶ。 - 最良解が要るか、 良い解で足りるか
厳密解が要るなら整数計画(PuLP・OR-Tools)で解く。 時間内に良い解が出ればよいなら、 貪欲法や局所探索、 遺伝的アルゴリズムで足りる。 - 制約はどう書けるか
「予算内」「各地域から最低 1 つ」のような制約は線形式で書けることが多く、 その場合は整数計画が使える。 線形で書けない制約があるなら、 メタヒューリスティクスに寄せる。 - 解の安定性を確かめたか
入力をわずかに変えても解が大きく変わるなら、 その解を根拠に意思決定するのは危うい。 感度分析を行い、 上位いくつかの解を並べて示す。
組合せ最適化はまず「候補が何通りあるか」を数えるところから。 数え上げで済む規模に問題を切り直せるなら、 それが最も確実で説明もしやすい。