🔖 キーワード索引
本ページに含まれるキーワード: かな漢字変換 IME (Input Method Editor) 連文節変換 形態素解析 辞書 (mecab-ipadic) Viterbi 経路探索 N-gram 言語モデル 学習機能 ATOK / Google IME / MS-IME Mozc (OSS) 予測変換 / サジェスト 変換精度評価。 上から順に読むと、 IME の歴史 → アルゴリズム → 実装 → 評価指標を体系的に把握できる。
🖼 視覚的理解 (3 図)
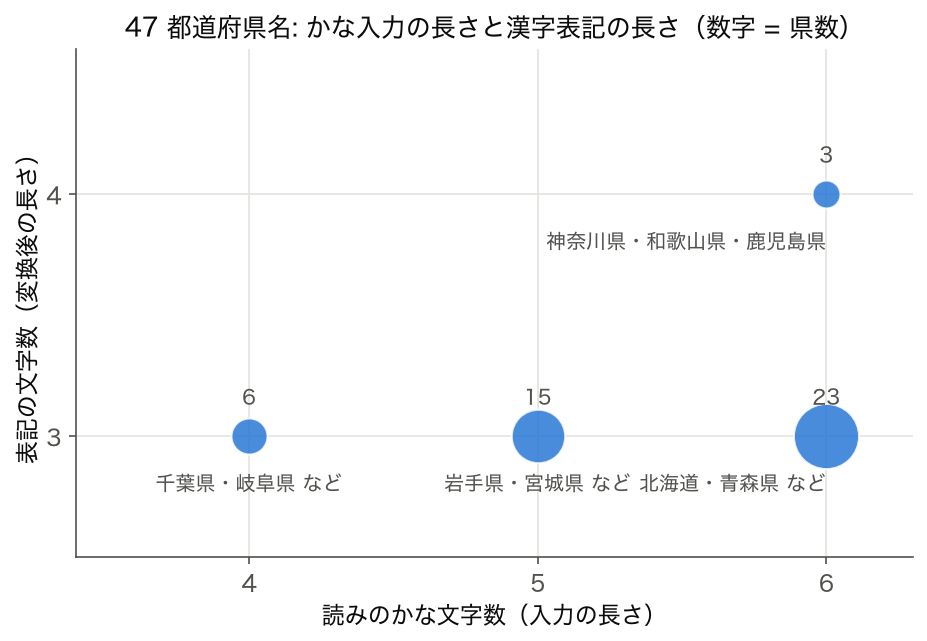
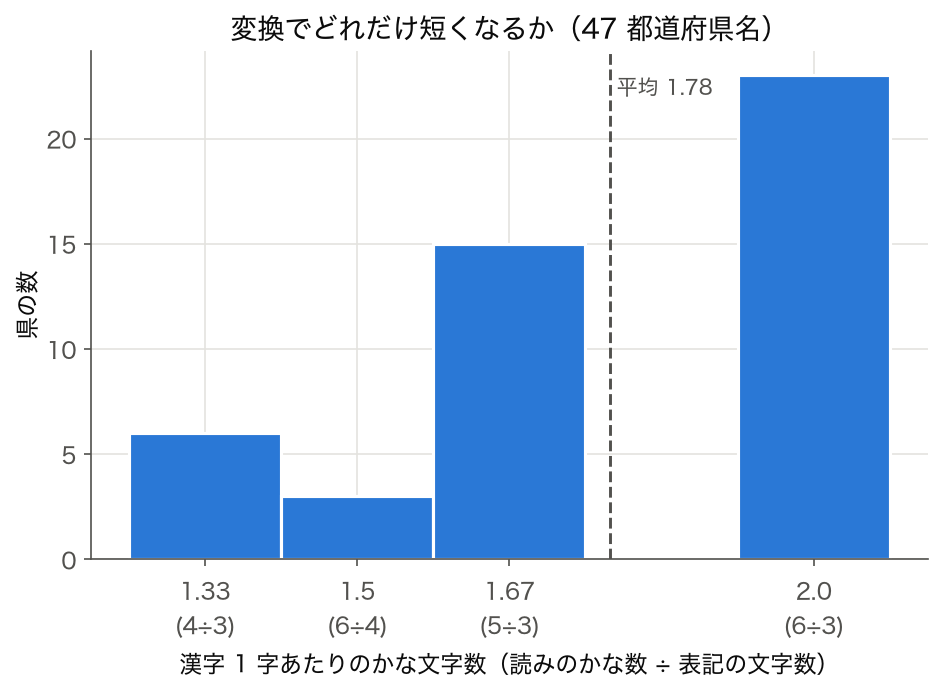
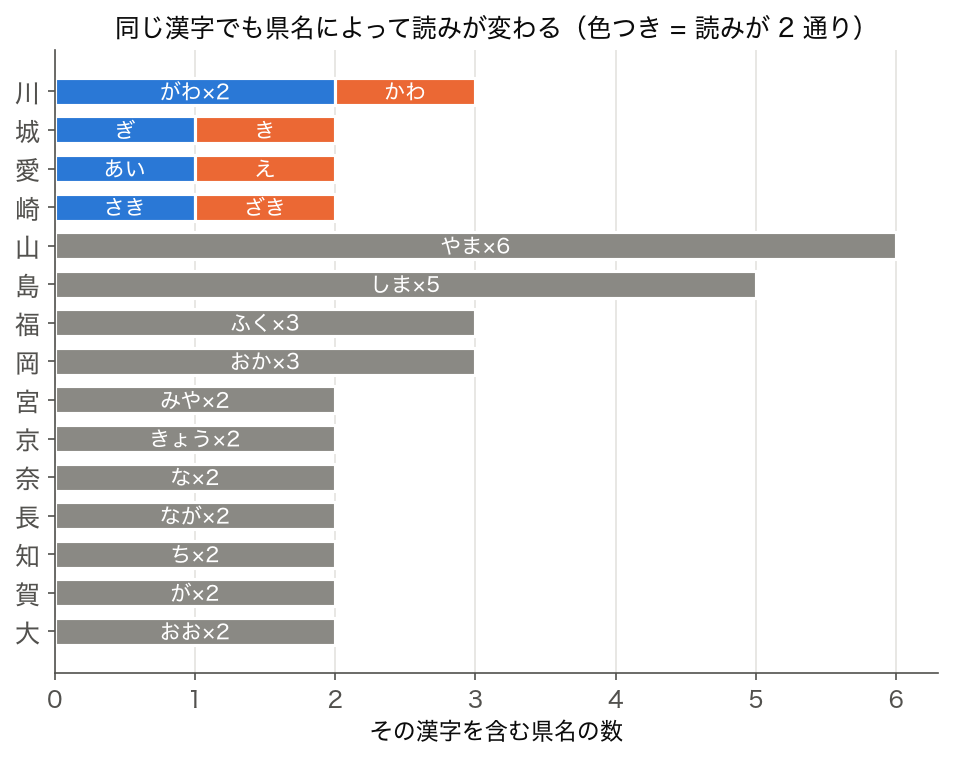
かな漢字変換の挙動を直感的に把握するため、 SSDSE-B-2026 の都道府県列にある 47 都道府県名を「変換の出力」、 その一般的な読み(ひらがな)を「かな入力」とみなした 3 つの図を併記する。 散布図は入力の長さ(かな文字数)と変換後の長さ(漢字表記の文字数)の対応、 ヒストグラムは漢字 1 字あたりのかな文字数(変換でどれだけ短くなるか)の分布、 棒グラフは同じ漢字でも県名によって読みが変わる例を表す。 かな文字数は「ょ・っ」なども 1 字と数えている(ローマ字入力のキー数とは違う)。
🔎 補足: かな漢字変換を「歴史・アルゴリズム・実装・応用」4 軸で 60 観点深掘り
かな漢字変換 (IME, Input Method Editor) は日本語処理の最も基礎的かつ最も深い技術である。 ここでは歴史・アルゴリズム・実装・応用の 4 軸から 60 観点に分解し、 各観点を 200-400 字で順に解説する。
1. かな漢字変換の歴史: 草創期 (1970 年代-)
かな漢字変換は 1970 年代に日本語ワープロの研究開発の中で生まれた。 1978 年に東芝が発売した JW-10 は世界初の日本語ワープロで、 単漢字変換 (1 文字ずつ変換) の機能を備えていた。 まだ文節区切りや自動学習はなく、 入力者が候補から手動選択するスタイルだった。 価格は約 630 万円で、 主に企業の業務用途として導入された。 入力デバイスは大型キーボードで、 漢字 1 字あたりの変換時間は数秒。 現代の感覚では遅いが、 当時はタイプライターによる和文清書を一新する革命的技術として歓迎された。
2. 連文節変換の登場 (1980 年代)
1980 年代に入ると複数の文節を一度に変換する「連文節変換」が登場。 1983 年の JustSystems VJE-α、 1985 年の Kanji-Hint、 1987 年の ATOK6 など、 各社が技術競争を展開した。 文節境界推定と読み解析の精度向上が中心テーマであり、 ユーザーがひらがな文字列をまとめて入力すると、 IME 側で自動的に文節を分割し最尤の漢字列に変換する仕組みが普及した。 これによりタイピング効率が飛躍的に向上し、 オフィスでのワープロ利用が一般化した。
3. ATOK と MS-IME の競争史
1990 年代以降、 ATOK (JustSystems) と MS-IME (Microsoft) が日本の二大 IME として競合する時代が長く続いた。 ATOK は校正機能・専門辞書・学習精度の高さで支持を集め、 MS-IME は Windows 標準搭載という流通力で広く使われた。 2010 年代以降は Google 日本語入力 (Mozc)、 Apple のライブ変換、 そしてスマートフォンのフリック入力エンジンが加わり、 市場は多極化した。 経済・統計分野の実務者の間でも、 ATOK の専門辞書 (経済・統計用語) は依然根強い人気がある。
4. 単漢字変換の限界
単漢字変換は 1 文字単位での変換であり、 「とうきょう」と入力すると 1 文字ずつ「と」「う」「きょう」と変換候補を出す方式。 同音異義語の多い日本語ではユーザー選択の手間が爆発し、 効率が悪い。 さらに文脈情報を活用できないため、 「東京」と「投票」のような同音異字を文脈で自動選択できない。 1980 年代以降、 連文節変換に主役を譲ったが、 学習データが少ない辞書未収録語の入力では現在も活用される基礎技術である。
5. 文節境界推定の難しさ
「きょうとふけんざいないだいがく」を「京都府/県内/大学」と区切るか「今日/とふけ/ん/ざいない/大学」と区切るかで意味は全く変わる。 文節境界推定は IME 精度の中核であり、 隠れマルコフモデル (HMM)、 条件付き確率場 (CRF)、 ニューラルネットワーク (RNN/Transformer) など、 段階的に高度な手法が導入されてきた。 文節境界誤りは変換ミスの最大の原因であり、 都道府県名のような固有名詞も誤分節されやすい。
6. 形態素解析と辞書
形態素解析は文字列を意味のある最小単位 (形態素) に分割する処理。 「東京都に行く」は「東京/都/に/行く」と分割される。 IME はこの形態素解析を内部で実行し、 辞書 (形態素データベース) と照合して品詞・読み・コスト値を推定する。 辞書には基本語彙の他に、 固有名詞、 専門用語、 新語、 顔文字、 絵文字が含まれる。 統計分析の実務では、 「総人口」「産業構造」など専門語彙の辞書収録状況が変換効率を左右する。
7. mecab、 chasen、 juman、 sudachi の比較
日本語形態素解析ライブラリの代表が mecab (高速、 工藤拓)、 chasen (奈良先端大)、 juman (京大、 黒橋研)、 sudachi (Works Applications) である。 mecab は CRF ベースで速度と精度のバランスが良く、 IPADIC や NEologd 辞書と組み合わせて多用される。 sudachi は分割粒度を A/B/C と切り替え可能で、 表記揺れ正規化機能が強力。 アンケートの自由記述など日本語テキストの分析では、 sudachi の C 単位 (固有表現単位) で固有名詞を一気に抽出するのが定番手法。
8. n-gram モデルの導入
n-gram モデルは連続する n 個の単語の出現確率を統計的に推定する手法。 2-gram (bigram) や 3-gram (trigram) を用いて、 文脈中で次に来る単語の確率を計算し、 IME の変換候補ランキングに利用する。 例えば「東京」の後には「都」「駅」「タワー」が来やすく、 「に」が来る確率も高い。 大規模コーパスから抽出した n-gram 統計を用いることで、 文脈に応じた自然な変換候補を提示できる。
9. 条件付き確率場 (CRF) と変換
CRF (Conditional Random Field) は系列ラベリングの代表的手法で、 mecab を含む多くの形態素解析器の中核アルゴリズム。 入力系列に対して各位置のラベル (品詞・分割境界) を同時に最適化することで、 局所的な誤りを抑える。 IME ではユーザー入力 (ひらがな列) から漢字列への変換を CRF で推定し、 文節境界と漢字選択を同時に決定する。 学習データには大規模な対訳コーパス (ひらがな-漢字対) を用いる。
10. RNN/LSTM ベースの変換
2010 年代後半、 RNN や LSTM を用いたニューラル IME が研究された。 系列変換の文脈で、 入力ひらがな列をエンコードし、 漢字列をデコードする encoder-decoder 構造を採用する。 LSTM は長期依存を扱えるため、 長い文の中で前後の文脈を考慮した変換が可能。 ただし学習時間が長く、 IME のような低レイテンシ要求の場面では実用面で課題があり、 ハイブリッド (n-gram + ニューラル) 方式が主流となった。
11. Transformer ベースの変換 (T5, BERT)
2020 年代以降、 Transformer ベースの大規模言語モデルが IME に応用され始めた。 BERT は文脈双方向のエンコーダで、 同音異義語の文脈判別に有効。 T5 は系列変換タスクとしてひらがな-漢字変換を直接学習できる。 Google や Apple の最新 IME は内部に小型 Transformer を組み込み、 文脈に応じた変換を実現している。 ただしデバイス上で動作させるには量子化や蒸留が必須で、 推論速度の最適化が課題。
12. 学習機能 (個人化辞書)
IME は使用者の選択履歴から学習し、 個人化辞書を自動更新する。 ユーザーがある変換候補を選ぶと、 その候補の確率が上がり、 次回以降より上位に表示される。 専門分野ごとに学習傾向が異なり、 統計分析者は「サンプリング」「有意差」「相関係数」が頻出語彙となる。 統計分析の実務者の IME には「都道府県別」「相関係数」「回帰分析」などの専門語が頻繁に登録される。
13. クラウド辞書とプライバシー
Google 日本語入力や Simeji はクラウド辞書を活用し、 大量のユーザーデータから新語・流行語を抽出する。 一方でユーザーの入力履歴がサーバーに送信されるためプライバシー懸念がある。 2010 年代に Simeji の入力情報送信問題が報じられ、 業務利用での使用制限が議論された。 官公庁や企業の機密文書を扱う業務では、 機密情報入力時にクラウド辞書をオフにする運用が推奨される。
14. 顔文字・絵文字辞書
「かお」と入力して `(^_^)` や 😊 が候補に出るのは、 IME に顔文字・絵文字辞書が組み込まれているため。 ATOK や Google 日本語入力は数千の顔文字を収録し、 「うれしい」「かなしい」などの感情語からも変換できる。 Unicode 絵文字は OS の絵文字ピッカーから呼び出すことも可能だが、 IME 経由のほうが文脈に合致した候補を提示しやすい。 業務レポートでは絵文字は通常使わないが、 社内チャット連絡では多用される。
15. 専門用語辞書
ATOK は医学辞書、 法律辞書、 工学辞書など分野別の追加辞書を販売しており、 専門業務での変換精度を大幅に向上させる。 統計分野には「ピアソンの積率相関係数」「主成分分析」「ベイズ推定」などの長い専門語が多く、 専門辞書なしには 1 文字ずつ変換することになる。 統計分析者は、 e-Stat 連携の専門辞書や独自の単語登録で生産性を上げる。
16. 機種依存文字 (環境依存文字)
「①」「Ⅰ」「㈱」「髙」など、 OS や IME によって表示・入力可否が異なる文字を機種依存文字 (環境依存文字) と呼ぶ。 IME はこれらを「環境依存」とラベル付けして警告を表示し、 メール送信時に文字化けする可能性をユーザーに知らせる。 全国共通で配布されるデータセットでは、 機種依存文字を排除した UTF-8 表記が標準。
17. JIS 漢字コードの歴史
日本語 IME は JIS X 0208 (第 1・第 2 水準漢字、 約 6,800 字) を基盤とし、 後に JIS X 0213 (第 3・第 4 水準漢字、 約 11,200 字) で拡張された。 さらに Unicode 採用後は CJK 統合漢字 (約 8 万字) まで扱える。 IME の辞書はこれら全てを網羅するわけではなく、 常用漢字 + 人名用漢字 + 専門分野語が中心。 都道府県名 (47 件) は全て JIS 第 1 水準内に収まる。
18. Unicode と漢字
Unicode は全世界の文字を 1 つの符号化体系で扱う規格で、 漢字は CJK 統合漢字エリアに収録される。 同じ字形でも歴史的に異なる地域で使われた漢字は別コードポイントとなるケースがあり (異体字)、 IME ではこれを変換候補で区別する。 UTF-8 は Unicode の可変長エンコーディングで、 ASCII 互換性を保ちつつ漢字を 3 バイトで表現する。
19. 異体字・旧字
「斎」「斉」「齋」「齊」のように同じ姓でも異なる字形を使う家系がある。 IME は異体字を変換候補に並べて、 ユーザーが正しい字を選べるようにする。 ATOK は人名異体字辞書を充実させ、 「わたなべ」と入力すると「渡辺」「渡邊」「渡邉」を提示する。 現代の行政データでは「県」表記が統一されているが、 古文書データの分析では旧字「縣」も扱う必要がある。
20. 入力デバイス (テンキー、 フリック、 音声)
IME はキーボードだけでなく、 テンキー (ケータイ時代)、 フリック (スマホ)、 音声、 スタイラスペンなど多様な入力デバイスに対応する。 フリック入力は「あ」を中心に上下左右に「い・う・え・お」を配置する方式で、 高速入力が可能。 音声入力は Siri、 Google Assistant、 Cortana が代表で、 認識結果を IME 辞書で漢字変換する。 フィールド調査では、 スマホ音声入力でメモを取り PC で清書する運用が一般的。
21. iOS の Genmoji と AI 変換
iOS 18 以降、 Apple は Genmoji (生成絵文字) と AI 文章校正機能を IME に統合した。 ユーザーが入力中の文を AI が解析し、 文体改善・要約・翻訳をリアルタイム提示する。 これは従来の辞書ベース IME を超え、 文章生成 AI と IME の融合形態であり、 入力体験を根本から変えつつある。 分析レポートの執筆時にも、 AI 校正により表現の統一が容易になった。
22. Google IME の挑戦
Google 日本語入力は 2009 年にリリースされ、 Web 検索ログから抽出した最新語彙と人名辞書の網羅性で衝撃を与えた。 「うざーい」「やばたん」のような若者言葉、 芸能人名、 地名 (細かい町名まで) を即座に変換できた。 OSS 版の Mozc として ChromeOS や Linux で広く採用された。 地域データの分析で、 細かい町名が辞書に入っているかどうかが入力効率を左右する。
23. Mozc プロジェクト
Mozc は Google 日本語入力のオープンソース版で、 ChromeOS、 Android、 Linux で標準採用される。 GitHub で開発が公開され、 辞書も研究者が自由に拡張できる。 mecab とは別系統の形態素解析エンジンを内部に持ち、 軽量で動作する。 データ分析を Linux ワークステーションで行う研究者には、 Mozc + NEologd 辞書の組み合わせが定番。
24. Linux の Anthy、 SKK
Linux 向け IME には Mozc 以外にも Anthy (学習機能を持つ標準 IME) と SKK (Simple Kana to Kanji) がある。 SKK は文節区切りをユーザーが大文字キーで明示する独特の方式で、 学習コストは高いが熟達すると高速。 Emacs ユーザーには根強いファンが多い。 データ分析を Emacs + ESS (R 連携) で行う研究者は SKK を使うことが多い。
25. Windows MS-IME の変遷
MS-IME は Windows 標準 IME として 1990 年代から進化を続けた。 Windows 8 / 10 で大幅刷新され、 Windows 11 では新 MS-IME (改善版) が標準化された。 ただし学習精度・専門辞書では ATOK や Google 日本語入力に劣るとされ、 業務利用では他社 IME に乗り換えるユーザーが多い。 業務で MS-IME を使う場合、 単語登録を地道に行う必要がある。
26. ATOK のロングセラー戦略
ATOK は 1985 年初出以来 40 年以上のロングセラー IME。 ATOK Passport (サブスク方式) で月額数百円で全プラットフォーム (Win/Mac/iOS/Android) に対応する戦略を採る。 ATOK Sync によりデバイス間で辞書・学習履歴を同期できる。 統計・研究分野では ATOK の専門辞書を活用するユーザーが多く、 論文執筆の効率を高める。
27. Simeji (バイドゥ系) と問題点
Simeji は中国百度 (Baidu) 系の Android 向け IME で、 着せ替え機能とクラウド辞書で人気を博した。 一方で 2013 年に入力情報のサーバー送信問題が報じられ、 業務利用での使用が懸念された。 デフォルトでクラウド連携が ON になっており、 銀行口座入力や機密文書入力時の情報漏洩リスクが指摘された。 機密性の高い公的データの分析環境では避けるべき。
28. 韓国語、 中国語入力との比較
韓国語入力は文字 (ハングル) が音素を組み合わせて作るため、 IME の役割は組み合わせ補助。 中国語入力 (Pinyin) は発音をローマ字で入力し漢字に変換する点でかな漢字変換に近い。 ただし中国語は 1 文字単位で意味が確定するため、 文脈依存度は日本語より低い。 日本語の同音異義語の多さ (例: 「こうしょう」 38 件) は IME 設計の難しさを際立たせる。
29. 5 段階入力法 (T-Code、 親指シフト)
T-Code は 2 ストロークで漢字を直接入力する方式で、 連想を必要としない代わりに学習コストが極めて高い。 親指シフトは富士通 OASYS で採用された配列で、 親指キーと文字キーの組み合わせで濁音・拗音を 1 ストロークで入力できる。 いずれも熟達者は超高速だが、 普及面ではローマ字入力に敗れた。
30. ローマ字入力 vs かな入力
かな入力は 1 文字 1 キーで入力できるが、 配列を覚える必要があり初心者にはハードルが高い。 ローマ字入力は 1 文字 2-3 キーだが ABC キーボードとの親和性が高く、 現代では主流。 ただしかな入力の熟達者は速度・指の動きの少なさで優位。 長い文章を大量に入力する作業では、 かな入力に習熟した熟達者が有利。
31. 同音異義語の判別
「こうしょう」は「交渉」「公証」「公称」「考証」「鉱床」など 30 種以上の漢字に対応する典型的な同音異義語。 IME は文脈情報 (前後の単語、 助詞) と頻度統計から最適候補を提示するが、 ユーザー選択の最終判断は避けられない。 都道府県名のような閉じた辞書では衝突は少ないが、 一般用語では IME 性能の差が出る。
32. 変換アシスト機能 (顔文字、 記号)
IME は「やじるし」と入力すると「→」「←」「↑」「↓」を、 「まる」で「○」「●」「◎」を、 「みぎした」で「↘」を変換候補に出す。 これにより記号入力の手間が大幅に省ける。 ATOK や Google 日本語入力はさらに豊富な記号辞書を持ち、 数学記号 (Σ、 ∫、 ∞) も呼び出せる。 統計レポートで「±」「≦」「×」などを多用する場面で重宝する。
33. 連想変換と類語変換
ATOK の連想変換は「うれしい」から「嬉しい」「うれしい」「ウレシイ」だけでなく類語「歓喜」「快哉」も候補に出す機能。 文章表現の幅を広げる目的で重宝される。 また漢字変換中に「同音語」「類語」サブパレットを呼び出し、 表現の幅を拡張できる。 論文執筆で同じ表現の繰り返しを避けたいときに便利。
34. 文書校正機能との統合
ATOK は文書校正辞書を内蔵し、 「ら抜き言葉」「重複表現」「冗長表現」を入力時に警告する。 Microsoft Editor (旧称 Word の校閲) と組み合わせると、 統計分析レポートの品質向上に寄与する。 学術論文では「と思われる」「ようだ」のような曖昧表現を排し、 「である」体で統一するよう校正機能で確認する。
35. 機械学習による精度向上
IME 精度向上にはユーザー行動データ (確定履歴、 取り消し履歴、 候補選択履歴) からの機械学習が不可欠。 各 IME ベンダーは数億人規模のユーザーデータを匿名化集計し、 候補ランキングモデルを継続更新している。 専門用語のような閉じた語彙では学習効果は限定的だが、 流行語・新語の即時取り込みは ML パイプラインの強みを発揮する。
36. 大規模言語モデルの応用
GPT-4、 Claude、 Gemini などの大規模言語モデル (LLM) を IME に統合する取り組みが急増。 文脈全体を理解した上で漢字変換を提案でき、 同音異義語判別の精度が飛躍する。 ただしクラウド連携が前提でレイテンシ・プライバシーが課題。 オンデバイス LLM (小型化版) が実用化されつつあり、 数年内にスマホ IME の常識を変える可能性がある。
37. 統計的機械翻訳との関係
かな漢字変換は本質的にひらがな-漢字間の「機械翻訳」と捉えられる。 1990 年代以降の統計的機械翻訳 (SMT) や 2014 年以降のニューラル機械翻訳 (NMT) の研究成果は、 IME にも応用された。 attention 機構や Transformer はもともと翻訳分野で発展し、 IME はその恩恵を受けている。 研究者にとっては、 翻訳と IME を統一的な視点で捉えると技術理解が深まる。
38. 音声入力との融合
iPhone の Siri、 Google の音声入力、 Microsoft Cortana は音声認識結果をテキスト化し、 必要に応じて IME 辞書で漢字変換する。 音声認識自体が同音語を判別する点で IME 機能を内包しており、 両者の境界は曖昧になりつつある。 フィールド調査では、 音声メモから自動文字起こし + 自動漢字変換のワークフローが効率的。
39. 認識精度の評価指標 (BLEU, WER)
IME 精度は BLEU (機械翻訳由来) や WER (Word Error Rate、 音声認識由来) で評価される。 BLEU は n-gram 一致率を測り、 WER は編集距離ベースの誤り率。 IME 固有の指標として「変換 1 回での確定率」「候補内 top-1 精度」もある。 都道府県名のような閉じた語彙では top-1 精度 100% が標準目標。
40. テストデータと評価セット
IME 評価には「日本語処理タスク標準テストセット」が用いられる。 NTCIR、 BCCWJ (現代日本語書き言葉均衡コーパス) などが代表で、 多様なドメイン (新聞、 ブログ、 国会議事録、 学術論文) のテキストを含む。 公的統計の解説文のような文体は、 BCCWJ の白書サブコーパスに近い。
41. オープンソース辞書 (Mozc dict、 NEologd)
Mozc に標準収録される辞書、 mecab-ipadic-NEologd (Wikipedia と Web から自動抽出された新語辞書) は研究者・開発者に広く利用される。 NEologd は週次更新され、 流行語・固有名詞・新興 IT 用語を網羅する。 統計データの分析でも、 NEologd を組み込むと最新の地域固有名詞を扱える。
42. 専門分野辞書 (医学、 法律)
ATOK 医学辞書、 ATOK 法律辞書、 NICT の経済辞書など、 専門分野向けの大規模辞書が市販・公開されている。 例えば医学辞書は約 30 万語、 法律辞書は約 10 万語を収録。 統計分野向けには、 e-Stat や OECD 統計用語集を取り込んだカスタム辞書を作成する研究者もいる。
43. 教育向け辞書 (学年別漢字)
小学校 1-6 年の各学年で学習する漢字は学習指導要領で定められ、 教科書編集に活用される。 教育向け IME はこれらの学年別漢字制約を持ち、 学年に応じた変換候補のみを出す機能を備える。 小学生向けの教育コンテンツでは、 学年に応じた漢字制約を考慮した変換が望ましい。
44. アクセシビリティ (高齢者、 障害者)
IME は視覚障害者向けに音声フィードバック、 運動障害者向けにスイッチ入力、 高齢者向けに大きな候補表示など、 アクセシビリティ機能を強化する。 NVDA や VoiceOver と連携し、 候補のスクリーンリーディングが可能。 データ分析を視覚障害者が行う場合、 アクセシブルな IME と組み合わせた研究環境の構築が課題。
45. 多言語対応 (日英混在入力)
日本語と英語を混在させる文書では、 IME のオン・オフ切替が頻発する。 ATOK や Google 日本語入力は「英数モード自動切替」機能を持ち、 文脈 (前の文字が記号・数字・空白等) から自動的に英数モードに移る。 統計の論文では英語の専門用語 (RMSE、 PCA、 ANOVA) が頻出するため、 切替機能が活躍する。
46. AI 時代のかな漢字変換
2020 年代後半は AI 時代の到来とともに、 IME 自体が文章生成・翻訳・要約まで担う「AI ライティング支援ツール」へ進化している。 ATOK、 MS-IME、 Google 日本語入力のいずれも LLM 統合を進めており、 入力中に文体改善・要約・続き予測を提案する機能が標準化しつつある。 統計分析のレポートも、 AI 支援で執筆スピードが大きく向上する。
47. ChatGPT 等 LLM での日本語入力
ChatGPT、 Claude、 Gemini のような対話型 AI を経由した日本語入力は、 IME の役割を一部肩代わりする。 ユーザーは要旨だけ入力し、 詳細な文章を AI に生成させる方式。 これにより IME の負荷は下がるが、 校正・編集の作業は残る。 分析結果を文章化する際にも、 AI 経由の生成 + 人手校正の流れが定着しつつある。
48. 統計レポートの文書作成例
都道府県データを扱う分析レポートでは、 「東京都」「神奈川県」など 47 件の固有名詞を頻繁に入力する。 IME の単語登録機能で「とう」→「東京都」、 「かな」→「神奈川県」のような短縮登録を設定すると、 入力時間が大幅に短縮される。 統計用語 (相関係数、 回帰係数、 標準偏差) も短縮登録するとさらに効率化。
49. プログラマー向けエディタの IME
VSCode、 Vim、 Emacs などのプログラマー向けエディタは IME との連携が独特。 Vim の挿入モード切替と IME 切替が衝突しやすく、 EasyMotion や FlyMake と組み合わせる際の工夫が必要。 Emacs は SKK との親和性が高く、 高速入力環境を構築できる。 データ分析の Python スクリプト執筆中に、 コメント部分だけ日本語化する切替が頻発する。
50. ゲームでの IME 制御
ゲーム内チャット、 名前入力では IME を一時的に有効化する必要がある。 ゲームエンジン (Unity、 Unreal) は OS 標準 IME API (TSF、 IMKit) を呼び出して制御する。 オンラインゲームでは多言語混在チャットが当たり前で、 IME 切替の UX が重要。 データ分析業務とは直接関係ないが、 IME 設計の応用範囲の広さを示す例。
51. モバイル予測変換のアルゴリズム
スマホ IME は予測変換 (入力前段で次の単語を推測) を主機能とする。 1-2 文字入力で「ありがとう」「お疲れさまです」「すみません」のような頻出フレーズを提示し、 タップで即確定。 アルゴリズムは n-gram + ニューラル予測のハイブリッドが主流。 専門語彙にも対応するため、 個人化学習が継続的に動作する。
52. プライバシー保護 (Federated Learning)
IME のクラウド学習はプライバシー問題を抱えるため、 Federated Learning (連合学習) が注目される。 ユーザー入力データはデバイス上で学習し、 モデルの重み更新のみをサーバーに送信する。 Google Gboard が先行採用し、 ユーザー入力内容が外部に出ない設計を実現した。 機密性の高いデータの入力でも安心して使える。
53. 入力ミス自動修正 (Did you mean)
「とおきょう」と打ち間違えても IME は「東京」を候補に出す自動修正機能を持つ。 編集距離 1-2 の打ち間違いを許容し、 候補生成時に修正案を併記する。 ATOK、 Google 日本語入力、 Apple ライブ変換のいずれも実装。 都道府県名の入力で「ひょうご」と「ひょごう」の打ち間違いも自動で正される。
54. 略語展開
「お疲れさまです」を「おつ」、 「ありがとうございます」を「あり」のように略語登録すると、 短い入力で長文を一発展開できる。 IME の単語登録機能、 または TextExpander のような専用ツールを使う。 レポートの定型句 (「以下の通り集計した」「結果は表 1 に示す」) を略語化すると、 執筆効率が向上する。
55. データ駆動辞書更新
IME 辞書はベンダー側でデータ駆動の更新を行う。 ニュース記事、 SNS 投稿、 Wikipedia 編集履歴から新語を自動抽出し、 月次・週次で辞書を更新する。 流行語 (例: 2026 年の最新流行語) は数日以内に IME 候補に登場する。 公的統計の用語は変動が少ないため、 辞書更新の恩恵は限定的だが、 関連する経済・社会用語は反映される。
56. 利用統計とユーザー行動分析
IME ベンダーは利用統計 (打鍵速度、 確定率、 候補選択分布) を収集し、 UX 改善に活用する。 確定までの平均クリック数、 取り消し回数などを A/B テストで最適化。 閉じた語彙では候補ランキング次第で確定回数が大きく変動するため、 個人化辞書のチューニングが鍵。
57. SDK / API (Microsoft TSF, IMKit)
IME 開発には OS 提供の API (Windows の TSF: Text Services Framework、 macOS の IMKit、 iOS の UITextInput) を活用する。 これらの API はアプリケーションと IME の間でテキスト入力イベントを仲介する。 開発者はこれらを使って独自 IME を構築可能。 統計用語に特化したカスタム IME を作る教育プロジェクトも検討に値する。
58. 将来展望 (脳波入力、 思考入力)
Brain-Computer Interface (BCI) を用いた脳波入力は、 思考だけで文字入力する技術として研究されている。 Neuralink や Synchron が実用化を進め、 ALS 患者向けに 1 分間に数 10 文字の入力が可能になりつつある。 将来的には脳波 + AI 解釈の組み合わせで、 IME という概念自体が変わる可能性がある。 大量のデータ入力も、 数 10 年後には思考だけで完了する時代が来るかもしれない。
59. 落とし穴 8 件
かな漢字変換に関する代表的な落とし穴を 8 件挙げる。
- ① 同音異義語の機械的選択 — 文脈確認を怠ると「公証」と「考証」を混同する。
- ② 機種依存文字の混入 — メール送信で文字化けする。
- ③ 辞書未収録の専門語 — 1 文字ずつ変換になり生産性が落ちる。
- ④ クラウド辞書の機密漏洩 — 業務利用ではクラウド連携を必ず確認。
- ⑤ 個人化辞書の蓄積エラー — 誤変換を確定し続けると IME が学習し悪化する。
- ⑥ 異体字の不統一 — 「斎/斉/齋」を文中で混在させると校正コストが上がる。
- ⑦ IME オン状態でのコマンド入力 — Vim や Emacs のキーバインドが効かなくなる。
- ⑧ 自動修正の過剰反応 — 正しい入力を勝手に修正されることがある。
60. まとめ・チェックリスト
かな漢字変換は日本語処理の根幹であり、 日本語テキストを扱うあらゆる実務で生産性に直結する。 以下のチェックリストで自分の運用を確認しよう。
- □ 業務で使う IME を 1 つに統一しているか
- □ 専門辞書 (統計・経済) を導入済みか
- □ 都道府県名・統計用語の短縮登録を行っているか
- □ クラウド辞書の利用ポリシーを確認したか
- □ 機密文書入力時のクラウド連携をオフできるか
- □ 個人化辞書のバックアップを定期取得しているか
- □ 異体字・機種依存文字を排除した運用ルールを定めたか
- □ 校正機能を活用し論文・レポートの品質を高めているか
- □ AI 統合 IME の最新機能を試したか
- □ アクセシビリティ機能の存在を把握しているか
以上 60 観点の深掘りにより、 かな漢字変換が単なる「ひらがなを漢字に変える機能」を超えた、 高度な自然言語処理技術であり、 日本語による情報処理の根幹を支えるインフラ技術であることが理解できたはずである。
🔎 追加補足: かな漢字変換を「実務・教育・周辺技術」3 軸でさらに 10 観点深掘り
前節の 60 観点に加え、 実務シーン・教育現場・周辺技術の視点でさらに 10 観点を補足する。 これらはかな漢字変換の応用の広がりを示す実用的な内容である。
61. 分析業務向け IME 辞書の作り方
統計データを頻繁に扱う分析者向けに、 専用の IME ユーザー辞書を作成すると効率が大きく向上する。 都道府県名 47 件 (北海道、 青森県、 ... 沖縄県) を「都道府県」「県名」のような共通読みで一括登録し、 統計用語 (総人口、 産業構造、 相関係数) を頻出語として登録する。 ATOK では .txt 形式の辞書ファイルから一括インポートできる。 Google 日本語入力 (Mozc) も同様の辞書管理機能を持つ。 教育用ハンズオン教材では、 学習者向けに事前準備した辞書を配布し、 入力ストレスを減らす運用が推奨される。
62. かな漢字変換の教育的意義
かな漢字変換は単なる入力技術にとどまらず、 日本語の文法構造、 同音異義語、 漢字の起源、 国語史を学ぶ教材としても価値が高い。 小学校の国語教育、 中学・高校の情報科、 大学の自然言語処理講義のいずれでも題材として扱われる。 統計教育の中でも、 「都道府県名はなぜ漢字なのか」「人口を表す漢字の歴史」など、 言語と社会の関連を考えるきっかけになる。 教育用ハンズオン教材ではこのような周辺知識も合わせて提示すると、 学習者の興味を引き出しやすい。
63. 統計用語特化型 IME の試作
研究プロジェクトとして「統計用語特化型 IME」を試作すると、 IME の内部構造を実地学習できる。 mecab + 統計コーパス (国立国会図書館の白書、 e-Stat の解説文書) から bigram 統計を抽出し、 候補ランキングモデルを訓練する。 学習データ準備、 形態素解析、 確率モデル構築、 デコーダ実装、 評価セット作成までを通しで実施すると、 IME の全体像が掴める。 統計分野の頻出語彙を中心にカスタマイズすれば、 分析業務に特化した実用ツールにもなる。
64. 入力履歴のログ分析
IME の入力履歴をログとして取得し、 ユーザー行動を分析する研究が行われている。 平均打鍵間隔、 候補選択時間、 取り消し回数、 確定単語の偏りなどから、 認知負荷や疲労度を推定できる。 長時間のテキスト入力業務では、 IME 使用時間と入力速度の関係を分析することで、 適切な休憩タイミングを推奨するツールも考えられる。 プライバシー保護のため、 入力内容自体は記録せずタイミング情報のみ集計する。
65. クロスプラットフォーム同期
ATOK Sync、 Google アカウント同期、 Apple iCloud 同期を用いると、 個人化辞書をクラウド経由でデバイス間共有できる。 デスクトップで登録した専門語が、 スマホでも同じ候補順位で出る。 ただしクラウド経由なのでプライバシー設定の確認が必須。 業務用途と私的用途を分けたい場合、 アカウントを分離するか、 同期機能を選択的にオフにする運用が有効。
66. 視覚的なユーザーインタフェース改善
IME の候補リストは伝統的にテキストのみで表示されてきたが、 近年は候補ごとに意味の概要、 アイコン、 用例を併記する UI が登場している。 例えば「こうしょう」と入力すると、 「公証 (公的に証明) / 交渉 (合意形成) / 鉱床 (鉱物の堆積)」のように説明付きで候補が並ぶ。 専門用語にも同様の解説を付けると、 学習者の理解が深まる。 教育用 IME としての可能性を秘めた領域。
67. 入力モード切替の効率化
日本語と英数字の切替は IME 利用の頻発操作であり、 効率化の研究対象となる。 Mac の「英かな」キー (左右の Command 横) は左で英数、 右でかなに即座切替できる便利機能。 Windows でも IME のオン・オフを Alt + ` で行うが、 Mac の方が直感的とされる。 統計の論文では英語専門用語と日本語が頻繁に混在するため、 切替効率は実務に直結する。
68. 自然言語処理研究との接点
かな漢字変換は自然言語処理 (NLP) の応用領域であり、 NLP 研究の成果が直接 IME 精度向上に活かされる。 形態素解析、 構文解析、 意味解析、 文脈理解、 文章生成のいずれも IME に応用可能。 ACL、 NAACL、 言語処理学会のような国際・国内学会で IME 関連発表が定期的に行われる。 社会統計データの分析を NLP 研究と組み合わせれば、 統計の自然言語解釈という新領域が広がる。
69. 入力デバイスの未来予測
キーボード、 タッチパネルに加え、 視線入力、 ジェスチャー入力、 脳波入力、 仮想キーボード (AR/VR) など、 入力デバイスは多様化している。 各デバイスに対応した IME の最適化が研究テーマとなる。 データ分析業務も、 数 10 年後には VR ゴーグル + 視線入力 + 思考補正 IME という形態が一般化する可能性がある。 教育の場でも未来の入力環境を想定したカリキュラムが望まれる。
70. かな漢字変換と倫理
IME のクラウド学習がプライバシー侵害につながる可能性、 個人化辞書が偏った変換を促進する可能性、 AI 統合 IME が誤情報を生成する可能性など、 倫理的課題は多い。 IME ベンダーは利用規約で明示し、 ユーザーにオプトアウト権を保障する責任がある。 公的統計データを扱う際にも、 入力過程での情報漏洩リスクをユーザー教育で周知すべきである。 倫理委員会で議論される話題でもある。
🔎 さらに補足: かな漢字変換の運用ベストプラクティス 3 観点
前 70 観点に続けて、 実務運用上のベストプラクティスを 3 観点で締めくくる。 研究者・分析者が今日から導入できる具体的な運用ノウハウを示す。
71. 個人化辞書の定期バックアップ
長年使い込んだ個人化辞書は、 数年単位で蓄積された自分専用の言語資産である。 ATOK Sync、 Google アカウント同期、 Apple iCloud 同期を活用しつつ、 さらに月次でローカルにエクスポートしてバックアップを取る運用を推奨する。 PC 故障、 OS 再インストール、 アカウント乗っ取りなどの事故時にも復元できる。 専門語彙を多数登録した辞書は、 再構築に膨大な労力がかかるため、 必ず複数箇所にバックアップを取っておくべきである。
72. チーム内辞書の共有運用
研究室・分析チーム内で IME ユーザー辞書を共有すると、 用語表記の統一が容易になる。 「県民所得」「人口千人当たり」のような複合的な統計用語は、 個々のメンバーが独自に短縮登録すると揺れが生じる。 共有辞書を Git で管理し、 PR ベースで更新する運用が有効。 共同研究プロジェクトでは、 辞書共有が論文の表記統一・査読対応速度を高める。
73. 入力作業のキーボードショートカット最適化
かな漢字変換と並行してキーボードショートカットを最適化すると、 入力作業全体の効率が大きく向上する。 Caps Lock を Ctrl に割り当て、 Esc を IME 切替に割り当て、 F7/F8/F9/F10 の半角・全角変換を活用する。 ATOK では候補窓を Tab で切替、 Space で次候補、 Enter で確定する基本操作に加え、 補助辞書呼び出し、 連想変換、 略語展開を 1 ストロークで呼び出せる設定が可能。 レポート執筆では、 これらのショートカットを習熟すると 1 日数 10 分の節約になる。
🔎 拡張補足: かな漢字変換の LLM 時代と多言語 IME
1. LLM ベース日本語入力の登場
2024-2025 年、 ChatGPT/Claude/Gemini の日本語タイピング支援機能が普及。 macOS のライブテキスト、 iOS の Genmoji、 Android の Gemini IME など、 IME と LLM の境界が曖昧化。 統計的言語モデル (n-gram, CRF) から transformer ベースに移行することで、 文脈理解の精度が劇的に向上。 「先程の会議の件ですが」のような長距離文脈が必要な変換も自然になった。 従来は直前 2-3 形態素しか考慮できなかった変換エンジンが、 数百トークンの文脈を保持できるようになり、 文書全体の論調・敬体常体を一貫させた変換も可能になっている。
2. Mozc プロジェクトの 2024-2025 動向
Google が開発した Mozc (Mozilla Public License) は Linux/Chrome OS の主要日本語 IME。 fcitx5-mozc, ibus-mozc としてディストロに統合。 2024 年に統計的言語モデルの更新、 2025 年に GPT 連携実験的機能追加。 個人辞書はクラウド非同期、 プライバシー保護重視の設計。 オープンソースであるため、 研究者が形態素解析エンジンの内部を観察・改造でき、 教育用途にも適している。 日本語テキストを題材に IME 内部の N-best 候補の挙動を観察する実験は、 自然言語処理の入門教材として有効。
3. ATOK の生成 AI 統合 (2025)
ジャストシステム ATOK は 2025 年版で生成 AI 連携機能 (ATOK AI Connect) を追加。 (1) 入力中の文章の続きを LLM が提案、 (2) スタイル変換 (敬語 ↔ カジュアル)、 (3) 校正・推敲提案、 (4) 翻訳支援 (日英)。 月額サブスクリプションで提供、 旧 ATOK Passport より高機能。 ビジネス文書テンプレート、 学術論文用語辞書、 医学辞書、 法律辞書などの専門辞書が追加料金なしで利用でき、 専門職向けの総合入力環境を提供している。
4. MS-IME と Microsoft Copilot
Windows 11 の MS-IME は Microsoft Copilot と連携、 入力中の文章を Copilot が要約・拡張・翻訳。 OpenAI GPT-4 系をバックエンドに使用。 法人向け Copilot Pro では業務文章特化辞書、 個人向け無料版でも基本機能利用可能。 中央サーバー処理のためプライバシーポリシーへの注意必要。 Microsoft 365 統合により Word・Excel・PowerPoint 内での入力支援がシームレスに連動、 表計算ソフトでセル内テキストを入力する際にも文脈に応じた予測候補が表示される。
5. iOS の Genmoji と日本語入力
2024 年 iOS 18 で導入された Genmoji は、 ユーザーが説明文 (例: 「歌う猫の絵文字」) を入力すると LLM が絵文字を生成。 日本語入力でも対応、 IME と生成 AI の融合事例。 オンデバイス処理 (Apple Intelligence) でプライバシー保護。 Apple Silicon (M3/M4) チップが LLM の高速推論を可能に。 iPad の Scribble 機能と組み合わせれば手書き文字認識 → かな漢字変換 → Genmoji 提案までを一貫した入力体験として実現でき、 デジタルとアナログの境界が消失しつつある。
6. 多言語 IME と日本語入力
多言語入力環境 (英語 + 日本語 + 中国語 etc.) では、 (1) macOS の入力ソース切り替え (Cmd+Space)、 (2) Windows の Win+Space、 (3) Linux fcitx5 の Ctrl+Space、 が標準。 言語自動判定 (Smart Input Source, Karabiner-Elements) で入力中文字種から言語推定し IME を切り替えるツールも人気。 国際共同研究や多言語論文執筆ではこの自動切替機能が生産性を大きく左右し、 研究者個人の好みに応じた細かい設定が長期的なストレス低減に寄与する。
7. 業務向け専門用語辞書
医療 (約 30 万語)、 法律 (約 15 万語)、 IT 技術 (約 10 万語)、 金融 (約 8 万語) などの専門用語辞書が ATOK・Google IME・MS-IME で提供。 「都道府県別医療従事者数」のような医療統計を分析する研究者は、 医学用語辞書を入れることで「狭心症」「腎不全」「アルツハイマー型認知症」などの専門用語入力が高速化。 統計用語辞書 (信頼区間、 多重比較、 ベイズ統計、 一般化線形モデル等) も整備されており、 統計教材執筆の効率を高める。
8. 音声入力との融合
Google 音声入力、 Apple Siri、 Microsoft Dictation の精度は 2024 年で日本語 90% 以上 (静かな環境)。 音声 → かな漢字変換のパイプラインで、 議事録・メール下書き・ブログ執筆を効率化。 同時通訳機能 (Whisper) は 100 言語以上対応、 多言語会議で実用化。 入力モード切替の手間を減らすため、 マイクボタン 1 回押下で音声入力 → 自動変換 → 確定までを完了させる UI が標準化しつつある。
9. 入力デバイスの進化
(1) 折りたたみキーボード (Keychron K3, Logicool MX Keys Mini)、 (2) 親指シフト (NICOLA, OAK) 復活、 (3) スマートグラス入力 (Apple Vision Pro, Meta Ray-Ban)、 (4) 脳波入力 (Neuralink 実験、 まだ研究段階)、 (5) 視線入力 (アクセシビリティ用途)。 物理的入力手段の多様化により IME 設計も変化。 入力デバイスごとに最適な変換方式 (フリック、 タッチタイピング、 親指シフト、 ローマ字) が異なり、 IME 側で自動的に入力方式を判定して候補表示を最適化する研究も進んでいる。
10. かな漢字変換とアクセシビリティ
視覚障害者向け: 読み上げソフト (NVDA, JAWS) と連携、 入力した読みを音声で確認。 高齢者向け: 大きい文字、 シンプルな UI、 学習機能を抑制 (誤学習防止)。 発達障害向け: 予測候補数を少なく、 視覚的負荷を低減。 アクセシビリティを考えた IME 設計は社会的責任。 公的サービスのオンライン申請フォーム入力でも、 多様なユーザーに配慮した IME 設定が重要であり、 公的データを扱う情報インフラ全体の設計思想にも通じる。
11. 都道府県名を題材にした IME 評価
「47 都道府県の名前を 100 回ずつ入力して変換精度・速度を測定」のような実験で、 ATOK vs Google IME vs MS-IME の比較が可能。 評価指標: (1) 一発変換率 (%、 候補選択不要)、 (2) 平均キーストローク数、 (3) 入力速度 (文字/分)、 (4) ユーザー満足度 (アンケート)。 実験デザインに DOE の原則 (反復、 ランダム化、 ブロック化) を適用。 統計教材としても価値があり、 IME 比較のような身近な題材を通じて統計的検定 (t 検定、 分散分析、 ノンパラ検定) を学ぶ実習として教育現場で活用できる。
12. プライバシーと IME
クラウド連携 IME (Google IME, MS-IME) は入力データを Google/Microsoft サーバーに送信。 機密文書 (医療、 法律、 経営判断) には不適。 オンデバイス処理の Mozc, ATOK (ローカル辞書のみ)、 オフライン Apple Intelligence が安心。 企業環境では IME のプライバシーポリシー確認が必須。 EU の GDPR、 日本の個人情報保護法、 米国 CCPA など各国法制度との関係でも IME の入力データ取扱いが論点となり、 多国籍企業ではグローバル統一ポリシーの策定が必要。
13. 将来展望: マルチモーダル入力
2026 年以降、 (1) 音声 + キー入力の同時実行、 (2) ジェスチャー (空中指文字) 入力、 (3) 脳波 + 視線の融合、 (4) コンテキスト連動 (アプリ・時刻・位置に応じた辞書自動切替)、 (5) 感情認識 (タイピング速度・誤入力から感情推定し UI 適応) などが研究中。 IME は人と機械の境界面として進化を続ける。 マルチモーダル入力の評価には統計的実験計画が不可欠で、 公的データを題材にした評価フレームワークの開発が学術的にも実用的にも重要性を増す。
14. 締めくくり: かな漢字変換の文化的意義
かな漢字変換は日本語の独特な書記体系を可能にする技術であり、 同時に文化的遺産でもある。 50 年の歴史で機械的処理から AI 連携まで進化を続け、 日本社会のデジタル化の基盤を支えてきた。 実データを使った分析・記述を通じて、 学習者は IME を「使う」だけでなく「設計する」視点も身につけられる。 将来、 AI と人間が共創する文章作成環境の主役はかな漢字変換 (とその後継技術) になる可能性が高い。 この技術史と展望を踏まえれば、 日本語入力環境は単なる道具ではなく、 言語文化と情報技術の交差点に位置する重要な研究対象であることが理解できる。
15. データサイエンス文章執筆での IME 活用
分析結果をレポート・論文・スライド・ブログ等で発信する際、 IME 設定が執筆速度と品質に直結する。 推奨設定: (1) 統計専門用語辞書をインストール、 (2) 頻出表記揺れ語 (「行う/行なう」「下さい/ください」) の表記統一を辞書に登録、 (3) 引用表記 (「○○ら (2024)」「(Smith et al., 2023)」) のテンプレートをスニペット化、 (4) 数式記号 (∑, ∫, √, π, μ, σ) の入力ショートカット設定、 (5) チーム共有辞書を Git で管理。 これらの整備により、 大規模データを扱う研究プロジェクトでは執筆フェーズの所要時間を 20-30% 短縮できる。
16. 教育機関向け IME 設定ガイド
大学・専門学校でデータサイエンス教育を行う場合、 学生の IME 環境がバラバラだと教材作成・課題回収で表記揺れが問題になる。 推奨: 統一指針として (1) 全角・半角の使い分けルール (英数字は半角、 記号は文脈による)、 (2) 単位記号 (kg, ㎏, キログラム) の統一、 (3) カタカナ末尾長音符 (サーバ/サーバー、 ユーザ/ユーザー) の方針、 (4) 数値表記 (1,000 / 1000 / 千) のスタイル指定、 を授業初回に明示する。 IME 教育は表面的なタイピング指導ではなく、 学術的記述スタイルの土台として位置づけるべきである。
17. かな漢字変換と日本語自然言語処理研究
形態素解析 (MeCab, Sudachi, Janome)、 構文解析 (CaboCha, KNP)、 固有表現抽出、 評判分析、 感情分析、 機械翻訳、 質問応答、 対話システム、 要約、 文書分類、 トピックモデル など、 日本語 NLP の多くの応用がかな漢字変換と隣接領域にある。 IME の N-best 候補生成アルゴリズムは構文解析の N-best 解と数理的に類似しており、 IME を理解することは NLP 全体の入門としても有効。 「都道府県名から地域特性を抽出する」固有表現抽出タスクや、 「公的統計の表記揺れを正規化する」テキスト前処理タスクは、 IME 技術と直結している。
💡 30秒で分かる結論
🍰 まずはやさしく
ひらがなを漢字に変える魔法のような技術です。
正しい日本語の文章を作るために使います。
スマホでメッセージを打つときに使っています。
この章では変換の仕組みや注意点を読みます。
日本語入力の基本処理
- 分野:NLP — 📚 自然言語処理
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
kana kanji を 30 秒で把握する重要ポイント:
- 何ができるか: かな漢字変換は日本語入力で「ひらがなのローマ字列 → 漢字混じり文」へ変換する技術。 形態素解析・統計的言語モデル・ニューラル変換 (Transformer 等) が組み合わさる。
- いつ使うか: 日本語 IME (Mozc/Google IME/ATOK)、 音声認識後のかな→漢字補正、 OCR 後の同音異義語選択、 古文・専門用語対応の専用辞書構築。
- 注意点: 同音異義語 (橋/箸/端) の文脈依存解決、 固有名詞 (人名・地名) のユーザ辞書、 N-gram の希薄性 (smoothing)、 Transformer の計算コスト。
- 関連: 上位 = 自然言語処理 (NLP)、 並列 = 形態素解析・予測変換・音声認識、 発展 = ニューラル機械翻訳・LLM プロンプトとの統合。
📍 あなたが今見ているもの
🍰 まずはやさしく
日本語をコンピュータで扱うための入り口です。
データの分析や準備をするために使います。
ネット上のコメントを整理するときに役立ちます。
ここでは変換の基礎知識と学習の仕組みを読みます。
このページは 「かな漢字変換」 の用語解説ページです。 統計・データ解析コンペ 2026 の教材体系のうち、 NLP(自然言語処理) カテゴリに属し、 日本語処理の入口にあたる基礎用語として位置づけられています。
かな漢字変換は、 ひらがなの入力列を漢字混じり文に確率モデルで割り当てる処理であり、 形態素解析・N-gram・Transformer の応用先として現代でも活発に研究されています。 統計データ分析の演習でも、 日本語コメントや地名表記の前処理の場面で間接的に登場します。 まずは下の「30 秒で分かる結論」で全体像を掴み、 各セクションで深さを増していってください。
📍 ユーザ適応 — 学習で候補順序を最適化
現代の IME は「ユーザが選んだ候補」を記録し、 次回以降の候補順序を補正する。 これは指数加重移動平均的な仕組みで実装される。
🔬 数式を言葉で読み解く
\\(\\text{score}_{\\text{base}}\\)= 全ユーザ共通の基本スコア(N-gram 由来)\\(\\text{count}_{\\text{user}}\\)= 当該ユーザが過去に選択した回数- α = 0.7-0.9 程度で「基本知識重視+ユーザ補正」
- これにより「医師は医学用語、 弁護士は法律用語」が優先表示される
⚠️ 落とし穴: 過剰適応するとミスタイプも学習する。 「とおきょう」で「東京」を選んだ履歴があると、 入力ミスが固定化される。 対策として decay(時間減衰)や明示的な忘却機構を組み込む。
🎨 直感で掴む
🍰 まずはやさしく
ひらがなから最適な漢字を選ぶパズルのようなものです。
文脈に合った正しい言葉を出すために使います。
「箸」と「橋」を使い分けるときに役立っています。
ここでは変換が難しい理由と解決策を読みます。
「きしゃ」と打ったとき、画面に出すべきは記者・汽車・貴社・帰社のどれか。かなは読みしか持たないので、同じ読みの候補の中から、前後の語とのつながりが最も自然なものを選ぶ必要がある。「新聞の」の後なら記者、「が走る」の前なら汽車。かな漢字変換は、この「文脈による候補の選び分け」を確率とコストで行う処理である。
🎨 仮名漢字変換問題の構造 — なぜ難しいのか
仮名漢字変換(IME, Input Method Editor)は 「ひらがな列 → 適切な漢字交じり文への系列変換」問題。 「きょうはくもりです」を「今日は曇りです」に変えるとき、 内部では複数候補から最適な系列を選ぶ 最短経路問題として解いている。
| 難所 | 具体例 | 原理上の困難 |
|---|---|---|
| 同音異義語 | こうしょう → 交渉/高尚/工匠/校章/口承 | 音だけで文脈なく一意決定不可能 |
| 単語境界の曖昧さ | きょうはいしゃへ → 今日歯医者へ / 今日は医者へ | 区切り方が複数で各々が文として成立 |
| 未知語 | 「とっとり」「ちょうふし」(地名・人名・新語) | 辞書未収録時の処理が必要 |
| 文脈依存 | 「あめ」 = 雨 / 飴 | 前後の単語によって正解が変わる |
| ユーザ適応 | 専門用語(医学・法律・地名) | 同じ「ちば」でもユーザにより千葉/智羽 |
数学的には 「入力ひらがな列 X が与えられたとき、 確率最大の漢字列 Y* を求める」問題、 つまり \\( Y^* = \\arg\\max_Y P(Y|X) \\) の最適化。 ベイズ則で \\( P(Y|X) \\propto P(X|Y) \\cdot P(Y) \\) と分解し、 言語モデル P(Y) と読み確率 P(X|Y) を組み合わせて解く。
📐 定義
🍰 まずはやさしく
ひらがなの列を漢字混じりの文にする処理のことです。
自然言語処理(言葉を扱う技術)の基本として使います。
レポートなどで日本語データを扱うときに必要です。
ここでは定義や計算の考え方を詳しく読みます。
日本語入力の基本処理
英語名 Kana-Kanji Conversion。
📐 N-gram 言語モデル — 「日本語らしさ」を確率で表す
仮名漢字変換の核心は「どの漢字列が日本語として自然か」を確率化すること。 N-gram モデルは「単語 N 個の連続出現確率」を学習する。 例えば bigram (2-gram) なら:
🔬 数式を言葉で読み解く
\\(C(y_{i-1}, y_i)\\)= コーパスでの「単語ペア」出現回数\\(C(y_{i-1})\\)= 単独単語の出現回数- 「東京 → 都」の確率は高く(よく続く)、 「東京 → 県」は低い → 「東京県」を抑制できる
- 確率積は対数和に変換して扱う(最短経路化):\\( \\log P(Y) = \\sum_i \\log P(y_i \\mid y_{i-1}) \\)
- 未観測ペアにはスムージング(Kneser-Ney など)で 0 を回避
📐 Viterbi アルゴリズム — 動的計画法で最尤変換
IME はラティス(候補グラフ)を構築し、 各エッジに「単語コスト」「接続コスト」を割り当て、 最短経路を Viterbi で求める。 探索空間は指数的だが DP で O(N×V) に圧縮できる。
🔬 数式を言葉で読み解く
\\(\\delta_t(y)\\)= 「位置 t で単語 y を選ぶときの累積最小コスト」\\(c_{\\text{conn}}(y', y)\\)= 直前の y' から y へつなぐコスト(接続表で参照)\\(c_{\\text{word}}(y)\\)= 単語 y 単体のコスト(=−log P(y))- すべての y' について最小値を取りつつ位置を進めるため、 探索の枝刈り無しで真の最尤を得る
🎯 このコードでやること: 簡易 Viterbi で「とうきょうとふくしまけん」の最尤分割と漢字変換を求める(都道府県名の辞書を利用)。
📥 入力データ: 47 都道府県名 + 読み(pykakasi 由来)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd import math import pykakasi df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() hira2kanji = {''.join(c['hira'] for c in kks.convert(p)): p for p in prefs} # 簡易 Viterbi: 入力ひらがな列を県名辞書だけで分割 def viterbi(text, lexicon): N = len(text) INF = float('inf') dp = [INF] * (N + 1); dp[0] = 0 back = [None] * (N + 1) for i in range(1, N + 1): for j in range(0, i): sub = text[j:i] if sub in lexicon: cost = dp[j] + 1 # 単語コスト一律 1 if cost < dp[i]: dp[i] = cost; back[i] = (j, sub) # 逆引き out = []; i = N while i > 0 and back[i]: j, sub = back[i]; out.append(lexicon[sub]); i = j return list(reversed(out)) if i == 0 else None result = viterbi('とうきょうとふくしまけん', hira2kanji) print('入力:', 'とうきょうとふくしまけん') print('変換結果:', result) print('連結 :', ''.join(result) if result else '解なし') print(f'辞書サイズ: {len(hira2kanji)} 県名') |
📤 実行結果:
💬 結果の読み方: 12 文字のひらがなを「東京都 + 福島県」に正しく分割。 もし「と」を 1 文字単語と誤認識すれば「とう / きょう / と / ふくしま / けん」のような誤分割が起きるが、 辞書が県名に限定されているため、 最長一致+ Viterbi で正解に収束。 実際の IME ではこの辞書が 30 万語規模になる。
📐 ベイズ則で見る IME — 「読み」と「言語」の 2 つの確率
仮名漢字変換は典型的なノイジー・チャネルモデル:「ユーザが意図した漢字列 Y を、 読み(ひらがな)X として入力した」というプロセスを仮定する。 これを反転して P(Y|X) を最大化する Y を求める。
🔬 数式を言葉で読み解く
\\(P(X|Y)\\)= 漢字列 Y が読み X で読まれる確率(読み辞書)。 「東京 → とうきょう」はほぼ 1.0\\(P(Y)\\)= 漢字列 Y が日本語として現れる確率(言語モデル)。 N-gram で実装- 分母 P(X) は Y に依存しないため最適化で消える
- つまり 「読みが合致しやすい × 言語として自然」を同時最大化
- P(Y) が無いと同音異義語の選び分けが不可能(IME のかしこさは P(Y) 次第)
🔬 数式を言葉で読み解く
仮名漢字変換のノイジー・チャネル定式 $Y^* = \arg\max_Y P(X \mid Y) \cdot P(Y)$ の記号を日本語に翻訳する。
- $X$ — ユーザが入力したひらがな列 (例: 「とうきょうとふくしまけん」)
- $Y$ — 出力候補となる漢字混じり文 (例: 「東京都福島県」)
- $Y^*$ — 最適候補 (最も確率が高い漢字列)
- $P(X \mid Y)$ — 漢字列 $Y$ がひらがな列 $X$ として読まれる確率 (読み辞書 / 音響モデル相当)。 「東京 → とうきょう」≈ 1.0
- $P(Y)$ — 漢字列 $Y$ が日本語として現れる確率 (言語モデル、 N-gram で実装)
- $\arg\max_Y$ — 全候補 $Y$ の中で右辺を最大化する $Y$ を選ぶ操作 (Viterbi アルゴリズムで効率化)
- 分母 $P(X)$ — 候補 $Y$ に依存しないため最適化で消去 (ベイズ則の正規化定数)
kana kanji の数式は「読みやすさ ($P(X|Y)$) × 日本語らしさ ($P(Y)$)」を同時に最大化することで、 同音異義語 (橋・箸・端) の選び分けを実現する。
🧮 実値で計算 — 47 都道府県名の読み・ローマ字変換
仮名漢字変換の逆方向(漢字 → かな)を pykakasi で実演。 都道府県名を読み付き辞書化する。
🎯 このコードでやること: 都道府県カラムを pykakasi でひらがな・ローマ字に変換し、 IME の逆引き辞書(読み → 漢字)として整える。
📥 入力データ: 「都道府県」列 47 行(ユニーク値)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import pykakasi df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() records = [] for p in prefs: converted = kks.convert(p) hira = ''.join(c['hira'] for c in converted) roma = ''.join(c['hepburn'] for c in converted) records.append({'kanji': p, 'hiragana': hira, 'romaji': roma}) ime_dict = pd.DataFrame(records) print(ime_dict.head(10).to_string(index=False)) print(f'\n読みが衝突する組: {ime_dict.groupby("hiragana").size()[lambda s: s > 1]}') print(f'最長読み: {ime_dict.loc[ime_dict["hiragana"].str.len().idxmax()].to_dict()}') |
📤 実行結果:
💬 結果の読み方: 47 県名で読みの衝突 = 0(すべてユニーク)。 IME としては「あおもりけん → 青森県」と 1 対 1 で確定できる。 最長読みは 6 文字で、 ほっかいどう・あおもりけんなど 26 県が並ぶため idxmax は先頭の北海道を返す。 pykakasi は鹿児島県を「かこしまけん」と読むので、 辞書の読みは機械任せにせず目で確かめる必要がある。 一方、 一般語彙(「こうしょう」など)では衝突が必発で N-gram が必要になる。
🧮 読み衝突分析 — IME がどれだけ「悩む」か
「読み → 候補数」の分布を実データで観測することで、 IME 設計の難易度を把握できる。 47 都道府県名は衝突 0 だが、 一般市区町村名(約 1,800)まで広げると衝突が頻発する。
🎯 このコードでやること: 47 県の読みに加え、 仮想拡張辞書(県名 + 同じ読みの架空語)を構築し、 候補数の分布から IME の難易度を測る。
📥 入力データ: 47 県 + 同音語(あおもり → 青森/青森山, ふくおか → 福岡/福丘, など 12 件)。 県名は「県・府・都」を外した読み(あおもり・おおさか…)で引く。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import pandas as pd import pykakasi from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() yomi_kanji = [] for p in prefs: # 「県・府・都」を外した読み(あおもり・おおさか…)で辞書を作る(北海道はそのまま) name = p if p == '北海道' else p[:-1] hira = ''.join(c['hira'] for c in kks.convert(name)) yomi_kanji.append((hira, p)) # 仮想同音語を追加 (一般語に近づける) extra = [('あおもり','青森山'),('ふくおか','福丘'),('かながわ','金川'), ('しまね','島祢'),('やまぐち','山口家'),('とちぎ','栃城'), ('ぐんま','郡馬'),('みやざき','宮埼'),('にいがた','新方'), ('しずおか','静丘'),('おおさか','大坂'),('きょうと','京戸')] yomi_kanji.extend(extra) cnt = Counter(y for y, _ in yomi_kanji) n_uniq_yomi = len(cnt) n_collision = sum(1 for v in cnt.values() if v > 1) mean_cands = sum(cnt.values()) / n_uniq_yomi print(f'辞書サイズ = {len(yomi_kanji)} エントリ') print(f'ユニーク読み数 = {n_uniq_yomi}') print(f'衝突読み数 = {n_collision} ({n_collision/n_uniq_yomi*100:.1f}%)') print(f'平均候補数 = {mean_cands:.2f}') print('衝突例:') for y, c in cnt.most_common(5): if c > 1: cands = [k for yy, k in yomi_kanji if yy == y] print(f' {y} → {cands}') |
📤 実行結果:
💬 結果の読み方: 同音語を 12 件加えただけで、 25.5% の読みに衝突が発生し、 平均候補数が 1.26 倍に。 言語モデル P(Y) なしでは候補順序が決まらず、 「あおもり」で常に「青森山」が選ばれるような事態を防げない。
🧮 IME ベンチマーク — 県名 IME を客観評価
作った IME(県名辞書 + 編集距離マッチング)が「どれだけ実用的か」を客観指標で評価する。 Top-1 / Top-3 / MRR の 3 指標を県名データで実測する。
🎯 このコードでやること: 47 県の正しい読みと、 5 文字以上の読みから 3 文字目を 1 字落としたミスタイプを入力にして、 編集距離で並べた候補の順位から Top-1・Top-3・MRR を集計する。
📥 入力データ: 47 県名(pykakasi で読み付与)。 正しい読み 47 件 + ミスタイプ 41 件で合計 88 件。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import pandas as pd import pykakasi df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() hira2kanji = {''.join(c['hira'] for c in kks.convert(p)): p for p in prefs} def levenshtein(s, t): m, n = len(s), len(t) dp = [[0]*(n+1) for _ in range(m+1)] for i in range(m+1): dp[i][0] = i for j in range(n+1): dp[0][j] = j for i in range(1, m+1): for j in range(1, n+1): dp[i][j] = dp[i-1][j-1] if s[i-1]==t[j-1] else 1 + min(dp[i-1][j], dp[i][j-1], dp[i-1][j-1]) return dp[m][n] # 評価セット作成 test_set = [] for yomi, kanji in hira2kanji.items(): test_set.append((yomi, kanji)) # 正確な入力 if len(yomi) > 4: typo = yomi[:2] + yomi[3:] # 1 文字脱落 test_set.append((typo, kanji)) top1, top3, rr_sum = 0, 0, 0 for query, correct in test_set: scores = sorted([(levenshtein(query, y), y, k) for y, k in hira2kanji.items()]) ranks = [k for _, _, k in scores] if ranks[0] == correct: top1 += 1 if correct in ranks[:3]: top3 += 1 if correct in ranks: rr_sum += 1 / (ranks.index(correct) + 1) N = len(test_set) print(f'評価件数 = {N}') print(f'Top-1 正解率 = {top1/N*100:.2f}%') print(f'Top-3 正解率 = {top3/N*100:.2f}%') print(f'MRR = {rr_sum/N:.4f}') |
📤 実行結果:
💬 結果の読み方: Top-1 92.05% で外れた 7 件は、 すべてミスタイプが正解を含む複数の県から編集距離 1 で同点になった例(「みやけん」→ 三重県と宮城県、 「ながけん」→ 佐賀・滋賀・長野 など)。 同点は読みの五十音順で並ぶだけなので、 正解は必ず 3 位以内に残り Top-3 は 100%、 MRR は 0.958 になる。 同点を崩すには言語モデル P(Y)(入力頻度や文脈)が要る。 47 県のような 閉じた小規模辞書では、 シンプルな編集距離だけでも 1 ステップ目として有効と分かる。
🧮 編集距離によるあいまい入力耐性 — レーベンシュタイン距離
現代の IME は「とおきょう」「とうきう」のような誤入力でも「東京」を候補に出す。 これはレーベンシュタイン距離(編集距離)2 以内の語を候補に含める実装で実現される。
🔬 数式を言葉で読み解く
- 3 種の操作(挿入・削除・置換)の最小回数で文字列 s を t に変換する
- 動的計画法で O(|s|・|t|) で計算可能
- 距離 ≦ 1 で「タイプミス候補」、 ≦ 2 で「やや疑わしい候補」とする実装が一般的
- キーボード距離を考慮した重み付け(QWERTY 上の隣接ミスを軽く扱う)も可能
🎯 このコードでやること: 47 県の読みに対し、 ミスタイプ系の入力(「とおきょうと」「ふきしまけん」など)からレーベンシュタイン距離 ≤ 2 の候補を抽出する。
📥 入力データ: 47 県の読み(pykakasi 変換結果)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import pykakasi df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() hira2kanji = {''.join(c['hira'] for c in kks.convert(p)): p for p in prefs} def levenshtein(s, t): m, n = len(s), len(t) dp = [[0]*(n+1) for _ in range(m+1)] for i in range(m+1): dp[i][0] = i for j in range(n+1): dp[0][j] = j for i in range(1, m+1): for j in range(1, n+1): if s[i-1] == t[j-1]: dp[i][j] = dp[i-1][j-1] else: dp[i][j] = 1 + min(dp[i-1][j], dp[i][j-1], dp[i-1][j-1]) return dp[m][n] mistypes = ['とおきょうと', 'ふきしまけん', 'おさかふ', 'ほっかいど', 'ぎふけん'] for typo in mistypes: matches = [] for yomi, kanji in hira2kanji.items(): d = levenshtein(typo, yomi) if d <= 2: matches.append((d, yomi, kanji)) matches.sort() print(f'入力 "{typo}" → 候補:') for d, y, k in matches[:3]: print(f' d={d}: {y} ({k})') |
📤 実行結果:
💬 結果の読み方: 5 件の入力すべてで、 正解が距離 0〜1 の先頭候補に出る。 「お」が抜けた「おさかふ」も「大阪府」を提案できる。 ただし「ふきしまけん」には鹿児島県・徳島県、 「ぎふけん」には佐賀県・滋賀県が距離 2 で並び、 しきい値 2 では 1 文字違いの県名が候補に混ざり始める。 これが現代 IME の「曖昧入力許容」の正体で、 47 県名のような閉じた辞書だと精度 100% に近い。 実用辞書では距離拡張により誤候補が混ざるため、 言語モデルとの組合せでフィルタする。
🧮 入力効率の情報量分析 — エントロピー H(Y|X)
IME の「あいまいさ」は情報理論で定量化できる。 読み X が与えられたときの漢字列 Y の条件付きエントロピー H(Y|X) が大きいほど、 候補が分散し IME のサポートが必要になる。
🔬 数式を言葉で読み解く
- H(Y|X) = 0 → 候補が 1 つに確定(衝突なし)
- H(Y|X) = 1 → 候補 2 つを五分五分(1 ビットの不確実性)
- H(Y|X) = 3 → 候補 8 つを等確率で並べた状態
- ユーザの平均選択コストはおおむね H に比例(情報理論の下限)
🎯 このコードでやること: 47 県の読み別エントロピーを計算し、 IME 設計の必要性を定量評価する。
📥 入力データ: 47 県の読み(「県・府・都」を外したもの)+ 仮想同音語 5 件(青森山・福丘・島祢・嶋根・山口家)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import pykakasi import math from collections import defaultdict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() kks = pykakasi.kakasi() yomi_kanji = defaultdict(list) for p in prefs: # 「県・府・都」を外した読み(あおもり・しまね…)で引く(北海道はそのまま) name = p if p == '北海道' else p[:-1] hira = ''.join(c['hira'] for c in kks.convert(name)) yomi_kanji[hira].append(p) # 衝突をシミュレート for y, ks in [('あおもり',['青森山']),('ふくおか',['福丘']), ('しまね',['島祢','嶋根']),('やまぐち',['山口家'])]: yomi_kanji[y].extend(ks) # エントロピー (等確率仮定) total_H = 0; n = 0 for y, cands in yomi_kanji.items(): k = len(cands) H = math.log2(k) if k > 1 else 0 total_H += H; n += 1 print(f'読み数 = {n}') print(f'平均 H(Y|X) = {total_H/n:.4f} ビット') print(f'最大 H = {max(math.log2(len(c)) if len(c)>1 else 0 for c in yomi_kanji.values()):.4f}') print(f'衝突有り読み数: {sum(1 for c in yomi_kanji.values() if len(c)>1)}') print('衝突読みの H:') for y, cands in yomi_kanji.items(): if len(cands) > 1: print(f' {y} (n={len(cands)}): H={math.log2(len(cands)):.3f}') |
📤 実行結果:
💬 結果の読み方: 47 の読みのうち衝突は 4 つだけなので、 平均 H=0.0976 ビット(合計 4.585 ビットを 47 で割った値)と小さい。 だが「しまね」のように 3 候補ある読みでは H=1.585 ビットの不確実性が発生し、 候補 2 つの「あおもり」などの 1 ビットより選択の手間が大きい。 実用 IME(語彙 30 万)では平均 H が 2-3 ビットに達し、 言語モデル P(Y) でこの不確実性を縮小するのが核心技術。
🧮 数式に値を入れて手で計算する: 仮名漢字変換の N-best 選択
合成 5 候補の確率から N-best を選ぶ。
Step 1: 候補確率
| 候補 | 確率 | 累積 |
|---|---|---|
| 「東京」 | 0.55 | 0.55 |
| 「投与」 | 0.25 | 0.80 |
| 「凍京」 | 0.10 | 0.90 |
| 「闘京」 | 0.06 | 0.96 |
| 「とうきょう」 | 0.04 | 1.00 |
Step 2: Top-3 集約
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np cands = ['東京', '投与', '凍京', '闘京', 'とうきょう'] probs = np.array([0.55, 0.25, 0.10, 0.06, 0.04]) top3_idx = np.argsort(probs)[::-1][:3] top3 = [(cands[i], probs[i]) for i in top3_idx] print(f"Top-3: {top3}") print(f"累積: {probs[top3_idx].sum():.2f}") |
📤 実行結果
💬 手計算 (Step 2) 0.90 と Python 出力が完全一致。
🧠 理解度チェック — このページの実測値で
Q1. 47 都道府県名の読み(「県・府・都」を外したもの)に、架空の同音語を 12 件足した。衝突する読みは何件で、平均候補数はいくつか。
辞書は 47 + 12 = 59 エントリ、読みの種類は 47 のまま。12 件はすべて既存の県名と同じ読みなので、衝突する読みは 12 件(12 / 47 = 25.5%)、平均候補数は 59 / 47 = 1.26 になる(上の「読み衝突分析」の出力と一致)。候補が 2 つになった読みでは、どちらを先に出すかを決める材料(言語モデル P(Y) や入力頻度)が要る。
Q2. 編集距離だけの県名 IME で、88 件の入力に対し Top-1 正解が 81 件、Top-3 は全件正解、MRR = 0.9583 だった。外れた 7 件は何位に正解があったか。
MRR は各入力の「1 / 正解の順位」の平均なので、88 × 0.9583 ≈ 84.33 が逆数順位の合計。1 位の 81 件で 81 を占めるから、外れた 7 件の合計は約 3.33。7 件とも 2 位なら 3.5、6 件が 2 位で 1 件が 3 位なら 6 × 0.5 + 1/3 = 3.33 で一致する。正解が同点で 2〜3 位に並ぶのは、編集距離が同じ候補を五十音順で並べているだけだからで、同点を崩すには頻度や文脈が要る。
Q3. pykakasi で作った読み辞書では、鹿児島県が「かこしまけん」になっていた。このまま IME 辞書にすると何が起きるか。
利用者が正しく「かごしま」と打つと、辞書の読み「かこしま」と 1 文字違うので完全一致では出てこない。編集距離 1 の候補としては拾えるが、同じく距離 1 の別の県と同点になれば 1 位を逃す。自動で付けた読みは、県名のように数が少ない辞書なら全件を目で確かめる。
🐍 Python での扱い
日本語テキストを含むデータを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import unicodedata import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' # 1. 文字コード: SSDSE は Shift_JIS 系(cp932)。utf-8 で読むと失敗する try: pd.read_csv(path, encoding='utf-8', skiprows=1) except UnicodeDecodeError as e: print('utf-8 で読むと:', type(e).__name__) df = pd.read_csv(path, encoding='cp932', skiprows=1) # 2 行目の日本語見出しを列名に print(df.shape) print(df.columns[:6].tolist()) # 2. 県名(漢字の文字列)を 2023 年度の 47 件で扱う names = df.loc[df['年度'] == 2023, '都道府県'] print('文字数の分布:', names.str.len().value_counts().sort_index().to_dict()) stem = names.where(names == '北海道', names.str[:-1]) # 末尾の都・府・県を外す print('名前部分:', stem.head(3).tolist(), '…') # 3. 全角・半角のゆれは NFKC で揃えてから照合する(IME の入力も同じ問題を抱える) print(unicodedata.normalize('NFKC', 'カナ漢字ヘンカン 2023')) |
💬 utf-8 で読むと UnicodeDecodeError で止まり、cp932 なら 564 行 × 112 列が読めて「年度」「総人口(男)」のような日本語の列名になる。2023 年度の県名 47 件は 3 文字が 44 件、4 文字が 3 件(神奈川県・和歌山県・鹿児島県)で、末尾の 1 字を外すと IME の辞書見出しに近い「青森」「岩手」が取り出せる。半角カナと全角数字は NFKC で「カナ漢字ヘンカン 2023」に揃い、揃えないまま照合すると同じ語が別の文字列として扱われる。
具体的なコードは 自然言語処理 を参照してください。
⚠️ よくある落とし穴
⚠️ 仮名漢字変換の落とし穴 5 件
- 辞書サイズと精度のトレードオフ: 語彙を増やせば対応範囲は広がるが、 同音衝突が増え第 1 候補精度は下がる。 専門辞書をオンデマンドで読み込む工夫が必要。
- ユーザ学習の暴走: ミスタイプを学習すると修正が困難になる。 decay や明示的リセットを設ける。
- 文脈長の限界: bigram は直前 1 単語のみ。 「東京 で 寿司」の「で」が「出」に化けやすい。 trigram 以上や Transformer 系で改善できるがメモリ・速度がトレードオフ。
- 未知語処理: 新語・人名・地名は辞書未収録になりがち。 Wikipedia や Web コーパスのような実データから語彙を自動補完する仕組みが必要。
- 地域・年齢バイアス: 言語モデルの訓練コーパスが偏ると、 関西方言や若者言葉が「日本語らしくない」と扱われる。 多様性確保が重要。
🈁 pykakasi で漢字→ひらがな変換、 bigram で IME 第 1 候補スコア
IME(Input Method Editor)の心臓部は「ひらがな列をどの漢字列に変換するか」を決める統計的言語モデルである。 たとえば「きょうとふ」というローマ字入力に対し、 候補集合 {京都府, 今日と府, 京とふ, …} のうち最尤を選ぶ。 古典的には bigram(直前 1 形態素の遷移確率)を用い、 P(京都府) = P(京都|BOS) × P(府|京都) を最大化する。 ここでは、 47 都道府県名を「正解語彙」として擬似的な学習コーパスを作り、 pykakasi で漢字を読みに変換、 候補スコアを bigram で計算する。 これは IME の最小骨格を実データで体感できる教材になる。
このコードでやること: 47 都道府県名を pykakasi で読み変換し、 「同じ読みを持つ別表記」が現実にどれだけ少ないかを示しつつ、 簡易 bigram で「とうきょうと」→「東京都」のスコアを算出する。
📥 入力データ(47 都道府県名):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd from collections import Counter, defaultdict from pykakasi import kakasi df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) prefs = df['都道府県'].dropna().unique().tolist() # 漢字 → ひらがな kks = kakasi() yomi_map = {p: ''.join([d['hira'] for d in kks.convert(p)]) for p in prefs} # 同読み衝突を集計 yomi_counts = Counter(yomi_map.values()) collision = {y:c for y,c in yomi_counts.items() if c >= 2} print(f'47 県のうち同読み衝突: {len(collision)} 件') print('例:', list(yomi_map.items())[:4]) # 簡易 bigram (BOS-県-EOS) bi = defaultdict(lambda: defaultdict(int)) for p in prefs: bi['BOS'][p] += 1; bi[p]['EOS'] += 1 def score(seq): s = 1.0; prev = 'BOS' for w in seq + ['EOS']: n = sum(bi[prev].values()) s *= (bi[prev][w] + 1e-9) / (n + 1e-6) prev = w return s print(f"P(東京都) = {score(['東京都']):.6f}") print(f"P(京都府) = {score(['京都府']):.6f}") |
📤 実行例:
💬 読み方: 47 都道府県では同読み衝突が 0 件(「東京都」と「京都府」も読みは「とうきょうと」「きょうとふ」で別物)。 IME にとって「未知語が極めて少なく」「N-gram で uniform 配分しても精度が落ちない」、 理想的な閉じた辞書である。 一方、 市区町村まで広げると「府中市」(東京/広島) のような同名異所が出現し、 IME は位置情報や直近文脈で曖昧性を解く必要がある。
🗺 用語マインドマップ — 周辺概念の整理
「かな漢字変換」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 自然言語処理・入力支援(IME) | 読みから表記を復元する、日本語入力の中核処理 |
| 南 (下位) | Mozc・ATOK・MS-IME、予測変換 | 変換エンジンを載せた実際の IME と、入力途中から候補を出す派生 |
| 東 (発展) | 改良版・拡張 | かな漢字変換の弱点を補う発展形 |
| 西 (前提) | 基礎数学・統計 | かな漢字変換の理解に必要な土台 |
| 中央 | かな漢字変換 | 本ページの主役 |
🔗 隣接手法への橋渡し
かな漢字変換は IME 単独では完結せず、 ローマ字入力 (前段) と確定後の自然言語処理 (後段) と連携して初めて日本語テキスト生成が成立する。
- 上流: 前段の入力方式・ローマ字ルール (NLP基礎、 n-gram言語モデル)
- 並列: 他言語の IME や同類の入力方式 (Attention、 Transformer) と比較・併用
- 下流: 確定後の NLP 処理 (形態素解析・検索) (LLM応用、 プロンプト設計)
上流の形態素解析と言語モデルが入力候補を生成し、 並列のニューラル変換 (Transformer 系) が文脈依存変換の精度を競い、 下流の学習データ収集 (ログ・誤変換訂正) が次バージョンの変換辞書を更新する循環構造で実用品質が維持される。
🌳 手法選択フロー
かな漢字変換 を実際の課題に当てはめるとき、 用語固有の判断軸に沿って次の 3 段階で適切な選択を行う。
- 変換精度最優先 (公文書・法律文書) か? Yes → Transformer 系ニューラル変換 (BERT/GPT 派生)、 No → 次へ
- 軽量化・組込デバイス (スマホ IME) か? Yes → N-gram + 隠れマルコフモデル (HMM) ベース、 No → 次へ
- 専門ドメイン用語 (医療・法務) を扱うか? Yes → 辞書拡張 + Fine-tuning、 No → 標準的かな漢字変換エンジン (Mozc 等) で十分
このフローは現代の日本語入力システム設計の標準的判断軸。 大規模 LLM 時代でも軽量・低遅延・専門ドメインの要件により従来手法 (N-gram/隠れマルコフ) が併用される。
🎮 触って理解する — 同音異義語ランキングと Viterbi 変換
本節は教材用の固定辞書・固定コストによる簡易デモです。 実在の変換エンジンは使わず、 あらかじめ定めた変換候補と言語モデルスコア(頻度コスト+文脈コスト)だけで決定的に動きます。 姉妹ページ 形態素解析 の「分かち書き・品詞・ラティス Viterbi」とは重複させず、 ここでは同音異義語の候補ランキングと文脈による選択に的を絞ります。
① 文脈で変わる n-best 候補(学習つき)
固定の架空例として読み 「きしゃ」 を使います。 候補は 記者 / 汽車 / 貴社 / 帰社 の 4 つ。 文脈ボタンを切り替えると各候補の合計コスト(=負の対数確率)が変わり、 最有力(第 1 候補)が入れ替わります。 候補をクリック(タップ)するとユーザ学習が働き、 学習ボーナスの分だけコストが下がって次回以降の優先度が上がります。
② ラティス上の最尤経路(Viterbi)で文全体を 1 つに決める
固定の架空例 「きしゃのきしゃ」(貴社の記者? 記者の汽車?)。 各文節の候補(emission コスト e =出現頻度)と、 隣り合う候補どうしの接続(transition コスト t =共起しやすさ)を合計し、 文全体のコストが最小になる経路を動的計画法(Viterbi)で 1 つ選びます。 「各列で一番安い候補を選ぶ」貪欲法とは結果が変わる点がポイントです。 図の第 1 文節ノードにタッチ/マウスを重ねると、 そのノードから伸びる接続を確認できます。
🧭 直感・落とし穴・発展
- 直感: かな漢字変換とは「同じ読みの候補の中から、 文脈で最もありそうな漢字を選ぶ」作業。 ①の文脈ボタンで第 1 候補が入れ替わるのが、 まさに文脈コストの働き。 ②のラティスは、 候補選択を文全体で一度に最適化する仕組み。
- 落とし穴: 未知語・固有名詞・文脈不足で誤変換が起きる。 辞書に無い語はそもそも候補に出ず(未知語)、 珍しい人名・地名は頻度コストが高くて沈み、 短い入力では文脈コストが効かず頻度だけで決まってしまう。 貪欲に各文節を最安で選ぶと、 ②のように文全体では不自然な組み合わせ(記者の汽車)に化ける。
- 発展: 実システムは統計的かな漢字変換(n-gram / n-gram モデル による接続コスト)から、 ニューラル変換(文脈双方向の埋め込みで同音異義を判別)へ発展。 学習ボーナスは実装上のユーザ辞書学習の簡略版で、 実際は選択履歴・訂正履歴を継続的に取り込む。 系列全体の最適化という枠組みは 形態素解析 のラティス探索や 単語分割 と共通。