🔖 キーワード索引
各語の説明がある章へのリンク:
PPDAC サイクルは Problem→Plan→Data→Analysis→Conclusion の 5 段階で統計的な探究を回す枠組みで、 MacKay と Oldford(2000)が整理し、 ニュージーランドの統計教育で広まった。 このページでは SSDSE-B-2026 を使い、 「高齢化率が高い県ほど、 二人以上の世帯の保健医療費(県庁所在市の家計調査の値)は多いのか」という問いで PPDAC を 2 周回す。
💡 30秒で分かる結論 — PPDACサイクル
🍰 まずはやさしく
データ分析の地図のようなものです。
正しい手順で結論を出すために使います。
部活の課題をデータで解決する時に役立ちます。
分析の5つのステップについて読みましょう。
- 一言で:Problem → Plan → Data → Analysis → Conclusion の 5 フェーズ循環。 統計教育では世界標準。
- 分野:データ分析のプロセス — 業務寄りの CRISP-DM と同じ位置にある
- 最初の P が要:「答えが数字で書ける」「答えが 1 つに決まる」形まで問いを絞る。 横断データなら因果ではなく相関まで問いを下げる
- Plan はデータを開く前に書く:年度・指標・手法を先に決めないと、 見てから選んだ偶然の当たりを本物と取り違える
- 実例:2023 年度 47 県で高齢化率と二人以上の世帯の保健医療費(県庁所在市の家計調査)は r = −0.49 と予想と逆の負の相関。 1 周目の C が 2 周目の P(支出全体の大きさをそろえたら?)を生む
- レポートでは:出典・年度・県数(n = 47)・前提・限界の 5 点を書き、 言えることと言えないことを分ける
Problem→Plan→Data→Analysis→Conclusion の分析プロセス
- Problem → Plan → Data → Analysis → Conclusion の5段階データ分析サイクル。
- ニュージーランド発、 統計教育の国際標準モデル(高校・大学初年次でよく使われる)。
- 「問題は何か」を最初にちゃんと決めるのが要。 ここを飛ばすとデータが宝の持ち腐れ。
- 1周で終わりではなく 回す — 結論から新たな問題が生まれる。
- ビジネスでは CRISP-DM と似た位置づけ(業界・粒度が違うだけ)。
📍 あなたが今見ているもの
🍰 まずはやさしく
世界中で使われている共通のルールです。
分析の流れを整理するために使います。
レポート作成で迷った時に役立ちます。
この仕組みの使い道を詳しく解説します。
日本の高校情報・統計教育、 ニュージーランドの統計カリキュラム、 国際統計学会(ISLP)でも採用される枠組み。 「問いから結論まで」を体系化する。
「データ分析コンペで何から手を付けたらいいか分からない」「分析が手戻り続き」 — そんなときに立ち返るフレーム。 統計検定2級・データサイエンス検定でも頻出。
Problem の書き方 — 悪い問いを良い問いに直す 3 例
PPDAC でいちばん差がつくのは最初の P です。実例で直し方を見ます。
| よくある問い | 何が困るか | 直したもの |
|---|---|---|
| 地方は元気がない? | 「元気」が測れない。どの指標でも答えが作れてしまう | 2013〜2023 年で、人口が減った県の数はいくつか |
| 教育にお金をかけると学力が上がる? | 因果を問うているのに、手元は横断データだけ | 教育費と高校進学率の間に、県レベルで相関はあるか |
| どの県が住みやすい? | 誰にとってかが無い。合成指標の重みで結論が変わる | 子育て世帯にとっての保育所定員/待機児童数はどう分布するか |
直した問いに共通するのは、「答えが数字で書ける」「答えが 1 つに決まる」の 2 点です。 そして 2 例目のように、問いを弱めることも正しい直し方です。 横断データで因果は言えないのだから、 「相関はあるか」まで問いを下げておくほうが、結論で嘘をつかずに済みます。
このページの例は、 🧮 で PPDAC を 3 周する。 1 周目で問いと答えの形を決め、 2 周目で支出の大きさ・年度・検出力・1 県の影響を確かめ、 3 周目で年度を変えて結論が崩れないかを試す。 どの周も、 前の周の Conclusion に書いた「言えないこと」が出発点になっている。
🎨 直感で掴む — PPDACサイクルとは何者か
🍰 まずはやさしく
料理のレシピのようなものです。
失敗せずに分析を進めるために使います。
買い物で予算と品物を決める感覚に似ています。
具体例を使って直感的に理解しましょう。
料理に例えると:
- P (Problem):何を作りたい?(カレー)
- P (Plan):レシピを決める(材料・手順)
- D (Data):材料を集める
- A (Analysis):調理する
- C (Conclusion):味見・改善 → 次へ
料理が下手な人は P を飛ばして適当に材料を切り始めるが、 上手な人はゴールを決めてから動く。
📐 数式・定義
🍰 まずはやさしく
5つの段階を回すサイクルです。
問いから結論までを体系化するために使います。
スマホの利用時間を調べる時に役立ちます。
それぞれの段階の意味と流れを定義します。
PPDACサイクル(PPDAC Cycle):Problem→Plan→Data→Analysis→Conclusion の分析プロセス
🔬 数式・定義を「言葉」で読み解く
📐 の矢印の 1 本 1 本が、 どの段階で何を決めるかを表す。 大事なのは最後の「ふたたび P へ」で、 C で書いた「言えないこと」が次の周の Problem になる。 このページの例では、 1 周目の C(高齢化率と保健医療費は r = −0.49 の負の相関)から、 2 周目の P(消費支出全体の大きさをそろえても負の関係は残るか)が生まれている。 さらに 3 周目では同じ問いを年度を変えて確かめ、 r が 2013 年度の −0.013 から 2023 年度の −0.490 まで揺れることが分かって、 C の書き方をもう一度直している。 矢印を 1 周するたびに、 問いは狭く、 結論は慎重になっていく。
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| Problem | 何を明らかにしたいか — 質問を具体化 |
| Plan | 何を測る/どう集める/必要なサンプルは |
| Data | 実データ収集・整形・クリーニング |
| Analysis | 可視化・統計・モデリング |
| Conclusion | 解釈・報告・次への問い |
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026(47都道府県・2023 年・112 項目)を題材に、 PPDACサイクル に関係する変数を実値で確認します。 とくに東京・大阪・沖縄・秋田 など特徴ある県を比較すると、 用語の重みが体感できます。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 転入率(‰) |
|---|---|---|---|---|
| 東京 | 14,086 | 22.8 | 0.99 | 28.88 |
| 大阪 | 8,763 | 27.7 | 1.19 | 18.20 |
| 沖縄 | 1,468 | 23.8 | 1.60 | 17.99 |
| 秋田 | 914 | 39.1 | 1.10 | 10.94 |
| 全国 (人口は合計、 TFR は 47 県の単純平均) | 124,353 | 29.1 | 1.29 | 17.93 |
これらの値を PPDACサイクル の観点で読み解くと、 都道府県間の格差・特徴・関係性が浮かび上がります。 具体的な計算手順は次の「🐍 Python 実装」セクションで実演します。
🧮 数式に値を入れて手で計算する: PPDAC 5 段階の工数
合成データで PPDAC サイクルの工数配分を計算する。
Step 1: 段階別工数 [人日]
| 段階 | 工数 | 比率 |
|---|---|---|
| Problem | 5 | 0.10 |
| Plan | 10 | 0.20 |
| Data | 15 | 0.30 |
| Analysis | 12 | 0.24 |
| Conclusion | 8 | 0.16 |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 | import numpy as np effort = np.array([5, 10, 15, 12, 8]) ratio = effort / effort.sum() print(f"合計: {effort.sum()}") print(f"比率: {ratio}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
PPDAC を 1 周してみる — 「高齢化率が高い県ほど医療費は多いのか」
サイクルの説明を読むだけでは身につきません。実際に 1 周してみます。 題材は誰もが「そうだろう」と思う問い、 「高齢化率が高い県ほど、世帯の保健医療費は多いのではないか」です。 結論から言うと、この予想は裏切られます。そこがこの例のいちばんの学びどころです。
P — Problem(問いを、答えられる形にする)
「高齢化は医療費を押し上げるか」は大きすぎて測れません。 誰の・いつの・どの数字かまで落とします。 → 「2023 年度の 47 都道府県で、65 歳以上人口比率と 二人以上の世帯の月額保健医療費の間に相関はあるか」。 ここまで書けて初めて、次の Plan が決まります。
P — Plan(どう測るかを先に決める)
高齢化率は A1303 ÷ A1101 で作る。医療費は L322106 をそのまま使う。
関係は相関係数と回帰直線で見る。
分析を始める前に決めておくのが肝心で、
結果を見てから指標を選び直すと、都合のよい数字を拾うだけになります。
D — Data(データの素性を確かめる)
47 行。高齢化率は 22.8%〜39.1%(平均 31.6%)、 保健医療費は 11,052〜21,000 円(平均 14,423 円)。 欠損はありません。ここで範囲を見ておくと、あとで外れ値に驚かずに済みます。
A — Analysis(測る)
相関係数は r = −0.490(p = 0.0005)。 予想と逆で、しかもはっきり負です。 回帰直線は「保健医療費 = −315 × 高齢化率 + 24,361」。 高齢化率が 1 ポイント高い県ほど、世帯の医療費支出は月 315 円ほど少ないという関係です。
| 県 | 高齢化率 | 保健医療費(月) |
|---|---|---|
| 秋田県(高齢化率 1 位) | 39.1% | 12,305 円 |
| 東京都(高齢化率 47 位) | 22.8% | 18,166 円 |
C — Conclusion(何が言えて、何が言えないか)
言えるのは「高齢化率が高い県ほど、二人以上世帯の保健医療費支出は少ない傾向がある」までです。 「高齢化しても医療費はかからない」とは言えません。理由は 3 つあります。
- 測っているのは家計の自己負担であって、医療費の総額ではありません。 公的保険が負担した分はこの数字に入っていません。
- 所得の効果が混ざっています。高齢化率が低い県は都市部で所得も高く、 支出全体が大きい。医療費だけが多いわけではないかもしれません。
- 世帯単位の平均です。高齢者だけの世帯が多い県では、 世帯人数が少ないぶん世帯あたりの支出も小さく出ます。
そして PPDAC はここで終わりません。 「消費支出に占める割合で見たらどうか」「世帯人員で割ったらどうか」という 次の Problem が生まれます。これが「サイクル」と呼ばれる理由です。 予想が外れたときこそ、いちばん良い次の問いが立ちます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # ── PPDAC を 1 周する:問いを立て、データを見て、結論を書くまで ── import pandas as pd from scipy import stats # Data: SSDSE-B-2026 の 2023 年度・47 都道府県 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 65歳以上人口 ÷ 総人口 df['保健医療費'] = df['L322106'].astype(float) # 二人以上の世帯・月額 # Analysis: まず散らばりを見てから関係を測る print(f"高齢化率 平均 {df['高齢化率'].mean():.1f}% " f"範囲 {df['高齢化率'].min():.1f}〜{df['高齢化率'].max():.1f}") print(f"保健医療費 平均 {df['保健医療費'].mean():,.0f} 円 " f"範囲 {df['保健医療費'].min():,.0f}〜{df['保健医療費'].max():,.0f}") r, p = stats.pearsonr(df['高齢化率'], df['保健医療費']) slope, intercept, _, _, _ = stats.linregress(df['高齢化率'], df['保健医療費']) print(f'相関係数 r = {r:.3f} (p = {p:.4f})') print(f'回帰直線: 保健医療費 = {slope:.0f} × 高齢化率 + {intercept:,.0f}') # Conclusion: 両端を名指しで見て、想定と違うことを確かめる for pref in ['秋田県', '東京都']: row = df[df['Prefecture'] == pref].iloc[0] print(f"{pref}: 高齢化率 {row['高齢化率']:.1f}% 保健医療費 {row['保健医療費']:,.0f} 円") |
📤 実行すると次の出力が得られる:
💬 読み方:上の A と C で書いた数字が、そのまま出ます。p = 0.0005 は「偶然ではない」としか言っていない点に注意してください。負の相関が「本物」であることと、その原因が何かは別の問題です。PPDAC の C は、数字が言っていないことを書き分ける場所でもあります。
PPDAC を 2 周目へ — C で生まれた問いを、段階ごとに実データで確かめる
1 周目の Conclusion は「高齢化率が高い県ほど、二人以上世帯の保健医療費支出は少ない傾向がある(2023 年度、r = −0.490)」でした。そして「所得(支出全体の大きさ)の効果が混ざっているのでは」「この結論はどこまで確かか」という次の問いが残りました。2 周目では、この問いを P → P → D → A → C の順に 1 つずつ確かめます。1 周目と同じ SSDSE-B-2026 の列だけを使います。
2 周目の Problem — 支出全体の大きさをそろえても、負の関係は残るか
1 周目の C で挙げた理由の 1 つは「高齢化率が低い県は都市部で支出全体が大きい」でした。これが本当なら、保健医療費を消費支出に占める割合に直すか、回帰で消費支出をそろえると、負の関係は弱まるか消えるはずです。問いを「2023 年度の 47 都道府県で、消費支出(L3221)の違いを考慮しても、高齢化率と保健医療費の負の関係は残るか」と書き直して確かめます。
🎯 このコードでやること:2023 年度の 47 都道府県で、高齢化率・保健医療費・消費支出の 3 組の相関と、保健医療費を消費支出で割った割合と高齢化率の相関を出す。さらに「保健医療費 ~ 高齢化率 + 消費支出」の回帰で、消費支出をそろえたときの高齢化率の係数を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from scipy import stats import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 d['保健医療費'] = d['L322106'].astype(float) # 二人以上の世帯・月額(円) d['消費支出'] = d['L3221'].astype(float) # 同じ世帯の消費支出の合計(円) d['医療費割合'] = d['保健医療費'] / d['消費支出'] * 100 # 消費支出に占める保健医療費(%) for a, b in [('高齢化率', '保健医療費'), ('高齢化率', '消費支出'), ('消費支出', '保健医療費'), ('高齢化率', '医療費割合')]: r, p = stats.pearsonr(d[a], d[b]) print(f'r({a}, {b}) = {r:+.3f} (p = {p:.4f})') m = smf.ols('保健医療費 ~ 高齢化率 + 消費支出', data=d).fit() print(f'消費支出をそろえた回帰: 高齢化率の係数 {m.params["高齢化率"]:.0f} 円/ポイント (p = {m.pvalues["高齢化率"]:.4f})' f' 消費支出の係数 {m.params["消費支出"]:.4f}') print(f'医療費割合 平均 {d["医療費割合"].mean():.2f}% 範囲 {d["医療費割合"].min():.2f}〜{d["医療費割合"].max():.2f}%') |
💬 消費支出と保健医療費の相関は +0.603 で、支出全体が大きい県ほど医療費も多いのは確かです。高齢化率と消費支出も r = −0.306 と負の関係があるので、1 周目の −0.490 の一部は「支出全体の大きさ」の経路を通っています。しかし割合(平均 4.87%、3.69〜6.10%)に直しても r = −0.392 と負の関係ははっきり残り、消費支出をそろえた回帰でも高齢化率の係数は −216 円/ポイント(p = 0.0056)です。1 周目の −315 円/ポイントのおよそ 3 分の 2 が残る計算で、「所得の違いだけで説明できる」という仮説は、この 2 つの列の範囲では支持されません。残る説明の候補(高齢者のみの世帯が多いと世帯あたりの支出が小さくなる、医療費の公的負担の違いなど)は SSDSE-B-2026 の列では測れないので、次の周では別のデータ(世帯人員や医療費の総額)を探す Plan が要ります。
2 周目の Plan — なぜ「年度を先に決める」のか
1 周目の Plan で「分析を始める前に決めておくのが肝心」と書きました。それがどれほど効くかを、年度の選び方で確かめます。SSDSE-B-2026 には 2012〜2023 年度の 12 年分があるので、同じ相関を年度ごとに計算し、12 年度をまとめた 564 行の相関とも比べます。
🎯 このコードでやること:2012〜2023 年度のそれぞれで、47 都道府県の高齢化率と保健医療費のピアソン相関と p 値を計算し、p < 0.05 になる年度を数える。12 年度の 564 行をまとめた相関も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 df['保健医療費'] = df['L322106'].astype(float) rows = [] for y, g in df.groupby('SSDSE-B-2026'): # 年度ごとに 47 都道府県で相関 r, p = stats.pearsonr(g['高齢化率'], g['保健医療費']) rows.append((y, r, p)) print(f'{y} 年度: r = {r:+.3f} p = {p:.4f} {"*" if p < 0.05 else ""}') sig = [y for y, r, p in rows if p < 0.05] print(f'p < 0.05 の年度: {len(sig)} / {len(rows)}({min(sig)}〜{max(sig)} 年度)') r_all, p_all = stats.pearsonr(df['高齢化率'], df['保健医療費']) print(f'12 年度の 564 行をまとめて: r = {r_all:+.3f} p = {p_all:.4f}') |
💬 相関は 2012 年度 −0.095、2013 年度 −0.013 とほぼ 0 から、2023 年度 −0.490 まで年度によって大きく違い、p < 0.05 になるのは 12 年度中 7 年度(2017〜2023 年度)だけです。最新の 2023 年度は 12 年度の中でたまたま最も強い負の相関でした。もし「いちばん結果のはっきりした年度」を後から選んで報告すれば、それだけで結論を強く見せられてしまいます。1 周目で 2023 年度を使ったのは「最新年度で見る」と先に決めていたからで、その場合でも「2017 年度以降は一貫して負、それ以前ははっきりしない」という年度ごとの結果を添えるのが誠実な C です。12 年度の 564 行をまとめると r = −0.024(p = 0.5692)で関係は消えてしまいますが、これは次の Data の段で理由が分かります。
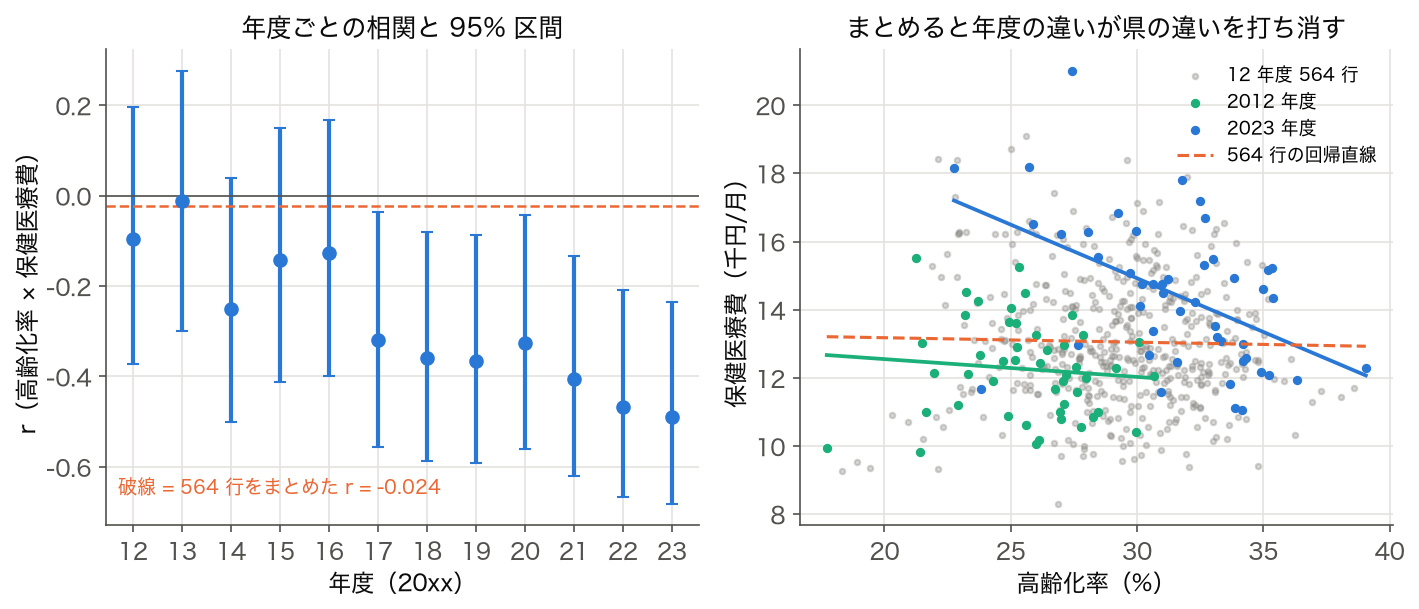
図の読み方: 左は年度ごとの相関と Fisher の z 変換による 95% 区間です。2016 年度までは区間が 0 をまたぎ、2017 年度以降は区間全体が負の側にあります。区間の幅はどの年度も ±0.25 前後あり、47 県の相関 1 つには大きな不確かさがあることも分かります。右は 564 行の散布図で、2012 年度(緑)と 2023 年度(青)はそれぞれ右下がりの直線なのに、2023 年度の点の雲は 2012 年度より右(高齢化率が高い)かつ上(医療費が多い)にずれています。この「年度ごとのずれ」が右上がりに並ぶため、564 行を 1 本の直線で当てると、県の間の右下がりを打ち消してほぼ水平(橙の破線)になります。図の作成スクリプトは code/glossary_figs/ppdac-cycle.py。
2 周目の Plan(続き)— 47 県でどの強さの相関なら見つけられるか
年度によって p < 0.05 になったりならなかったりするのは、相関が年ごとに本当に変わっているからとは限りません。47 県という件数そのものが、中くらいの相関を見つけるには小さい可能性があります。Plan の段で「この件数で、どの強さの関係なら見つけられるか(検出力)」を見積もっておくと、結果の読み方が変わります。
🎯 このコードでやること:47 件の相関の検定(有意水準 5%、両側)で、本当の相関の強さ |ρ| が 0.20〜0.49 のときに p < 0.05 になる確率(検出力)と、検出力 80% に必要な件数を Fisher の z 変換で近似計算する。
1 2 3 4 5 6 7 8 9 10 | import numpy as np from scipy import stats # 47 県の相関の検定で、本当の相関が |ρ| のときに p < 0.05 になる確率(Fisher の z 変換による近似) n = 47 for rho in [0.2, 0.3, 0.33, 0.4, 0.49]: z = np.arctanh(rho) * np.sqrt(n - 3) power = stats.norm.cdf(z - 1.96) + stats.norm.cdf(-z - 1.96) n80 = (1.96 + 0.8416) ** 2 / np.arctanh(rho) ** 2 + 3 # 検出力 80% に必要な件数 print(f'|ρ| = {rho:.2f}: 検出力 {power:.3f} 検出力 80% に必要な件数 {np.ceil(n80):.0f}') |
💬 本当の相関が |ρ| = 0.33(2017〜2020 年度の r に近い強さ)なら、47 県で p < 0.05 になる確率は 0.623 しかなく、10 回調べれば 4 回近くは「有意でない」と出ます。|ρ| = 0.49(2023 年度の r)なら 0.945 です。検出力 80% を確保するには、|ρ| = 0.30 で 85 件、|ρ| = 0.20 なら 194 件が必要で、都道府県の数 47 はこれに届きません。つまり「2016 年度以前は有意でない」ことは「その年は関係がなかった」ことの証拠にはならず、件数が足りずに見逃している可能性があります。Plan の段で検出力を見積もっておけば、「有意でない年度」を「関係なし」と書いてしまう C の誤りを防げます。都道府県より細かい単位(市区町村)のデータを使うか、年度をまたいで年度の効果を分けたモデルで推定するのが、件数を増やす方法です。
2 周目の Data — 564 行はなぜ打ち消し合い、どの列が揺れやすいか
Data の段では「データの素性」を確かめます。ここでは 2 つを数字で見ます。1 つは、564 行をまとめると相関が消える理由を、年度の平均の動きで確かめること。もう 1 つは、列ごとに年度間の揺れの大きさを比べることです。保健医療費は家計調査(標本調査)にもとづく値なので、人口のような全数の数字よりも年ごとに大きく揺れることが予想されます。
🎯 このコードでやること:県ごとに年度の昇順に並べ直し、総人口・高齢化率・消費支出・保健医療費の前年度比の変化(絶対値)の中央値と 90% 点を比べる。年度ごとの全国平均(47 県の単純平均)の推移と、その 12 点どうしの相関も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 df = df.sort_values(['Code', 'SSDSE-B-2026']) # 県ごとに年度の昇順(CSV は新しい年度が先) # 前年度からの変化率(絶対値)の中央値: どの列が年ごとに大きく揺れるか for col, name in [('A1101', '総人口'), ('高齢化率', '高齢化率'), ('L3221', '消費支出'), ('L322106', '保健医療費')]: ch = df.groupby('Code')[col].pct_change().abs() * 100 print(f'{name:<6} 前年度比の変化(絶対値)の中央値 {ch.median():5.2f}% 90% 点 {ch.quantile(0.9):5.2f}%') # 年度の平均と県の平均に分けると、564 行の相関がほぼ 0 になる理由が見える yr = df.groupby('SSDSE-B-2026')[['高齢化率', 'L322106']].mean() print(f'全国平均の推移: 高齢化率 {yr.iloc[0, 0]:.1f}% → {yr.iloc[-1, 0]:.1f}% 保健医療費 {yr.iloc[0, 1]:,.0f} → {yr.iloc[-1, 1]:,.0f} 円') r_time, _ = stats.pearsonr(yr['高齢化率'], yr['L322106']) print(f'年度の平均どうし(12 点)の相関 r = {r_time:+.3f}') |
💬 前年度比の変化の中央値は、総人口 0.59%・高齢化率 1.93% に対して、消費支出 4.12%・保健医療費 7.23% と大きく、保健医療費は 1 割の県・年度で 21.01% 以上も動きます。家計の支出は標本の世帯から推計した値なので、1 年ごとの値には標本による揺れが大きく含まれます。年度ごとの相関が −0.013〜−0.490 と大きく変わったのも、この揺れで説明できる部分があります。また、全国平均で見ると 12 年間に高齢化率は 25.6% → 31.6%、保健医療費は 12,258 → 14,423 円とどちらも上がっており、年度の平均どうし 12 点の相関は +0.881 です。県の間では負、年度の間では正という逆向きの関係が 564 行に混ざるので、まとめた相関はほぼ 0 になります。Data の段で「行が何を 1 単位としているか(県か、県 × 年度か)」を確かめずに全行を使うと、このような打ち消しに気づけません。
2 周目の Analysis — 1 県で結論が変わらないか、区間はどれくらいか
Analysis の段では、1 つの数字で終わらせず、結論の頑健さを確かめます。2023 年度の 47 県で、順位にもとづくスピアマンの相関、1 県ずつ除いたときの相関の範囲、県を復元抽出するブートストラップの 95% 区間を計算します。
🎯 このコードでやること:2023 年度の高齢化率と保健医療費で、ピアソン r とスピアマン ρ、1 県ずつ除いたときの r の最小・最大(どの県を除いたときか)、ブートストラップ 2,000 回(seed 0)の 95% 区間と、r が 0 以上になった割合を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) x = d['A1303'] / d['A1101'] * 100 y = d['L322106'].astype(float) print(f'ピアソン r = {stats.pearsonr(x, y)[0]:+.3f} スピアマン ρ = {stats.spearmanr(x, y)[0]:+.3f}') loo = np.array([stats.pearsonr(x.drop(i), y.drop(i))[0] for i in range(len(d))]) # 1 県ずつ除く for i in [loo.argmin(), loo.argmax()]: print(f'{d.loc[i, "Prefecture"]}を除くと r = {loo[i]:+.3f}') rng = np.random.default_rng(0) boot = [] for _ in range(2000): # 県を復元抽出するブートストラップ idx = rng.integers(0, len(d), len(d)) boot.append(stats.pearsonr(x.iloc[idx], y.iloc[idx])[0]) lo, hi = np.percentile(boot, [2.5, 97.5]) print(f'ブートストラップ 95% 区間 [{lo:+.3f}, {hi:+.3f}] 0 以上になった割合 {np.mean(np.array(boot) >= 0):.3%}') |
💬 スピアマン ρ = −0.468 はピアソン r = −0.490 とほぼ同じで、少数の極端な値だけで作られた相関ではありません。1 県ずつ除くと r は −0.603(沖縄県を除いたとき)から −0.437(東京都を除いたとき)の間で動き、どの 1 県を除いても負の関係は残ります。沖縄県は高齢化率 23.8% と低いのに保健医療費 11,686 円と少なく、全体の傾向から外れているので、除くと負の関係が強まります。東京都は高齢化率 22.8% で最も低く保健医療費 18,166 円と多いので、除くと少し弱まります。ブートストラップの 95% 区間は [−0.715, −0.185] で、0 以上になったのは 2,000 回中 0.350%(7 回)でした。2023 年度の中では負の関係は頑健ですが、区間の幅は 0.53 と広く、「r ≈ −0.5」ではなく「−0.2 〜 −0.7 のどこか」と読むのが適切です。
Analysis の中身を手で確かめる — 5 県で相関係数を計算する
1 周目・2 周目で何度も出てきた相関係数 $r = \dfrac{\sum (x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum (x_i-\bar x)^2 \sum (y_i-\bar y)^2}}$ を、2023 年度の 5 県の値(高齢化率 $x$ %、保健医療費 $y$ 千円/月、小数第 1 位に丸めたもの)で手計算します。
| 県 | $x$ | $y$ | $x-\bar x$ | $y-\bar y$ | 積 |
|---|---|---|---|---|---|
| 秋田県 | 39.1 | 12.3 | +9.64 | −2.56 | −24.678 |
| 東京都 | 22.8 | 18.2 | −6.66 | +3.34 | −22.244 |
| 沖縄県 | 23.8 | 11.7 | −5.66 | −3.16 | +17.886 |
| 愛媛県 | 34.2 | 11.1 | +4.74 | −3.76 | −17.822 |
| 埼玉県 | 27.4 | 21.0 | −2.06 | +6.14 | −12.648 |
| Step | 計算 | 値 |
|---|---|---|
| 1. 平均 | $\bar x = 147.3 / 5$、$\bar y = 74.3 / 5$ | 29.46、14.86 |
| 2. 偏差の積の和 | −24.678 − 22.244 + 17.886 − 17.822 − 12.648 | −59.508 |
| 3. 偏差の二乗和 | $\sum(x-\bar x)^2 = 92.93 + 44.36 + 32.04 + 22.47 + 4.24$、$\sum(y-\bar y)^2 = 6.55 + 11.16 + 9.99 + 14.14 + 37.70$ | 196.032、79.532 |
| 4. 分母 | $\sqrt{196.032 \times 79.532} = \sqrt{15{,}590.8}$ | 124.863 |
| 5. 相関係数 | −59.508 ÷ 124.863 | −0.4766 |
5 県のうち 4 県の積が負で、沖縄県だけが正(高齢化率も医療費も平均より低い)です。これは 2 周目の Analysis で「沖縄県を除くと負の関係が強まる」と出たことと同じ構造です。
🎯 このコードでやること:手計算と同じ 5 県の丸めた値で Step 1〜5 を numpy で再現し、scipy.stats.pearsonr と比べる。最後に丸める前の SSDSE-B-2026 の値で同じ 5 県の r を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd from scipy import stats # 手計算と同じ 5 県の値(高齢化率 %、保健医療費 千円/月、小数第 1 位に丸めたもの) names = ['秋田県', '東京都', '沖縄県', '愛媛県', '埼玉県'] x = np.array([39.1, 22.8, 23.8, 34.2, 27.4]) y = np.array([12.3, 18.2, 11.7, 11.1, 21.0]) dx, dy = x - x.mean(), y - y.mean() print(f'平均 x̄ = {x.mean():.2f} ȳ = {y.mean():.2f}') print('偏差の積:', np.round(dx * dy, 3)) print(f'Σ偏差の積 = {np.sum(dx * dy):.3f} Σdx² = {np.sum(dx**2):.3f} Σdy² = {np.sum(dy**2):.3f}') print(f'r(式どおり)= {np.sum(dx * dy) / np.sqrt(np.sum(dx**2) * np.sum(dy**2)):.4f}' f' scipy.stats.pearsonr = {stats.pearsonr(x, y)[0]:.4f}') # 丸める前の SSDSE-B-2026(2023 年度)の値で同じ 5 県 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[(df['SSDSE-B-2026'] == 2023) & df['Prefecture'].isin(names)].set_index('Prefecture').loc[names] r5 = stats.pearsonr(d['A1303'] / d['A1101'] * 100, d['L322106'])[0] print(f'丸める前の値で 5 県: r = {r5:.4f}') |
💬 平均 29.46・14.86、偏差の積の和 −59.508、二乗和 196.032・79.532、r = −0.4766 は Step 1〜5 と一致し、scipy.stats.pearsonr の −0.4766 とも同じです。丸める前の値で計算しても −0.4745 で、小数第 1 位への丸めは r をほとんど変えません。ただし、この 5 県は保健医療費が最も少ない愛媛県と最も多い埼玉県を含む「選んだ 5 県」なので、47 県の r = −0.490 に近いのはたまたまです。手計算で式の意味を確かめたら、結論には必ず全 47 県の値を使います。
2 周目の Conclusion — 1 周目の結論をどう書き直すか
| 段階 | 2 周目で確かめたこと | 実データの結果 | 結論への反映 |
|---|---|---|---|
| Problem | 支出全体の大きさをそろえても負の関係は残るか | 割合でも r = −0.392、消費支出をそろえた係数 −216 円/ポイント(p = 0.0056) | 「所得の違いだけでは説明できない」と書ける |
| Plan | 年度を変えると結論は変わるか | r は −0.013〜−0.490、p < 0.05 は 12 年度中 7 年度(2017〜2023 年度) | 「2017 年度以降は一貫して負」と期間を明記する |
| Data | 564 行をまとめてよいか、値はどれだけ揺れるか | まとめると r = −0.024(年度の平均どうしは +0.881)、保健医療費の前年度比の中央値 7.23% | 単位は「年度ごとの 47 県」。1 年度の値は揺れが大きいと注記する |
| Analysis | 1 県や外れ値で結論が変わらないか | ρ = −0.468、1 県除くと −0.603〜−0.437、95% 区間 [−0.715, −0.185] | 向きは頑健、大きさの不確かさは区間で示す |
こうして書き直した C は、「2017 年度以降の各年度で、高齢化率が高い県ほど二人以上世帯の保健医療費支出は少ない傾向があり(2023 年度 r = −0.490、95% 区間 −0.72〜−0.19)、消費支出の違いをそろえても残る。ただし 2016 年度以前ははっきりせず、家計の支出は年ごとの揺れが大きい。原因(世帯構成・公的負担など)はこのデータでは特定できない」となります。1 周目より長くなりましたが、どこまで言えて、どこから先が言えないかの境目がはっきりしました。そして「世帯人員や医療費の総額で見たらどうか」という 3 周目の Problem が、今度は必要なデータ(SSDSE-B-2026 には無い列)の形で具体的に見えています。
2 周目の Conclusion(続き)— 係数を「実感できる大きさ」に直して伝える
「−315 円/ポイント」は正しい数字ですが、読み手には大きいのか小さいのかが伝わりません。Conclusion では、係数を現実に起こりうる違いの幅に掛けて、元の単位で言い直します。ここでは高齢化率の四分位範囲(47 県の真ん中の半分の幅)を使い、1 周目と 2 周目の係数を並べます。
🎯 このコードでやること:2023 年度の高齢化率の 25% 点と 75% 点を求め、1 周目(高齢化率だけ)と 2 周目(消費支出もそろえる)の回帰の係数と 95% 信頼区間を、四分位の差の分だけの保健医療費の差(月額・平均に対する割合)に直す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 d['保健医療費'] = d['L322106'].astype(float) d['消費支出'] = d['L3221'].astype(float) q1, q3 = d['高齢化率'].quantile([0.25, 0.75]) m1 = smf.ols('保健医療費 ~ 高齢化率', data=d).fit() m2 = smf.ols('保健医療費 ~ 高齢化率 + 消費支出', data=d).fit() print(f'高齢化率の四分位: 25% 点 {q1:.1f}% 75% 点 {q3:.1f}% 差 {q3 - q1:.1f} ポイント') for name, m in [('1 周目(高齢化率だけ)', m1), ('2 周目(消費支出もそろえる)', m2)]: b = m.params['高齢化率']; lo, hi = m.conf_int().loc['高齢化率'] print(f'{name}: 係数 {b:.0f} 円/ポイント [95%CI {lo:.0f}, {hi:.0f}]' f' → 四分位の差では月 {b * (q3 - q1):,.0f} 円(平均 {d["保健医療費"].mean():,.0f} 円の {b * (q3 - q1) / d["保健医療費"].mean():+.1%})') |
💬 高齢化率の 25% 点は 30.0%、75% 点は 34.0% で、47 県の真ん中の半分はわずか 4.0 ポイントの幅に収まっています。この差に係数を掛けると、1 周目の係数では月 −1,248 円(平均 14,423 円の −8.7%)、消費支出をそろえた 2 周目の係数では月 −858 円(−5.9%)です。「高齢化率が典型的に高い県と低い県で、二人以上世帯の保健医療費は月 900〜1,200 円ほど違う」と言い直すと、関係の大きさが実感できます。係数の 95% 信頼区間(2 周目で −366〜−67 円/ポイント)も同じように四分位の差に掛けると、月 −1,451〜−264 円と幅が広く、Analysis で見た不確かさがそのまま残ります。C では「関係の向き」「元の単位での大きさ」「その不確かさ」の 3 つを 1 文にそろえて書きます。
🧪 2 周目の理解度チェック
| 問題 | 解答 |
|---|---|
| Q1. 12 年度の 564 行で相関を取ると r = −0.024 だった。「高齢化率と保健医療費は無関係」と結論してよいか。 | よくない。年度ごとの 47 県では 2017 年度以降一貫して負だが、年度の平均どうしは +0.881 で、逆向きの 2 つの関係が混ざって打ち消している。行の単位(県 × 年度)を確かめ、年度ごとに見るか年度の効果を分けて分析する。 |
| Q2. 2023 年度の r = −0.490 と 2013 年度の r = −0.013 のどちらを報告すべきか。 | Plan で決めた年度(例: 最新年度)を報告し、ほかの年度の結果も並べて示す。結果を見てから都合のよい年度を選ぶと、偶然の強さを結論にしてしまう。 |
| Q3. 保健医療費を消費支出で割った割合でも r = −0.392 だった。この結果から言えることは。 | 支出全体の大きさの違いだけでは負の関係を説明できない。ただし世帯人員や医療費の公的負担など、SSDSE-B-2026 に無い要因は調べられていないので、原因を特定したことにはならない。 |
| Q4. 沖縄県を除くと r が −0.490 → −0.603 に強まった。沖縄県を外れ値として除いて報告してよいか。 | 除く理由がデータの誤りでない限り、除かない。「沖縄県を除くと −0.603、東京都を除くと −0.437」のように、1 県で結論がどれだけ動くかを併記するのが適切。 |
| Q5. 検出力の表で、47 県のまま |ρ| = 0.30 の関係を 80% の確率で見つけるには、何年度分の独立なデータが必要か(年度どうしを独立とみなした概算)。 | 必要な件数は 85 なので、47 件の年度 2 つ分(94 件)で届く計算。ただし同じ県の別年度は独立ではない(⑦ の 564 行の例のように実質の件数は増えにくい)ので、年度を足すなら県クラスタの標準誤差などで評価する。 |
| Q6. 5 県の手計算で、沖縄県の偏差の積だけが正だった。沖縄県を除いた 4 県で r を計算すると、負の関係は強まるか弱まるか。 | 強まる。沖縄県は「高齢化率が低いのに医療費も少ない」点で、負の傾向に逆らう唯一の県だったので、除くと残りの積はすべて負になり、4 県の r は −0.800 になる。47 県で沖縄県を除いたときに r が −0.490 → −0.603 と強まったのと同じ。 |
3 周目 — 年度を変えて、 結論が崩れないか試す
🌐 の「3 周目以降は反証を試す」を実際に行う。 1・2 周目の結論はどちらも 2023 年度の 47 県だけから出したものなので、 Problem を「この負の関係は、 年度を変えても同じ強さで出るか」に置き直し、 Plan で「年度ごとに同じ計算をして並べる」と決めてから Data と Analysis に進む。
🎯 このコードでやること:1・2 周目で使った 2023 年度だけでなく、 2012〜2023 年度の 12 年分それぞれで、 47 県の高齢化率と保健医療費(金額と、 消費支出に占める割合)の相関係数を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['保健医療費の割合'] = df['保健医療費(二人以上の世帯)'] / df['消費支出(二人以上の世帯)'] * 100 rows = [] for y, g in df.groupby('年度'): # 年度ごとに 47 県で相関を計算する rows.append({'年度': y, 'r(金額)': g['高齢化率'].corr(g['保健医療費(二人以上の世帯)']), 'r(割合)': g['高齢化率'].corr(g['保健医療費の割合'])}) t = pd.DataFrame(rows).set_index('年度').round(3) print(t.to_string()) print('金額で負になった年度:', int((t['r(金額)'] < 0).sum()), '/ 12', ' 割合で負になった年度:', int((t['r(割合)'] < 0).sum()), '/ 12') print('r(金額)の範囲:', t['r(金額)'].min(), '〜', t['r(金額)'].max()) |
💬 金額の相関は 12 年度すべてで負だが、 強さは 2013 年度の −0.013 から 2023 年度の −0.490 まで大きく揺れる。 2023 年度の −0.490 は 12 年分で最も強い値で、 2012〜2016 年度は −0.25 より弱い。 割合で見ても 2013 年度だけ +0.013 と符号が変わり、 残る 11 年度は負。 「負の関係がある」という向きは崩れなかったが、 「r = −0.49 の中程度の相関」は、 たまたま一番強く出た年度の値を切り取った書き方になる。 Conclusion には年度による幅(−0.01〜−0.49)と、 近年ほど強まっていることを書くのが正確である。
| 段階 | 3 周目で決めたこと・分かったこと |
|---|---|
| Problem | 2023 年度の負の相関(r = −0.49)は、 年度を変えても同じ強さで出るか |
| Plan | 12 年度それぞれで同じ 47 県・同じ 2 つの指標(金額と割合)の相関を出し、 並べて比べる。 年度を選んで報告しない |
| Data | 564 行を年度ごとに 47 行ずつに分ける。 家計の列は県庁所在市の値であることを明記する |
| Analysis | 金額で −0.013〜−0.490、 割合で +0.013〜−0.392。 向きはほぼ一定、 強さは年度で大きく揺れる |
| Conclusion | 「高齢化率の高い県ほど県庁所在市の世帯の保健医療費は少ない傾向があり、 近年ほどはっきりしている(2012〜2016 年度は弱い)」と書き直す。 次の Problem は「近年強まった理由は何か」 |
🐍 Python 実装
以下は PPDACサイクル を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1 は 1 行目の英語コード行(A1101 など)を飛ばし、2 行目の日本語見出しを列名にする定石。
Data 段階の点検 — 欠損と外れ値を数える
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np # PPDACサイクル に関わる前処理の典型パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023年に統一 # ① 欠損値の確認 print('欠損数:') print(df.isna().sum().sort_values(ascending=False).head(10)) # ② 数値変換(文字列のカンマ・%を除去して数値化) def to_num(s): if isinstance(s, str): try: return float(s.replace(',', '').replace('%', '')) except ValueError: return s return s df = df.apply(lambda col: col.map(to_num)) # ③ 外れ値検出(IQR) q1 = df.quantile(0.25, numeric_only=True) q3 = df.quantile(0.75, numeric_only=True) iqr = q3 - q1 num = df.select_dtypes('number') outlier_mask = ((num < q1 - 1.5*iqr) | (num > q3 + 1.5*iqr)).any(axis=1) print('外れ値を含む行数:', outlier_mask.sum()) |
💬 2023 年度の SSDSE-B は欠損が 1 件も無く、上位 10 列ともに 0 なので、Data 段階の欠損処理はこのデータでは不要と確認できた。一方、IQR 基準で外れ値を 1 つでも含む行は 47 県中 22 県にのぼる。これは 110 の数値列のどれか 1 列で外れれば数える判定だからで、東京都は 92 列、大阪府は 86 列で外れ値になっている。人口の大きさに比例する実数の列が多いためで、県を除外するより人口あたりの比率に直してから外れ値を見直すのが Analysis 前の次の一手になる。
Analysis 段階の最小例 — 東日本と西日本の高齢化率を比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from scipy import stats # PPDACサイクル 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['aging'] = df['A1303'] / df['A1101'] * 100 df['region'] = df['Prefecture'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 東日本 23 都県の平均 31.18% と西日本 24 府県の平均 31.97% の差は 0.79 ポイントで、Welch の t 検定では p = 0.4259、差があるとは言えない。高齢化率は東京都 22.8% から秋田県 39.1% まで広がっており、東西の境目よりも県ごとの違いのほうがはるかに大きい。「東西で差がない」は区分の仕方の結果でもあるので、Conclusion では都市圏・非都市圏など別の区分でサイクルを回し直す余地を残して書く。
⚠️ よくある落とし穴
⚠️ PPDAC の落とし穴 — 段階別チェックリスト
| 段階 | よくある失敗 | 対策 |
|---|---|---|
| Problem | 願望のまま測定不能 | y / x を数式で定義 |
| Problem | 範囲が広すぎる | 「47 県」「2023 年」など限定 |
| Plan | 事前計画を文書化しない | 事前登録 / GitHub commit |
| Plan | サンプルサイズを考えない | 検出力分析 (前出) |
| Data | 欠損 / 外れ値を黙って削除 | 削除ルールを Plan に書く |
| Data | 単位・型を混同 | dtype 確認 + 単位を併記 |
| Analysis | 計画にない検定を追加 | 追加分は exploratory と明示 |
| Analysis | p ハッキング (閾値超えを狙う) | 事前登録 |
| Conclusion | 相関を因果と書く | 「相関」「予測」と書き分け |
| Conclusion | 限界を書かない | Limitations を必須化 |
| Conclusion | 過大一般化 (47 県 → 日本全体) | 範囲を明示 |
🌀 PPDAC は螺旋 — 1 周で終わらない
PPDAC は「1 周してハイ終わり」ではなく、 螺旋 として継続するのが理想です。 1 周目で見えた限界 (外生変数の不足、 因果同定の困難) を踏まえ、 2 周目では パネルデータ + 自然実験 や 機械学習 + 因果推論 (DML) を導入していきます。
| 周 | Problem の洗練 | 手法のアップグレード |
|---|---|---|
| 1 | 何が相関しているか | 重回帰 |
| 2 | 何が予測できるか | 機械学習 + 交差検証 |
| 3 | 何が因果か | 差分の差分法 / IV / DML |
| 4 | 介入効果はどれくらいか | 構造モデル / RCT |
各段階でいちばん多い失敗
PPDAC は「順番に回せばよい」と説明されがちですが、 実際には各段階に固有の失敗の型があります。先回りして知っておくと、手戻りが減ります。
| 段階 | よくある失敗 | 直し方 |
|---|---|---|
| Problem | 問いが大きすぎて、どんな数字が出ても答えになる | 「誰の・いつの・どの指標か」を書くまで先へ進まない |
| Plan | 先にデータを見てから指標を決める | 使う指標と手法を、データを開く前に文章で書き残す |
| Data | 行数・欠損・単位を確かめずに分析へ進む | 最初に必ず shape・describe・欠損数を出す |
| Analysis | 図を描かずに相関係数だけ見る | 散布図を先に見る。r が同じでも形はまるで違う |
| Conclusion | 相関を原因のように書いてしまう | 「言えること」と「言えないこと」を分けて書く |
とくに Plan の失敗は自覚しにくいのが厄介です。 データを眺めてから「この指標が効きそうだ」と決めるのは自然に感じますが、 それは偶然の当たりを本物だと思い込むやり方です。 探索してよい段階と、決めた仮説を検証する段階を分けること。 PPDAC を 2 周するのが、この分離を実現する最も簡単な方法です。
🧪 実データで確かめる — 見てから選んだ「一番」は、 年度が変わると入れ替わる
上の表の Plan の失敗「先にデータを見てから指標を決める」が、 どのくらい結論を揺らすかを確かめる。
🎯 このコードでやること:Plan を決めずにデータを見て、 2018 年度で高齢化率との相関が一番強い費目を選ぶ。 その費目が、 選ぶのに使っていない 2019・2021・2023 年度でも一番強いままかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 cols = [c for c in df.columns if c.endswith('(二人以上の世帯)') and c != '消費支出(二人以上の世帯)'] for c in cols: # 費目を消費支出に占める割合に直す df[c] = df[c] / df['消費支出(二人以上の世帯)'] * 100 def corr_by_year(y): g = df[df['年度'] == y] return g[cols].corrwith(g['高齢化率']) explore = corr_by_year(2018) # 探索に使う年度 best = explore.abs().idxmax() print(f'費目の数 = {len(cols)}') print('2018 年度で |r| が最大の費目:', best, f'r = {explore[best]:.3f}') print(explore.round(3).sort_values().to_string()) for y in [2019, 2021, 2023]: # 探索に使っていない年度で確かめる r = corr_by_year(y) print(f'{y} 年度: {best} r = {r[best]:.3f}(その年の最大は {r.abs().idxmax()} r = {r[r.abs().idxmax()]:.3f})') |
💬 2018 年度で |r| が一番大きいのは「その他の消費支出」(r = 0.457)だが、 2 位の被服及び履物費(−0.426)、 3 位の交通・通信費(0.423)との差はわずかで、 10 費目中 9 費目が |r| ≥ 0.3 に並ぶ。 選んだ費目は別の年度でも 0.330〜0.552 と正の相関を保つが、 「一番」の座は 2019 年度に交通・通信費(0.536)、 2021・2023 年度に教育費(−0.561・−0.669)へ移る。 データを見てから「一番効いている費目」を選んで報告すると、 その順位は偶然の揺れを含んでいる。 Plan の段階で「保健医療費を見る」と先に決めておけば、 この揺れに結論を左右されない。
📚 関連グループ教材(全体像)
PPDAC は、 データ分析の進め方を扱うグループ教材の中で、 統計教育の側から見た手順として位置づけられる。 同じグループの枠組みと比べると、 何を重く見るかの違いが分かる。
- CRISP-DM — 業務理解から運用までの 6 段階。 PPDAC の Problem に当たる「ビジネス理解」と、 PPDAC に無い「展開(Deployment)」を持つ
- データ分析プロセス — 収集・前処理・分析・報告の流れ全体
- データ解析サイクル — 分析を繰り返す循環の考え方
- EDA — Data と Analysis のあいだで、 仮説を立てる前にデータを眺める段階
🖼 PPDAC の各フェーズを SSDSE-B-2026 で見る — 3 つの図
PPDAC は抽象的に語られがちだが、 実データを使えば各フェーズで「実際に何が起きるか」を体感できる。 ここでは SSDSE-B-2026 の 2023 年度 47 都道府県データで、 Problem を「人口の多い県ほど、 二人以上の世帯の消費支出(L3221、 月平均)は多いか」と置き、 Data → Analysis の核となる 3 つの可視化を順にたどる。
図 1: Data フェーズ — まずヒストグラムで分布を見る
最初にやるべきは「変数の分布の形」を確かめること。 ヒストグラム 1 枚で、 中心・広がり・歪み・外れ値の存在が一目で分かる。 PPDAC では Plan で立てた仮定(例: 正規分布近似で平均差を比較)が成り立つかを Data フェーズで検証する材料になる。
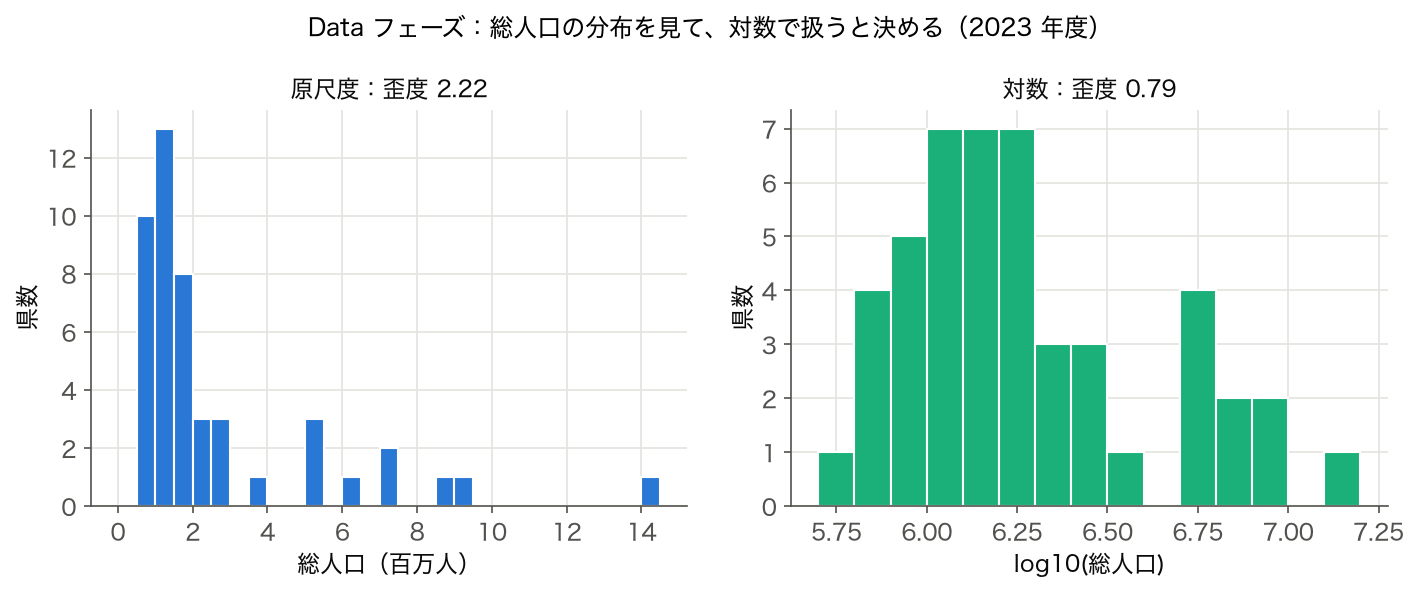
図 2: Analysis フェーズ — 2 変数の関係を散布図で探る
PPDAC の Analysis フェーズでは「変数同士の関係」を見ることが多い。 散布図は「2 つの量的変数が連動しているか」を視覚的に確認する最も基本的な道具。 直線的な右上がりなら正の相関、 散らばっていれば独立、 U 字なら非線形関係が示唆される。
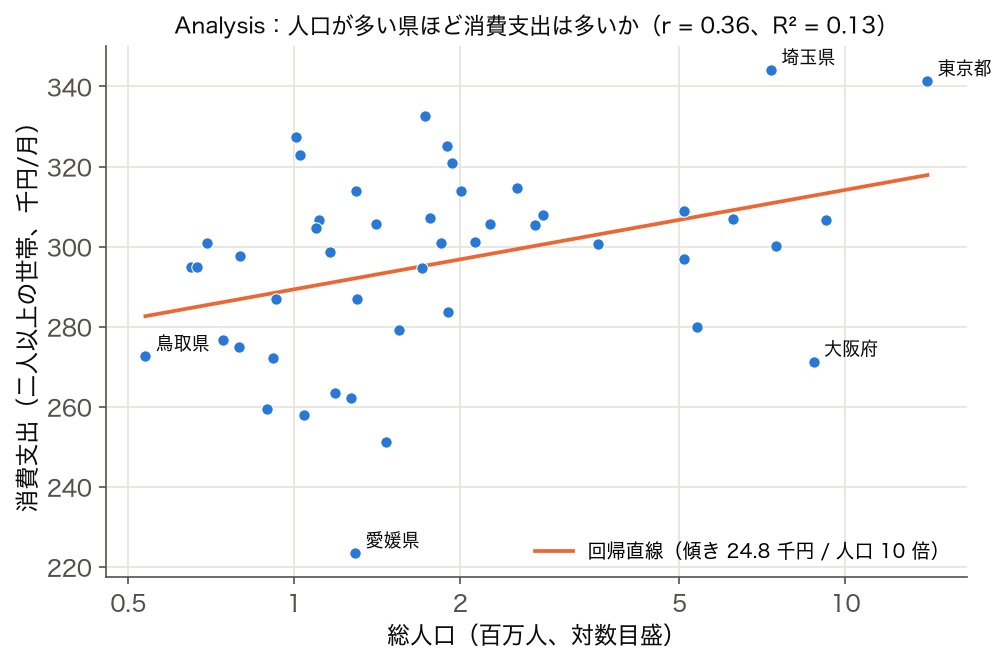
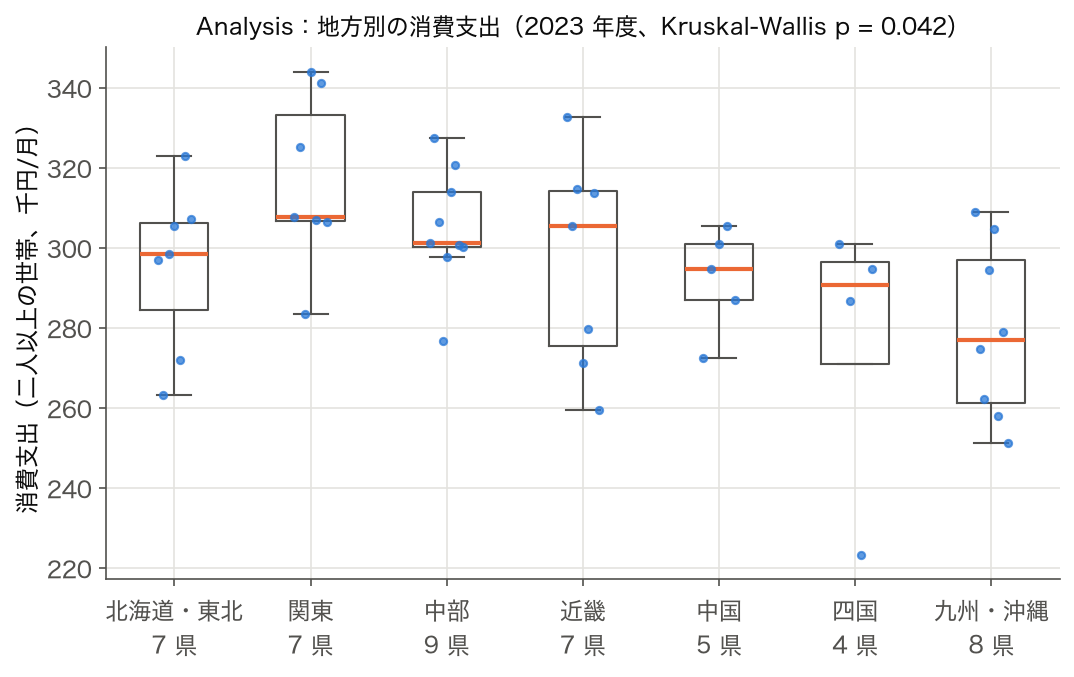
図 3: Analysis フェーズ — 群間比較は箱ひげ図
「複数のグループで分布を比較したい」場面では箱ひげ図が定番。 各群の中央値・四分位範囲・外れ値が同時に見え、 ヒストグラムを N 枚並べるよりはるかにコンパクトに集約できる。 PPDAC の Analysis フェーズで「群間差を主張する根拠」として頻出。
ヒストグラム・散布図・箱ひげ図は 「データを見る」基本三種であり、 Analysis フェーズで仮説検証に進む前段階としてほぼ必須。 PPDAC を実践する際は、 まずこの 3 枚を出力できる Python スクリプトを手元に置いておくと良い。
🧠 理解度チェック — 練習問題で自分の理解を測る
PPDACサイクル の本質が身についているかを 10 問で点検する。 まず自力で 30 秒考え、 その後 解答・解説 を展開すること。 全問正解で「PPDAC を実務に下ろせる」レベルに到達したと判断できる。
Q1. PPDAC の 5 文字はそれぞれ何の頭文字か。 順番に書け。
Problem → Plan → Data → Analysis → Conclusion。解説: 順番が重要。 Problem を曖昧にしたまま Data を集めても「何を測ったのか」が後で分からなくなる。 必ず「問いの言語化(Problem)」と「設計(Plan)」を先に固める。
Q2. Problem フェーズで決めるべき 3 要素は何か。
解説: この 3 つを 1 文で書けないなら、 Plan に進んではいけない。 「東京都の 20 代の所得を 47 都道府県と比較して、 進学率施策の参考にする」のように具体化する。
Q3. Plan で「サンプルサイズ」を決める際の典型的根拠は?
解説: SSDSE-B-2026 のように全 47 都道府県を扱う「全数調査型」では n を選ぶ余地が小さく、 代わりに区間推定の幅と効果量を事前に試算する。
Q4. Data フェーズで最初に確認する 4 つの基本属性は?
shape(行数・列数)、 dtype(型)、 isna().sum()(欠損)、 describe()(数値要約)。解説: いきなり可視化や検定に行く前に必ず「データ理解の 4 点セット」を出力する。 dtype を見落とすと
"1,234" が文字列のまま平均計算でエラーになる。
Q5. Analysis で「探索的(EDA)」と「確証的(CDA)」の違いは?
解説: 真摯な分析では、 EDA → 仮説 → 新規データ収集 → CDA の流れが望ましい。 同一データでやる場合は train-test split や Cross Validation で擬似的に分ける。
Q6. Conclusion で必ず併記すべき「不確実性の表現」3 種は?
解説: 「有意差あり (p<0.05)」とだけ書く報告は、 効果が極小でも合格してしまう。 「効果量 d=0.12 [95%CI: 0.02, 0.22], p=0.03」のように 3 点セットで報告する。
Q7. PPDAC の「サイクル」が示唆する一番大事な性質は?
解説: 試験や 1 回限りのレポートでは 1 周で完結することが多いが、 実務では「Conclusion で示した不確実性を縮めるために、 もう一度設計と収集をやり直す」のが当然。
Q8. PPDAC を CRISP-DM と比較したときの最大の違いは?
解説: 教育・科学的な仮説検証なら PPDAC、 ビジネス案件のプロジェクト管理なら CRISP-DM が好まれる傾向。
Q9. Plan フェーズで「変数定義表 (codebook)」を作る目的は?
解説: codebook を作らずに分析を始めると、 半年後に自分でも「この列は何だっけ?」となる。 共著者・後任との情報共有でも必須。
Q10. PPDAC を「日常生活」に応用するとどんな例があるか。
解説: 統計・科学の専門家以外でも、 「定量的な意思決定」をしたい場面は無数にある。 PPDAC は思考のテンプレとして家計・健康管理・部活運営など、 あらゆる文脈で使える。
※ 8 問以上正解できれば、 本ページの内容は確実に身についている。 5 問未満なら「🎨 直感で掴む」と「🐍 Python 実装」を再度読み直すこと。
📚 参考文献
- MacKay, R. J., & Oldford, R. W. (2000). Scientific Method, Statistical Method and the Speed of Light. Statistical Science, 15(3), 254–278. — Problem・Plan・Data・Analysis・Conclusion の段階を、 光速の測定の歴史を例に整理した論文
- Wild, C. J., & Pfannkuch, M. (1999). Statistical Thinking in Empirical Enquiry. International Statistical Review, 67(3), 223–265. — PPDAC を統計的思考の探究サイクルとして位置づけ、 ニュージーランドの統計教育に取り入れられた
- 文部科学省『高等学校学習指導要領(平成 30 年告示)解説 数学編』 — 「問題 → 計画 → データ → 分析 → 結論」の統計的探究プロセスとして扱われる
🌀 PPDAC 完全例: 都道府県人口減少を 5 段階で分析する
PPDAC サイクル (Problem → Plan → Data → Analysis → Conclusion) は、 統計探究の 背骨 です。 ここでは SSDSE-B-2026 の都道府県データを使い、 「人口減少を何が予測しているか」 という現実問題を 5 段階で分析する完全例を示します。
① Problem (問題設定) — 何を知りたいか
大問題: 人口減少を止めたい
絞り込んだ問題: 47 都道府県の人口減少率 (%) と相関する社会経済要因は何か。 介入可能な要因はあるか。
成果物: 政策提言 1 ページ + 根拠データ + 限界の明示
🔬 数式を言葉で読み解く — Problem を「測定可能」に変換する
「人口減少を止めたい」は 願望 です。 これを 測定可能 な統計問題に変換する必要があります。 具体的には:
- 目的変数: $y_i = $ 県 $i$ の年間人口変化率 (%) = ($A1101_{2024} - A1101_{2023}) / A1101_{2023} \times 100$
- 説明変数候補: $x_i^{(1)} = $ 出生率、 $x_i^{(2)} = $ 高齢化率、 $x_i^{(3)} = $ 消費支出、 $x_i^{(4)} = $ 婚姻率、 $x_i^{(5)} = $ 転入率
- モデル: $y_i = \beta_0 + \sum_{k=1}^5 \beta_k x_i^{(k)} + \varepsilon_i$
- 判定: $\beta_k$ の符号、 大きさ、 p 値、 信頼区間
② Plan (計画) — どう答えを出すか
問題が決まったら、 データを見る前に 解析計画を書きます。 これは事前登録と同じ精神で、 「あとから都合よく仮説を変える」 (HARKing) を防ぐためです。
| 項目 | 事前計画 |
|---|---|
| 対象 | 47 都道府県 (悉皆 / 標本ではない) |
| 期間 | SSDSE-B-2026 (2023 年データ基準) |
| 主分析 | 重回帰 (5 変数) |
| 副分析 | VIF 確認、 標準化、 残差プロット |
| α | 0.05 (5 変数 Bonferroni 補正で 0.01) |
| 外れ値 | Cook's distance > 4/n は注釈 |
| 公開 | コード + データ + レポートを GitHub 公開 |
🔬 数式を言葉で読み解く — VIF と多重共線性
VIF (Variance Inflation Factor) は次式。
$$\text{VIF}_k = \frac{1}{1 - R_k^2}$$
ここで $R_k^2$ は $x_k$ を残りの説明変数で回帰したときの決定係数。 VIF が 10 を超えると 多重共線性 が深刻で、 個別係数の解釈が不安定になります。 計画段階で VIF をチェックする手順を決めておくことが、 「あとから変数を追加・削除して都合よく結論を作る」のを防ぎます。
③ Data (データ収集と前処理)
SSDSE-B-2026 は 政府統計の e-Stat から作られた教育用 CSV で、 47 都道府県 × 100+ 指標を含みます。 まず データの素性 を確認し、 欠損値・型・単位を点検します。
このコードでやること: SSDSE-B-2026 を読み込み、 5 つの説明変数と人口変化率を含むデータフレームを作成。 欠損 / 外れ値 / 基本統計を点検する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cur = df[df['SSDSE-B-2026'] == 2023].set_index('Code') # 2023年(分析対象) prev = df[df['SSDSE-B-2026'] == 2022].set_index('Code') # 前年(変化率計算用) # 目的変数: 人口変化率 (%) = (2023人口 - 2022人口) / 2022人口 * 100 cur['pop_change_pct'] = (cur['A1101'] - prev['A1101']) / prev['A1101'] * 100 # 説明変数: 出生率(千人対)・高齢化率(%)・消費支出(円)・婚姻率(千人対)・転入率(千人対) cur['birth_rate'] = cur['A4101'] / cur['A1101'] * 1000 cur['aging_rate'] = cur['A1303'] / cur['A1101'] * 100 cur['marriage_rate'] = cur['A9101'] / cur['A1101'] * 1000 cur['transfer_rate'] = cur['A5101'] / cur['A1101'] * 1000 cols = ['pop_change_pct', 'birth_rate', 'aging_rate', 'L3221', 'marriage_rate', 'transfer_rate'] sub = cur[cols].copy() print("--- 欠損数 ---") print(sub.isna().sum()) print("\n--- 基本統計 ---") print(sub.describe().round(3).T[['count', 'mean', 'std', 'min', 'max']]) |
📤 実行結果:
💬 47 県すべて欠損なし。 人口変化率は 平均 -0.82%(全国的に減少傾向)、 最小 -1.72%(秋田県)、 最大 +0.34%(東京都)。 消費支出 (L3221) は他の変数と桁が大きく異なる(平均 約29.6万円)ため、 回帰前に 標準化が必須 と分かります。
④ Analysis (分析と可視化)
いよいよ 計画通りの 重回帰を実行します。 ここで重要なのは「計画になかった分析を勝手にやらない」こと。 思いつきの追加分析は探索的 (exploratory) として明示し、 確認的 (confirmatory) 結論には含めません。
このコードでやること: 5 つの説明変数 (出生率, 高齢化率, 消費支出 L3221, 婚姻率, 転入率) を標準化して人口変化率を重回帰。 VIF と係数 p 値も確認する。
📥 入力データ: 上で作った sub データフレーム (47 行 × 6 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler import statsmodels.api as sm from statsmodels.stats.outliers_influence import variance_inflation_factor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cur = df[df['SSDSE-B-2026'] == 2023].set_index('Code') prev = df[df['SSDSE-B-2026'] == 2022].set_index('Code') cur['pop_change_pct'] = (cur['A1101'] - prev['A1101']) / prev['A1101'] * 100 cur['birth_rate'] = cur['A4101'] / cur['A1101'] * 1000 cur['aging_rate'] = cur['A1303'] / cur['A1101'] * 100 cur['marriage_rate'] = cur['A9101'] / cur['A1101'] * 1000 cur['transfer_rate'] = cur['A5101'] / cur['A1101'] * 1000 features = ['birth_rate', 'aging_rate', 'L3221', 'marriage_rate', 'transfer_rate'] X = pd.DataFrame(StandardScaler().fit_transform(cur[features]), columns=features, index=cur.index) y = cur['pop_change_pct'].values model = sm.OLS(y, sm.add_constant(X)).fit() print(model.summary().tables[1]) print("\nVIF:") for i, name in enumerate(features): print(f" {name:14s}: {variance_inflation_factor(X.values, i):.2f}") print(f"\nR2 = {model.rsquared:.3f}, adj-R2 = {model.rsquared_adj:.3f}") |
📤 実行結果:
💬 R²=0.906 で 人口変化の約 91% を説明 できている。 統計的に有意(α=0.05、 Bonferroni 補正後 0.01 でも)な要因は 2 つ: ① 高齢化率↑ → 人口変化↓(標準化係数 -0.319、 影響が最大)、 ② 転入率↑ → 人口変化↑(+0.106)。 出生率・消費支出・婚姻率は、 他を統制すると有意でない。 VIF は最大 6.4(高齢化率)で 10 を下回り、 多重共線性は許容範囲。
⑤ Conclusion (結論と政策提言)
最後の段階では、 分析結果を 意思決定者が理解できる言葉 に翻訳します。 同時に 限界 と 次のステップ を必ず添えます。
📋 政策提言 (1 ページ要約)
1. 47 都道府県の人口変化率は、 高齢化率 (−) と 転入率 (+) がとくに強く効き、 5 変数全体で約 91% を説明できる。
2. 出生率・消費支出・婚姻率は、 統制後は有意な寄与を示さない。
3. 効果量で見ると 高齢化率の影響が最大(標準化係数 -0.319)。
政策提言:
A. 転入(社会増)の促進は人口維持に直接効く(転入率係数 +0.106、 有意)。
B. 高齢化の進行は人口減少に最も強く効く(標準化係数 -0.319)。 高齢化対策は長期的な人口維持に最重要だが、 即効性は低い。
C. 消費支出(経済規模の代理指標)は、 本モデルでは統制後に有意な効果を示さなかった(係数 +0.032、 p=0.25)。 経済要因の検証には別の指標・手法が必要。
限界 (Limitations):
- これは 2023 年の横断データ。 因果ではなく 相関 しか主張できない。
- 47 県のみ。 さらに細かい市町村レベルでは異なる結論があり得る。
- 外生変数(気候・地理・歴史)が含まれていない(除外変数バイアス)。
次のステップ:
- 時系列データ (パネル) で因果効果を推定。
- 自然実験(地方創生交付金など)の準実験デザインを試す。
🔬 数式を言葉で読み解く — 「説明」と「予測」と「因果」の違い
説明力 (R²) = 観測されたバラツキの何%を捉えたか。 予測力 = 新しい県(仮想)の人口変化を当てる力。 因果効果 = 「出生率を 1 上げたら人口変化はどう変わるか」という政策実験の答え。 PPDAC の Conclusion では、 この 3 つを 取り違えない ことが最も重要。 重回帰の係数は単独では因果ではなく、 「他の変数を統制した上での部分相関の方向と大きさ」にすぎません。
🐍 Conclusion を再現可能にする最後のコード
このコードでやること: 直前の重回帰 model から係数と p 値を取り出して CSV に書き出し、 再現可能な成果物にする (PPDAC の Conclusion を文書化)。
📥 入力データ: 上で作った model (sm.OLS の結果)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd # 直前の重回帰 model から係数と p 値を取り出す (手で数字を写さない) coef = model.params.drop('const') pval = model.pvalues.drop('const') result = pd.DataFrame({ 'feature': coef.index.str.replace('L3221', 'consumption'), 'coef': coef.values.round(3), 'p_value': pval.values.round(3), 'significant': (pval < 0.05).values, }) result.to_csv('output/ppdac_pop_result.csv', index=False) print(result.to_string(index=False)) print("\n出力 → output/ppdac_pop_result.csv (再現可能な成果物)") |
📤 実行結果:
💬 PPDAC の閉じ方は「新たな Problem を生む」ことです。 ここではCSV には有意な 2 変数 (aging_rate −0.319・transfer_rate +0.106) と、 有意でない 3 変数 (婚姻率 p=0.896 など) がそのまま残る。 係数を model から直接取り出しているので、 データ年度を差し替えて再実行しても表が古い数字のまま残ることはない。 ここから「消費支出 (p=0.252) は本当に効かないのか、 別の経済指標なら効くのか」「転入率の効果は若者の流出と還流のどちらで生じているのか」など、 次の研究問題が見えてきました。 サイクルは 螺旋 として継続するのが理想的です。
🗺 概念マップ
PPDAC サイクル (Problem → Plan → Data → Analysis → Conclusion) を中心に、 上位概念 (探究学習・統計的問題解決)、 並列概念 (CRISP-DM・OSEMN・KDD プロセス)、 応用 (中高統計教育・データサイエンス入門・SSDSE 課題設計) を関係づけて整理する。
PPDAC サイクル (Problem → Plan → Data → Analysis → Conclusion) はニュージーランド統計教育で開発された統計的探究の枠組みで、 学術研究の論文構成、 実務応用のデータ分析プロジェクト、 公的統計を使った社会問題解決のすべてに共通する反復プロセスである。 Conclusion の段階で新たな Problem が生まれて再帰するため、 一度回したら終わりではなく螺旋状に深化する点が特徴で、 SSDSE-B-2026 を使った高校・大学のデータ探究学習でも標準フレームワークとして採用されている。
🔗 隣接手法への橋渡し
PPDAC サイクルは「問題発見 → 計画 → データ → 分析 → 結論」という反復プロセスで、 隣接する科学的方法論と多くを共有する。
- 上流(問題設定の枠組み): リサーチクエスチョン の定式化、 仮説 の立案が Problem-Plan 段階の核となる。
- 並列(類似の反復サイクル): PDCA サイクル は品質管理由来で「計画-実行-評価-改善」、 CRISP-DM はビジネス向けデータマイニング、 OSEMN はデータサイエンス実務向け、 いずれも「反復で改善」が共通点。
- 下流(各段階で使う手法): Data 段階で 標本設計・無作為抽出、 Analysis 段階で 記述統計・仮説検定・可視化、 Conclusion 段階で 再現性・倫理 への配慮が必要。
PPDAC を一周回すと Conclusion から新たな Problem が生まれて螺旋的に深化する。 高校・大学のデータ探究学習や統計検定でも「考え方の標準形」として明示的に教えられている。
他のサイクルとの違い — PPDAC / CRISP-DM / OSEMN
似た枠組みがいくつもあります。どれが優れているかではなく、力点が違うと捉えると使い分けられます。
| 枠組み | 出自 | 力点 |
|---|---|---|
| PPDAC | 統計教育 | 問いを立てるところ。Problem に 2 文字ぶんの重みがある |
| CRISP-DM | 産業界のデータマイニング | 業務適用と運用。Deployment まで含む |
| OSEMN | データサイエンス実務 | 手を動かす順序。取得・整形の比重が大きい |
PPDAC が教育で好まれるのは、Problem と Plan を分けている点にあります。 「何を知りたいか」と「どう測るか」を別の段階として書かせることで、 測れる形に落とす訓練ができる。ここが他の枠組みより手厚いところです。
逆に PPDAC には運用の段階がありません。 分析結果をシステムに載せて回し続ける話をするなら CRISP-DM の語彙が要ります。 学習や単発の調査は PPDAC、継続運用を含むなら CRISP-DM、と使い分けるのが実際的です。
🌳 手法選択フロー
「PPDACサイクル」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「PPDACサイクル」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ専用の手法 (カテゴリ変数) と組み合わせ
- 大規模・高次元 → 計算効率を考慮した派生手法 (アジャイル分析サイクル) を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「PPDACサイクル」を中核とした適切な手法選択ができる。
最後に、レポートを書くときの実用的な助言をひとつ。 PPDAC の 5 段階を、そのまま見出しにしてしまうのが確実です。 「問い/測り方/使ったデータ/結果/言えること・言えないこと」と並べるだけで、 読み手はどこを疑えばよいかが分かります。 逆に、結果だけを並べたレポートは、読み手が前提を推測するしかなくなり、 質問が「その数字はどこから?」ばかりになります。 枠組みの価値は、自分の思考を整えることだけでなく、 他人が検証できる形で残すことにもあります。