🔖 キーワード索引
このページで扱う主要キーワード(クリックで該当セクションへ):
💡 30秒で分かる結論
🍰 まずはやさしく
バラバラの表を1つにまとめるパズルのような操作です。
データを分析しやすい形にするために使います。
スマホの連絡先とSNSのアカウントを紐付けるようなものです。
この章ではデータのまとめ方について読みます。
- データ統合とは、 別々に管理された複数のデータソースを共通のキーで結びつけ、 1 つの分析可能な表にまとめる操作。
- 分野:データ前処理/データエンジニアリング — 分析やモデリングの前段でほぼ必ず通る工程。
- 主な操作:横結合(JOIN/merge、 キーで列を増やす)・縦結合(concat/UNION、 行を積む)・名寄せ(表記ゆれの正規化)・スキーマ統合(列名・単位・型の統一)。
- 使う場面:人口表と死亡表を結合して死亡率を出す、 複数年ファイルを積んでパネル化する、 別システムの台帳を名寄せする。
- 注意:キーの表記ゆれ、 内部結合による行の脱落、 多対多結合による行の増殖、 単位・型・粒度の不一致。
📍 あなたが今見ているもの
🍰 まずはやさしく
バラバラに保存されたデータを1つにする方法です。
正しい分析を始めるための準備として使います。
学校の出席簿とテストの結果をまとめる時に似ています。
ここでは統合の流れと関連する言葉について読みます。
「データ統合」 (Data Integration) は、 SSDSE-B-2026 などの公的統計データを使った教材・分析で頻出するキーワードです。 現実のデータは「人口の表」「死亡の表」「所得の表」のように別々のファイル・別々のシステムに分かれて存在します。 分析の第一歩は、 それらを共通のキー(年・都道府県など)で 1 枚の表に束ねること。 本ページでは、 まず直感、 次に結合の種類の定義、 そして 47 都道府県の実データで確かめる、 という流れで整理します。
関連用語(前提・並列・発展)も末尾にまとめてあるので、 用語の地図として活用してください。
🎨 直感で掴む
🍰 まずはやさしく
2枚の名簿を突き合わせるイメージです。
共通の目印を使って情報を付け足すために使います。
部活の名簿に、個人の連絡先を書き足すようなものです。
ここでは横に貼る方法と縦に積む方法について読みます。
データ統合のいちばん素朴なイメージは「2 枚の名簿を突き合わせる」こと。 片方に「都道府県ごとの人口」、 もう片方に「都道府県ごとの死亡数」があるとき、 都道府県名という共通の目印(キー)で 2 枚を横に貼り合わせれば、 「人口と死亡数が同じ行に並んだ 1 枚の表」ができます。 あとは割り算するだけで死亡率が出ます。
直感 1: キーで突き合わせる = JOIN(横結合)
SSDSE では都道府県ごとに人口 A1101 と死亡数 A4200 が並んでいます。 これを別ソース由来の 2 表だと考えると、 「都道府県」というキーで突き合わせて列を増やす操作が JOIN です。 表計算ソフトの VLOOKUP と同じ発想で、 「キーが一致した行だけ、 相手の列を持ってくる」わけです。
直感 2: 横に貼る(JOIN)と 縦に積む(concat)
統合には 2 方向あります。 横結合(JOIN/merge)は「同じ対象について列を増やす」操作。 縦結合(concat/UNION)は「同じ列構成の表を行方向に積む」操作で、 2012 年ファイルと 2023 年ファイルを積んでパネルデータを作るときに使います。 列を増やすのか、 行を増やすのか — ここを取り違えないことが第一歩です。
直感 3: キーが命 — 表記ゆれで突き合わせは壊れる
JOIN はキーの完全一致で結びつきます。 だから「東京都」と「東京」、 「株式会社ABC」と「(株)ABC」のように表記がぶれると、 見た目は同じでも機械的には別物と判定され、 突き合わせが 1 件も成立しないことがあります。 この表記を揃える作業が名寄せで、 データ統合で最も手間のかかる部分です。
直感 4: 相手にない行をどう扱うか = 内部結合 / 外部結合
「両方の表にキーがある行だけ残す」のが内部結合(inner)、 「片方(基準表)の行は全部残し、 相手にない部分は欠損にする」のが外部結合(left/right/full outer)。 内部結合は静かに行を落とすので、 「なぜか件数が減った」の多くはこれが原因です。
📐 定義・結合の種類
🍰 まずはやさしく
共通の項目を基準に表をくっつける操作のことです。
どの行を残してどの行を捨てるかを決めるために使います。
買い物リストと商品の値段表を合わせるようなものです。
ここでは結合の詳しい種類について読みます。
データ統合とは、 異なるソースの複数の表 $R, S$ を、 共通の属性(キー)$k$ の一致に基づいて 1 つの表に結合する操作の総称です。 関係代数では横結合を結合演算 $\bowtie$ で表します。
両表でキー $k$ が一致する組だけを残す。 一致しない行は捨てられる。
左表 $R$ の行はすべて残し、 右に相手がなければ欠損(NULL / NaN)で埋める。
結合(JOIN)の 4 タイプ
| 種類 | pandas の how | 残る行 | 典型的な用途 |
|---|---|---|---|
| 内部結合 INNER | "inner" | 両表にキーがある行のみ | 両方そろって初めて意味を持つ分析(人口×死亡→死亡率) |
| 左外部結合 LEFT | "left" | 左表は全件、 右は一致分のみ | マスター(47都道府県)を軸に、 実績を貼り付ける |
| 右外部結合 RIGHT | "right" | 右表は全件、 左は一致分のみ | left の左右を入れ替えただけ |
| 完全外部結合 FULL | "outer" | どちらかにあれば全部 | 2 ソースの差分・欠けを洗い出す突合 |
横結合(JOIN / merge)と 縦結合(concat / UNION)
| 観点 | 横結合(JOIN / merge) | 縦結合(concat / UNION) |
|---|---|---|
| 増える方向 | 列(属性を足す) | 行(レコードを積む) |
| 前提 | 共通キーがある | 列構成(スキーマ)が揃っている |
| 例 | 人口表 + 死亡表 → 死亡率表 | 2012年 + … + 2023年 → パネル |
| pandas | pd.merge(a, b, on=...) | pd.concat([a, b]) |
統合にまつわる基本用語(一言定義)
| 用語 | 一言定義 |
|---|---|
| キー(結合キー) | 表と表を突き合わせるための共通の目印となる列(年・都道府県など)。 |
| 主キー | 1 つの表の中で行を一意に識別する列(またはその組)。 重複・欠損があってはいけない。 |
| 外部キー | 別の表の主キーを参照する列。 表と表の関係を張る。 |
| マスターデータ | 都道府県一覧・商品台帳のように、 分析の基準となる「正」の参照表。 これを軸に外部結合することが多い。 |
| 名寄せ | 「東京」「東京都」のように表記の異なる同一実体を同じキーに揃える作業。 |
| スキーマ統合 | ソースごとに違う列名・単位・型・粒度を、 共通の定義に合わせて揃えること。 |
| レコードリンケージ | 共通 ID がないデータ同士を、 氏名・住所などの類似度で確率的に突き合わせる名寄せの発展形。 |
🔬 深掘り — 結合キーの「一意性」が行数を決める
ここまでの①〜④とシミュレータで「結合タイプで行が消える」「表記ゆれで突合が全滅する」を見ました。 最後に、 データ統合で起きる行数の変化(脱落と増殖)を一本の式で串刺しにし、 実務で刺さりやすい残りの落とし穴(複合キーの取り違え・時点整合・同名異義列・検算)まで踏み込みます。
🎨 直感: 結合後の行数は「キーの重複数のかけ算」で決まる
横結合(JOIN)の後の行数は、 難しく考えなくても次の一行で説明できます。 あるキー値 $k$ について、 左表でそのキーを持つ行が $a_k$ 個、 右表で $b_k$ 個あるとき、 内部結合で生まれる行数は
左でも右でもキーが一意(各 $a_k, b_k \in \{0,1\}$)なら積は 0 か 1 で、 行は増えも減りもしない(一致すれば 1、 相手が無ければ 0=脱落)。 どちらかでキーが重複($a_k$ や $b_k$ が 2 以上)すると、 その分だけ行が掛け算で増殖する。
この式ひとつで、 これまでの現象が全部つながります。 内部結合の脱落(③の 47→10 行)は「相手にキーが無い= $b_k=0$ で積が 0」。 多対多結合の行増殖(誤解 2)は「片方で $a_k\ge2$ や $b_k\ge2$」。 名寄せ(②)は「そもそも $k$ が揃っていないと全部 $a_k\times b_k=0$ になる」問題でした。 だから統合の設計は、 まず「結合キーは各表で一意か($a_k, b_k$ は 1 以下か)」を確かめることに尽きます。
⚠️ 落とし穴(重要): 「年」を落とした複合キーで行が 12 倍に膨らむ
誤解 2 の行増殖を、 SSDSE-B-2026 の実データで再現します。 このデータは 564 行 = 47 都道府県 × 12 年(2012–2023)で、 1 行を一意に決めるキーは「年 + 都道府県」の複合キーです。 うっかり「年」を落として Prefecture だけで結合すると、 各都道府県が 12 回重複する非一意キーになり、 掛け算で行が膨らみます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) hok = df[df["Prefecture"] == "北海道"][["SSDSE-B-2026", "Prefecture", "A1101"]] print("北海道の行数:", len(hok)) # 12年分 = 12行(Prefectureは12回重複) # キーから「年」を落とすと Prefecture は非一意キー → 掛け算で増殖 bad = pd.merge(hok, hok, on="Prefecture", how="inner") print("年を忘れて Prefecture だけで結合:", len(bad), "行") # 12×12 = 144 # 正しくは 年+都道府県 の複合キーで結合 good = pd.merge(hok, hok, on=["SSDSE-B-2026", "Prefecture"], how="inner") print("年+都道府県で結合:", len(good), "行") # 12 # validate で関係を宣言し、意図しない多対多を例外で検知 try: pd.merge(hok, hok, on="Prefecture", validate="one_to_one") except Exception as e: print("validate=one_to_one で例外:", type(e).__name__) |
📤 実行結果:
💬 読み取り:北海道だけで 12 行(各年 1 行)。 結合キーから「年」を落とすと Prefecture が 12 回重複する非一意キーになり、 $12\times12=144$ 行に膨れ上がりました(脱落と真逆の事故)。 複合キーの一部を書き忘れるのが、 実務で最も多い増殖原因です。 正しく「年 + 都道府県」で結合すれば 12 行のまま。 そして validate="one_to_one" を付けておけば、 非一意キーでの結合を MergeError で実行前に叩き落とせます。 「結合したら行数が想定と違う」を検知する最も安いガードです。
⚠️ さらに刺さりやすい 3 つの落とし穴
pop_oct1)にしてから統合します。_x / _y が生える人口)があると、 pd.merge は自動で 人口_x / 人口_y にリネームします。 これを見落とすと、 後段でどちらを使っているか分からなくなります。 結合前に suffixes=("_住基", "_推計") で由来を明示するか、 事前に列名を一意化しておきましょう。assert len(merged) == 期待値 や、 merged["総人口"].sum() の前後比較を 1 行入れるだけで、 静かな脱落・増殖の大半は水際で止まります。🚀 発展: 一意性の「宣言」から SQL・ETL の自動化へ
ここで使った validate は、 「このキーは一意なはず」という設計上の前提を機械に宣言する営みです。 これはデータベースの世界では主キー制約・UNIQUE 制約、 外部キー制約として最初から仕組み化されています。 発展の方向は次の通りです。
- 関係の言葉で整理する → データ結合(JOIN)・テーブル結合で「一対一/一対多/多対多」を意識する。
- 宣言的に書く・自動化する → SQL の
JOINとPRIMARY KEY/UNIQUE制約、 ETL パイプラインで統合を再現可能な処理として固定する。 - 粒度を揃えてから結合する → キーの重複が「粒度違い」由来なら、 細かい側を集約して粗い側に合わせる(③・ケース 3)。
- 積み上げてパネルにする → 検算済みの縦結合でパネルデータを作り、 年をまたいだ分析へ(④)。
- 共通 ID が無いとき → 正規化キーで揃わない揺れは対応表マスタ、 それでも駄目なら類似度で確率的に突き合わせるレコードリンケージへ(現状このテーマの単独ページは未整備)。
1 対多の結合 — 合計が 48 倍になる実例
ここまでは「1 対 1」で結べる表を見てきました。実務でいちばん事故が多いのは 片方のキーが重複している 1 対多の結合です。 行数の変化が直感と合わないうえ、例外もエラーも出ません。
同梱データで実際に起こしてみます。左は SSDSE-B-2026 の 都道府県ごとに 1 行(47 行)、右は SSDSE-A-2025 の 市区町村ごとに 1 行(1,741 行)。都道府県名で結合します。
| 見るところ | 値 | 意味 |
|---|---|---|
| 左の行数 | 47 | 都道府県は 1 県 1 行 |
| 右の行数 | 1,741 | 市区町村は 1 県あたり平均 37.0 行 |
| 結合後の行数 | 1,741 | 左の 47 行が市区町村の数だけ複製された |
| 県総人口の単純合計 | 6,010,224,000 | 複製された値をそのまま足した誤りの値 |
| 正しい全国人口 | 124,353,000 | 結合前に合計した値 |
| 倍率 | 48.3 倍 | 1 県あたりの市区町村数の平均に対応する |
日本の人口が 60 億人になりました。 ここまで極端だと気づけますが、複製されたのが「県の平均気温」や「県の面積」だったら、 平均を取っても値がもっともらしく見えてしまい、まず気づけません。 市区町村数は北海道 179、富山県 15 と県によって大きく違うので、 市区町村数が多い県ほど重く数えられるという偏りまで生まれます。
防ぎ方は 3 つです。 (1) 結合の前に粒度を揃える(市区町村を県に 集約してから結ぶ)。 (2) 結合の直後に行数を数える(47 のはずが 1,741 なら即座に分かる)。 (3) 複製された列を合計しない(どうしても必要なら重複を除いてから足す)。 下のコードは、この事故と直し方をそのまま再現します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | # ── 1 対多の結合で合計が壊れる様子を実データで見る ── import pandas as pd # 左:都道府県ごとに 1 行(47 行) b = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') b = b[b['年度'] == 2023][['都道府県', '総人口']].rename(columns={'総人口': '県総人口'}) # 右:市区町村ごとに 1 行(1,741 行) a = pd.read_csv('data/raw/SSDSE-A-2025.csv', skiprows=2, encoding='cp932') a = a[['都道府県', '市区町村', '総人口']] print(f'左 = {len(b)} 行(都道府県)/ 右 = {len(a)} 行(市区町村)') print('1 県あたりの市区町村数:', round(len(a) / 47, 1)) m = b.merge(a, on='都道府県', how='inner') print(f'結合後 = {len(m)} 行 ← 左の 47 行が市区町村の数だけ複製された') # ここが事故のもと:複製された県総人口をそのまま合計してしまう print(f'県総人口の単純合計(誤り)= {m["県総人口"].sum():,}') print(f'正しい全国人口 = {b["県総人口"].sum():,}') print(f'倍率 = {m["県総人口"].sum() / b["県総人口"].sum():.1f} 倍') # 正しくは、複製された列は重複を除いてから合計する print(f'重複を除いた合計 = {m.drop_duplicates("都道府県")["県総人口"].sum():,}') |
📤 実行すると次の出力が得られる:
💬 読み方:最後の 2 行が対になっています。drop_duplicates で県の重複を落としてから合計すれば、結合前と同じ 124,353,000 に戻ります。つまり値が壊れていたのではなく、同じ県の値を市区町村の数だけ数えていただけです(北海道の人口は 179 回、富山県は 15 回。倍率 48.3 はこの回数を人口で重み付けした平均)。1 対多の結合をしたら「この列は複製されているか」を必ず自問してください。
🧮 実値で計算してみる — 4 種類の結合で行数がどう変わるか
結合を口で説明すると分かった気になりますが、行数と欠損の数を数えると一発で腑に落ちます。 同梱の 2 つの表を実際に結合して確かめます。
- 左表 B:SSDSE-B-2026 の 2023 年度、
都道府県と総人口。47 行。 - 右表 D:SSDSE-D-2023 の男女計、
都道府県と推定人口(10歳以上)。48 行。
行数が 47 と 48 で 1 つ違います。この 1 行の差がどこへ消えるかが、結合の種類の違いそのものです。
Step 1: 4 種類を数える
| 結合 | 結果の行数 | 欠損を含む行 | 何が起きたか |
|---|---|---|---|
| inner(内部結合) | 47 | 0 | 両方にある 47 県だけが残り、「全国」は黙って消える。 |
| left(左外部結合) | 47 | 0 | 左の 47 行を保つ。右にしかない「全国」は捨てられる。 |
| right(右外部結合) | 48 | 1 | 右の 48 行を保つ。「全国」の総人口が欠損になる。 |
| outer(完全外部結合) | 48 | 1 | どちらかにあれば残す。差分が欠損として見える化される。 |
Step 2: 消えた 1 行の正体
indicator=True を付けて _merge 列を見ると、
right_only に入っていたのは 「全国」 の 1 行でした。
SSDSE-D には 47 都道府県に加えて全国計の行が入っており、SSDSE-B には入っていません。
ここが実務でいちばん危ないところです。inner で結合すると、 「全国」が消えたことに気づかないまま 47 行の表ができあがります。 行数が 47 で揃っているので、一見なにも問題がないように見えます。 逆に、もし全国計を残したまま平均を取れば、全国計が 1 県として二重に数えられ、 平均も相関も狂います。
結合したら必ず行数を数える。 そして「増えた/減った」なら、その 1 行が誰なのかを名指しで確認する。 この 2 つを習慣にすれば、統合工程の事故のほとんどは防げます。
Step 3: 同じ計算を Python で再現する
このコードでやること:上の表を実際に作ります。
4 種類の結合それぞれで行数・欠損数・_merge の内訳を出し、
最後に「右にしかない行」を名指しで表示します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # ── この抜粋で使うデータを用意します ── # SSDSE-B(経済社会)47 行と SSDSE-D(学習・自己啓発)48 行を、都道府県名で結合する。 # D 側には「全国」という集計行が 1 つ余分に入っている。 import pandas as pd b = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') b = b[b['年度'] == 2023][['都道府県', '総人口']] d = pd.read_csv('data/raw/SSDSE-D-2023.csv', skiprows=1, encoding='cp932') d = d[d['男女の別'] == '0_総数'][['都道府県', '推定人口(10歳以上)']] for t in (b, d): t['都道府県'] = t['都道府県'].astype(str).str.strip() print(f'左表 B = {len(b)} 行 / 右表 D = {len(d)} 行') # 4 種類の結合で行数と欠損がどう変わるか for how in ('inner', 'left', 'right', 'outer'): m = b.merge(d, on='都道府県', how=how, indicator=True) n_nan = int(m.isna().any(axis=1).sum()) cnt = m['_merge'].value_counts() print(f'{how:6s} 行数={len(m):3d} 欠損を含む行={n_nan:2d} ' f'both={cnt.get("both", 0)} left_only={cnt.get("left_only", 0)} ' f'right_only={cnt.get("right_only", 0)}') # 右にしか居ないのは誰か only_right = b.merge(d, on='都道府県', how='outer', indicator=True) print('右にだけある行:', only_right.loc[only_right['_merge'] == 'right_only', '都道府県'].tolist()) |
📤 実行すると次の出力が得られる:
💬 一致の確認:Step 1 の表と数字がそのまま一致しました。最後の 1 行が決定的で、消えていたのは「全国」という集計行だと名指しで分かります。inner と left が同じ 47 行になるのは「左にしかない行が 0 件だったから」であって、いつも同じになるわけではありません。左に余分な行があれば inner だけが減ります。
🐍 Python で実践(SSDSE-B-2026 実データ)
ここからは実データ SSDSE-B-2026(564 行 = 47 都道府県 × 12 年 2012–2023、 112 列)を使い、 データ統合の 4 つの基本操作を順に動かします。 CSV は cp932 で、 1 行目が英語コード(A1101 等)、 2 行目が日本語見出しなので、 読み込み時に skiprows=[1] で日本語行を捨て、 英語コードを列名として使います。
① 2 表を JOIN する(内部結合で死亡率を作る)
🎯 目的:別ソースを模した「人口表」と「死亡表」を、 年 + 都道府県のキーで内部結合し、 同じ行に人口と死亡数を並べて死亡率(人口千人あたり)を計算します。
🔗 橋渡し:SSDSE は 1 枚の表ですが、 総人口 A1101 と死亡数 A4200 を別々に切り出すことで「2 つのソースを統合する」状況を再現します。 結合キーは ["年", "Prefecture"] の 2 列です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd # SSDSE-B-2026 を読み込む(1行目=英語コード, 2行目=日本語見出しを除外) df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) df = df[df["SSDSE-B-2026"] == 2023] # 2023年だけ抽出 # 別々のソースから来た2つの表を想定して切り出す pop = df[["SSDSE-B-2026", "Prefecture", "A1101"]].rename( columns={"SSDSE-B-2026": "年", "A1101": "A1101"}) death = df[["SSDSE-B-2026", "Prefecture", "A4200"]].rename( columns={"SSDSE-B-2026": "年", "A4200": "A4200"}) # キー(年 + 都道府県)で内部結合(INNER JOIN) merged = pd.merge(pop, death, on=["年", "Prefecture"], how="inner") merged["死亡率パーミル"] = (merged["A4200"] / merged["A1101"] * 1000).round(2) print("pop:", pop.shape, " death:", death.shape, " merged:", merged.shape) print(merged.head(3).to_string(index=False)) print("全国平均死亡率(‰):", round(merged["A4200"].sum() / merged["A1101"].sum() * 1000, 2)) |
📤 実行結果:
💬 読み取り:人口表 47 行と死亡表 47 行が、 キー完全一致で 47 行に統合されました(1 行も落ちていない=キーが綺麗に対応している証拠)。 統合できて初めて「死亡数 ÷ 人口」という複数ソースにまたがる計算が可能になります。 2023 年の全国平均死亡率は 12.67‰。 北海道 14.75、 青森 17.60 と、 高齢化の進む県で高い傾向が読み取れます。
② 名寄せ — 表記ゆれで JOIN が全滅する例と、その修復
🎯 目的:外部システム由来の表が「北海道→北海」「東京都→東京」のように末尾を落とした表記ゆれを持つとき、 素朴な結合が 0 件になることを見せ、 正規化キーを作る名寄せで 47 件を回復させます。
🔗 橋渡し:高齢人口 A1303 の表を、 わざと末尾の「都道府県」を除いた 地域 列に加工します。 これで「同じ都道府県なのにキー文字列が違う」状況を人工的に作ります。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) df = df[df["SSDSE-B-2026"] == 2023] pop = df[["Prefecture", "A1101"]].rename(columns={"A1101": "A1101"}) # 外部システム由来の表は末尾の都/道/府/県を省いた表記ゆれを持つと想定 ext = df[["Prefecture", "A1303"]].rename(columns={"A1303": "高齢人口"}).copy() ext["地域"] = ext["Prefecture"].str.replace(r"(都|道|府|県)$", "", regex=True) ext = ext[["地域", "高齢人口"]] # そのまま結合 → キーの表記が揃わず1件も一致しない naive = pd.merge(pop, ext, left_on="Prefecture", right_on="地域", how="inner") print("素朴な結合(表記ゆれ)一致件数:", len(naive)) # 名寄せ: 両表に正規化キーを作ってから結合 pop["key"] = pop["Prefecture"].str.replace(r"(都|道|府|県)$", "", regex=True) fixed = pd.merge(pop, ext, left_on="key", right_on="地域", how="inner") print("名寄せ後 一致件数:", len(fixed)) print(fixed[["Prefecture", "A1101", "高齢人口"]].head(3).to_string(index=False)) |
📤 実行結果:
💬 読み取り:「北海道」と「北海」は人間には同じでも、 文字列としては別物なので一致件数は 0。 統合結果が空になったら、 まずキーの表記を疑うのが鉄則です。 両表に同じ正規化ルール(末尾の都/道/府/県を除去)でキーを作り直すと、 一気に 47 件全部が突き合いました。 これが名寄せの最小形です。
③ 内部結合 vs 外部結合 — 行が「消える」か「残る」か
🎯 目的:47 都道府県のマスターと、 一部の県しか観測されていない実績表を結合し、 内部結合(inner)だと行が減り、 左外部結合(left)だと欠損付きで全件残ることを比較します。
🔗 橋渡し:「総人口 300 万人以上の県だけ観測できた」という欠損シナリオを作り、 マスター 47 行に貼り付けます。 どちらの how を選ぶかで結果件数がどう変わるかを見ます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) df = df[df["SSDSE-B-2026"] == 2023] # マスター: 47都道府県すべて / 実績: 総人口300万人以上の県のみ観測されたと想定 master = df[["Prefecture"]].copy() subset = df[df["A1101"] >= 3_000_000][["Prefecture", "A1101"]].rename( columns={"A1101": "A1101"}) print("マスター:", len(master), "行 実績:", len(subset), "行") inner = pd.merge(master, subset, on="Prefecture", how="inner") # 両方にある県だけ left = pd.merge(master, subset, on="Prefecture", how="left") # マスターは全件残す print("内部結合(inner):", len(inner), "行") print("左外部結合(left):", len(left), "行 総人口が欠損(NaN):", int(left["A1101"].isna().sum()), "件") |
📤 実行結果:
💬 読み取り:内部結合は 10 行に激減 — 実績のない 37 県が黙って消えました。 集計対象を「全 47 県」のつもりでいると、 気づかぬうちに一部だけを分析してしまう典型的な事故です。 一方左外部結合は 47 行を維持し、 実績のない県は総人口が NaN(欠損)で残ります。 「母集団を減らしたくない」なら外部結合+欠損の明示が安全です。
④ 縦結合(concat)— 複数年ファイルを積んでパネル化
🎯 目的:年ごとに分かれて配布される想定のファイルを縦方向に積み上げ(UNION)、 1 本のパネルデータにまとめます。 列を増やす JOIN と違い、 行を積むのが concat です。
🔗 橋渡し:SSDSE から 2012 年分と 2023 年分を切り出し、 同じ列構成のまま pd.concat で縦に連結します。 スキーマ(列名・型)が揃っていることが前提です。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) # 別ファイルとして配布された年度データを縦方向に積み上げる想定(UNION / concat) y2012 = df[df["SSDSE-B-2026"] == 2012][["SSDSE-B-2026", "Prefecture", "A1101"]] y2023 = df[df["SSDSE-B-2026"] == 2023][["SSDSE-B-2026", "Prefecture", "A1101"]] panel = pd.concat([y2012, y2023], ignore_index=True).rename( columns={"SSDSE-B-2026": "年", "A1101": "A1101"}) print("concat後 行数:", len(panel), "( =", len(y2012), "+", len(y2023), ")") print(panel.groupby("年")["A1101"].sum()) |
📤 実行結果:
💬 読み取り:47 行 + 47 行がそのまま 94 行に積み上がりました。 縦結合は「同じ意味の列が同じ列名・同じ単位で並んでいる」ことが前提で、 ここがずれているとスキーマ統合(列名や単位の事前統一)が必要になります。 積み上げた結果、 全国総人口は 2012 年の 1 億 2759 万人から 2023 年の 1 億 2435 万人へと約 324 万人減少しており、 年をまたいだ推移分析ができるようになりました。
⑤ 粒度の違う表を結合する — 県の表に「地方の表」を多対一で貼る
🎯 目的:統合でよく出会うのが、細かい単位の表(47 都道府県)と粗い単位の表(7 地方)を突き合わせる場面です。地方ごとの高齢化率を集計した表を作り、各県の行に「所属する地方の値」を貼り付けて、県が地方の中でどれだけ高い・低いかを計算します。
🔗 橋渡し:県 → 地方の対応は多対一(many-to-one)です。validate="m:1" を付けて「右の表のキーは重複しない」ことを宣言しておくと、地方の表にうっかり重複行が入ったときに例外で止まります。地方の値は「65 歳以上人口の合計 ÷ 総人口の合計」で作り、県の率の単純平均とどれだけ違うかも出します。
🎯 このコードでやること:2023 年度の 47 都道府県に 7 地方の区分を付け、地方ごとに 65 歳以上人口と総人口を合計して高齢化率の表(7 行)を作る。これを validate="m:1" で県の表に結合し、県の高齢化率 − 地方の高齢化率 が大きい・小さい県と、地方の値を「率の単純平均」で作った場合との差を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) d = df[df["SSDSE-B-2026"] == 2023].copy() no = d["Code"].str[1:3].astype(int) # R13000 → 13 d["地方"] = pd.cut(no, [0, 7, 14, 23, 30, 35, 39, 47], labels=["北海道・東北", "関東", "中部", "近畿", "中国", "四国", "九州・沖縄"]) d["高齢化率"] = d["A1303"] / d["A1101"] reg = d.groupby("地方", observed=True)[["A1303", "A1101"]].sum() # 7 行の「地方の表」 reg["地方の高齢化率"] = reg["A1303"] / reg["A1101"] # 合計どうしの比 reg["率の単純平均"] = d.groupby("地方", observed=True)["高齢化率"].mean() print((reg[["地方の高齢化率", "率の単純平均"]] * 100).round(2)) m = d.merge(reg[["地方の高齢化率"]], left_on="地方", right_index=True, how="left", validate="m:1") # 多対一の宣言 m["差(pt)"] = (m["高齢化率"] - m["地方の高齢化率"]) * 100 print("結合前", len(d), "行 → 結合後", len(m), "行, 地方が付かない行", m["地方の高齢化率"].isna().sum()) s = m.sort_values("差(pt)")[["Prefecture", "地方", "差(pt)"]].round(2) print(pd.concat([s.head(3), s.tail(3)]).to_string(index=False)) |
💬 地方の表は 7 行で、県の表 47 行に結合しても 47 行のまま(地方の付かない行は 0)です。地方の高齢化率は関東 26.17%・四国 34.38% などで、県の率を単純に平均した値(関東 27.99%)とは最大 1.8 ポイントずれます。単純平均は人口 1,409 万人の東京都も 191 万人の栃木県も同じ 1 票で数えるので、人口の多い県の低い高齢化率が薄まるためです。「地方の中での位置」を見ると、沖縄県は九州・沖縄の 30.59% より 6.74 ポイント低く、秋田県は北海道・東北の 33.34% より 5.72 ポイント高い、と全国順位では見えない「地方内の外れ具合」が分かります。
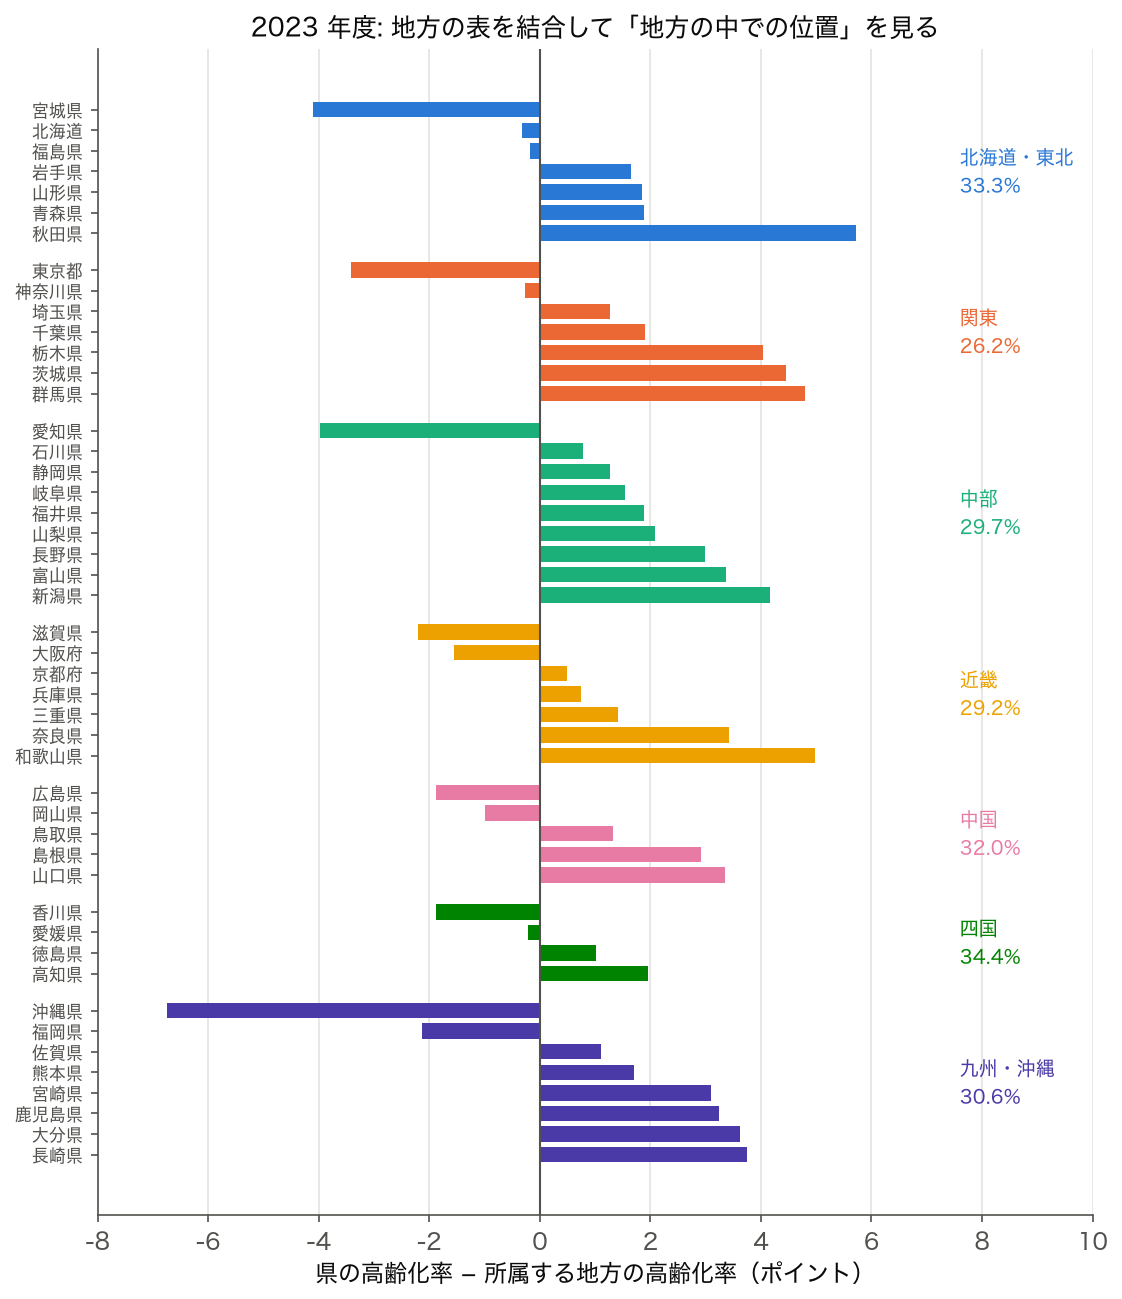
図の読み方: 地方ごとに、差の小さい順に県を並べています(右の数字が結合した地方の高齢化率)。どの地方でも、マイナス側には地方の中心都市を抱える県(宮城県・東京都・愛知県・福岡県・広島県・香川県)や若い人の多い県(沖縄県・滋賀県)が、プラス側にはその周りの県が来ます。関東では東京都(−3.41)と神奈川県(−0.25)だけがマイナスで、残り 5 県は +1.3〜+4.8 ポイントです。これは地方の値が人口の多い都県に引っ張られた「合計比」だからで、地方の値を率の単純平均で作ると 0 の線が右へずれ、マイナスの県が増えます。どちらの基準で結合したかを図や表に必ず書き添えます。図の作成スクリプトは code/glossary_figs/integration.py。
多対一の宣言が守ってくれるもの: 地方の表を 2 つのソース(たとえば東日本の表と西日本の表)から縦に積んで作ると、境目の地方(中部など)が両方に入って重複することがあります。そのまま結合すると中部の 9 県が 2 行ずつに増え、合計が静かに膨らみます。次のブロックで、validate の有無で何が起きるかを確かめます。
🎯 このコードでやること:上の地方の表 reg に「中部」の行をもう 1 行重ねた表を作り、validate なしで結合した場合の行数と総人口の合計、validate="m:1" を付けた場合に出る例外のメッセージを比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from pandas.errors import MergeError dup = pd.concat([reg, reg.loc[["中部"]]]) # 中部が 2 行になった地方の表 print("地方の表の行数", len(dup), "/ 重複したキー", dup.index[dup.index.duplicated()].tolist()) bad = d.merge(dup[["地方の高齢化率"]], left_on="地方", right_index=True, how="left") print("validate なし: 行数", len(bad), ", 総人口の合計", f'{bad["A1101"].sum():,}', "(本来", f'{d["A1101"].sum():,})') try: d.merge(dup[["地方の高齢化率"]], left_on="地方", right_index=True, how="left", validate="m:1") except MergeError as e: print("validate='m:1':", type(e).__name__, "-", e) |
💬 地方の表に中部が 2 行あると、validate を付けない結合は例外を出さずに 56 行(47 + 中部の 9 県)を返し、総人口の合計は 1 億 2435 万人から 1 億 4510 万人へ 2,075 万人(中部 9 県の人口)膨らみます。validate="m:1" を付けると MergeError で止まり、「右の表のキーが一意でない」ことがその場で分かります。結合のたびに行数を print する習慣(落とし穴の 7 項目)と、関係の宣言(validate)は、この種の事故を 2 重に防ぎます。
⑥ 統合した列どうしの整合性を確かめる — 内訳の合計は総数と一致するか
🎯 目的:SSDSE-B-2026 は、国勢調査・人口推計・人口動態統計・建築着工統計など、別々の統計を 1 枚の表に統合したものです。統合された表では、「内訳を足すと総数になるはず」の列の組が整合しているかを確かめるのが基本の品質チェックです。ここでは ①男 + 女 = 総人口、②15 歳未満 + 15〜64 歳 + 65 歳以上 = 総人口、③持家 + 貸家 + 分譲住宅 = 着工新設住宅戸数、の 3 組を 564 行すべてで調べます。
🔗 橋渡し:「一致しない行がある」こと自体は誤りとは限りません。ずれの大きさと、ずれの出る年度・県の偏りを見て、「丸め」「不詳」「内訳に無い区分」のどれで説明できるかを判断します。
🎯 このコードでやること:564 行(47 都道府県 × 12 年度)について、男女の合計・年齢 3 区分の合計と総人口のずれを年度ごとに集計する(ずれのある行数・全国のずれの合計・県ごとの最大のずれ)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) df["男女ずれ"] = df["A110101"] + df["A110102"] - df["A1101"] df["年齢ずれ"] = df["A1301"] + df["A1302"] + df["A1303"] - df["A1101"] t = df.groupby("SSDSE-B-2026").agg( 男女ずれ行数=("男女ずれ", lambda s: (s != 0).sum()), 男女最大=("男女ずれ", lambda s: s.abs().max()), 年齢ずれ行数=("年齢ずれ", lambda s: (s != 0).sum()), 年齢ずれ全国計=("年齢ずれ", "sum"), 年齢ずれ最大率=("年齢ずれ", lambda s: (s / df.loc[s.index, "A1101"] * 100).min()), ) print(t.round(2).to_string()) |
💬 男女の合計のずれは、国勢調査の年(2015・2020 年度)には 0 行で、それ以外の年度は 4〜16 行に最大 1,000 人のずれがあります。国勢調査の年以外の人口は千人単位に丸めた推計値なので、男・女・総数をそれぞれ丸めると 1,000 人ずれることがあり、これは「丸め」で説明できます。年齢 3 区分のずれは性質が違い、国勢調査の年に全国で 145.4 万人(2015 年度)・293.2 万人(2020 年度)も足りず、47 都道府県すべてで合計が総人口を下回ります。国勢調査では年齢を回答しなかった人が「年齢不詳」として総人口にだけ含まれるためで、SSDSE にはこの不詳の列がありません。2016〜2019 年度の推計人口でも 11.2〜38.2 万人のずれが年々大きくなっており、2021 年度以降はほぼ 0 です。
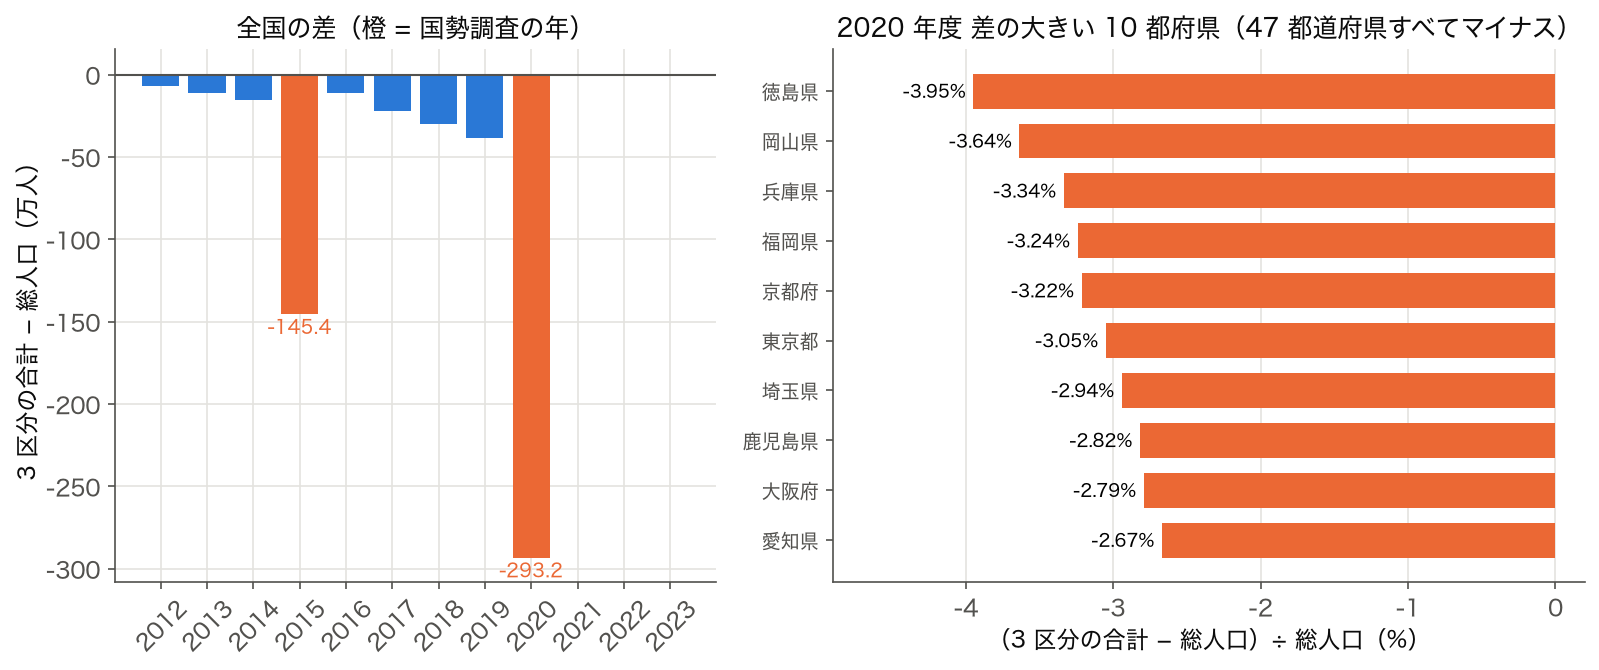
図の読み方: 左は全国の「3 区分の合計 − 総人口」で、橙の 2 本が国勢調査の年です。2016〜2019 年度の青い棒が年々深くなるのは、2015 年の国勢調査を基準に毎年の出生・死亡・移動を足し引きする推計で、年齢不詳の扱いの差が積み重なるためと考えられます(2020 年の国勢調査の後、2021 年度以降は年齢不詳を各年齢に割り振った値でほぼ一致)。右は 2020 年度に差の大きい 10 都府県で、徳島県 −3.95%・岡山県 −3.64%・兵庫県 −3.34% と、都市部に限らない県が上位に来ます。どの県でも差は −0.87%(和歌山県)以上あり、この年度の 3 区分から計算した「高齢化率 = 65 歳以上 ÷ 総人口」は、不詳の分だけ低めに出ます。高齢化率の年次推移を描くとき、2015・2020 年度だけ段差ができる原因の 1 つがこれです。
対処の選択肢: (a) 分母を総人口ではなく「3 区分の合計」(年齢が分かっている人)にする、(b) 年齢不詳を按分した公表値(不詳補完値)を別に取り寄せて統合する、(c) 国勢調査の年だけ注記する。どれを選んでも、統合した表を使う人に「どの定義の分母か」を伝えることが大事です。
🎯 このコードでやること:着工新設住宅戸数(H1800)と、その内訳として並んでいる持家(H1801)・貸家(H1802)・分譲住宅(H1803)の合計を年度ごと・全国で比べ、ずれの大きさ(戸数と %)と、ずれが 0 になる都道府県・年度の数を出す。
1 2 3 4 5 6 | h = df.groupby("SSDSE-B-2026")[["H1800", "H1801", "H1802", "H1803"]].sum() h["ずれ"] = h["H1800"] - h[["H1801", "H1802", "H1803"]].sum(axis=1) h["ずれ%"] = (h["ずれ"] / h["H1800"] * 100).round(2) print(h[["H1800", "ずれ", "ずれ%"]].to_string()) gap = df["H1800"] - df[["H1801", "H1802", "H1803"]].sum(axis=1) print("行ごと: ずれが負の行", (gap < 0).sum(), "/ 0 の行", (gap == 0).sum(), "/ 正の行", (gap > 0).sum()) |
💬 全国では毎年 5,118〜7,958 戸(総数の 0.53〜0.89%)だけ、3 列の合計が総数に届きません。564 行のうち 561 行でずれは正(内訳の合計が総数より小さい)、3 行が 0 で、負の行は 1 行もありません。「足りない」方向にしかずれないことから、丸めではなく、内訳に含まれていない区分があると分かります。建築着工統計の着工新設住宅は「持家・貸家・給与住宅・分譲住宅」の 4 区分で、SSDSE には給与住宅(社宅・公務員住宅など)の列が統合されていません。3 列から「持家率」を計算するときに、分母を 3 列の合計にするか総数にするかで値が 0.5〜0.9% 変わるのはこのためです。
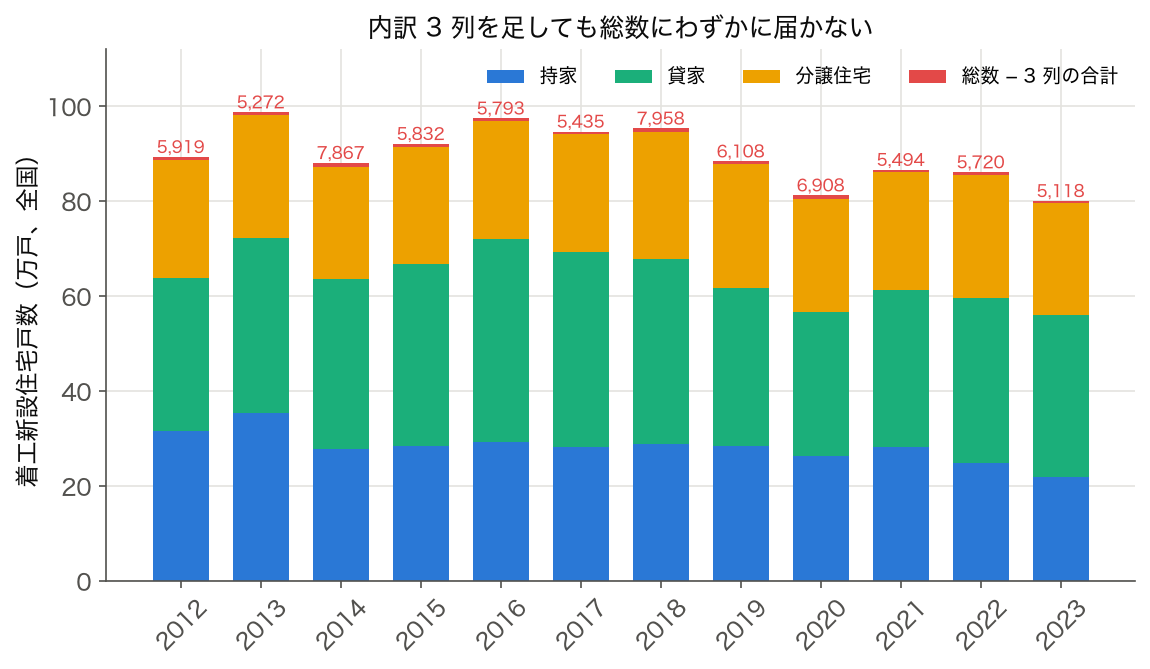
図の読み方: 青・緑・黄の 3 列を積んだ高さに、赤い薄い帯(総数との差)が毎年のっています。帯は 0.5〜0.9% と薄いので、積み上げ棒だけを見ていると「内訳の合計 = 総数」と思い込みがちです。棒の上の数字(差の戸数)は、持家・貸家・分譲の増減と関係なく 5,000〜8,000 戸前後で推移しており、別の区分(給与住宅)がほぼ一定の規模で存在することと整合します。統合した表で内訳の列を使うときは、この図のように「内訳の合計と総数の差」を一度描いておくと、列の定義の抜けに気づけます。
年齢不詳の影響を、実際によく作る指標で確かめておきます。上の住宅の例は「内訳に無い区分」でしたが、年齢 3 区分は「総数にだけ含まれる不詳」で、ずれは国勢調査の年に集中していました。高齢化率(65 歳以上 ÷ 総人口)は SSDSE で最もよく作られる比率の 1 つなので、分母に総人口を使うか、年齢の分かっている人の合計を使うかで、全国の時系列がどう変わるかを並べます。分子の 65 歳以上人口はどちらも同じで、変えるのは分母だけです。
🎯 このコードでやること:全国の高齢化率を 2018〜2022 年度について、分母を総人口(A1101)にした場合と、年齢 3 区分の合計(年齢が分かっている人)にした場合の 2 通りで計算し、前年度からの変化(ポイント)を並べる。
1 2 3 4 5 | s = df.groupby("SSDSE-B-2026")[["A1101", "A1301", "A1302", "A1303"]].sum().loc[2018:2022] s["総人口が分母"] = s["A1303"] / s["A1101"] * 100 s["3区分の合計が分母"] = s["A1303"] / s[["A1301", "A1302", "A1303"]].sum(axis=1) * 100 out = s[["総人口が分母", "3区分の合計が分母"]] print(pd.concat([out.round(2), out.diff().round(2).add_prefix("前年差_")], axis=1).to_string()) |
💬 総人口を分母にすると、全国の高齢化率は 2019 年度 28.36% → 2020 年度 28.01%(−0.34 ポイント)と下がり、2021 年度に 28.86%(+0.84 ポイント)と跳ね上がります。高齢化が 1 年だけ逆戻りしたように見えますが、これは 2020 年度の総人口に年齢不詳の 293.2 万人が含まれ、65 歳以上の人数だけがその分を含まないためです。年齢が分かっている人(3 区分の合計)を分母にすると、前年差は +0.31 → +0.24 → +0.18 → +0.15 ポイントとなめらかにつながり、2020 年度の段差は消えます。統合した表で時系列を描くときは、分母の定義しだいで前年差の符号まで変わる年度があると知っておき、内訳と総数の整合性(上の ⑥)を先に確かめます。
⑦ 基準の年がずれた表を結合すると — 分母の年度を 1 年取り違える
🎯 目的:人口の表と出生数の表を結合するとき、キーの「年度」の意味が 2 つの表でずれていることがあります(片方は 10 月 1 日現在の人口、もう片方は前年 1 年間の出生数、など)。キーの値が一致していても意味が 1 年ずれていれば、結合は成功して静かに誤差が入ります。年度のずれがどのくらいの誤差になるかを、分母の総人口を 1 年前のものに取り違えた場合で測ります。
🎯 このコードでやること:各年度の出生数を、同じ年度の総人口で割った出生率(千人あたり)と、1 年前の年度の総人口で割った出生率を 47 都道府県で計算し、ずれ(%)の中央値・範囲と、47 都道府県の順位がどれだけ変わるか(スピアマンの順位相関)を出す。
1 2 3 4 5 6 7 8 9 10 11 | from scipy.stats import spearmanr pop = df.pivot(index="Prefecture", columns="SSDSE-B-2026", values="A1101") birth = df.pivot(index="Prefecture", columns="SSDSE-B-2026", values="A4101") for y in [2013, 2020, 2023]: right = birth[y] / pop[y] * 1000 # 正しい組み合わせ lag = birth[y] / pop[y - 1] * 1000 # 分母を 1 年前にずらした組み合わせ err = (lag / right - 1) * 100 rho = spearmanr(right, lag).statistic print(f"{y}: ずれ 中央値 {err.median():+.2f}% (範囲 {err.min():+.2f}〜{err.max():+.2f}%), " f"順位相関 {rho:.4f}, 最大のずれ {err.abs().idxmax()}") |
💬 分母を 1 年前の総人口にすると、出生率は 2023 年度で中央値 −0.81%(範囲 −1.72〜+0.34%)ずれます。人口が減っている県では 1 年前の人口のほうが大きいので率が低めに出て、減り方の最も速い秋田県で −1.72%、2022→2023 年度に人口が増えた唯一の東京都だけが +0.34% です。47 都道府県の順位はほとんど変わらず(順位相関 0.998〜0.999)、ずれの幅も年を追って大きくなります(中央値 −0.47% → −0.64% → −0.81%)。順位の比較なら問題になりにくい一方、「出生率が前年より何 % 下がった」のような変化率を議論するときは、1% 前後の誤差は無視できない大きさです。結合キーの値が一致することと、その値の意味(基準時点)が一致することは別の確認事項です。
⑧ キーの「型」と「書式」をそろえる — 地域コード R13000 と 13 と "13"
🎯 目的:② の名寄せは都道府県「名」の表記ゆれでした。実務ではコードの形式違いのほうがよく起きます。SSDSE の地域コードは R13000 の形ですが、他の統計では都道府県番号が整数の 13、ゼロ埋めの文字列 "13"、5 桁の全国地方公共団体コード "13000" などで配られます。形式の違う 3 つの表を作り、そのまま結合すると何が起き、どう正規化すれば 47 件がそろうかを確かめます。
🎯 このコードでやること:2023 年度の 47 都道府県について、キーが整数の都道府県番号の表(出生数)と、ゼロ埋め文字列の都道府県番号の表(死亡数)を作り、①そのまま結合、②文字列どうしだが書式が違う結合、③共通の整数キーに正規化してからの結合、の 3 通りの結果を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | d = df[df["SSDSE-B-2026"] == 2023] a = pd.DataFrame({"pref_no": d["Code"].str[1:3].astype(int), "出生数": d["A4101"]}) # 整数 1〜47 b = pd.DataFrame({"pref_no": d["Code"].str[1:3], "死亡数": d["A4200"]}) # 文字列 "01"〜"47" c = pd.DataFrame({"pref_no": d["Code"].str[1:], "婚姻件数": d["A9101"]}) # 文字列 "01000"〜 try: a.merge(b, on="pref_no") # ① 整数と文字列 except ValueError as e: print("① 整数 × 文字列:", str(e)[:70], "…") print("② \"01\" × \"01000\":", len(b.merge(c, on="pref_no")), "行") # 型は同じ文字列でも書式が違う def norm(s): # どの形式でも 1〜47 の整数へ return s.astype(str).str.extract(r"(\d{1,2})")[0].astype(int) for t in (a, b, c): t["key"] = norm(t["pref_no"]) m = a.merge(b, on="key", validate="1:1").merge(c, on="key", validate="1:1") print("③ 正規化後:", len(m), "行, 死亡数の合計", f'{m["死亡数"].sum():,}') |
💬 ① 整数と文字列のキーは pandas が ValueError で止めてくれます。怖いのは ② で、型はどちらも文字列なのに書式が違う("01" と "01000")ため、例外は出ずに 0 行の結果が返ります。③ で「数字の先頭 1〜2 桁を取り出して整数にする」正規化をすると、3 表とも 47 行が 1 対 1 でそろい、死亡数の合計 1,575,084(2023 年度の 47 都道府県の合計)も失われません。コードの形式違いは、全国地方公共団体コードの 5 桁と 6 桁(末尾の検査数字の有無)、北海道が 1 か "01" か、などでも起こります。キーを正規化する関数を 1 か所に書いて、すべての表に同じ関数を通すのが安全です。
⑨ 「相手の表に無い行」は 0 か、不明か — 待機児童のいる県だけの表
🎯 目的:③ の外部結合では、相手の表に無い行が NaN になりました。その NaN を 0 で埋めてよいかどうかは、相手の表が「なぜその行を持っていないのか」で決まります。報告書などでは「待機児童のいる都道府県だけ」を一覧にすることがよくあります。2023 年度の保育所等利用待機児童数(J250502)から、そうした一覧を作って 47 都道府県の表に結合し、NaN の扱いで平均がどう変わるかを確かめます。
🎯 このコードでやること:2023 年度の待機児童数が 1 人以上の都道府県だけを載せた表を作って 47 都道府県の表に左外部結合し、①NaN を無視した平均、②NaN を 0 で埋めた平均、③元の表の平均を比べる。indicator=True で「相手に無かった行」も数える。
1 2 3 4 5 6 7 8 | d = df[df["SSDSE-B-2026"] == 2023][["Prefecture", "J250502"]] listed = d[d["J250502"] > 0].rename(columns={"J250502": "待機児童数"}) # 報告書の一覧を模す base = d[["Prefecture"]] m = base.merge(listed, on="Prefecture", how="left", indicator=True, validate="1:1") print("一覧に載っている県", len(listed), "/ 載っていない県", (m["_merge"] == "left_only").sum()) print(f'① NaN を無視した平均 {m["待機児童数"].mean():.2f} 人') print(f'② NaN を 0 で埋めた平均 {m["待機児童数"].fillna(0).mean():.2f} 人') print(f'③ 元の表の平均 {d["J250502"].mean():.2f} 人(合計 {d["J250502"].sum():,} 人)') |
💬 一覧に載っているのは 32 県で、残りの 15 県は結合すると NaN になります。pandas の mean() は NaN を黙って除くので、① は 32 県だけの平均 83.75 人になり、47 都道府県の本当の平均 57.02 人より 47% も大きく出ます。この一覧は「0 人の県は載せない」という作り方なので、NaN は 0 と同じ意味で、② のように 0 で埋めると元の表の値と一致します。一方、アンケートの未回答や集計対象外の県が一覧に無いのなら、NaN は「不明」で、0 で埋めると逆に平均を過小に見積もります。外部結合のあとで fillna(0) を書く前に、相手の表の作り方(どういう行が載らないのか)を必ず確かめます。
⑩ 「結合の前後で必ず見る 7 項目」を関数にする
🎯 目的:落とし穴の節の 7 項目(行数・キーの重複・キーの欠損・キーの重なり・結合後の行数・indicator の内訳・合計の保存)を毎回手で書くのは面倒で、急いでいるときほど省かれます。1 つの関数にまとめて、① の正しい結合と、⑤ の「地方の表に重複がある」結合に当ててみます。
🎯 このコードでやること:結合の前後で見る 7 項目を 1 回の呼び出しで出す関数 audit_merge を作り、(A) 2023 年度の人口表と死亡表の年度 + 県での内部結合、(B) 2023 年度の県の表と「中部が 2 行ある地方の表」の左外部結合、に当てて出力を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | def audit_merge(left, right, on, how="inner", sum_col=None): L, R = left[on].astype(str).agg("|".join, axis=1), right[on].astype(str).agg("|".join, axis=1) print(f" 1 行数: 左 {len(left)} / 右 {len(right)}") print(f" 2 キーの重複: 左 {L.duplicated().sum()} / 右 {R.duplicated().sum()}") print(f" 3 キーの欠損: 左 {left[on].isna().any(axis=1).sum()} / 右 {right[on].isna().any(axis=1).sum()}") print(f" 4 キーの重なり: {len(set(L) & set(R))} 種類(左 {L.nunique()} / 右 {R.nunique()})") m = left.merge(right, on=on, how=how, indicator=True) print(f" 5 結合後の行数: {len(m)}") print(f" 6 indicator: {m['_merge'].value_counts().to_dict()}") if sum_col: print(f" 7 {sum_col} の合計: 結合前 {left[sum_col].sum():,} → 結合後 {m[sum_col].sum():,}") return m.drop(columns="_merge") d = df[df["SSDSE-B-2026"] == 2023] pop = d[["SSDSE-B-2026", "Prefecture", "A1101"]] death = d[["SSDSE-B-2026", "Prefecture", "A4200"]] print("(A) 人口表 × 死亡表") _ = audit_merge(pop, death, on=["SSDSE-B-2026", "Prefecture"], sum_col="A1101") pref = d[["Prefecture", "Code", "A1101"]].copy() no = pref["Code"].str[1:3].astype(int) pref["地方"] = pd.cut(no, [0, 7, 14, 23, 30, 35, 39, 47], labels=["北海道・東北", "関東", "中部", "近畿", "中国", "四国", "九州・沖縄"]).astype(str) reg = pref.groupby("地方", as_index=False)["A1101"].sum().rename(columns={"A1101": "地方人口"}) reg_dup = pd.concat([reg, reg[reg["地方"] == "中部"]]) print("(B) 県の表 × 地方の表(中部が 2 行)") _ = audit_merge(pref, reg_dup, on=["地方"], how="left", sum_col="A1101") |
💬 (A) は 7 項目すべてが「期待どおり」を示します。左右とも 47 行・重複 0・欠損 0・キーの重なり 47 種類で、結合後も 47 行、indicator はすべて both、総人口の合計 124,353,000 も結合の前後で変わりません。(B) では 2 番の左の重複 40 は多対一の結合なので想定どおり(47 県が 7 地方に属する)で、問題は「右のキーの重複 1」です。これが最初の警報で、5 番の行数が 47 → 56、7 番の合計が 124,353,000 → 145,102,000 と、同じ事故が 3 か所に現れます。4 番のキーの重なりは 7 種類で正常に見えるので、重なりだけを見ていると重複には気づけません。項目を 1 つに絞らず 7 つまとめて見る意味がここにあります。
✏️ 理解度チェック(⑤〜⑩ の数字で)
- 関東の高齢化率を「7 都県の高齢化率の単純平均」で作ると 27.99%、「65 歳以上人口の合計 ÷ 総人口の合計」で作ると 26.17% になった。県の表に結合して「関東の平均より高い県」を数えるとき、どちらを使うかで何が変わるか。
答え: 単純平均(27.99%)を基準にすると 0 の線が 1.82 ポイント右にずれ、埼玉県(27.4%)のように合計比では「平均より高い」県が「平均より低い」に入れ替わる。基準の作り方を必ず明記する。 - 地方の表に重複行があるのに validate を付けずに結合した。何を見れば気づけたか。
答え: 結合前後の行数(47 → 56)と、主要な列の合計(総人口 1 億 2435 万 → 1 億 4510 万)。どちらも「結合の前後で必ず見る 7 項目」に入っている。 - 2020 年度の 3 区分から計算した高齢化率が、前後の年度と比べて段差のように見えた。統合した表のどこを確かめるべきか。
答え: 3 区分の合計と総人口の差。2020 年度は国勢調査の年齢不詳で全国 293.2 万人(県によって 0.87〜3.95%)足りず、分母を総人口にした高齢化率はその分だけ低めに出る。 - 「持家 + 貸家 + 分譲住宅」を分母にした持家率と、「着工新設住宅戸数(総数)」を分母にした持家率はどちらが大きいか。理由も述べよ。
答え: 3 列の合計を分母にした方が大きい。総数には SSDSE に列の無い給与住宅(全国で毎年 5,000〜8,000 戸)が含まれ、3 列の合計は総数より 0.5〜0.9% 小さいため。 - 地域コードを "01"〜"47" に直した表と、"01000"〜"47000" の表を結合したら 0 行になった。例外が出なかったのはなぜか。
答え: 2 つのキーの型はどちらも文字列で、pandas から見れば正当な結合だから。値の集合に重なりが無いだけなので、結合前に「キーの重なり」(⑩ の 4 番)を見るか、両方を同じ関数で正規化してから結合する。 - 待機児童のいる 32 県だけの一覧を 47 都道府県の表に結合し、mean() で平均を出したら 83.75 人になった。47 都道府県の平均として報告してよいか。
答え: よくない。15 県の NaN が除かれた 32 県の平均で、この一覧では NaN は 0 人を意味するので、0 で埋めた 57.02 人が正しい。NaN の意味(0 か不明か)を相手の表の作り方から判断する。 - ⑩ の audit_merge で、県の表 × 地方の表の「左のキーの重複」が 40 と出た。これは事故か。
答え: 事故ではない。47 県が 7 地方に属する多対一の結合なので、左の地方の列は 47 − 7 = 40 回重複するのが当然。事故の印は「右(1 側のはずの表)のキーの重複」と、結合後の行数・合計の変化のほう。どちらの表が「1」側かを先に決めておくと、重複の数字を正しく読める。 - 全国の高齢化率が 2020 年度に前年より 0.34 ポイント下がった。「高齢化が一時的に止まった」と書いてよいか。
答え: よくない。2020 年度の総人口には年齢不詳の 293.2 万人が含まれ、分母だけが大きくなっている。年齢の分かっている人を分母にすると前年差は +0.24 ポイントで、高齢化は続いている。
🎮 触って理解する — JOIN シミュレータ
上の①〜③で見た「結合タイプで行数が変わる」「表記ゆれで突合が全滅する」を、 実データ(SSDSE-B-2026・2023 年)の 8 都道府県で体感するシミュレータです。 左表は 8 県のマスター(人口表 A1101)、 右表は「人口の多い順に上位だけ観測できた」死亡表(A4200)。 図の右半分を上下にドラッグ(タッチ対応)すると観測範囲が変わり、 結合タイプ・表記ゆれ・名寄せを切り替えると、 結合結果の行数と欠損がリアルタイムに更新されます。
結合結果(リアルタイム更新)
※ 数値はすべて SSDSE-B-2026(2023 年)の実測値。 死亡率‰ = 死亡数 ÷ 総人口 × 1000(両方そろった行のみ計算可能)。
💡 シミュレータで確かめたい 3 つのこと
- 直感 — JOIN はキー集合のベン図:inner は左右キーの積集合(∩)、 full outer は和集合(∪)、 left は「左円の全体」。 結合タイプを切り替えると、 図の中で「残る行 / 欠損で埋まる行 / 消える行」が入れ替わるのが見えます(集合の言葉で整理すると迷いません)。
- 落とし穴 — 行は黙って消える・欠損は黙って増える:観測件数を減らして inner にすると、 警告なしに行数が減ります(③の再現)。 表記ゆれを ON にして名寄せ OFF のままだと一致 0 件(②の再現)— 見た目は同じ「東京」でも文字列が違えば別キーです。 名寄せ ON で全件回復する様子まで確かめてください。 なお本シミュレータはキーが両表で一意な例ですが、 キーが重複していると多対多結合で行が増殖する点は逆向きの事故です(誤解 2 参照)。
- 発展 — 実務への広げ方:正規化で揃わない揺れは対応表マスタ、 共通 ID がなければレコードリンケージ(類似度による確率的突合)へ。 大規模には SQL の JOIN や ETL パイプラインで自動化し、 粒度が違えば集約で揃え、 縦に積めばパネルデータになります。
🔍 具体例・ケーススタディ
ケース 1: 名寄せの難しさ(同一実体・別表記)
名寄せは「見た目が違うが同じもの」を同一キーに束ねる作業で、 実務で最も工数がかかります。 典型的なゆれ:
- 接尾辞のゆれ:「東京」「東京都」「Tokyo」/「株式会社ABC」「ABC(株)」「ABC Inc.」
- 全角・半角、 大文字・小文字:「ABC123」と「ABC123」/「Tokyo」と「tokyo」
- 旧字体・異体字・スペース:「髙橋」「高橋」/姓名間の空白の有無
- コード体系の違い:SSDSE の地域コード
R01000と、 総務省の団体コード、 郵便番号ベースなど参照系がバラバラ
対策の定石は「まず正規化ルール(トリム・全半角統一・接尾辞除去)でキーを揃える → それでも残る揺れはマスタ(対応表)で明示的に対応づける → 共通 ID が無い場合は氏名・住所の類似度で突き合わせるレコードリンケージ」という段階を踏むことです。 上の②のコードは、 この最初の「正規化」段階を最小構成で示したものです。
ケース 2: 内部結合と外部結合の使い分け
「顧客マスタ(全顧客)」と「今月の購入ログ(買った人だけ)」を統合するとします。
- 今月の売上を集計したい → 内部結合(買った人だけで十分)
- 全顧客の購入有無を知りたい(休眠顧客の把握) → 左外部結合。 マスタを軸に、 購入していない人は欠損として残す
③のコードが示す通り、 同じデータでも how 次第で 10 行にも 47 行にもなります。 「行数が意図通りか」を結合直後に必ず確認しましょう。
ケース 3: キーの粒度不一致
片方が「都道府県別」、 もう片方が「市区町村別」だと、 そのままでは結合できません(1 対多になる)。 粒度を揃えるには、 細かい側を集約して粗い側に合わせる(市区町村を都道府県で合計する)か、 粗い側を按分して細かくします。 統合の前に「両表のキーは同じ粒度か」を確認するのが鉄則です。
⚠️ よくある誤解・落とし穴
print(len(df)) し、 減っていたら「キーの表記ゆれ」か「相手にない行」を疑ってください。pd.merge(..., validate="one_to_one") や validate="one_to_many" で関係を宣言し、 違反したら例外を出させるのが安全です。13 と文字列の "13"、 全角の「13」と半角の「13」は、 人間には同じでも機械は別キー扱い。 結合前に str.strip()・型合わせ・全半角正規化でキーの正規化を必ず行います(②参照)。結合の前後で必ず見る 7 項目
結合の事故は、どれも「例外が出ないまま静かに間違う」のが厄介なところです。 裏を返せば、決まった数を毎回見るだけで大半は防げます。 結合を書いたら、次の 7 つをその場で出力する習慣をつけてください。
| いつ | 見るもの | おかしいと分かるサイン |
|---|---|---|
| 結合前 | 左右それぞれの行数 | 想定と違うなら、絞り込み条件が効きすぎている |
| 結合前 | キーの重複数 df[key].duplicated().sum() | 0 でないなら 1 対多。行数が増える覚悟が要る |
| 結合前 | キーの欠損数と型 | 欠損キーは結合されない。数値と文字列の混在も一致しない |
| 結合前 | キーの集合の重なり len(set(a) & set(b)) | 0 なら表記ゆれを疑う。結合しても空になるだけ |
| 結合後 | 結果の行数 | 増えたら 1 対多、減ったら不一致。どちらも理由を言えること |
| 結合後 | indicator=True の内訳 | left_only / right_only が想定外に多い |
| 結合後 | 主要な列の合計・平均 | 結合前と桁が変わっていたら、値が複製されている |
とくに 4 つめの「キーの集合の重なり」は、結合を書く前に一度だけ見ておく価値があります。
重なりが 0 でも merge は例外を出さず、列だけが揃った空の表を返します。
「なぜか結果が空になる」の原因は、ほとんどがここです。
全角と半角、前後の空白、都・道・府・県 の有無、
数値キーが片方だけ文字列になっている — 原因はいつも同じ顔ぶれです。
7 つめの「結合前後で合計を比べる」も強力です。
1 対多で値が複製されていれば合計は必ず増えますし、
不一致で行が落ちていれば必ず減ります。
合計が結合前と一致していれば、少なくとも行の増減で値は壊れていないと言えます。
たった 1 行の print で、この安心が手に入ります。
❓ FAQ
Q. 「JOIN」「merge」「結合」「マージ」は違うもの?
A. ほぼ同義です。 SQL では JOIN、 pandas では merge/join、 日本語では「結合」「マージ」と呼びますが、 いずれも「キーで表を横に突き合わせる」操作を指します。
Q. merge と concat はどう使い分ける?
A. 列を増やす(属性を足す)なら merge(=JOIN)、 行を増やす(同じ形の表を積む)なら concat(=UNION)。 「人口表に死亡列を足す」は merge、 「2012 年と 2023 年を積む」は concat です。
Q. どの結合タイプをデフォルトにすべき?
A. pandas の merge のデフォルトは how="inner" です。 ただし「母集団を減らしたくない」分析では、 基準となるマスタ側を left に置いた左外部結合の方が事故が少ないことが多いです。 いずれにせよ結合後の行数確認を習慣にしましょう。
Q. 共通の ID 列がありません。 どう統合する?
A. まず氏名・住所・都道府県など複数列を組み合わせてキーを作り、 正規化して突き合わせます。 それでも一意に決まらない場合は、 文字列の類似度(編集距離など)で確率的に対応づけるレコードリンケージを使います。
🗺 学習ロードマップ
- レベル 1 — 横結合(JOIN/merge)と縦結合(concat/UNION)の違いを理解する。
- レベル 2 — 内部結合・外部結合の 4 タイプと、 結合後の行数チェックを習慣化する。
- レベル 3 — キーの正規化・名寄せ(表記ゆれ・全半角・接尾辞)を実装する。
- レベル 4 — スキーマ統合(列名・単位・型・粒度の統一)とマスターデータ管理。
- レベル 5 — 共通 ID なしのレコードリンケージ、 ETL/データパイプラインでの統合の自動化。
データ統合を中心に、前後の工程と結合の 4 種類を 1 枚に置きます。 矢印は「これができてから次へ進む」順序です。
この 5 つは順番に意味があります。 ①②を飛ばして③へ行くと、結合そのものは成功したように見えて中身が空になります。 ④を飛ばすと、消えた行に気づかないまま分析が進みます。 ⑤は「毎回同じ結果になること」を保証する段階で、ここまで来て初めて統合が仕組みになります。
🔗 隣接手法への橋渡し
データ統合は分析パイプラインの中盤に位置します。 バラバラのソースを 1 枚の分析テーブルに束ねる工程です。
🌳 手法選択フロー — どの結合を選ぶか
迷ったら「分析の母集団はどちらの表か」から考えます。 結合の種類は好みではなく、答えたい問いで決まります。
- 両方に揃っている対象だけを分析したい?
→ inner。ただし何行落ちたかを必ず数える。 落ちた対象に偏りがあれば、それは選択バイアスになります。 - 左の表が母集団(例:全 47 都道府県)で、右は付加情報?
→ left。母集団の行数を保ったまま、付かなかったところは欠損で残す。 実務でいちばん多い形です。 - どちらが欠けているかを知りたい/突合検査をしたい?
→ outer +indicator=True。 left_only と right_only を数えるのが目的そのものになります。 - キーが重複している(1 対多・多対多)?
→ 結合の前に 集約して粒度を揃えるか、 結合後の行数が「左の行数 × 平均一致数」になることを承知のうえで進む。 多対多は原則として設計ミスを疑う。 - そもそもキーの表記が揃っていない?
→ 結合の前に 名寄せ。 揃える前に結合すると、一致 0 件でも例外は出ず、空の表が静かにできあがります。
どれを選んでも、結合の直後に必ず行数を出力する。 これだけで、統合工程の事故はほとんど水際で止まります。
なお本ページで使った 2 つの表は、どちらも 1 行が 1 つの都道府県に対応するという点で結合しやすい形でした。 実務では片方が「取引 1 件 1 行」「ログ 1 件 1 行」のように粒度が細かいことが多く、 そのままでは 1 対多になります。結合の設計とは、突き詰めれば粒度の設計です。 どの単位で 1 行にしたいのかを先に決めてから、そこへ向けて集約と結合を並べてください。