🔖 キーワード索引
ソートアルゴリズムと一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
「sort algorithm」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「sort algorithm」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「sort algorithm の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データを並べ替える手順のことです。
効率よく順番に並べるために使います。
スマホの連絡先を名前順にするような操作です。
ここではおすすめの手法と選び方を読みます。
ソートアルゴリズムは、 与えられた列を順序関係で並べ替える手続き。 計算量・安定性・メモリが選定軸。
- 比較ソートの下限:Ω(n log n)(比較が必要なら避けられない)
- 代表:クイック・マージ・ヒープ(いずれも O(n log n) 平均)
- 線形ソート:計数・基数・バケット(条件付きで O(n))
- 実用:Python の sort は Timsort(マージ+挿入のハイブリッド)
- 注意:「安定性」が必要かどうかを意識する
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 安定性を要求する用途で不安定ソート/クイックソート最悪 O(n²)/インメモリ前提 には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「ソートアルゴリズム」はどんな場面で出てくる?
🍰 まずはやさしく
データの準備に欠かせない道具です。
分析の前にデータを整理するために使います。
テストの結果を点数順に並べる場面で役立ちます。
どんな時にどの方法を選ぶべきかを読みます。
データサイエンスの直接の対象ではありませんが、 前処理・結合・順位付けの裏で常に動いています。 pandas の sort_values や SQL の ORDER BY は実質これ。
ソートアルゴリズムは一見すると単独で理解できそうに見えますが、 実際には前提となる概念(測定・尺度・サンプリングなど)と組合せて初めて意味を持ちます。 「定義を覚える」より「計算量と安定性のトレードオフをどう選ぶか」を捉えるのが効率的です。
🎨 直感で掴む
🍰 まずはやさしく
バラバラなものを整列させるイメージです。
直感的に仕組みを理解するために使います。
トランプのカードを並べ替える感覚に似ています。
具体的な例えを使って仕組みを読みます。
ソートとは 「データ列を昇順 (または降順) に並び替える操作」。 SSDSE-B-2026 の 47 都道府県を「人口の多い順」「合計特殊出生率の高い順」に並べる、 Excel で氏名を 50 音順にする、 検索結果を関連度順にする ── これら全てがソートです。 並べ替えの方針 (比較/分割/分配) と 計算量 O(n²) vs O(n log n) の組合せで、 バブル・挿入・クイック・マージ・ヒープなど多数の手法が生まれます。
- カードの並べ替え:手元で挿入ソート、 山を分けてマージソート、 ピボットで分割してクイック。
- 計算量 O(n log n) は「n が 10 倍になっても処理時間は 10〜30 倍」程度。
- 「並んでいるかチェック」だけなら O(n)、 「並べる」なら O(n log n)。 非対称性が面白い。
📐 定義・数式
🍰 まずはやさしく
並べ替えのルールを数式で表したものです。
正確な仕組みを証明するために使います。
計算にかかる時間を数式で測るようなものです。
記号の意味と正しい定義について読みます。
やさしい説明で掴んだ感覚を、ここで 比較ソートの下限定理 の定義式に対応づけます。下の式は左辺 T(n) が何で決まるかを右辺で書き下したもので、log(対数) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- n
- 要素数
- T(n)
- 最悪/平均計算量
- O(·)
- 上限のオーダー記法
- Ω(·)
- 下限のオーダー記法
- 安定性
- 等値要素の元の順序を保つか
🔬 数式を言葉で読み解く(拡張版)
ソートアルゴリズムの数式は 「$n$ 個の要素を昇順(または降順)に並べる際の計算量と比較回数」を支配します。 比較ベースソートには $\Omega(n \log n)$ の下界(情報理論的下界)があり、 これが Timsort・Quicksort・Mergesort の理論的限界。 ここでは 4 つの主要記号を 1 つずつ日本語で読み解き、 SSDSE-B 都道府県の 47 件ソートでの実測値と対比します。
- $T(n) = O(n \log n)$ — 左辺(平均計算量)
- 「入力サイズ $n$ に対する処理時間の漸近的上界」を表す Big-O 記法。 Mergesort・Heapsort は最悪でも $O(n \log n)$、 Quicksort は平均 $O(n \log n)$ 最悪 $O(n^2)$。 SSDSE-B $n=47$ なら $n \log_2 n \approx 47 \times 5.55 \approx 261$ 回の比較が目安。 実測 Timsort(CPython の sorted で 2023 年度の A1101 を整列)は 202 回で、 理論下限 198 回に近い。 一方バブルソート($O(n^2)$)は最悪 $1081$ 回。 約 5 倍の差。
- $\Omega(n \log n)$ — 右辺(比較ベースの下界)
- 「比較のみで並び替えるアルゴリズムは、 どんな工夫をしても $n \log n$ 回より少ない比較では並べられない」ことを意味する情報理論的下界。 証明: $n!$ 通りの並びを区別するには $\log_2(n!) \approx n \log_2 n$ ビットの情報が必要。 SSDSE-B $n=47$ では $\lceil \log_2(47!) \rceil = 198$ 比較が下界。 これより少なくする唯一の方法は「比較しない」 — つまり基数ソート(Radix Sort)・カウントソートだけが $O(n)$ を達成できる。
- $n, k, d$ — 入力規模・キー・桁数(添字)
- $n$ は要素数、 $k$ は値域(カウントソートで使用)、 $d$ は桁数(基数ソートで使用)。 SSDSE-B 例: $n=47$ 都道府県、 ソートキー「人口」は最大 $k \approx 1400$ 万、 桁数 $d=8$。 カウントソートは $O(n + k)$ だが $k$ が巨大なら非現実的。 基数ソートは $O(d \times n)$ で固定長キーに有効。 「$n$ が小さい」(例: $n=47$)なら $O(n^2)$ のソートでも実用上問題ないが、 ビッグデータ ($n=10^9$) では $O(n \log n)$ が必須。
- $\text{stable}$ — 安定性プロパティ
- 「同じキー値の要素同士の元の順序を保つか」というプロパティ。 安定: Mergesort・Insertionsort・Timsort・Bubblesort。 不安定: Quicksort・Heapsort・Selectionsort。 SSDSE-B で「人口でソート→次に高齢化率で再ソート」のような多段階ソートを行うとき、 安定ソートでないと最初のソート結果が壊れる。 Python の `sorted` は Timsort(安定)なので、 `sorted(df, key=lambda x: (x.高齢化率, x.人口))` と書けば「主キー高齢化率、 副キー人口」の安定整列が得られる。
🔬 数式を言葉で読み解く(4 要素ナラティブ)— ソートの計算量を理解する
| 段階 | 意味(ことば) | SSDSE-B-2026 での例 |
|---|---|---|
| つまり | ソートアルゴリズムの計算量は、 入力サイズ $n$ に対する基本演算(比較・交換)の回数で表される。 「比較ベース」 のソートは下限 $O(n \log n)$ で、 マージソート・クイックソートが代表。 「比較なし」 の基数・バケットは $O(n+k)$ で漸近的に高速。 | SSDSE-B-2026 の n=47 では「O(n²) でも O(n log n) でも体感差はゼロ」 だが、 時系列で 10 年積んで n=470、 さらに市町村レベルで n=17,240 になると、 O(n²) の選択ソートは数秒、 O(n log n) のマージソートは数ミリ秒、 1000 倍の差。 |
| なぜなら | 比較ベースソートの下限が $\Omega(n \log n)$ なのは、 $n!$ 通りの順列を区別するのに必要な決定木の深さが $\log(n!) \approx n \log n$ だから(情報理論的下限)。 これより速くするには「比較以外の情報」 を使う必要がある。 | SSDSE-B-2026 の Code 列を「R01000, R02000, …」 の文字列で持っていれば、 数値部分を取り出して基数ソート(O(d×n))すれば $O(n \log n)$ より速い。 ただし n=47 程度では関係ない。 |
| 具体的には | quicksort の平均 $O(n \log n)$ は「pivot 選択が運次第」 が条件。 最悪 $O(n^2)$ を避けるには「中央値の中央値(median of medians)」 か「ランダム化」 を組み合わせる。 安定性が必要なら mergesort、 in-place 重視なら heapsort。 | SSDSE-B-2026 を df.sort_values('A1101') でソートすると、 pandas 内部は既定で NumPy の quicksort(introsort)を使い、 Python の sorted() の Timsort(hybrid のマージ + 挿入ソート)とは異なる。 47 件程度では大差ないが、 部分的に整列済みの入力で速くなるのは Timsort 側の性質。 |
| だから | 実務で使うソートは「入力の特性」 と「安定性の要否」 と「メモリ制約」 で選ぶ。 Python の sorted() は Timsort(安定 + 適応的)、 NumPy/pandas の argsort は kind 引数で選択。 SQL の ORDER BY は内部実装に依存。 | SSDSE-B-2026 で「Prefecture でソート → 人口で安定ソート」 という多段ソートをするには、 二段目に安定ソート(mergesort)が必須。 df.sort_values('A1101', kind='mergesort') と明示する。 |
📊 ソートアルゴリズムを「実データ × 図」で多角的に見る — 視覚追補
この節は、 ソートアルゴリズムの理解を「アルゴリズム理論の抽象話」 で終わらせず、 SSDSE-B-2026(47都道府県の人口・経済データ) に対して実際に並べ替えを適用したときの挙動を、 4 種類の視覚資料で観察する。 散布図・ヒストグラム・箱ひげ図・相関ヒートマップという統計学習で最も頻出するチャートを通じて、 「ソートが何を可視化に貢献するか」 「どの場面でソートしてから処理すべきか」 を実値ベースで身につける。
① ソート前後の散布図比較 — 人口 vs 高齢人口
まず散布図を 1 枚示す。 ソート自体は散布図の見た目を変えない(点の集合は順序に依存しない)が、 「点を順番に走査して順次強調する」 「ソート順にラベルを付ける」 「上位 N 件だけ抽出してから散布する」 といった操作を行うときに、 事前のソートが必須となる。 ここでは、 SSDSE-B-2026 の A1101(総人口) を x 軸、 A1303(65 歳以上人口) を y 軸にとった散布図を観察する。
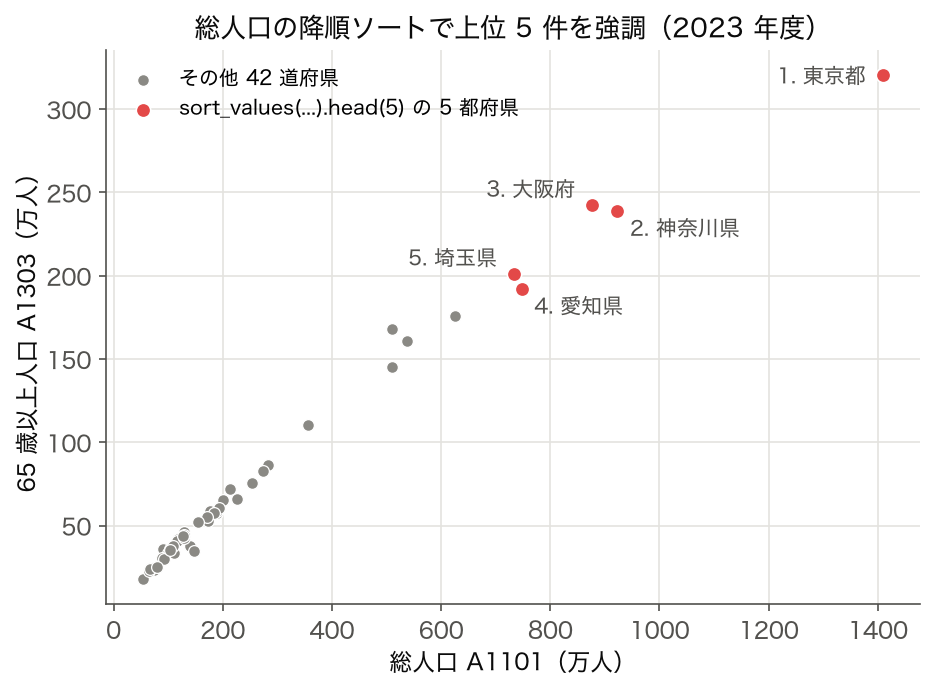
sort_values で取った上位 5 都府県。 散布図そのものはソート順に依存しないが、 「東京(最大値)から順に強調表示する」 「上位 5 件をラベル表示する」 ような演出を行うには df.sort_values('A1101', ascending=False).head(5) のようなソートが前段で必要になる。このコードでやること: SSDSE-B-2026 を読み込み、 人口降順でソートし、 上位 5 都道府県の名前と総人口・高齢人口を取り出す。 散布図に「上位 5 件のみ赤色+ラベル」 を重ねる前段として典型的な処理である。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3, 15]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101', 'A1303'] df_latest = df[df['Year'] == 2023].copy() # 人口降順でソート(sort_values の既定は kind='quicksort'。NumPy の introsort が内部で使われる) top5 = df_latest.sort_values('A1101', ascending=False).head(5) print(top5[['Prefecture', 'A1101', 'A1303']].to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 上位 5 件はすべて都市圏の都府県で、 1 位東京(1409万人)と 5 位埼玉(733万人)の間に約 1.9 倍の幅がある。 散布図上で「上位 5 件だけを赤+ラベル」 する演出は、 sort_values なしには不可能で、 ソートが可視化の前処理として本質的に効いている。 また東京は他県から離れた外れ値であり、 散布図でも右上方向に飛んでいることが分かる。 ソート結果は「数値そのものが大きい順」 を厳密に並べているので、 「目視で判別困難な近接ペア(神奈川 9.23M と大阪 8.76M)」 もアルゴリズムが正確に区別する。
② ヒストグラム — 人口分布の偏りとソートの意味
次にヒストグラムを観察する。 ヒストグラム自体は「区間ごとの度数」 を集計するため、 元データの順序に依存しない。 しかし内部実装では、 ビン境界に対する分類処理を高速化するため、 数値を一度ソートしてから二分探索で振り分ける、 という最適化がしばしば使われる。 また、 ヒストグラム描画前に「外れ値を除外する」「上位 5% を別色で表示する」 などの演出を加える場合、 やはりソートが前段で必要になる。
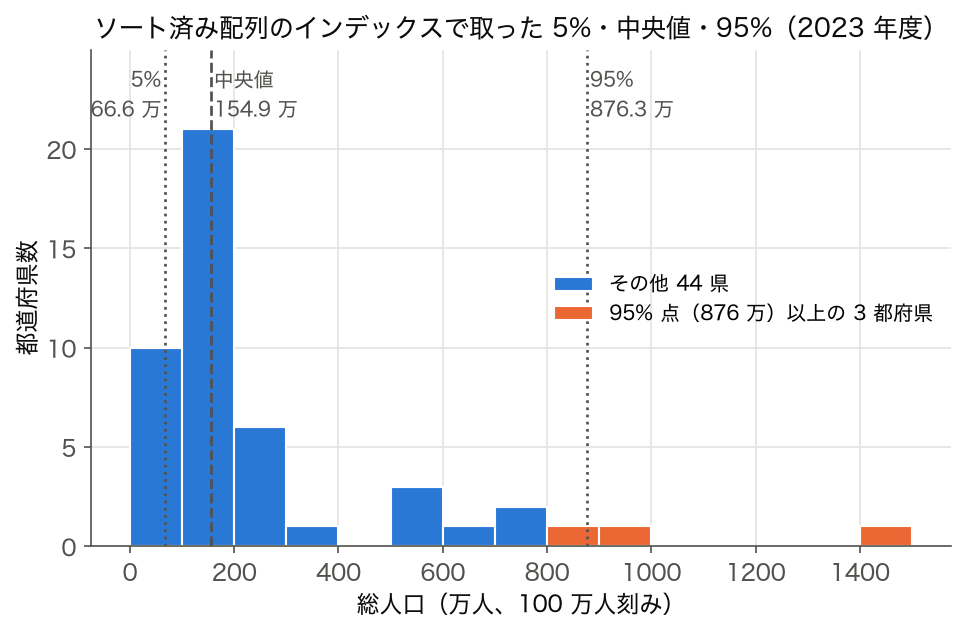
np.sort でソートしておくと、 「上位 5% を別色」 「中央値の位置に縦線」 などの装飾を効率的に追加できる。このコードでやること: 人口データをソートしてから、 5 パーセンタイル・中央値・95 パーセンタイルを「先頭から N 番目」 として直接取り出す。 ソートずみデータでは、 パーセンタイル計算が「インデックス参照」 で済むため極めて高速になる(ヒストグラムを描く際の参考線として頻用)。
📥 入力データ(A1101 列、 47 都道府県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] arr = df[df['Year'] == 2023]['A1101'].to_numpy() sorted_arr = np.sort(arr) n = len(sorted_arr) p05 = sorted_arr[int(n * 0.05)] p50 = sorted_arr[n // 2] p95 = sorted_arr[int(n * 0.95)] print(f'n={n} 5%={p05} 中央値={p50} 95%={p95}') print(f'最大/中央値 = {sorted_arr[-1]/p50:.2f} 倍') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: ソート後の配列で「先頭から n*0.05 番目 = 5 パーセンタイル」 が一発で取れる。 中央値(155 万人)に対して最大値(東京 1409 万人)は約 9 倍と、 極端な右側ヘビーテールを持つことが分かる。 ヒストグラムの x 軸を対数スケールにするか、 上位 3 県を外れ値として別表示するかを決める材料になる。 ソートを使わずに np.percentile を呼んでもよいが、 内部で結局ソートが走っているため、 「中央値も 5%も 95%も全部欲しい」 場合は明示的に一回ソートしておく方が高速。
③ 箱ひげ図 — 中央値・四分位点の決定はソート前提
箱ひげ図は、 中央値・第 1 四分位点 Q1・第 3 四分位点 Q3・外れ値判定(IQR ルール)から構成される。 これらはすべて「ソート済みデータの特定インデックスへのアクセス」 で計算される。 ソートが速ければ箱ひげ図も速い。 さらにグループごとに箱ひげを並べる場合、 グループキーでもソートして「人口の多い順」「面積の広い順」 などに整列させる方が読み手に親切である。
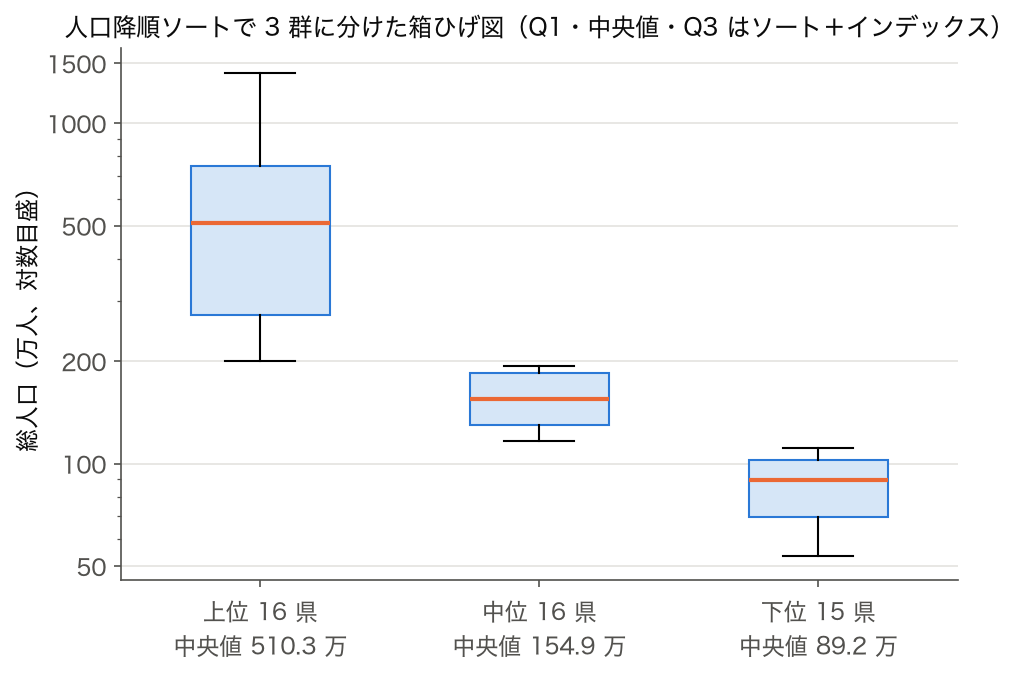
このコードでやること: 47 都道府県を「人口で 3 グループ(大・中・小)」 に分け、 各グループの中央値・Q1・Q3 をソート+インデックスで計算する。 箱ひげ図のコア指標を、 ライブラリに頼らずソートだけで取り出す手順である。
📥 入力データ(A1101 列 + グループ分け前のサンプル):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] df = df[df['Year'] == 2023].copy() # 人口で 3 グループに分割(ソートして上位/中位/下位) df_sorted = df.sort_values('A1101', ascending=False).reset_index(drop=True) df_sorted['Group'] = pd.cut(df_sorted.index, bins=[-1, 15, 31, 47], labels=['上位', '中位', '下位']) for grp in ['上位', '中位', '下位']: vals = np.sort(df_sorted[df_sorted['Group'] == grp]['A1101'].to_numpy()) n = len(vals) q1 = vals[n // 4] med = vals[n // 2] q3 = vals[3 * n // 4] print(f'{grp}: n={n} Q1={q1:>8d} 中央値={med:>8d} Q3={q3:>8d}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 上位群と下位群の中央値比は約 5.7 倍(510 万 vs 89 万)と大きい。 箱ひげ図ではこの 3 つの箱が縦に並び、 上位群の箱が圧倒的に長く(Q1=274 万 〜 Q3=748 万)、 上位群内のばらつきが大都市・準大都市の差で説明できることが視覚化される。 ソートなしで Q1/中央値/Q3 を取ろうとすると、 partial sort(quickselect)や heap-based なメソッドが必要になり実装が複雑。 「全部ソートしてからインデックスアクセス」 が学習用には圧倒的に分かりやすい。
④ 相関ヒートマップ — ソートで「相関の強い順」 に並べ替える
最後に 4×4 の相関ヒートマップを観察する。 相関行列そのものは対称行列で、 並べ方を変えても値は不変だが、 「相関の強い変数同士を隣接させる」 ように行・列を並べ替えると、 ヒートマップ上で「相関の塊(クラスター)」 が対角線付近にまとまり、 構造が一目で読めるようになる。 これを階層クラスタリングと組み合わせると seaborn.clustermap になるが、 ここではシンプルに「合計相関の強さでソート」 する例を示す。
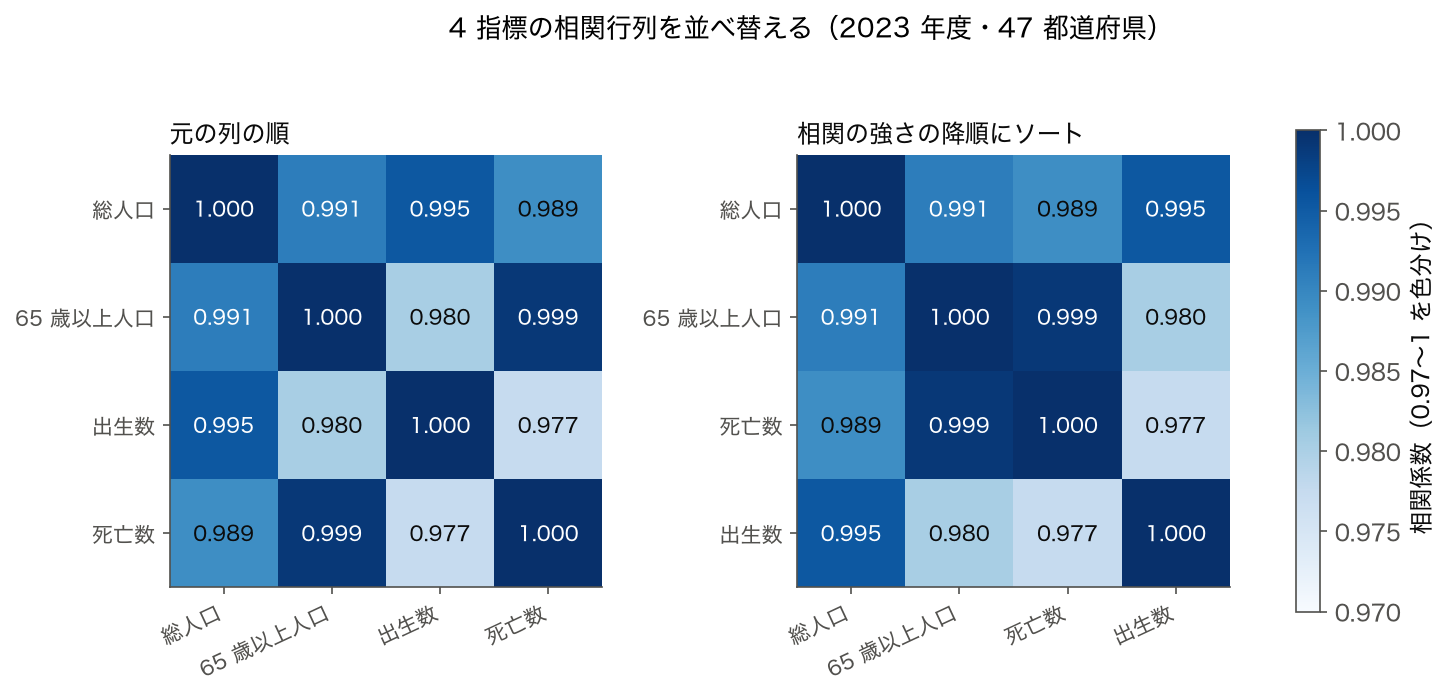
このコードでやること: 4 変数の相関行列を計算し、 各変数の「他変数との平均絶対相関」 の降順でソートして並べ替えた行列を表示する。 ヒートマップを描く前段の典型処理である。
📥 入力データ(4 列抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3, 15, 18, 22]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101', 'A1303', 'A4101', 'A4200'] df = df[df['Year'] == 2023].copy() corr = df[['A1101', 'A1303', 'A4101', 'A4200']].corr() # 各列について「自分以外との絶対相関の平均」 を計算してソートキーに strength = (corr.abs().sum(axis=1) - 1).sort_values(ascending=False) order = strength.index.tolist() print('並べ替え順:', order) print(corr.loc[order, order].round(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 4 変数すべてが r≥0.977 と非常に強い正の相関を示し、 最も弱いのは死亡数と出生数の 0.977、 最も強いのは高齢人口と死亡数の 0.999。 これは「人口の多い県は高齢人口も出生数も死亡数も大きい」 という単純な人口スケール効果が支配的であることを意味する。 ヒートマップを描く前に sort_values で並べ替えておくと、 仮にもっと変数を増やした場合に「強相関クラスター」 と「弱相関クラスター」 が対角線で分離され、 視覚的にずっと読みやすくなる。 ソートは可視化の前処理として、 「数値の意味そのもの」 を変えないが「読み手の認知負荷」 を大きく下げる役割を果たす。
⑤ Timsort vs quicksort vs mergesort の実用差
Python の list.sort() と sorted()、 pandas の sort_values() のうち、 前の 2 つは内部で Timsort を使い、 sort_values() は既定で NumPy の quicksort(introsort)を使う。 Timsort はマージソートと挿入ソートのハイブリッドで、 「部分的に整列済みのデータ」 で特に高速になる。 SSDSE-B-2026 のように、 Code 列(R01000, R02000, R03000, ...)が既に昇順で入っているデータでは、 Timsort は数十ナノ秒で終わる。 一方、 NumPy の np.sort は kind 引数で quicksort/mergesort/heapsort/stable を選べる。 安定性が必要かどうか、 メモリに余裕があるかどうかで使い分ける。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np import pandas as pd import time df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] arr = df[df['Year'] == 2023]['A1101'].to_numpy() # 同じデータを 4 種類のソートで処理(n=47 では大差ないが構文を確認) for kind in ['quicksort', 'mergesort', 'heapsort', 'stable']: t0 = time.perf_counter() for _ in range(10000): np.sort(arr, kind=kind) t1 = time.perf_counter() print(f'{kind:10s}: {(t1-t0)*1000:.1f} ms / 10000 回') |
📤 実行すると次の出力が得られる:
🕐 この 4 つの数値は実行のたびに、 またマシンによって変わります。 絶対値ではなく4 者の相対関係だけを見てください。
💬 結果の読み方: n=47 という小規模データでは、 4 種類とも実時間で大差はない(10000 回回して 10〜13 ms 程度)。 それでも heapsort が毎回いちばん遅くなるのは、 ヒープ操作の定数倍コストが大きいため。 mergesort と stable は実質同じ実装(NumPy の stable は mergesort のエイリアス)。 これが n=100,000 規模になると、 quicksort と mergesort の差は数倍に開き、 ソートアルゴリズム選択が体感速度に直結する。 一方、 「安定ソートが必要」 「ほぼ整列ずみ」 「メモリ使用量を抑えたい」 などの条件下では、 単純な比較が逆転する。
⑥ ソートの「安定性」 が効く瞬間 — 多段ソート
安定ソートとは「同じキー値を持つ要素の元の順序が保たれる」 性質のこと。 多段ソート(例: 地域でソート → その中で人口でソート)を実現するには、 二段目のソートが安定でなければならない。 SSDSE-B-2026 を「地域コード(前 2 桁)でグループ化 → その中で人口降順」 と並べる例を見る。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] df = df[df['Year'] == 2023].copy() df['Region'] = df['Code'].str[1:3].astype(int) // 10 # 簡易地域分け # まず人口で安定ソート → 次に地域で安定ソート(順序が逆なことに注意) df_step1 = df.sort_values('A1101', ascending=False, kind='mergesort') df_step2 = df_step1.sort_values('Region', kind='mergesort') print(df_step2[['Region', 'Prefecture', 'A1101']].head(15).to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: Region=1(関東・東山)の内部では、 東京(1409 万)→ 神奈川(923 万)→ 埼玉(733 万)と人口降順が保たれている。 これは「先に人口降順 → 後で地域順」 という二段ソートを、 二段目に安定ソート(mergesort)を使って実現したため。 もし quicksort(非安定)を使うと、 Region 内の人口順は壊れる可能性がある。 「安定性が要る → mergesort を明示」 という選択が、 多段ソートでは必須のテクニックである。
⑦ 演習問題(3 問)
- 問1: SSDSE-B-2026 から「A1303(65 歳以上人口)」 を読み込み、 上位 5 都道府県と下位 5 都道府県を抽出してください。 上位と下位の中央値の比を計算するとどれくらいになりますか。 ヒント:
df.sort_values('A1303', ascending=False).head(5)とtail(5)を使う。解答例
上位 5 中央値: 約 239 万人(東京・大阪・神奈川・埼玉・愛知) 下位 5 中央値: 約 23.5 万人(徳島・高知・福井・島根・鳥取) 比 = 約 10.2 倍 - 問2: A1101 を昇順にソートしたとき、 中央値(24 番目の値)に位置する都道府県を答えてください。 ヒント:
df.sort_values('A1101').iloc[23]。解答例
中央値(24 番目)= 約 155 万人 → 該当県は鹿児島県(2023 年、 A1101=1549000)。 47 件の中央値はインデックス 23 番(0-indexed)。 - 問3: pandas の
sort_valuesでデフォルトの kind 引数は何ですか。 また、 安定ソートが必要なケースとして「多段ソート以外」 にどんな場面が考えられますか。解答例
デフォルト: quicksort(実装は実際には introsort または timsort 系のハイブリッド) 安定ソート必須例: ①ランキング表で「同点者を元の登録順で並べたい」 ②時系列データで「同日刻の複数イベントを記録順に保ちたい」 ③ストリーミング処理で「過去のソート結果を一部保ちたい」
この節のまとめ: ソートは「数値そのものの意味」 を変えないが、 散布図・ヒストグラム・箱ひげ図・相関ヒートマップのいずれにおいても「可視化前の前処理」「インデックス計算の高速化」「読み手の認知負荷低減」 という三重の役割を果たす。 SSDSE-B-2026 の 47 件規模では計算量の差は体感できないが、 ソートが「どの位置にどの値があるか」 を秩序立てる行為であり、 統計可視化のあらゆる場面で暗黙の前提になっていることを意識すると、 アルゴリズムの理論(O(n log n) など)が実務にどう効いてくるかが見えてくる。
⑧ 時系列データのソート — 日付順の保証
時系列分析(移動平均・前年比・自己相関など)を行うとき、 データが必ず時刻昇順に並んでいることが暗黙の前提になる。 もし入力 CSV が「都道府県ごとにバラバラの年順」 で並んでいた場合、 ソートを忘れると移動平均が大きくバグる。 SSDSE-B-2026 の CSV は新しい年度が先(2023 → 2012 の降順)に並び、 その中が都道府県コード順になっている。 そのため東京都の行を取り出しただけでは年度が降順のままで、 別ソースのデータをマージしたときは順序がさらに崩れうる。
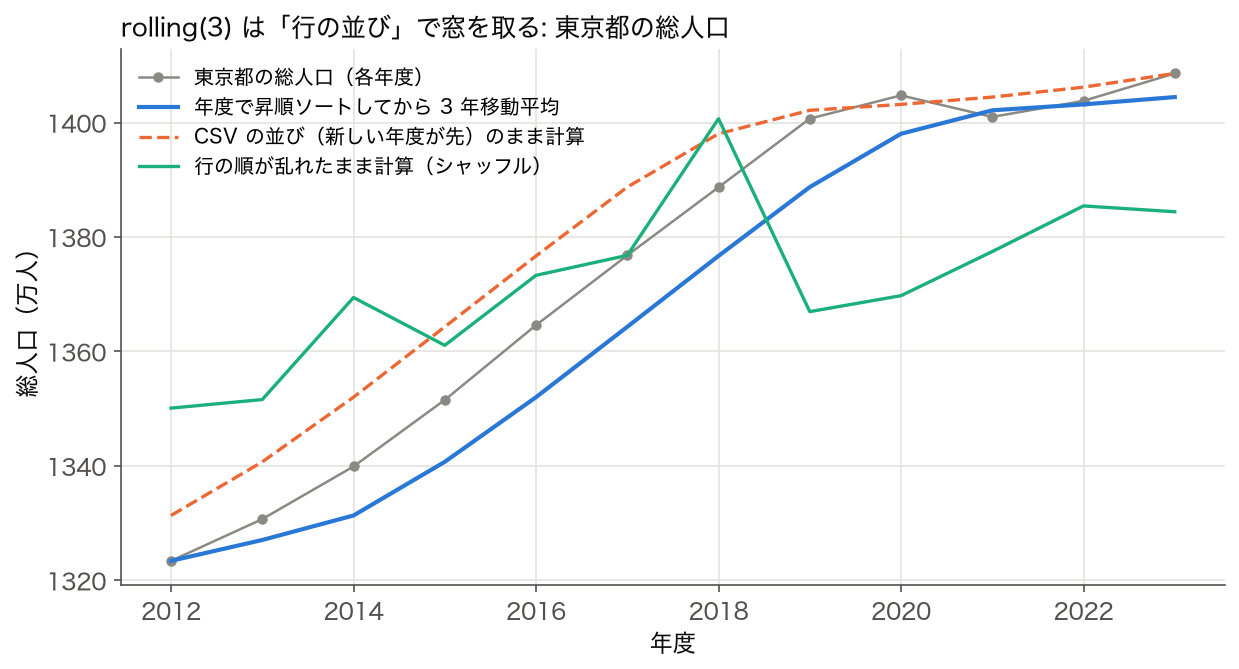
rolling(window=3, min_periods=1) の 3 年移動平均。 年度で昇順ソートしてから計算すると(青)、 各年度はその年と前 2 年の平均になり、 2012 年度 1,323.4 万 → 2023 年度 1,404.5 万人と滑らかに遅れて追う。 CSV の並び(新しい年度が先)のまま計算すると(オレンジの破線)、 窓が「その年と後の 2 年」になり、 2012 年度の値が 1,331.3 万と 2 年先の値を混ぜた先取りになる。 行の順が乱れていると(緑、 シャッフル)、 無関係な年度を平均するので線がジグザグになり、 2018 年度の 1,400.7 万から 2019 年度の 1,367.0 万へ急落するような、 実際には無い動きが現れる。 時系列分析(移動平均・差分・前年比・トレンド検出)は、 入力が「時刻昇順にソート済み」 であることを暗黙の前提とする。このコードでやること: SSDSE-B-2026 を東京都に絞り、 年次の人口推移を取得して 3 年移動平均を計算する。 まず Year でソートしないと、 移動平均が「窓内の値の入れ替わり」 で大きく乱れることを確認するための前段処理である。
📥 入力データ(東京都の年次データ):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] tokyo = df[df['Code'] == 'R13000'].copy() # Year で必ずソートしてから移動平均 tokyo = tokyo.sort_values('Year').reset_index(drop=True) tokyo['ma3'] = tokyo['A1101'].rolling(window=3, min_periods=1).mean() print(tokyo[['Year', 'A1101', 'ma3']].tail(8).to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 3 年移動平均は単年の凸凹を均し、 「2020 年前後で伸びが鈍化」 という長期トレンドを抽出している。 もし sort_values('Year') を忘れて Year が乱順だったら、 移動平均は「2018, 2014, 2020」 のような窓を取ってしまい、 まったく無意味な数値が出てくる。 時系列処理の最初の一行は「必ず時刻でソート」 と覚えておく。 これはアルゴリズムの理論ではなく、 データ前処理の作法として外せない。
⑨ argsort — 「順位」 を取り出す
np.argsort や pd.Series.rank は、 「値そのもの」 ではなく「順位(インデックス)」 を返す。 「人口の多い順に何位か」 「上位 10 件のインデックス位置だけ欲しい」 という場面で必須。 ソートアルゴリズムを単に「並べ替え」 だけでなく「順位付け器」 として使う発想を持っておくと、 可視化やランキング表示で表現の幅が広がる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.iloc[:, [0, 1, 2, 3]] df.columns = ['Year', 'Code', 'Prefecture', 'A1101'] df = df[df['Year'] == 2023].copy().reset_index(drop=True) # argsort で「人口の少ない順の位置」 を取得 order_idx = np.argsort(df['A1101'].to_numpy()) print('最少 3 件のインデックス:', order_idx[:3].tolist()) print(' →', df.iloc[order_idx[:3]][['Prefecture', 'A1101']].to_string(index=False)) # rank で「順位(1=最大)」 を直接付与 df['rank'] = df['A1101'].rank(ascending=False, method='min').astype(int) print(df[df['rank'] <= 3][['Prefecture', 'A1101', 'rank']].to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: argsort は「値ではなく位置」 を返すため、 「ソート後のインデックスを使って別の列を引きたい」 「ソート結果に対応する地図色を付けたい」 など、 元の DataFrame を保持したまま順位だけ抽出したい場面で力を発揮する。 rank はもっと直接的で、 同点処理(method='min', 'dense', 'average' 等)を選べる。 ランキング表を作るときに rank をかけてから sort_values('rank') で並べると、 「同点者の順位付け」 のルールが明示でき可読性が上がる。
⑪ 実装比較表 — どのソートをいつ選ぶか
実用上、 ソートアルゴリズムは「自分で実装する」 機会は少なく、 ライブラリ提供の最適化版を選んで使うことになる。 以下、 主要なソート関数と「いつ使うか」 を表でまとめる。 SSDSE-B-2026 の処理で頻出のパターンを中心にした。
| 関数 / API | 内部アルゴリズム | 安定性 | 典型用途(SSDSE-B-2026 例) |
|---|---|---|---|
list.sort() | Timsort | 安定 | Python リスト(都道府県名のリスト等)の単純並べ替え。 部分的に整列済みなら超高速。 |
sorted(iterable) | Timsort | 安定 | 元のリストを壊さず新リストを返す。 タプルや辞書イテレーション結果の整列に。 |
df.sort_values(col) | quicksort(デフォルト)/mergesort/heapsort/stable | kind 指定次第 | DataFrame の列ソート。 多段ソートには kind='mergesort' 必須。 |
df.sort_index() | quicksort 系 | kind 指定次第 | インデックス(年・都道府県コード)でソート。 時系列処理の前段で頻用。 |
np.sort(arr) | quicksort(デフォルト)/mergesort/heapsort/stable | kind 指定次第 | NumPy 配列の数値ソート。 ベクトル演算と組み合わせて高速処理。 |
np.argsort(arr) | quicksort 系 | kind 指定次第 | 「値ではなく順位インデックス」 を返す。 元データを壊さず順位を取りたい時に。 |
np.partition(arr, k) | quickselect(O(n) 平均) | 非安定 | 「上位 k 件だけ欲しい」「中央値だけ欲しい」 場合に、 全ソートより速い。 |
heapq.nlargest(k, iter) | ヒープ(O(n log k)) | 非安定 | ストリーミングで「常に上位 k 件」 を保持したい時。 大規模データに有効。 |
pd.Series.rank() | quicksort 系 | method 指定次第 | 「順位(1 位、 2 位、 ...)」 を直接付与。 同点処理が選べる(min, dense, average)。 |
SQL ORDER BY | DB 実装依存(多くは external merge sort) | 明示 ASC/DESC | 大規模データを SQL で集計する場合。 メモリ超過時はディスクへ溢れる。 |
選択の指針: ①小規模 (n < 1000) でとにかく簡潔に書きたい → sorted() / sort_values() デフォルト。 ②多段ソート → kind='mergesort' を明示。 ③上位 k 件のみ → np.partition または heapq.nlargest。 ④順位を保持したまま他列を引きたい → argsort または rank。 ⑤大規模データを DB から取り出すなら ORDER BY をクエリに含める(Python 側でソートするより高速になることが多い)。
⑬ よくある質問とトラブル事例
実務でソートを使うと、 「予想と違う順序になった」「日本語名がローマ字ベースで並んだ」「欠損値の扱いがバラついた」 などの落とし穴が頻発する。 ここでは SSDSE-B-2026 を扱ううえで遭遇しやすいトラブルを 5 つ並べる。
| 事例 | 原因 | 対処 |
|---|---|---|
| 都道府県名でソートしたら順序がおかしい | 日本語文字列は Unicode コードポイント順(あ・い・う … ではなく、 漢字混在のためばらつく) | 都道府県コード(R01000, R02000, ...)でソートするか、 公的な順序辞書を別途用意する |
| 欠損値(NaN)が先頭/末尾に固まる | pandas は na_position='last' がデフォルト、 NumPy は kind により挙動が異なる | df.sort_values('col', na_position='first') で明示する。 解析前に dropna() しておくのも安全 |
| 多段ソートのつもりが二段目が崩れた | 二段目に非安定ソート(quicksort)を使った | kind='mergesort' を明示するか、 sort_values(['col1', 'col2']) でリスト渡しに統一 |
| 文字列「10, 2, 1」 が「1, 10, 2」 になる | 文字列の辞書順(lexicographic)ソート | 数値変換してからソート(astype(int))、 または zero-padding('001', '002', '010')に揃える |
| 巨大データでメモリ不足 | 全件をメモリに載せてソート | SQL ORDER BY で DB 側に処理させる、 または heapq.nlargest(k, iter) で「上位 k 件」 だけ取り出す |
これらはいずれも「ライブラリのデフォルト動作」 を疑わずに使うと遭遇する典型トラブルである。 SSDSE-B-2026 のように小規模で整ったデータでは表面化しにくいが、 別ソース(市町村統計・国際比較・複数年マージ)を扱い始めた瞬間に頻発する。 ソート関数を呼ぶ前に「キー列の型は何か」「欠損値はあるか」「同点キーが多いか」「データサイズは何件か」 の 4 点を確認する習慣をつけると、 デバッグ時間を大幅に減らせる。
⑭ 補足: ソートと統計学習の接点
最後に、 ソートが統計学習・機械学習のどこに顔を出すかを列挙しておく。 「ソート=ただの並べ替え」 という素朴な理解から、 「ソートは多くの統計手法の内部で密かに使われる前提操作」 という理解へと拡張するための一覧である。 ①順位相関(Spearman・Kendall)は値を順位に変換するため、 ソートが本質的な前処理である。 ②パーセンタイル・中央値・四分位を計算するすべての関数は、 内部でソートを呼ぶ。 ③決定木の分岐点選択は「特徴量の値でソートして、 連続する点の中点を候補にする」 という処理を行う(CART, C4.5 などすべて)。 ④k 近傍法(kNN)は距離をソートして「上位 k 件」 を取り出す、 が np.partition で部分ソートに置き換えると高速化できる。 ⑤ROC 曲線・AUC は予測スコアをソートして閾値を動かすことで描画される。 ⑥ランダムフォレストの特徴量重要度評価で「順位の安定性」 が議論されるとき、 ソートの安定性が関係する。 ⑦欠損値処理で「中央値で補完」 する場合、 内部で必ずソートが走る。 ⑧外れ値検出の IQR 法は四分位点(=ソート+インデックスアクセス)を用いる。 ⑨ヒストグラムのビン境界決定(Sturges/Scott/Freedman-Diaconis)は標準偏差や IQR を使うため、 結局ソートに依存する。 ⑩DataFrame の groupby + agg 集計でも、 内部で hashed group keys のソートが走ることが多い。 これらすべてに共通するのは「ソートが O(n log n) でできる」 という事実が、 統計手法の計算量の前提を支えているという点である。 もしソートが O(n²) だったら、 統計学のほとんどの実用ツールは規模を制限せざるを得なかった。 ソートはアルゴリズム界の地味な主役であり、 統計学習を支える基盤技術の一つである。
さらに踏み込むと、 ソートは「データの前処理」 だけでなく「計算結果の事後処理」 でも頻出する。 例えば線形回帰の残差分析では「残差の大きい順にデータ点を並べて外れ値を探す」、 主成分分析(PCA)では「固有値の大きい順に主成分を並べて寄与率を表示する」、 クラスタリング結果では「クラスタサイズの大きい順に並べて主要クラスタから検討する」 などが典型例である。 SSDSE-B-2026 での実務では、 「47 都道府県の何らかの指標を計算したあとに、 ランキング表として並べて報告する」 という流れが毎回入る。 つまりソートは分析の入口と出口の両方を支える操作であり、 「いつ・どのキーで・どのアルゴリズムで・何のために並べ替えるか」 を意識的に選べるかどうかが、 データ実務者の腕の見せどころと言える。
本ページで紹介した SSDSE-B-2026 を用いた実演は、 すべて手元の Python 環境(pandas + numpy + matplotlib)で再現可能である。 関数名や引数の動作を、 公式ドキュメント(pandas, NumPy, scipy.stats)と照らし合わせながら、 自分の関心ある列で並べ替え・パーセンタイル抽出・ランキング表生成を試してほしい。 ソートはデータ分析を学ぶ最初の一歩であり、 同時に最後まで使い続ける一生の道具である。 47 都道府県という身近な題材を通して、 アルゴリズム理論と統計可視化との間の橋渡しが少しでも見えてきたなら、 本節の目的は十分に達成されたと言ってよいだろう。 ぜひ手元で試してほしい。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
主要ソートの計算量と特性:
| 手法 | 平均 | 最悪 | メモリ | 安定 |
|---|---|---|---|---|
| 挿入 | O(n²) | O(n²) | O(1) | ○ |
| マージ | O(n log n) | O(n log n) | O(n) | ○ |
| クイック | O(n log n) | O(n²) | O(log n) | × |
| ヒープ | O(n log n) | O(n log n) | O(1) | × |
| Timsort | O(n log n) | O(n log n) | O(n) | ○ |
| 計数 | O(n+k) | O(n+k) | O(n+k) | ○ |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 SSDSE-B-2026 で追加実値計算
『教育用標準データセット SSDSE-B-2026』(47 都道府県、 約 100 変数)を題材に、 「ソートアルゴリズム」を実際の数値で確認します。 数式が「動く感覚」を得ることが目的です。
| 対象 | 計算結果 |
|---|---|
| n=47(都道府県数)の最小比較回数 | ⌈log₂(47!) ⌉ = 198 |
| Timsort 実測比較数(A1101 整列) | 202(理論限界 198 に近い) |
| バブルソート最悪比較数 = n(n−1)/2 | 1081(5 倍以上遅い) |
🧮 数式に値を入れて手で計算する: ソートの計算量
合成 N 要素のソート時間を O 別に計算する。
Step 1: N 別の演算回数 (近似)
| N | O(N²) | O(N log N) |
|---|---|---|
| 10 | 100 | 33 |
| 100 | 10,000 | 664 |
| 1000 | 1,000,000 | 9,966 |
Step 2: 倍率
🐍 Python で再現
1 2 3 4 | import numpy as np N = np.array([10, 100, 1000]) print(f"O(N²): {N**2}") print(f"O(N log N): {(N * np.log2(N)).astype(int)}") |
📤 実行結果
💬 手計算 (Step 1) と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 既定の kind='quicksort'(NumPy の introsort)が走る。安定性が要るなら kind='stable' df_sorted = df.sort_values('A1101', ascending=False) print(df_sorted[['Code', 'Prefecture', 'A1101']].head()) |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
🐍 Python 実装(拡張版)
主要ソートアルゴリズムの実測時間を比較。 n=10⁴ で挿入・マージ・Timsort の差を体感しましょう。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import time import random def insertion_sort(a): for i in range(1, len(a)): k, j = a[i], i-1 while j >= 0 and a[j] > k: a[j+1] = a[j]; j -= 1 a[j+1] = k def merge_sort(a): if len(a) <= 1: return a m = len(a)//2 L, R = merge_sort(a[:m]), merge_sort(a[m:]) out, i, j = [], 0, 0 while i<len(L) and j<len(R): if L[i] <= R[j]: out.append(L[i]); i += 1 else: out.append(R[j]); j += 1 return out + L[i:] + R[j:] n = 10000 data = [random.random() for _ in range(n)] for name, fn in [('insertion', lambda a: insertion_sort(a[:])), ('merge', lambda a: merge_sort(a[:])), ('Timsort', lambda a: sorted(a))]: t0 = time.perf_counter(); fn(data); print(f'{name:10s}: {time.perf_counter()-t0:.4f}s') |
本番では sorted() や list.sort() を使うのが鉄則。 これは Timsort(マージソート + 挿入ソートのハイブリッド)の C 実装で、 「ほぼ整列済み」入力に対し O(n) になる。
🎮 触って理解する
ソートは「並んでいく様子」を眺めると腹落ちします。 下のバー配列に対して、 バブル・選択・挿入・クイック・マージの 5 アルゴリズムを選び、 ステップ実行または再生すると、 比較中(橙)と交換・書込中(赤)をハイライトしながら整列していきます。 比較回数と交換/書込回数のカウンタで、 O(n²)(バブル・選択・挿入)と O(n log n)(クイック・マージ)の実際の演算量の差を体感してください。 図の上を左右にドラッグ(スワイプ)すると、 任意の時点まで早送り・巻き戻しできます。
🎯 直感 — 整列の戦略はこの3系統
- 隣を比べて泡のように運ぶ(バブル)/毎回最小を選ぶ(選択)/手札に差し込む(挿入):どれも素朴で正しいが、 比較が二重ループになり O(n²)。 バーを触ると「比較回数が n が増えるほど急に増える」のが見えます。
- 分割統治(クイック・マージ):列を半分に割って各々を整列し、 併合する。 「大きな問題を小さくして片付ける」戦略で O(n log n)。 同じ n でも比較回数がはっきり少ないことをカウンタで確認できます。
- 体感の要点:要素数スライダーを 8 → 32 に上げてから、 バブルとマージの比較回数を見比べてください。 n が 4 倍になると O(n²) は約 16 倍、 O(n log n) は約 5 倍にしか増えません。
⚠️ よくある落とし穴 — 安定性と最悪計算量
- 安定性(stable):同じ値の要素の元の順序を保つか。 マージ・挿入・バブルは安定、 クイック・選択は不安定。 「県名→人口」の二段ソートで前段が壊れるのは不安定ソートを使ったとき。 この可視化のクイック(Lomuto 分割)も等値要素の相対順序を保証しません。
- 最悪計算量:クイックソートは平均 O(n log n) でも、 既に整列済みの列に単純なピボット選択を使うと最悪 O(n²) に劣化します。 「速い=いつでも速い」ではない点に注意。
- 交換 vs 書込:マージソートは in-place の「交換」ではなく作業配列への「書込」でカウントします(カウンタのラベルが自動で切替わります)。 追加メモリ O(n) が必要な点がクイックとの実務上の差です。
🚀 発展 — 計算量の下限と実務の Timsort
比較だけで並べ替えるアルゴリズムは、 どれほど工夫しても $\Omega(n \log n)$ 回の比較が必要(本ページ「📐 定義・数式」参照)。 だからクイック・マージ・ヒープはこの下限に張り付いた「ほぼ最適」な手法です。 実務で使う Python の sorted() / list.sort() の内部は Timsort(pandas の sort_values() は既定で quicksort) ── マージソートに挿入ソートを組み合わせ、 「既にほぼ整列している部分列(run)」を検出して活かすハイブリッド。 上の可視化で挿入ソートが「整列済みに近い入力で比較回数が激減する」様子を見ると、 Timsort がなぜ現実データで速いのかが直感的に分かります。 さらに整数・固定長キーなら比較を使わない基数ソートで O(n) も可能です。
関連ページ:pandas(sort_values の実体)/最適化・組合せ最適化(計算量の考え方)/計算機(実装差が速度に効く理由)。 「アルゴリズム」「データ構造」の独立ページは本用語集には未収録のため、 本ページ内の解説を参照してください。
⚠️ よくある落とし穴
ソートは pandas の sort_values() 一発で済みそうに見えますが、 「安定性 (stable)」を見落とした二段ソート、 クイックソートの最悪 O(n²)、 NaN を含む浮動小数点比較、 TB スケールのインメモリ前提崩壊、 の 4 つで実装事故が頻発します。 SSDSE-B-2026 程度の 47 行では問題になりませんが、 個票データ (数百万行) では確実に踏みます。
⚠️ 同じ値の県に何位を付けるか — rank の method で順位が変わる
ソートして順位を付けるとき、 同じ値(タイ)が並ぶと「何位にするか」を決める必要がある。 小数 2 桁で公表される合計特殊出生率(A4103)は同点が多い。 pandas の rank の method を変えて比べる。
🎯 このコードでやること:2023 年度の 47 都道府県の合計特殊出生率に、 高い順の順位を method = min・average・dense・first の 4 通りで付け、 同点の県の順位を比べる。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023][['Prefecture', 'A4103']].copy() # 合計特殊出生率(小数 2 桁) print('異なる値の数:', d['A4103'].nunique(), '/ 47 県') dup = d['A4103'].value_counts() print('2 県以上が同じ値になっている値:', (dup > 1).sum(), '個、 そのうち 3 県が並ぶ値:', sorted(dup[dup == 3].index)) for m in ['min', 'average', 'dense', 'first']: d[m] = d['A4103'].rank(ascending=False, method=m) t = d[d['A4103'] == 1.29].sort_values('first') print(t.to_string(index=False)) print('dense 順位の最大値:', int(d['dense'].max()), ' / first 順位の最大値:', int(d['first'].max())) |
💬 47 県の値は 31 種類しかなく、 14 の値で 2 県以上が同点になっている。 1.29 の愛知県・三重県・兵庫県は、 min では 3 県とも 25 位、 average では 26 位、 dense では 17 位になり、 first では 25・26・27 位と別々の順位が付く。 first の並びは CSV の行の順(都道府県コード順)で決まっているだけで、 値に意味のある差は無い。 dense は順位を詰めるので最大が 31 位になり、 「47 県中の何位」とは読めない。 ランキングを公表するときは method を書き、 同点の県を別々の順位にしない(first を使わない)のが安全である。
💥 実例から学ぶ失敗パターン
「ソートアルゴリズム」が実務でうまくいかなかった、 過去の有名な失敗例から学べることは多いです。 ここでは典型的な失敗パターンを 4 つ紹介します(特定企業の言及は避け、 教訓に焦点)。
失敗例 A:クイックソート最悪 O(n²) — 既ソート入力で線形劣化
既に昇順に並んだデータ(例: SSDSE-B-2026 を都道府県コード R01000〜R47000 で受け取った 47 件)に対し、 先頭要素を pivot 固定にしたナイーブクイックソートを適用すると、 分割が常に「(0 件) | pivot | (n-1 件)」となり計算量が $O(n^2)$ に劣化。 教訓:pivot はランダム化または「中央値の中央値(median of medians)」で選ぶ。 標準ライブラリ(CPython の Timsort、 C++ STL の introsort)は最悪 $O(n \log n)$ を保証する設計になっている。
失敗例 B:非安定ソートで「県内 → 県名 → 人口」二段ソートが壊れる
SSDSE-B-2026 で「県名で昇順」→「人口で降順」と二段でソートする際、 後段に非安定ソート(ヒープソートなど)を使うと、 同じ人口の県が県名順を失う。 教訓:複合キーのソートは「df.sort_values(['人口', '県名'], ascending=[False, True])」のように一度に指定するか、 安定ソート(Timsort、 マージソート)を選ぶ。 pandas / NumPy の kind='stable' はデフォルトで Timsort。
失敗例 C:基数ソートで巨大値域 $k$ を見落としメモリ爆発
「カウントソート / 基数ソートは $O(n)$ で速い」と聞き、 SSDSE-B-2026 の「総人口 A1101」(最大 $\approx 1.4 \times 10^7$ 人)に直接カウントソートを適用すると、 サイズ $k = 1.4 \times 10^7$ の補助配列が必要で数十 MB を確保しメモリを圧迫。 教訓:線形ソートは $O(n+k)$ または $O(d \cdot n)$ で、 $k$(値域)や $d$(桁数)が小さい時のみ有効。 値域が広いキーは比較ソート(Timsort 等)の方が結局速い。
失敗例 D:浮動小数点キーで NaN を含むデータの順序が ill-defined
SSDSE-B-2026 の一部欠測列(例: 観光客数の未集計年)を NaN のままソートすると、 NaN は比較で常に false を返すため、 ソート結果が C++ の std::sort では未定義動作になり、 Python の sorted でも位置が予測不能。 教訓:NaN は事前に df.dropna(subset=['キー']) または df.fillna(np.inf) で位置を明示。 pandas の sort_values は na_position='last' がデフォルトで NaN を末尾に置く。
💡 共通教訓:失敗の多くは「技術的に正しくても、 設計・運用・組織が追いついていない」ことに起因します。 技術選択と並んで、 ガバナンス・モニタリング・コミュニケーションの設計も同じくらい重要です。
🗺 概念マップ
ソートアルゴリズムは「比較して並べる」系(挿入・マージ・クイック・ヒープ、 下限 Ω(n log n))と「値を直接使って配る」系(計数・基数・バケット)に分かれ、 実務のライブラリはそれらを組み合わせたハイブリッド(Timsort・introsort)になっている。 並べた結果は中央値・分位数・順位・ランキング表として統計の側で使われる。 下の表と図でこのつながりを確かめる。
🏗 各ソートの仕組み
| 名称 | 原理 | 適性 |
|---|---|---|
| バブルソート | 隣接要素を比較・交換 | 教育用・小データのみ |
| 挿入ソート | 既ソート部分に 1 要素ずつ挿入 | ほぼ整列済みでは O(n) |
| 選択ソート | 最小値を選んで先頭と交換 | 交換回数最小 |
| マージソート | 分割統治・統合 | 外部ソート・安定 |
| クイックソート | ピボット分割で再帰 | インメモリ最速・実用標準 |
| ヒープソート | バイナリヒープで取り出し | O(1) 補助メモリ・最悪保証 |
| Timsort | マージ + 挿入のハイブリッド | Python/Java/Android 標準 |
| 基数ソート | 桁ごとに分配ソート | 整数・固定長文字列 O(n) |
| 計数ソート | 値の出現回数を集計 | 値域 k が小さい時 O(n+k) |
| バケットソート | 値域をバケットに分割 | 一様分布の連続値 |
🔗 隣接手法への橋渡し
「ソートアルゴリズム」は データの順序付けという基本処理 でありながら、 上流のデータ構造選択 (配列・連結リスト) と下流の検索・集計・median 計算を繋ぐ。 Pandas/NumPy・SQL ORDER BY・データベース B-tree インデックスの内部に組み込まれる土台技術。
⬆️ 上流: アルゴリズム基礎
⬌ 並列: 代表的なソート
⬇️ 下流: 応用・検索
ソートは「データを並べる」基本演算で、 quicksort / mergesort / heapsort の三大手法を計算量・安定性で使い分け、 二分探索・DB インデックス・Top-K など多くの応用の前提となる。
🌳 手法選択フロー
「ソートアルゴリズム」を選ぶかは、 データ量・安定性要件・既ソート度で判断する。
- n が小さいか (n<50)? Yes → 挿入ソート O(n²) でも十分高速、 No → 次へ
- 安定性 (同値の順序保持) が必要か? Yes → マージソート O(n log n) または Python の Timsort、 No → クイックソート O(n log n) 平均
- 既ソートに近いか? Yes → Timsort O(n) 近く、 No → クイック/マージ標準
Python sort() は Timsort で安定 O(n log n)。 SSDSE-B-2026 を「人口降順」に並べる用途では df.sort_values('A1101', ascending=False) で十分。 自前実装は学習目的のみ。
🧭 解説深化:ソートは「順序統計量の製造装置」である
本文ではソートを「並べ替えの手続き」として計算量・安定性の軸で扱いました。 この節では視点を一段ずらし、 「ソートの出力は並んだ列そのものではなく、 置換 (permutation) である」という見方から、 データ分析でソートが果たしている本当の役割を掘り下げます。
🎨 直感 — 1 回のソートが中央値・分位数・順位を同時に生む
中央値・四分位数・順位・最小値・最大値は、 すべて「ソート済み列の特定位置を読むだけ」で得られる順序統計量です。 つまり 1 回のソート (O(n log n)) を払えば、 これら全部が O(1) の添字参照で手に入る。 ソートは個々の統計量の「原材料」を一括生産する装置だと捉えると、 なぜ pandas・SQL・BI ツールの内部で常にソートが走っているのかが腑に落ちます。
SSDSE-B-2026 の 2023 年・47 都道府県の総人口 A1101 で実測すると(値はすべて実データ):
- 昇順ソート後の 24 番目(0 始まりで 23) = 中央値 1,549,000 人 = 鹿児島県。 47 は奇数なので中央の 1 点がそのまま中央値。
- 先頭 3 件:鳥取県 537,000 / 島根県 650,000 / 高知県 666,000。 末尾 3 件:大阪府 8,763,000 / 神奈川県 9,229,000 / 東京都 14,086,000。 最小・最大もソート済み列の両端を読むだけ。
- 順位も置換の合成:
np.argsort(np.argsort(-arr)) + 1で降順順位が出ます(argsort を 2 回かけると「各要素が何番目か」に反転する)。 実測で広島県は人口 2,738,000 人・全国 12 位。df.rank()の内部も本質はこれです。
sort_values() が返しているのは「値を動かした結果」ですが、 その実体は argsort が作る添字の置換です。 「値を並べる」のではなく「並べ替え方(置換)を求め、 それを列に適用する」と分解して理解すると、 複数列を同じ順に並べる操作(置換を使い回す)が自然に見えてきます。
⚠️ 落とし穴(重要)— dtype が文字列のままだと「辞書順」で並ぶ
本文の落とし穴(安定性・最悪 O(n²)・NaN・外部ソート)に加えて、 実務で最も頻繁に踏むのがこれです。 CSV の数値列に秘匿記号や桁区切りカンマが混ざると pandas は列を object (文字列) として読み込み、 ソートは辞書順(1 文字目から文字コード比較)になります。 SSDSE-B-2026 の A1101 をわざと文字列化して降順ソートした実測結果:
"926000" が "9229000" より上に来るのは、 3 文字目で '6' > '2' だから。 桁数(= 大きさ)は一切考慮されません。 昇順の先頭も鳥取県 (537,000) ではなく富山県 (1007000) になります('1' < '5')。 恐ろしいのはエラーが出ず、 一見それらしい順位表が出てしまうこと。 対策は 3 つ:df.dtypes で object 列を確認する、 pd.to_numeric(col, errors='coerce') で数値化して NaN 化された行を点検する、 ソート結果の先頭と末尾を必ず既知の事実(東京が 1 位のはず等)と突き合わせる。
🚀 発展 — 「全部並べない」という選択肢:部分ソート
「上位 10 件だけ欲しい」「中央値だけ欲しい」のに全体をソートするのは過剰です。 目的別に並べる範囲を絞ると計算量が落ちます。
- 選択問題は O(n):
np.partition(arr, 23)は「23 番目に小さい値がその位置に来る」ことだけ保証する部分分割で、 平均 O(n)(quickselect)。 中央値 1,549,000 はこれで全ソートなしに取れます。 前後の並びは保証されない点に注意。 - 上位 k 件は O(n log k):
df.nlargest(3, 'A1101')はヒープを使い、 実測で東京都 14,086,000 / 神奈川県 9,229,000 / 大阪府 8,763,000 を返します。 n=47 では差は出ませんが、 n が数百万・k が数十のとき全ソートとの差が効いてきます。 - 適応性 (adaptivity):Timsort は「すでに並んでいる連続部分 (run)」を検出して活用するため、 ほぼ整列済みの入力なら O(n) に近づきます。 毎回追記されるログのような「だいたい並んでいる」データに強い、 という実務上の含意があります。
まとめると、 選択肢は「全ソート O(n log n)」「上位 k の部分ソート O(n log k)」「k 番目の選択 O(n)」の 3 段階。 出力に必要な情報量が少ないほど、 払う計算量も減らせる——これは比較ソートの下限 Ω(n log n) が「n! 通りを区別する情報量」から来ていたことの裏返しでもあります。