🔖 キーワード索引
別名・略称:データ生成過程(DGP, data generating process)、 真のモデル、 真の関数 f*(x)
このページでは、 観測値 = 真の関数 f*(x) + ノイズ ε という見方から出発し、 残差プロット・予測区間・識別可能性・バイアスとバリアンス・外挿の難しさ・標本分布と母集団の違いを、 SSDSE-B-2026 の 47 都道府県と「真値が既知」のシミュレーションの両方で確かめる。
💡 30秒で分かる結論
🍰 まずはやさしく
データの裏にある本当の仕組みのことです。
正解を予想するための基準にするために使います。
テストの点数が決まる本当の理由のようなものです。
この仕組みをどうやって見つけるかを読みます。
真のプロセス(True Process):観測の背後にあるデータ生成過程
- 真のプロセス=観測データの背後にある本当のデータ生成メカニズム。 統計・機械学習はこれを推定したい。
- 「真のプロセス」は通常 未知。 我々は有限のサンプルから推定するしかない。
- モデルは「真の関数 $f^*$ +ノイズ $\epsilon$」を想定。 推定した $\hat f$ が $f^*$ に近づくほど良いモデル。
- シミュレーション研究では 「真のプロセスを自分で決めて」 データを生成し、 推定手法の性能を検証する。
- 「真のモデル=線形」と思い込む過信は禁物。 現実はもっと複雑。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの裏側に隠れた正解のようなものです。
分析の土台となる考え方として使います。
スマホの利用時間と成績の関係を考えるときです。
この考え方がなぜ重要なのかを読みます。
🎨 直感で掴む
🍰 まずはやさしく
正解のグラフをなぞるようなイメージです。
モデルがどれだけ正確かを測るために使います。
部活の練習量と上達の関係を予想するときです。
正解に近づくための色々な方法を読みます。
真のプロセスとモデルの関係
世界には我々が知らない 真の関数 $f^*(x)$ があると仮定します。 観測値は:
我々ができるのは:
- 有限のサンプル $(x_i, y_i)$ を集める
- モデル族 $\mathcal{F}$(線形、 木、 ニューラルネット等)から推定 $\hat f$ を作る
- $\hat f$ が $f^*$ にどれだけ近いか考える
「モデルが真のプロセスを正確に表現できるか」が バイアス-バリアンス分解 の根幹です。
🎨 真のプロセスを推定する 4 つの典型アプローチ
真のプロセス $f^*$ を推定する手法は、 仮定の強さと柔軟性のトレードオフで分類できます。
| アプローチ | 仮定の強さ | 代表手法 | 真のプロセスがマッチする例 |
|---|---|---|---|
| パラメトリック | 強い | 線形回帰、 ロジスティック回帰 | 物理法則、 単純な関係 |
| セミパラメトリック | 中 | 一般化加法モデル (GAM) | 滑らかな非線形関係 |
| ノンパラメトリック | 弱い | カーネル回帰、 ランダムフォレスト | 複雑な相互作用 |
| ディープラーニング | 最も弱い | ニューラルネット、 Transformer | 高次元・高度な抽象 |
SSDSE で 3 つのアプローチを比較
同じ問題(2023 年の総人口から一般診療所数を近似する)に対して、 異なる仮定強度のモデルを適用し、 真のプロセスへの近似度を比較しましょう。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
df = pd.read_csv('data/raw/SSDSE-B-2026.csv',
encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
X = (df[['A1101']].values / 1_000_000) # 総人口 (百万人)
y = df['I5102'].values # 一般診療所数
lin = LinearRegression().fit(X, y)
mse_lin = ((lin.predict(X) - y) ** 2).mean()
X_poly = np.column_stack([X, X ** 2])
poly = LinearRegression().fit(X_poly, y)
mse_poly = ((poly.predict(X_poly) - y) ** 2).mean()
rf = RandomForestRegressor(n_estimators=50, max_depth=3,
random_state=0).fit(X, y)
mse_rf = ((rf.predict(X) - y) ** 2).mean()
print(f'線形: MSE = {mse_lin:.1f}')
print(f'多項式: MSE = {mse_poly:.1f}')
print(f'RF: MSE = {mse_rf:.1f}')
|
🎯 このコードでやること: 2023 年 47 都道府県の総人口 (A1101) から一般診療所数 (I5102) を近似し、 仮定の強さが違う 3 つのモデルの MSE を比較する。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県、 A1101 (総人口) と I5102 (一般診療所数)。
📤 実行結果:
💬 結果の読み方: 2 次式が最も低 MSE だが、 47 点だけの断面なので「真のプロセスを当てた」とは言えない。 総人口と一般診療所数の関係は強いが、 東京都・大阪府など大都市の残差がモデル選択に大きく効くため、 残差の形も合わせて見る必要がある。
🎨 真のプロセスを可視化する 3 つの方法
真のプロセスは直接観察できませんが、 推定値と観測値の関係を可視化することで、 真のプロセスへの「近さ」を視覚的に判断できます。
方法 1: 残差プロット
予測値 vs 残差をプロット。 真のプロセスが正しく推定されていれば、 残差は ゼロ周りにランダム散布するはず。 系統的なパターンが見えたらモデルが真のプロセスを捉えきれていない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd
from sklearn.linear_model import LinearRegression
df = pd.read_csv('data/raw/SSDSE-B-2026.csv',
encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
X = (df[['A1101']].values / 1_000_000) # 総人口 (百万人)
y = df['I5102'].values # 一般診療所数
model = LinearRegression().fit(X, y)
result = df[['Prefecture', 'A1101', 'I5102']].copy()
result['pop_million'] = X.ravel()
result['pred'] = model.predict(X)
result['resid'] = result['I5102'] - result['pred']
result = result.reindex(result['resid'].abs().sort_values(ascending=False).index)
print('都道府県 人口(百万人) 実測 予測 残差')
for _, row in result.head(8).iterrows():
print(f"{row['Prefecture']} {row['pop_million']:6.3f} "
f"{row['I5102']:5.0f} {row['pred']:5.0f} {row['resid']:+6.0f}")
|
🎯 このコードでやること: 総人口だけで一般診療所数を線形予測し、 残差が大きい都道府県を確認する。 残差に地域・都市規模の構造が残るかを読む。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県、 A1101 (総人口) と I5102 (一般診療所数)。
📤 実行結果:
💬 結果の読み方: 残差は東京都・大阪府で正、 埼玉県・千葉県・神奈川県で負に大きい。 総人口だけでは、 医療機関の集積、 昼間人口、 周辺県からの受療行動などの構造を吸収しきれない。 ここに「人口だけではない真のプロセス」が残差として表れている。
方法 2: 予測区間の可視化
点推定だけでなく 予測区間を提示することで、 真のプロセスの不確実性を表現できる。 95% 予測区間が広い領域では、 真のプロセスを正確に推定できていない。
方法 3: 部分依存プロット
機械学習モデル (RF、 GBM) でも、 「真のプロセスがどんな形か」を可視化できる。 入力変数を変化させたときの予測値の変化をプロットすることで、 非線形性・相互作用を読み取れる。
🔍 モデル仮説と真のプロセスの一致を検証する 5 つの統計テスト
真のプロセスへの近似度を定量的に判定する代表的検定手法を整理します。
| 検定 | 何を検出するか | 推定モデル |
|---|---|---|
| Durbin-Watson 検定 | 残差の自己相関 | 時系列モデル |
| Breusch-Pagan 検定 | 残差の異分散 | 線形回帰 |
| Ramsey RESET 検定 | 関数形のミスマッチ | 線形・多項式 |
| Chow 検定 | 構造変化 | 時系列・分断回帰 |
| Hosmer-Lemeshow 検定 | 適合度 | ロジスティック回帰 |
💡 使い分け: モデル仮説が「真のプロセスを十分捉えているか」を厳密に確認する場合、 これらの検定を組み合わせる。 複数の検定を通過したモデルは、 真のプロセスへの近似として信頼性が高い。
🎮 触って理解する
データ生成過程を手で動かして体感しましょう。 見えないはずの 真の関数 f*(x)(緑の線)から、 ノイズを加えて 有限個の観測データ(黒い点)を生成し、 それに 推定モデル f̂(赤の線)を最小二乗で当てはめます。 現実に手に入るのは黒い点だけ。 緑の線は本来見えません。
💡 図の上を ドラッグ(スマホはタッチ)しても操作できます: 横方向=振幅 a / 縦方向=ノイズ σ。
この図から分かること
- 観測 = 真の過程 + ノイズ: σ を上げると黒点が緑線の周りに散らばる。 データは真の関数を直接は見せてくれません。
- サンプリング変動: 「新しい標本」を押すたびに赤線が揺れます。 真の関数は同じでも、 手元の標本が変わると推定は変わる。
- 有限性の限界: n を小さくすると赤線が不安定に。 データは真の過程の一部しか見せません。
- 次数 d と過学習: d を上げると訓練MSEは下がるのに、 真の関数との平均二乗差はかえって悪化することがあります(過学習)。
💡 直感
私たちが分析するのは「真実そのもの」ではなく「真実にノイズが乗った影」です。 モデリングとは、 影(観測データ)から本体(真の関数 f*)を逆算しようとする営み。 だから「データによく当てはまる」ことと「真の過程をよく捉えている」ことは別物です。
⚠️ よくある落とし穴
- 観測 = 真実 と誤解する: 手元のデータをそのまま真の関係と信じると、 ノイズのたまたまの形まで「意味」として読み取ってしまう。
- 過学習: 訓練MSEを下げること自体を目的化すると、 高次モデルがノイズを暗記して f* から離れる(上の図で d を 8〜9 にしてみてください)。 → 過学習 / 汎化
- 1つの標本を過信する: 1回の推定は多数のありえた推定の1つにすぎない。 → 標本抽出 / ブートストラップ
🔭 発展
- 母集団と標本: 真の過程は 母集団 の性質、 観測は 標本。 標本から母集団を推し量るのが推測統計です。
- 生成モデル的見方: y = f*(x) + ε をデータの「生成レシピ」とみなすと、 ノイズ ε の分布の仮定(等分散・正規性など)が推定の妥当性を左右します。
- バイアス-バリアンス: 「変動を見る」で表示される バイアス² と バリアンス の和が期待誤差の主要部分。 次数 d を上げると分散↑・バイアス↓のトレードオフが観察できます。 → バイアス-バリアンス分解
📐 定義 / 数式
🍰 まずはやさしく
数式で表したデータの作り方のことです。
予想のズレを正しく計算するために使います。
買い物の金額が決まるルールを式にすることです。
数式を使った詳しい定義について読みます。
📐 識別可能性 (Identifiability) と Bias-Variance トレードオフ
真のプロセス $f^*$ を観測データから一意に決定できるかという問題が 識別可能性。 識別可能でない場合、 異なる $\hat{f}$ が同じデータをほぼ等しく説明してしまうため、 「真のプロセスを当てた」とは言えません。
識別可能性の数式
$$ \text{identifiability:} \quad \forall \theta_1 \ne \theta_2, \; p(Y | X, \theta_1) \ne p(Y | X, \theta_2) $$
パラメータ $\theta_1, \theta_2$ が異なれば、 観測の確率分布も異なる — これが識別可能性。 多重共線性 (多重共起) や交絡が強いと、 識別可能性が破れます。
数式を言葉で読み解く
「2 つの異なるパラメータ値が、 全く同じデータ分布を生む」と パラメータを区別できない=識別不能。 たとえば 2 変数が完全相関していたら、 それぞれの寄与を分離して推定できない(多重共線性の本質)。 SSDSE-B では「総人口」と「世帯数」がほぼ完全相関するため、 両方を回帰に入れると識別不能になります。
Bias-Variance トレードオフの数式
$$ \mathbb{E}\left[(\hat{f}(x) - f^*(x))^2\right] = \underbrace{(\mathbb{E}[\hat{f}(x)] - f^*(x))^2}_{\text{Bias}^2} + \underbrace{\mathbb{V}[\hat{f}(x)]}_{\text{Variance}} + \sigma^2 $$
真のプロセス $f^*$ との距離 (MSE) は バイアスの二乗 + 分散 + 既約ノイズに分解される。 シンプルなモデルはバイアス大・分散小、 複雑なモデルはバイアス小・分散大。 真のプロセスの複雑さを正しく見積もることが、 適切なモデル選定の鍵です。
💡 実務のコツ: 「真のプロセスが線形なのにディープラーニングを使う」と分散が爆発し、 過学習する。 逆に「真のプロセスが非線形なのに線形モデルを使う」とバイアスが大きく、 系統的な誤差が残る。 真のプロセスの複雑度とモデルの複雑度を釣り合わせるのが分析の腕の見せ所。
📐 真のプロセスの哲学 — 古典統計 vs ベイズ
真のプロセスの捉え方は、 古典統計学 (頻度主義) と ベイズ統計学 で大きく異なります。 用語を使う際は、 どちらの立場で議論しているかを意識することが重要。
頻度主義の見方
真のプロセスのパラメータ $\theta^*$ は 固定された定数。 観測データはランダムで、 標本ごとに $\hat{\theta}$ が変動する。 信頼区間は「同じ実験を無限回繰り返したとき、 95% が真値を含む区間」と解釈する。
ベイズ主義の見方
$$ p(\theta | D) = \frac{p(D | \theta) p(\theta)}{p(D)} $$
真のプロセスのパラメータ $\theta$ は 確率変数として扱う。 観測データ $D$ を得る前に事前分布 $p(\theta)$ を設定し、 観測後に事後分布 $p(\theta | D)$ を計算する。 信用区間 (credible interval) は「真値が含まれる確率 95%」と直接解釈できる。
数式を言葉で読み解く
ベイズの定理は「事前知識 + 観測 = 事後知識」を数学的に表現したもの。 $p(D|\theta)$ は尤度 (このパラメータならこのデータが出る確率)、 $p(\theta)$ は事前分布 (分析前に持つ信念)、 $p(\theta|D)$ は事後分布 (データで更新された信念)。 真のプロセスを「不確実な知識」として扱うのがベイズの本質です。
| 観点 | 頻度主義 | ベイズ |
|---|---|---|
| 真のパラメータ | 固定された定数 | 確率変数 |
| 事前知識 | 使わない | 事前分布として明示 |
| 区間推定 | 信頼区間 | 信用区間 |
| 解釈の直感性 | 難しい | 直感的 |
| 計算コスト | 低 | 高 (MCMC など) |
✅ 真のプロセスを推定する際の実践チェックリスト
分析開始前
- 真のプロセスについて、 ドメイン知識から仮説を立てたか?
- 観測データのバイアスを把握したか?
- サンプルサイズが推定に十分か? (検出力分析)
モデル選択時
- 仮定の強さと真のプロセスの複雑度が釣り合っているか?
- 識別可能性 (多重共線性チェック等) を確認したか?
- 過学習対策 (正則化、 交差検証) を組み込んだか?
推定後
- 残差プロットで系統的パターンがないか?
- テストデータでも予測精度が保たれているか?
- 異なるモデルでも結論が変わらないか? (頑健性分析)
- 結果の信頼区間 / 信用区間を報告したか?
レポート時
- 「真のプロセスが線形と仮定して」など、 前提を明記したか?
- 外挿の範囲と限界を示したか?
- 因果関係の主張に必要な条件を満たしているか?
💡 知的誠実さの原則: 真のプロセスを「当てた」と主張するには非常に強い証拠が必要。 通常は「現在のデータ・現在のモデル仮定の下では、 真のプロセスは X に近いと推定される」という慎重な書き方が適切。 これが 誠実な統計推論の姿勢。
🔬 記号・式を言葉で読み解く
- $f^*$
- 真の関数。 神のみぞ知る。 我々は推定するしかない。
- $\epsilon$
- ノイズ項。 観測誤差、 未測定の影響因子をまとめて表現。
- $\hat f$
- 我々が手元のサンプルで学習した推定モデル。
- バイアス
- $\hat f$ の期待値と $f^*$ のずれ。 モデルが 真のプロセスを表現しきれない ことで生じる。
- バリアンス
- サンプルが変わると $\hat f$ がどれだけブレるか。 複雑モデルで増大。
- 既約誤差
- $\sigma^2$。 ノイズ自体に由来し、 どんなモデルでも消せない下限。
🔬 真のプロセス vs 観測モデル — 統計の根本構造
統計分析の出発点は 「真のプロセスは観測できない」という前提です。 私たちが手にするのは 観測データであり、 そこから真のプロセスを 推定するのが分析の仕事。 この区別を理解せずに分析を進めると、 「観測されたパターン = 真理」と誤解する典型的な落とし穴に陥ります。
真のプロセスの数学的定式化
$$ Y = f^*(X) + \varepsilon, \quad \varepsilon \sim \mathcal{N}(0, \sigma^2) $$
ここで $f^*$ が 真のプロセス(私たちが推定したい対象)、 $\varepsilon$ が観測ノイズ。 分析者が推定するのは $\hat{f}$ という 真のプロセスの近似であり、 これは無限にデータを集めても $f^*$ と完全には一致しません(モデル誤差 + ノイズが残るため)。
数式を言葉で読み解く
$f^*$ は 「自然界が知っているが、 私たちは知らない」関数。 $\varepsilon$ は測定誤差・サンプリング誤差・モデル化されていない要因など、 私たちには予測できない揺らぎ。 真のプロセスがあるからこそ、 統計推定が意味を持ち、 信頼区間や仮説検定が定義できる。 「真のプロセスがある」という仮定そのものが、 古典統計学の基盤です。
SSDSE-B-2026 で観測モデルを実演
SSDSE-B-2026 の 2023 年 47 都道府県データは、 何らかの真のプロセス(人口規模と医療提供体制の構造)に観測ノイズが乗ったものと考えられます。 ここでは「総人口から一般診療所数を近似する」線形モデルを例にします。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd
from sklearn.linear_model import LinearRegression
df = pd.read_csv('data/raw/SSDSE-B-2026.csv',
encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
X = (df[['A1101']].values / 1_000_000) # 総人口 (百万人)
y = df['I5102'].values # 一般診療所数
model = LinearRegression().fit(X, y)
y_hat = model.predict(X)
residuals = y - y_hat
print(f'傾き (施設/百万人): {model.coef_[0]:.1f}')
print(f'切片: {model.intercept_:.1f}')
print(f'残差 SD: {residuals.std():.1f}')
print(f'人口 500 万人の予測値: {model.predict([[5]])[0]:.1f}')
|
🎯 このコードでやること: 2023 年の 47 都道府県について、 総人口を入力、 一般診療所数を出力とする線形観測モデルを当てはめる。 傾きが 真のプロセスの粗い近似、 残差が 観測ノイズと未観測構造の近似。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県、 A1101 (総人口) と I5102 (一般診療所数)。
📤 実行結果:
💬 結果の読み方: 人口が 100 万人増えると一般診療所数は平均で約 909.5 施設増える、 という線形近似になる。 ただし残差 SD は 611.9 施設あり、 総人口だけでは説明できない都市機能・医療圏・年齢構成などが真のプロセスに残っている。
真のプロセスが「直線」とは限らない
上の分析は「真のプロセスは線形」と仮定していましたが、 これは 近似仮定にすぎません。 実際の医療提供体制は人口だけでなく、 都市機能、 年齢構成、 交通圏、 近隣県からの受療行動など、 複雑な非線形構造を持ちます。 真のプロセスを正しく推定するには、 仮定そのものを検証する作業(残差プロット、 別モデルとの比較)が必要です。
🧮 実データで計算してみる
シミュレーションで「真のプロセス」を自分で決める例:
- 真の関数を $f^*(x) = 2x + 3$ と決める
- $x_i$ を一様分布から 100 個、 $\epsilon_i \sim N(0, 0.5^2)$ を加えて $y_i$ を生成
- このデータで線形回帰 → $\hat\beta_0 \approx 3$、 $\hat\beta_1 \approx 2$ になるはず
- 違う乱数シードで何度も繰り返すと、 $\hat\beta$ の分布が見える=サンプリング分布
この「真の値が分かっている設定」を作ることで、 推定手法のバイアスとバリアンスを定量化 できます。
🧮 数式に値を入れて手で計算する: 真の生成過程と観測のずれ
「真の生成過程」は本質的に未知だが、 教科書的に仮の真値モデル y = 2x + 3 を設定し、 x = 1〜5 の架空の観測値 5 点 (真値にノイズを乗せた合成データで、 SSDSE-B-2026 の実データではない) について、 真値と観測のずれ (残差) を計算する。 真値を自分で決めたからこそ残差を「純粋なノイズ」として測れるのであって、 SSDSE のような実データでは真の生成過程は不可知であり、 推定モデルとの誤差は必ず残る点が要諦。
Step 1: 真の値と観測
| x | 真 y = 2x+3 | 観測 (ノイズ含む) | 残差 |
|---|---|---|---|
| 1 | 5 | 5.2 | +0.2 |
| 2 | 7 | 6.5 | -0.5 |
| 3 | 9 | 9.1 | +0.1 |
| 4 | 11 | 10.8 | -0.2 |
| 5 | 13 | 13.4 | +0.4 |
Step 2: 残差二乗和
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np x = np.array([1,2,3,4,5]) y_true = 2*x + 3 y_obs = np.array([5.2, 6.5, 9.1, 10.8, 13.4]) SSE = ((y_obs - y_true)**2).sum() print(f"SSE: {SSE}") |
📤 実行結果
💬 手計算 (Step 2) 0.50 と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年データ)を題材にした最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 | # シミュレーションの準備:真のプロセス y = 2x + 3 を仮に決め、実データの x で真値を計算する import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 実在列から高齢化率を作る: A1303 高齢人口 / A1101 総人口 aging_rate = df['A1303'] / df['A1101'] * 100 y_true = 2 * aging_rate + 3 # ノイズを乗せる前の「真値」 print(f'2023年の都道府県数: {len(df)}') print(f'高齢化率の平均: {aging_rate.mean():.2f}%') print(f'仮の y_true 平均: {y_true.mean():.2f}') |
📤 実行結果:
🐍 応用コード — 「都道府県の出生率」を決める真の因果構造は観測不能、 SSDSE はその影
SSDSE 公的データを題材に、 真のプロセス を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['A1101', 'A1301', 'A1303', 'A4101'] df_use = df[features].copy() print(df_use.describe()) |
💬 2023 年度に絞ったので 47 行 × 112 列になった。総人口は平均 264 万 6 千人に対して中央値 154 万 9 千人と平均が中央値の約 1.7 倍あり、最大の 1,408 万 6 千人(東京都)が平均を引き上げている。出生数も平均 15,474 人・中央値 9,524 人と同じ形の右裾で、観測値を生んだ「真の過程」を考えるとき、県の人口規模という共通の要因が 4 列すべてに効いていることがここから読み取れる。
次に、 真のプロセス に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score X = df[['A1101', 'A1303', 'A4101']].fillna(0).values y = df['A4103'].fillna(df['A4103'].median()).values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 合計特殊出生率を人口・高齢人口・出生数の 3 列から当てると、train R² 0.866 に対して test R² は 0.038 まで落ちた。y の標準偏差は 0.133 なので test RMSE 0.114 はほぼ平均を当てたのと同じ誤差で、学習データの 32 県に合わせ込んだだけで真の過程はつかめていない。test は 15 県しかなく、分割を変えると R² が大きく動くので、次の 5-fold CV で確かめる。
さらに可視化を加えると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('真のプロセス を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_true-process.png', dpi=150) |
最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。
1 2 3 4 5 6 7 8 | from sklearn.model_selection import cross_val_score scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=5, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 5 つの fold の R² は -5.832 から 0.445 まで振れ、平均は -2.092 と「平均値で予測する」より悪い。cv=5 はシャッフルせずに先頭から分けるので、1 つ目の fold は北海道〜群馬など北日本の県だけで検証しており、南の県で学習したモデルが通用しない。KFold(shuffle=True, random_state=0) にすると各 fold の R² は 0.20〜0.40 に収まり平均 0.28 になるので、分け方が評価を大きく左右していることが分かる。
🐍 実装パターン集 — 状況別レシピ
同じ「真のプロセス」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。
パターン B:パイプライン化(前処理+モデル)
1 2 3 4 5 6 7 8 9 10 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('model', Ridge(alpha=1.0)), ]) pipe.fit(X_tr, y_tr) print('R^2 =', pipe.score(X_te, y_te)) |
💬 標準化してから Ridge(alpha=1.0) にすると、同じ 15 県の test で R² = 0.191 と、ランダムフォレスト(0.038)より高くなった。32 県という少ない学習データでは、深さ 4 の木 200 本より、直線 1 本の方が過学習しにくいということ。ただし 0.19 は出生率の分散の 2 割を説明したにすぎず、真の過程のうち人口規模の 3 列で説明できる部分は小さい。
パターン C:交差検証+ハイパーパラメータ探索
1 2 3 4 5 6 | from sklearn.model_selection import GridSearchCV params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} gs = GridSearchCV(pipe, params, cv=5, scoring='r2') gs.fit(X, y) print('best:', gs.best_params_, 'score:', gs.best_score_) |
💬 alpha を 0.01〜100 で探すと最良は 0.01 だが、その CV の R² は -0.923 とマイナスのままで、#10 の 0.191 は 1 回の分割でたまたま良かった値だと分かる。最良が探索範囲の端の 0.01 になっているのは、正則化を弱めても強めても改善しないというサインで、alpha ではなく説明変数(人口規模の実数ではなく率に直すなど)を見直す段階にある。
パターン D:可視化付きの結果保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt import json pred = gs.predict(X_te) plt.figure(figsize=(7,5)) plt.scatter(y_te, pred, alpha=0.7, edgecolor='k') plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--') plt.xlabel('実測'); plt.ylabel('予測'); plt.title('真のプロセス 結果') plt.tight_layout(); plt.savefig('result_true-process.png', dpi=150) with open('result_true-process.json', 'w', encoding='utf-8') as f: json.dump({'best_params': gs.best_params_, 'cv_score': gs.best_score_, 'test_score': gs.score(X_te, y_te)}, f, ensure_ascii=False, indent=2) |
⚠️ よくある落とし穴
⚠️ 真のプロセスを「誤推定する」7 つの落とし穴
① 観測パターン = 真のプロセス と誤解
「データにこういう関係が見えた」だけで「これが真の関係だ」と結論してしまう。 実際にはサンプリングノイズや偶然のパターンも多い。 仮説検定や交差検証で再現性を確認することが必須。
② 識別不能な状況での過信
多重共線性が強い場合、 個別の係数推定は不安定。 「人口と世帯数を両方使った回帰」では、 どちらの効果なのか識別できない。 VIF や 縮小推定 (ridge/lasso) で対応する。
③ 過学習による「真のプロセス」の過大評価
複雑なモデルで訓練データを完璧にフィットしても、 真のプロセスを推定したことにはならない。 テストデータで予測精度を確認するのが鉄則。
④ 過小学習による「真のプロセス」の過小評価
単純すぎるモデルは、 真のプロセスの構造を捉えきれない。 残差プロットで 系統的なパターンが見えたら、 モデルが過小学習している兆候。
⑤ 因果の取り違え
「相関」を「真の因果プロセス」と混同する。 相関は因果ではない。 因果プロセスを推定するには、 ランダム化試験、 自然実験、 因果推論手法 (Do 演算、 IV など) が必要。
⑥ 観測不可能な交絡変数の無視
真のプロセスを規定する変数のうち、 観測できないものがある場合、 それを無視すると偏った推定になる。 感度分析や代理変数の探索で対応する。
⑦ 時間的安定性の仮定
「過去の真のプロセス」と「未来の真のプロセス」が同じとは限らない。 構造変化(コロナ禍前後など)があれば、 過去データから推定したモデルは将来予測には使えない。 構造変化検定や ローリングウィンドウで対処。
🧪 真のプロセスを「知っている」状況で推定誤差を見る
実際の分析では真のプロセス $f^*$ は分かりません。 しかし学習目的として「真のプロセスが既知の状況」を考えると、 推定の難しさが見えてきます。 ここでは SSDSE-B-2026 の 2023 年断面データで、 小中規模県から学んだ関係を大規模県へ外挿する実験を行います。
実験: SSDSE-B-2026 を使った「外挿の難しさ」検証
「人口 500 万人未満の 38 県でモデルを訓練し、 500 万人以上の 9 都道府県で予測を検証」。 これは真のプロセスが人口規模を超えて同じであれば成功するはず。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv',
encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
# 小中規模県で学習し、大規模県へ外挿する
train = df[df['A1101'] < 5_000_000]
test = df[df['A1101'] >= 5_000_000]
slope, intercept = np.polyfit(train['A1101'] / 1_000_000,
train['I5102'], 1)
pred = slope * (test['A1101'].values / 1_000_000) + intercept
actual = test['I5102'].values
err = pred - actual
print('大規模県の予測誤差 (予測 - 実測):')
for pref, p, a in zip(test['Prefecture'], pred, actual):
print(f' {pref}: 予測 {p:.0f} / 実測 {a} / 誤差 {p-a:.0f}')
print(f'\n平均絶対誤差 (MAE): {np.abs(err).mean():.0f}')
|
🎯 このコードでやること: 小中規模県で真のプロセス(線形仮定)を推定し、 大規模県に外挿して誤差を測る。 真のプロセス推定の適用範囲を実感する。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県。 訓練は人口 500 万人未満の 38 県、 テストは 500 万人以上の 9 都道府県。
📤 実行結果:
💬 結果の読み方: 小中規模県から学んだ線形モデルは、 東京都を 4120 施設、 大阪府を 2132 施設ほど過小予測する。 つまり真のプロセスは「人口だけで一様」ではなく、 大都市の医療集積という別構造を含む可能性が高い。 外挿先の分布が訓練データと違うほど、 真のプロセスの取り違えが大きくなる。
📚 関連グループ教材
真のプロセスは 機械学習の基礎 と推測統計の両方の土台になる考え方である。 観測値が母集団のどの部分を映しているかは 母集団 と 標本抽出、 f*(x) と推定した関数のずれを分解するのが バイアス・バリアンス、 ずれが大きくなる典型が 過学習 で、 見ていないデータでの当たり具合が 汎化 である。 どのモデルが真のプロセスに近いかを選ぶ手続きは モデル選択、 観測された関係を因果と読んでよいかは 交絡 と 因果関係 へ進む。
📚 「真のプロセス」を巡る統計学の歴史的議論
「真のプロセスがある」という前提は古典統計学の根本ですが、 これに対しては歴史的に多くの議論がありました。
議論 1: George Box の名言 — 「全てのモデルは間違っている」
統計学者 George Box (1919-2013) は 「全てのモデルは間違っているが、 一部は有用である」 (All models are wrong, but some are useful) と述べました。 これは「真のプロセスを完全に表現するモデルは存在しない」「しかし近似として有用なモデルはある」という現実主義的立場。
議論 2: Fisher vs Neyman-Pearson
20 世紀前半、 R.A. Fisher と Neyman-Pearson の間で 仮説検定の哲学を巡る激しい論争がありました。 Fisher は「データから真のプロセスを推測する」、 Neyman-Pearson は「2 つの仮説を比較して意思決定する」という枠組み。 現代の検定はこの 2 つの折衷が一般的。
議論 3: ベイズ統計の復権
20 世紀後半まで頻度主義が主流でしたが、 計算機の発展により MCMC が実用化され、 ベイズ統計が復権。 「真のプロセスのパラメータを確率変数として扱う」という発想は、 現代の機械学習にも大きな影響を与えています (ベイズ推論、 変分推論など)。
議論 4: 因果推論の革命
Judea Pearl らによる因果推論の発展により、 「真のプロセス = 因果構造」という見方が広まりました。 単なる相関ではなく、 do() 演算で表される介入下のプロセスこそが真のプロセスだという立場。 これにより「真のプロセスとは何か」の議論がさらに深化しました。
💡 歴史を学ぶ意義: 「真のプロセス」概念は時代とともに変化してきた。 統計学を学ぶときは、 単に手法を覚えるだけでなく、 「なぜこの手法が必要になったか」の歴史的文脈を知ると、 用語の重みが深く理解できる。
🤖 真のプロセスと機械学習の関係
現代の機械学習は「真のプロセスは観測できないが、 観測データから学習する」というスタンス。 古典統計と何が違うのか整理しましょう。
古典統計 vs 機械学習の対比
| 観点 | 古典統計 | 機械学習 |
|---|---|---|
| 真のプロセスの仮定 | パラメトリック (線形等) | 最小限の仮定 |
| 主な目的 | パラメータの解釈 | 予測精度 |
| 過学習対策 | 仮説検定 | 交差検証、 正則化 |
| 不確実性表現 | 信頼区間 | 予測区間、 アンサンブル |
| 結論の語り方 | 統計的に有意 | テスト精度 X% |
深層学習における真のプロセスの近似
ニューラルネットワークの普遍近似定理によれば、 十分なパラメータを持つネットワークは 任意の連続関数を任意精度で近似できます。 これは「真のプロセスが連続関数なら、 ディープラーニングで近似可能」という強力な主張。 ただし、 学習に必要なデータ量とパラメータ数が爆発するため、 実用的には適切な構造仮定 (CNN, RNN, Transformer) が必要です。
💡 使い分けの指針: ① パラメータの解釈が重要 (例: 政策評価) → 古典統計 ② 予測精度が重要 (例: 推薦システム) → 機械学習 ③ どちらも重要なら、 両方を実装して結果を比較する。 「真のプロセスの近似」という観点では両者は補完的です。
🧪 真の過程の深掘り — 標本分布・母集団推定・サンプリングバイアス
真の分布 vs 標本分布 — 何が観測でき、 何が観測できないか
「真の過程」とは、 データを生成する未知の仕組み (確率分布 $p(x)$ や条件付き分布 $p(y|x)$) を指す。 我々が観測できるのは 真の分布から独立に抽出された有限個のサンプルであり、 真の分布そのものを直接観察することはできない。 標本分布 (sample distribution) は観測データのヒストグラムや経験分布関数で表され、 サンプルサイズ $n$ が大きくなるにつれて真の分布に収束する (大数の法則・グリベンコ=カンテリの定理)。
📐 グリベンコ=カンテリの定理 (一様収束)
経験分布関数 $F_n(x)$ が真の分布関数 $F(x)$ に一様収束することを保証する基本定理。
🔬 数式を言葉で読み解く
- $F_n(x)$ — 観測した $n$ 個のサンプルから作る経験分布関数 (「$x$ 以下のサンプル割合」)
- $F(x)$ — 真の累積分布関数 (見えない真の過程の出力)
- $\sup_x |F_n(x) - F(x)|$ — 全ての $x$ における差の最大値 (最悪のずれ)
- $\xrightarrow{a.s.}$ — 「確率 1 で収束する (almost surely)」
- 結論 — サンプルサイズを増やせば、 真の分布を任意の精度で近似できる
🐍 SSDSE-B-2026 で真の分布を推定する
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県の人口 (A1101) を「観測標本」とみなし、 真の人口分布を経験分布関数およびカーネル密度推定で近似する。
📥 入力データ (SSDSE-B-2026 から):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'].dropna().values # 2023 年 47 都道府県の総人口 # 経験分布関数 (ECDF) sorted_pop = np.sort(pop) ecdf = np.arange(1, len(sorted_pop)+1) / len(sorted_pop) # カーネル密度推定 (KDE) kde = stats.gaussian_kde(pop) x_grid = np.linspace(pop.min(), pop.max(), 200) density = kde(x_grid) print(f"観測標本数 n = {len(pop)}") print(f"標本平均 = {pop.mean():.0f} 人") print(f"標本中央値 = {np.median(pop):.0f} 人") print(f"KDE 推定の最頻値 ≈ {x_grid[np.argmax(density)]:.0f} 人") |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 平均 (264.6 万人) と中央値 (154.9 万人) が大きく乖離し、 KDE の最頻値は 142.2 万人付近。 これは真の人口分布が「右に大きく歪んだ分布 (東京・大阪などの巨大都市が右裾)」であることを示唆。 $n=47$ では真の分布の細部は把握しきれず、 「経験分布は真の分布の粗いスケッチ」と認識することが重要。
⚠️ サンプリングバイアス — 真の過程の歪んだ像
「真の過程」を理解しようとしても、 サンプリングがランダムでなければ標本分布は真の分布から系統的にずれる。 代表的なバイアス:
- 選択バイアス — 例: ウェブアンケートは「ネット利用者」の真の過程しか観測しない
- 生存バイアス — 例: 上場企業の業績データは「倒産していない企業」の真の過程に偏る
- 応答バイアス — 例: 政治調査で「意見のある人」だけが回答 → 中立層の真の過程は見えない
- 測定バイアス — 例: 古い気温計は系統的に低く出る → 真の気温過程の推定が偏る
💡 真の過程に近づく王道: ランダムサンプリング + サンプルサイズを増やす + バイアスを補正する重み付け推定 (例: Horvitz-Thompson estimator) + 複数の独立データソースで結果が再現するか検証する。
🖼 真の過程を 3 つの視点で「見る」 — 散布図・ヒストグラム・箱ひげ図
「真の過程 (true process)」は決して直接観測できない。 私たちが手にできるのは 有限個の標本と、そこから推測する 経験分布だけである。 ここでは SSDSE-B-2026 (47 都道府県、 全数調査に近い公的統計) を題材に、 3 種類の基本グラフが「真の過程のどの側面を映し出すか」を順に確認していく。 散布図は 2 変数間の関係、 ヒストグラムは 1 変数の分布の形、 箱ひげ図は 群間の中心と裾の比較を可視化する道具であり、 同じデータでも見る視点で映る「真の過程」は大きく変わる。
① 散布図 — 2 変数の真の関係を映す
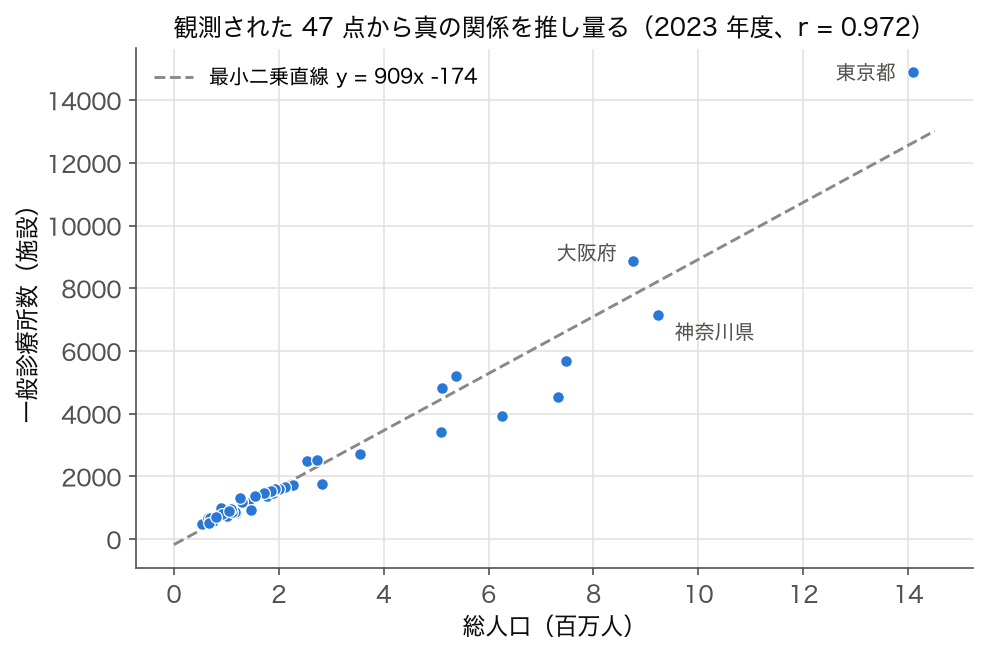
散布図は「真の過程が 2 変数間にどんな関数関係を生成しているか」を粗く推し量るための第一の道具である。 真の過程が線形 $y = a x + b + \varepsilon$ なら点群は直線状に並び、 真の過程が二次関数なら U 字や逆 U 字に、 真の過程が独立 (関係なし) なら点群は雲のように散らばる。 SSDSE-B-2026 では「総人口 ↔ 一般診療所数」($r=0.972$) や「総人口 ↔ 出生数」($r=0.995$) のように、 右上がりの直線的関係が見える組み合わせと、 「総人口 ↔ 合計特殊出生率」($r=-0.564$) のように方向が逆になる組み合わせが共存している。 散布図一枚で、 仮説の方向 (正/負/無相関/非線形) を秒で判別できる点が散布図の強みである。
ただし散布図にも限界がある。 (a) 点が重なる領域では密度が見えない (overplotting)、 (b) 外れ値 1 点で線形/非線形の印象が大きく変わる、 (c) 第三の交絡変数の影響を分離できない、 などである。 そのため、 真の過程の関係を主張する際は「散布図で当たりを付け → 相関係数や回帰係数で定量化 → 部分相関や層別散布図で交絡を切り分け」という 3 段階の手順が定石となる。 散布図は「真の過程を疑問形で問いかける装置」であり、 「真の過程を断定する装置」ではないことを強く意識しておきたい。
散布図で映る真の過程の代表パターン (SSDSE-B-2026 ベース)
| 変数ペア | 点群の形 | 真の過程の解釈 |
|---|---|---|
| 総人口 (A1101) × 一般診療所数 (I5102) | 右上がりの強い直線 ($r=0.972$) | 人口規模が医療施設数を強く規定する真の過程 |
| 総人口 (A1101) × 出生数 (A4101) | 右上がりの強い直線 ($r=0.995$) | 母数効果。 人口が多ければ出生数も多い |
| 総人口 (A1101) × 合計特殊出生率 (A4103) | 負の傾向 ($r=-0.564$) | 人口規模と出生率水準が同じ方向には動かない構造 |
| 高齢化率 (A1303/A1101) × 一般診療所数 (I5102) | 負の傾向 ($r=-0.671$) | 人口規模が小さく高齢化率が高い県ほど施設総数は少ない |
| 着工建築物 (C3301) × 総人口 (A1101) | 右上がりの強い直線 ($r=0.964$) | 人口規模が建築活動量と連動する真の過程 |
| 婚姻件数 (A9101) × 出生数 (A4101) | 右上がりの強い直線 ($r=0.991$) | 家族形成イベントと出生数が同じ規模要因を共有する |
この表が示すように、 散布図 1 枚だけでは「真の過程が線形か非線形か」「外れ値の影響はどの程度か」までは厳密に評価できない。 そこで実務では、 (1) 散布図 + 回帰直線、 (2) 散布図 + 等高線 (KDE)、 (3) 散布図行列 (pairplot)、 の 3 段階で順に詳細化していく。 とくに散布図行列は「真の過程が多変数のどこに潜んでいるか」を網羅的に探す探索的解析 (EDA) の主役であり、 SSDSE-B-2026 の 30+ 列に対しても定番として使われる。
散布図のチェックリスト
| 確認項目 | 狙い | 真の過程との関係 |
|---|---|---|
| 軸スケール (線形/対数) | 裾の長い分布を視認可能に | 対数軸で線形に見えれば真の過程は乗法的 |
| 外れ値の位置と数 | 東京・大阪のような巨大都市の影響 | 外れ値除外で傾きが変わるなら真の過程は不均一 |
| 点の密度 (overplotting) | 重なる領域の本当の集中度 | 密度の山が真の過程の最頻領域を示す |
| 色分け (第三変数) | 層別による交絡の可視化 | 層ごとに傾きが異なれば交互作用が真の過程に存在 |
| 等高線/回帰曲線 | 非線形性の有無 | 曲線なら真の過程は非線形関数 |
| 残差の分布 | 分散の一様性 | 残差が偏れば真の過程は等分散仮定を破る |
② ヒストグラム — 1 変数の真の分布形を映す
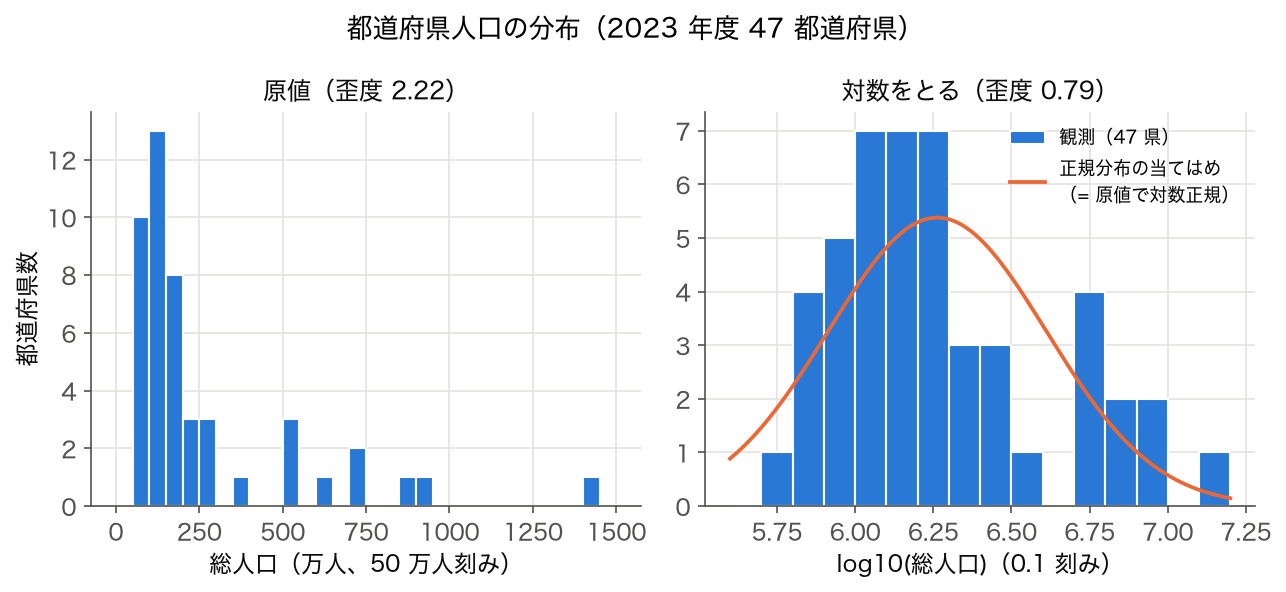
ヒストグラムは「真の過程が生み出す 1 変数の分布形」を視覚化する最重要ツールである。 散布図が「関係性」を見るなら、 ヒストグラムは「分布の形そのもの」を見るための装置である。 真の確率密度関数 $f(x)$ を直接観測することはできないが、 標本のヒストグラムを描けば $f(x)$ の階段近似が得られる。 ビン幅を細かくすればするほど真の密度に近づくが、 同時に各ビンに入る観測数が少なくなって推定がギザギザになる。 これがヒストグラムの宿命的トレードオフであり、 ビン幅選択ルール (Sturges, Scott, Freedman-Diaconis) はこのトレードオフの自動化を目指したものである。
SSDSE-B-2026 の「都道府県人口」変数を例にとると、 ヒストグラムは明確な 右裾の長い (right-skewed) 分布を示す。 多数の県は 100 万人前後の山にまとまっており、 東京・神奈川・大阪などごく少数の県だけが 800 万人以上の右裾に飛び出す。 対数をとると歪度は 2.22 から 0.79 まで下がり、 右裾の長さの大半は「掛け算で効く過程」(対数正規分布など) で説明できる。 ただし log10 でも Shapiro-Wilk 検定は p = 0.006 で、 図 2 右のように 6.0〜6.3 の山と 6.7〜7.0 の大都市圏の塊が分かれて見えるので、 47 県が 1 つの対数正規分布から出たとまでは言えない。 都市規模の分布を比例成長 (Gibrat の法則) や Zipf 則で説明する議論は主に都市単位のもので、 県単位の 47 個でそれを確かめるには数が足りない。 もしヒストグラムが左右対称の釣鐘型なら正規分布に近い真の過程、 二峰なら異質な 2 集団の混合過程、 一様に近ければランダム発生過程、 と「形」から真の過程の種類を推測できる。
ヒストグラム形状と真の過程の型
| 分布の形 | 典型例 | 真の過程の型 |
|---|---|---|
| 左右対称 釣鐘型 | 身長、 IQ | 多数の独立要因の加算 (中心極限定理) |
| 右裾が長い | 所得、 都市人口、 売上 | 乗法的成長過程 (対数正規) |
| 左裾が長い | 成績テストの上限張り付き | 上限のある到達過程 (天井効果) |
| 二峰 (bimodal) | 男女混合の身長 | 2 つの異質な集団の混合 |
| 一様 (ほぼ平ら) | 乱数、 円周率の各桁 | 独立等確率の発生過程 |
| 離散の山 | サイコロの目、 子どもの数 | 離散値しか取らない真の過程 |
| U 字 | 1 日の交通量 (朝夕ピーク) | 2 つの周期的ピークを持つ過程 |
| 長い右裾 + 多数ゼロ | 地震マグニチュード、 保険金額 | ゼロ過剰の重い裾過程 (Zero-inflated) |
ヒストグラムを真の過程の推定器として使うときの落とし穴は主に 3 つ。 (1) ビン幅依存性: 同じデータでもビン幅を変えると一峰に見えたり二峰に見えたりする。 (2) 端点問題: 最小値・最大値付近のビンは観測数が少なくノイズに弱い。 (3) サンプル不足: $n < 30$ ではヒストグラムは真の密度の信頼できる近似にはならず、 KDE や正規近似の方が安定するケースがある。 これらを回避するために、 SSDSE-B-2026 のような $n = 47$ の小標本では、 ビン幅を 2-3 通り変えて頑健性を確認する、 もしくはヒストグラム + KDE を重ねて描く、 という慣行が定着している。
ビン幅選択ルールの早見表
| ルール | 式 | 適用場面 |
|---|---|---|
| Sturges | $k = \lceil \log_2 n + 1 \rceil$ | 正規分布に近い小〜中標本 ($n \le 200$) |
| Scott | $h = 3.5 \sigma / n^{1/3}$ | 正規に近く $n$ が大きい場合 |
| Freedman-Diaconis | $h = 2 \cdot \mathrm{IQR} / n^{1/3}$ | 裾が長い・外れ値のあるデータ |
| Rice | $k = \lceil 2 n^{1/3} \rceil$ | 簡便。 自動 EDA |
| Square-root | $k = \lceil \sqrt{n} \rceil$ | Excel デフォルト。 教育用途 |
| Doane | Sturges + 歪度補正 | 非対称な分布 |
③ 箱ひげ図 — 群間の真の中心と裾を比較する
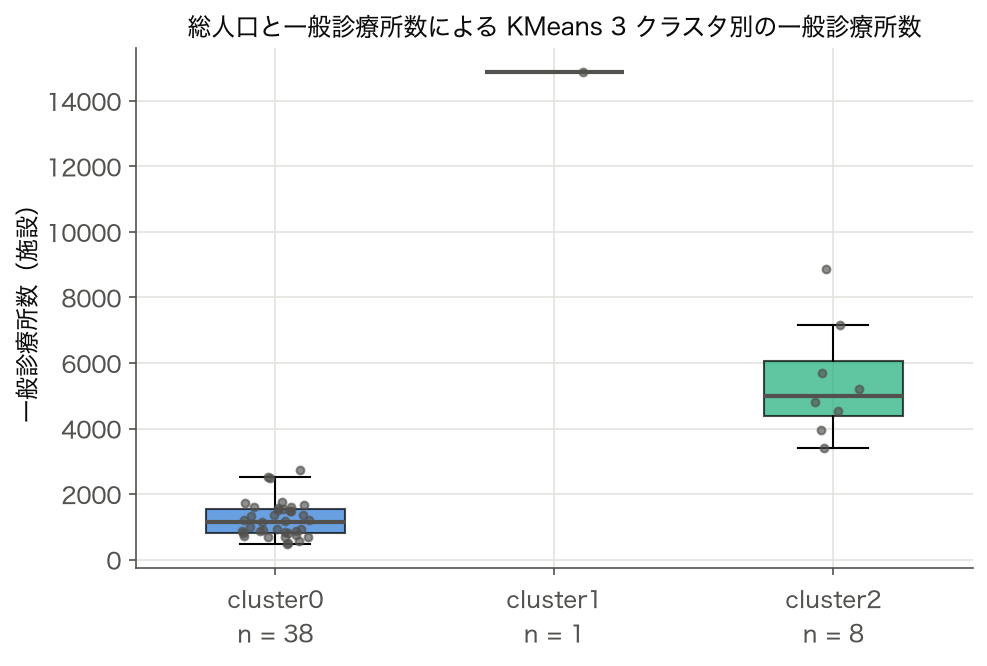
箱ひげ図 (boxplot) は「真の過程が群ごとにどう違うか」を比較するための圧縮表現である。 ヒストグラムは 1 変数の分布形を詳しく見るのに対し、 箱ひげ図は 中央値・四分位範囲・外れ値という要約統計量だけを取り出し、 多数の群を横並びで比較できる利点を持つ。 図 3 では SSDSE-B-2026 (2023 年度) の総人口 (A1101) と一般診療所数 (I5102) から KMeans で 3 群に分け、 一般診療所数の箱ひげを描いている。 東京都が単独の cluster1 として突出し、 大都市圏 8 道府県の cluster2 は中央値 5001 施設、 残る 38 県の cluster0 は中央値 1159 施設で、 医療施設数の真の過程が人口規模と都市集積に強く依存することが見える。
箱ひげ図の優れた点は、 (a) 平均値ではなく 中央値を中心に置くため外れ値に頑健、 (b) IQR (四分位範囲) を箱の長さで表現するため分布の広がりを直感的に把握できる、 (c) 群数が 10 を超えても並べやすく、 探索的解析の主力になる、 という 3 点である。 一方で限界は、 (1) 分布が二峰の場合は箱ひげでは見抜けない (中央値は谷に来る)、 (2) サンプル数の少ない群と多い群が同じ大きさの箱で並ぶため $n$ 情報が落ちる、 (3) 外れ値の判定基準 ($Q3 + 1.5 \cdot \mathrm{IQR}$) がやや恣意的、 などである。 そのため、 箱ひげ図はヒストグラム or バイオリンプロットと併用するのが現代的な作法となっている。
箱ひげ図で読み取れる真の過程の差
| 比較対象 | 箱ひげで見える特徴 | 真の過程の解釈 |
|---|---|---|
| KMeans クラスタ × 一般診療所数 (I5102) | 東京都が単独で 14894 施設 | 首都機能と人口集中が施設数を押し上げる真の過程 |
| 大都市圏クラスタ × 一般診療所数 (I5102) | 8 道府県の中央値が 5001 施設 | 人口規模の大きい地域で施設総数も大きい |
| 地方中心クラスタ × 一般診療所数 (I5102) | 38 県の中央値が 1159 施設 | 小規模県では施設総数が低い範囲に集まる |
| 地域ブロック × 高齢化率 (A1303/A1101) | 東北の中央値 35.09%、四国の中央値 34.78% | 地方ほど高齢化が進む真の過程 |
| 地域ブロック × 合計特殊出生率 (A4103) | 九州沖縄の中央値 1.475、北海道 1.060 | 出生率の地理勾配が残る |
| 地域ブロック × 総人口 (A1101) | 関東の中央値 625.7 万人、四国の中央値 81.1 万人 | 人口規模そのものが地域ブロックで大きく異なる |
真の過程を「群間で比較する」とき、 箱ひげ図は同時に複数の問いに答えてくれる。 (1) 中心がずれているか → 中央値の高低を見る。 (2) ばらつきが違うか → 箱の長さ (IQR) を比較する。 (3) 裾の形が違うか → 上下のひげの長さと外れ値の数を比較する。 (4) 非対称か → 中央値が箱の中心からずれていれば歪み。 この 4 視点で群間差を読み解くと、 「平均値だけを比較する t 検定」では見落とすパターンが多数あらわになる。 たとえば「平均は同じだが分散が違う」 (Welch の問題)、 「平均は同じだが片群だけ二峰」 (混合分布) などである。
④ 3 視点を組み合わせて真の過程を立体的に捉える
散布図・ヒストグラム・箱ひげ図はそれぞれ「関係 / 形 / 群差」という別々の側面を映す。 真の過程は一枚の絵では捉えきれず、 必ず複数の視点を組み合わせる必要がある。 たとえば「総人口と一般診療所数」の真の過程を理解したい場合、 (a) 散布図で「強い右上がり ($r=0.972$)」を確認し、 (b) 人口ヒストグラムで「右裾の長い分布」を確認し、 (c) KMeans クラスタ別箱ひげで「東京都の単独突出と大都市圏クラスタの上振れ」を確認する、 という 3 段階で初めて「人口規模 + 都市集積」という真の過程モデルが浮かび上がってくる。
3 種類の図の役割分担まとめ
| 図の種類 | 主な目的 | 強み | 弱み |
|---|---|---|---|
| 散布図 | 2 変数の関係を見る | 関係の方向・形が直感的 | 密度・第 3 変数を見落としやすい |
| ヒストグラム | 1 変数の分布形を見る | 裾・歪み・峰の数が見える | ビン幅依存。 小標本に弱い |
| 箱ひげ図 | 多群の中心と裾を比較 | 外れ値に頑健。 群数が多くても並ぶ | 二峰や正確な分布形は隠れる |
| 散布図 + 回帰直線 | 関係を定量化 | 傾き・切片を読める | 非線形だと誤誘導 |
| ヒストグラム + KDE | 滑らかな密度推定 | ビン依存を緩和 | バンド幅選択が必要 |
| 箱ひげ + ストリップ | 群差 + 個別点を両立 | $n$ 情報が見える | 群が多いと混雑 |
⑤ 図を描く実コード (Python, SSDSE-B-2026)
このコードでやること: SSDSE-B-2026 から「総人口 (A1101)」と「一般診療所数 (I5102)」を読み込み、 散布図・ヒストグラム・クラスタ別箱ひげ図の 3 種を順に描いて真の過程を立体的に観察する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import matplotlib.pyplot as plt import os from sklearn.cluster import KMeans # 英字の項目コード(A1101 など)を使うので、2 行目の日本語名を読み飛ばす df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'] / 1_000_000 # 百万人 clinics = df['I5102'] clusters = KMeans(n_clusters=3, random_state=0, n_init=10).fit_predict( df[['A1101', 'I5102']] ) fig, axes = plt.subplots(1, 3, figsize=(15, 4)) axes[0].scatter(pop, clinics, alpha=0.7, color='#1976D2') axes[0].set_title('散布図: 総人口 × 一般診療所数') axes[1].hist(pop, bins=15, color='#FF7043', edgecolor='black') axes[1].set_title('ヒストグラム: 総人口分布') groups = [df.loc[clusters == k, 'I5102'] for k in sorted(set(clusters))] axes[2].boxplot(groups, tick_labels=[f'cluster{k}' for k in sorted(set(clusters))]) axes[2].set_title('箱ひげ図: クラスタ別 一般診療所数') plt.tight_layout() os.makedirs('figures', exist_ok=True) plt.savefig('figures/true_process_3views.png', dpi=120) print(f'相関係数={pop.corr(clinics):.3f}') print(f"人口平均={df['A1101'].mean():.0f}, " f"中央値={df['A1101'].median():.0f}, 最大値={df['A1101'].max():.0f}") |
📤 実行例:
💬 結果の読み方: 3 つの図がそれぞれ別の側面を映し出す。 散布図は「総人口と一般診療所数は強く正の関係」、 ヒストグラムは「人口分布が右に歪む」、 箱ひげ図は「東京都と大都市圏クラスタが他県と質的に異なる」と語る。 単一の図に頼らず、 3 視点を統合することで初めて「人口規模 + 都市集積」という真の過程モデルに到達できる。
⑥ よくある誤解と回避策
真の過程の可視化は「グラフが描けたら終わり」ではない。 むしろグラフの解釈で誤ることが多い。 代表的な誤解は次の通り。
- 散布図で相関がないように見える → 関係がない、 と即断する: 実は非線形 (U 字、 周期) かもしれない。 必ずヒストグラム + 残差プロットで補完する。
- ヒストグラムが釣鐘型 → 正規分布だと決めつける: Shapiro-Wilk や Q-Q プロットで形式的に確認する。 SSDSE のような小標本では釣鐘に見えても裾が重い場合がある。
- 箱ひげ図の中央値が同じ → 群差なし、 と結論する: ばらつき (IQR) や外れ値の数が違えば真の過程は違う。 Levene 検定で分散差も確認する。
- 外れ値を機械的に除外する: SSDSE における東京は「外れ値」ではなく「真の過程の重要構成要素」。 除外すると首都集中という真の過程を見落とす。
- ビン幅を変えずに 1 通りで判断する: ヒストグラムの印象はビン幅で激変する。 必ず 2-3 通り試して頑健性を確認する。
- 散布図に第三変数を入れない: 色分けや層別で交絡変数の影響を可視化しないと、 シンプソンのパラドックスに陥る。
💡 3 視点ワークフロー: ① 散布図で「関係の方向と形」を当たり付け → ② ヒストグラムで「両変数の分布形」を点検 → ③ 箱ひげ図で「層別/群差」を確認 → ④ 必要なら散布図 + 等高線、 ヒストグラム + KDE、 箱ひげ + ストリップで詳細化。 この 4 段階を踏めば、 真の過程の主要な姿はほぼ捉えられる。 残るのは因果推論 (DAG, 自然実験) という別レベルの仕事。
⑦ 真の過程と「推定」のあいだ — 図から数式モデルへ
3 種類の図で真の過程の姿を捉えたら、 次の段階は「数式モデルへの翻訳」である。 散布図で右上がりの直線が見えたら線形回帰 $y = \beta_0 + \beta_1 x + \varepsilon$ を当てはめ、 ヒストグラムが右裾の長い形なら対数正規分布 $\log Y \sim \mathcal{N}(\mu, \sigma^2)$ を仮定し、 箱ひげ図で群差が見えたら混合効果モデル $y_{ij} = \alpha_i + \beta x_{ij} + \varepsilon_{ij}$ を考える。 真の過程を完全に再現する数式は決して書けないが、 「観測されたデータと矛盾しない最良近似」としてのモデルを構築するのが統計学の核心である。
SSDSE-B-2026 を用いた具体例で言えば、 (a) 散布図で「総人口 vs 一般診療所数」が直線的だと確認、 (b) ヒストグラムで「人口分布が右裾」と確認、 (c) 両軸を対数変換すれば散布図がより直線的になることを確認、 (d) $\log(\text{一般診療所数}) = a + b \cdot \log(\text{総人口}) + \varepsilon$ という対数線形モデルを当てはめる。 実CSVでは $b=0.966$、 $R^2=0.968$ なので、 「施設数は人口規模にほぼ比例するが、 都市集積や医療圏の効果が残差に残る」 という具合に真の過程に関する仮説検証へ進める。
図から数式モデルへの対応表
| 図で見えるパターン | 対応する数式モデル | 真の過程の名前 |
|---|---|---|
| 散布図が直線 | $y = \beta_0 + \beta_1 x + \varepsilon$ | 線形回帰過程 |
| 散布図が曲線 (U 字) | $y = \beta_0 + \beta_1 x + \beta_2 x^2 + \varepsilon$ | 多項式回帰過程 |
| 両対数で直線 | $\log y = a + b \log x + \varepsilon$ | べき乗則過程 |
| ヒストグラム釣鐘型 | $X \sim \mathcal{N}(\mu, \sigma^2)$ | 正規過程 |
| ヒストグラム右裾 | $\log X \sim \mathcal{N}(\mu, \sigma^2)$ | 対数正規過程 |
| ヒストグラム二峰 | $f(x) = \pi_1 f_1(x) + \pi_2 f_2(x)$ | 混合分布過程 |
| 箱ひげで群差 | $y_{ij} = \alpha_i + \varepsilon_{ij}$ | 一元配置 ANOVA 過程 |
| 箱ひげで群差 + 共変量 | $y_{ij} = \alpha_i + \beta x_{ij} + \varepsilon_{ij}$ | 共分散分析 (ANCOVA) 過程 |
⑧ 真の過程と確率分布 — 「過程」が「分布」を生む
真の過程は時間的・空間的に展開する「メカニズム」であり、 確率分布はその過程が定常状態で生み出す観測値の「スナップショット」である。 真の過程と確率分布の対応は次のように整理できる。
真の過程と帰結分布の対応 (代表例)
| 真の過程 | 結果の分布 | 例 |
|---|---|---|
| 多数の独立要因の加算 | 正規分布 | 身長、 測定誤差 |
| 多数の独立要因の乗算 | 対数正規分布 | 所得、 売上、 都市人口 |
| 稀な事象の到着 | ポアソン分布 | 1 日の地震回数、 窓口到着客数 |
| 成功率一定の試行回数 | 二項分布 | 10 回打席のヒット数 |
| 最初の成功までの待ち時間 | 幾何分布 / 指数分布 | 顧客が次に来るまでの時間 |
| 大きさが大きさに比例 | べき乗則 (Pareto) | 地震マグニチュード、 都市規模 |
| 独立同分布の最大値 | 極値分布 (Gumbel など) | 年最大降水量、 年最高気温 |
| カテゴリ別に独立試行 | 多項分布 | 選挙の得票分布 |
これらの対応を覚えておくと、 ヒストグラムの形を見ただけで「裏側にどんな真の過程が動いているか」をある程度推測できる。 SSDSE-B-2026 の都道府県人口が対数正規っぽい形をしているなら、 その背後には「乗法的成長 (Gibrat 過程)」が動いている可能性が高い、 という推論ができる。 これが「分布の形から真の過程を逆推定する」という統計推論の醍醐味である。
⑨ 真の過程の安定性と非定常性
これまで真の過程を「時間によらず一定」と暗黙に仮定してきたが、 現実には真の過程自体が時間とともに変化する場合がある。 これを 非定常 (non-stationary) な真の過程と呼ぶ。 たとえば出生率の長期系列を考えると、 過去の高出生率期と現在の低出生率期では真の過程 (社会構造・経済環境・価値観) が大きく異なっており、 単純に過去のデータで未来を予測することはできない。
真の過程の非定常性を扱う代表的手法は次の通り。 (1) 時間ウィンドウ法: 過去 5 年間など短期窓だけを使う。 (2) 状態空間モデル: 真の過程のパラメータが時間とともに変化することを明示モデル化する。 (3) 変化点検出: 真の過程が切り替わったタイミングを統計的に検出する。 (4) 因果機械学習: 真の過程の構造を DAG で表し、 介入時の挙動を推論する。 いずれも「真の過程は固定された 1 個の分布ではなく、 時間とともに変化する一連の分布」であることを前提に置く。
真の過程の定常性チェック項目
| 性質 | 検査方法 | 非定常時の対処 |
|---|---|---|
| 平均が一定か | 時系列平均の窓ごと比較 | 差分・トレンド除去 |
| 分散が一定か | ローリング分散の可視化 | 対数変換、 GARCH モデル |
| 自己相関構造が一定か | ACF を区間別に比較 | 状態空間モデル、 季節調整 |
| 分布形が一定か | Kolmogorov-Smirnov の窓別検定 | 変化点検出 |
| 外的ショックの有無 | イベント前後で平均比較 | 介入分析、 中断時系列分析 |
| 季節性の有無 | FFT、 自己相関のピーク | 季節差分、 SARIMA |
⑫ 真の過程と「データ生成モデル」の用語整理
統計学・機械学習の文献では、 「真の過程 (true process)」と類義の用語が複数登場する。 ここで主要な用語を整理し、 それぞれのニュアンスの違いを明確にしておく。 (1) 真の過程 (true process / true underlying process): 観測の背後で実際にデータを生み出している自然・社会のメカニズム全体。 (2) データ生成過程 (data generating process, DGP): 計量経済学で頻出。 観測データを生み出す確率モデルとしての真の過程。 (3) 母集団分布 (population distribution): 真の過程が定常状態で生み出す観測値の確率分布。 (4) 真のモデル (true model): 真の過程を完全に記述する仮想的な関数形 (実際には書けない)。 (5) ベイズ最適モデル (Bayes optimal): 真の過程に対して期待損失を最小化する仮想モデル。
これらの用語の使い分けは文脈次第だが、 共通する核心は「データの背後に存在し、 直接観測できない理想的な実在」を指している点である。 我々が観測できるのは常にサンプルという有限・ノイズ混じりの窓だけであり、 真の過程に直接アクセスする方法は存在しない。 この「観測されえないものを推定する」という哲学的な構図が、 統計学を他の分野と区別する最大の特徴である。
類義語の比較表
| 用語 | 主な使用分野 | 強調する側面 |
|---|---|---|
| 真の過程 (true process) | 統計学全般・教育 | 背後のメカニズム |
| データ生成過程 (DGP) | 計量経済学 | 確率モデルとしての定式化 |
| 母集団分布 | 推測統計学 | 定常状態の分布形 |
| 真のモデル | 機械学習 | 仮想的な関数形 |
| ベイズ最適 | 機械学習理論 | 達成可能な最良誤差 |
| 真の関数 $f^*(x)$ | 回帰理論 | 条件付き期待値 |
| 母数 (parameter) | パラメトリック統計 | 分布を支配する定数 |
| 仮想無限母集団 | R.A. Fisher 流 | サンプリングの枠組み |
⑬ 真の過程を扱う Python ライブラリ早見表
真の過程を推定・可視化・モデル化するための Python エコシステムは充実している。 基本ツール群を整理しておく。
| ライブラリ | 主用途 | 真の過程との関係 |
|---|---|---|
| pandas | データ読込・整形 | 標本データの管理 (真の過程の窓) |
| numpy | 数値計算 | 標本統計量の計算 |
| matplotlib | 基本可視化 | 3 種類の図 (散布/ヒスト/箱) を描画 |
| seaborn | 統計可視化 | FacetGrid・pairplot で層別図 |
| scipy.stats | 確率分布・検定 | 真の分布の当てはめ・検定 |
| statsmodels | 計量経済モデル | OLS・GLM・時系列で DGP を推定 |
| scikit-learn | 機械学習 | 真の関数の関数近似 |
| pymc | ベイズ推論 | 事後分布で真の過程を推定 |
このコードでやること: pandas + matplotlib で SSDSE-B-2026 の総人口と一般診療所数の 3 視点 (散布図・ヒスト・箱ひげ) を 1 枚にまとめる、 真の過程理解の標準ワークフロー。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import matplotlib.pyplot as plt import os df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'] clinics = df['I5102'] fig, axes = plt.subplots(1, 3, figsize=(15, 4)) axes[0].scatter(pop, clinics, alpha=0.7, color='#1976D2') axes[0].set_title('散布図: 人口 × 一般診療所数') axes[1].hist(pop, bins=15, color='#FF7043', edgecolor='black') axes[1].set_title('ヒスト: 人口分布') axes[2].boxplot([pop], tick_labels=['人口']) axes[2].set_title('箱ひげ: 人口') plt.tight_layout() os.makedirs('figures', exist_ok=True) plt.savefig('figures/true_process_3views_pop.png', dpi=120) print(f'平均={pop.mean():.0f}, 中央値={pop.median():.0f}, 最大値={pop.max():.0f}') |
📤 実行例:
💬 結果の読み方: 平均 (265 万) と中央値 (155 万) の大きな乖離、 最大値 (1409 万) の突出が、 「真の過程は右に大きく歪んだ分布」であることを示している。 散布図・ヒスト・箱ひげの 3 視点を合わせて初めて、 この姿が立体的に見える。
🔚 本セクションの要点: 真の過程は (a) 直接観測できない、 (b) 3 種類の基本図で間接的に推測する、 (c) 図から数式モデルへ翻訳して定量化、 (d) 複数視点・複数時点・第三変数で頑健性を担保、 (e) 「すべてのモデルは間違っているが有用」と謙虚に扱う、 という 5 原則を守れば、 統計的思考の土台が完成する。
⑭ 真の過程の理解度を高める Q&A
真の過程の概念は抽象的なため、 多くの学習者が同じ箇所でつまずく。 ここでは頻出する疑問を Q&A 形式で整理しておく。
Q1. 真の過程を「測定誤差」と「ランダム性」のどちらと考えるべきか?
A1. 両方含む。 真の過程は (a) 系統的に観測値を生み出す決定論的部分 (構造) と、 (b) 観測ごとに変動するランダム部分 (ノイズ・誤差) の和として表現されることが多い。 数式では $Y = f(X) + \varepsilon$ と書き、 $f(X)$ が真の関数、 $\varepsilon$ がランダム部分。 SSDSE-B-2026 の人口の場合、 $f$ は「県ごとの構造的人口規模」、 $\varepsilon$ は「年次の小さな変動」と解釈できる。
Q2. 母集団が有限 (47 都道府県) なら真の過程はないのでは?
A2. それは Fisher が「仮想無限母集団 (hypothetical infinite population)」の概念で乗り越えた問題。 47 都道府県は「ある社会経済プロセスが現時点で生み出した 47 個のスナップショット」と見なす。 同じ社会経済プロセスが別の歴史を辿れば、 違う 47 個が観測されたかもしれない。 その「ありえた観測の集合」全体が仮想無限母集団であり、 そこから 1 通りが実現したのが現在の SSDSE-B-2026 と解釈する。
Q3. 真の過程と「因果関係」は同じか?
A3. 別物。 真の過程は「観測がどう生み出されたか」のメカニズムで、 因果関係は「ある変数を変えたら別の変数がどう変わるか」の関係。 真の過程の理解は因果推論の必要条件だが十分条件ではない。 観察データから真の過程の姿は推定できても、 因果の方向 (X→Y か Y→X か) は通常追加の仮定 (DAG, 自然実験, 介入実験) なしには決められない。
Q4. なぜ 3 種類の図にこだわるのか? もっと多くの図を使うべきでは?
A4. 「散布図 / ヒストグラム / 箱ひげ図」が EDA の最小セットだから。 散布図は 2 変数関係、 ヒストグラムは 1 変数分布、 箱ひげ図は群間比較、 という 3 つの基本的な問いに対応する。 この 3 つを徹底すれば真の過程の主要側面は捉えられる。 もちろん追加で「散布図行列、 等高線、 ヒートマップ、 バイオリンプロット、 Q-Q プロット、 ECDF プロット」などを使うとさらに詳細化できるが、 まずは 3 種類の基本を徹底することが教育的に最重要である。
Q5. 機械学習では「真の過程」より「予測精度」が大事では?
A5. 短期的にはそうだが、 長期的・運用フェーズでは真の過程の理解が決定的に重要になる。 真の過程を理解せずに予測精度だけ追求すると、 (a) データドリフト時にモデルが急速に劣化する、 (b) なぜ予測が外れたか説明できない (説明責任が果たせない)、 (c) 介入時の挙動を予測できない、 という重大なリスクが残る。 一流の機械学習エンジニアは予測精度と真の過程理解を両輪で進める。
📖 追加学習リソース: 真の過程・データ生成過程・確率モデルの関係をさらに深く学ぶには、 Hastie-Tibshirani-Friedman "The Elements of Statistical Learning"、 Wasserman "All of Statistics"、 久保拓弥「データ解析のための統計モデリング入門」(緑本) の前半が定番。 これらの書籍はいずれも「観測の背後にある真の過程をどう推定するか」という共通の問いに取り組んでいる。
⑮ 補論: 真の過程と「再現性危機」
心理学・医学・経済学などで指摘されている「再現性危機 (replication crisis)」は、 突き詰めると「研究者が報告した結果は真の過程を反映しているのか、 それともサンプリングの偶然や p ハッキングの産物なのか」という問いに帰着する。 再現性が低い研究の典型的特徴は、 (a) 単一視点 (散布図のみ等) で結論を出している、 (b) サンプルサイズが小さい、 (c) 有意な結果だけを報告 (出版バイアス)、 (d) 探索的解析と仮説検証を区別していない、 などである。 これらは全て「真の過程の推定に対する謙虚さの欠如」から生じる。
再現性危機を乗り越えるための処方箋は、 (1) 事前登録 (preregistration): 分析手順をデータ収集前に公開、 (2) 多重比較補正: Bonferroni 補正や FDR 制御、 (3) 効果量とその信頼区間の報告: p 値だけでなく実質的な大きさを示す、 (4) 独立データセットでの再現確認: 別チームによる追試、 (5) ベイズ推論の併用: 事後分布で結果の頑健性を可視化、 など複合的に行う。 真の過程の理解は単発の論文では完結せず、 多数の研究者による検証の積み重ねによって少しずつ近づくものである。
再現性を高める実務チェックリスト
| 段階 | チェック項目 | 真の過程との関係 |
|---|---|---|
| 研究計画 | 事前登録、 サンプルサイズ設計 | 真の過程推定の精度を確保 |
| データ収集 | ランダムサンプリング、 バイアス記録 | 真の過程の歪んだ像を回避 |
| 探索的解析 | 3 種類の図を全部描く | 真の過程を立体視 |
| 確証的解析 | 事前登録した検定を実行 | 多重比較で真の過程を見誤らない |
| 結果報告 | 効果量・信頼区間・コード公開 | 第三者が真の過程推定を検証 |
| 追試 | 独立データで再現確認 | 真の過程の頑健性を担保 |
🌍 真の過程と社会的責任: 統計学・データサイエンスが社会的に重要になるにつれ、 「真の過程」の推定結果は政策・医療・教育の現場で実際の意思決定に使われるようになっている。 推定が誤っていれば、 多数の人々に不利益をもたらす。 だからこそ、 散布図・ヒストグラム・箱ひげ図の 3 視点を徹底し、 再現性を担保し、 結果の限界を正直に伝える姿勢が、 単なる「分析者の良心」ではなく「社会的責任」として求められる。 SSDSE-B-2026 を題材に練習を積みながら、 この責任感も同時に育てていきたい。
🗺 概念マップ
「真のプロセス」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 統計モデリング / 因果推論 | DGP (データ生成過程) を扱う大枠 |
| 南 (下位) | 線形回帰 / GLM / 状態空間モデル | 真のプロセスを近似する具体モデル |
| 東 (発展) | 構造方程式モデル (SEM) / DAG / SCM | 関係を構造として記述する発展形 |
| 西 (前提) | 確率分布 / 残差解析 / 仮説検定 | 真のプロセスの理解に必要な土台 |
| 中央 | 真のプロセス | 本ページの主役 |
🔗 隣接手法への橋渡し
「真のプロセス」(データ生成過程 DGP) は統計モデリングの起点で、 上流の仮定・下流の検証と直結する。
- 上流: 領域知識 から f(x) の形を仮説化 (人口減少なら指数減衰?) → DAG (有向非巡回グラフ) で因果構造を視覚化 → モデル指定
- 並列: 観測データ (DGP からのサンプル)、 推定モデル f̂(x) (DGP の近似)、 反事実 (counterfactual)
- 下流: 残差プロット で DGP との乖離検出 → モデル誤指定 診断 → バイアス-バリアンス 分解で誤差源を特定
SSDSE-B-2026 の人口データの「真のプロセス」は、 出生率・死亡率・移動率の連立微分方程式 (コーホート要因法) で記述される。 これを線形回帰で近似すると DGP との乖離 = バイアス、 観測ノイズ = バリアンスとなる。
🌳 手法選択フロー
真のプロセスをどう扱うかは、 情報量と目的で 4 通りに分岐する。
- DGP の理論があり既知? Yes → パラメトリックモデル (理論式 + パラメータ推定)。 物理学・経済学の構造モデル
- DGP は未知だが滑らか? Yes → ノンパラメトリック (カーネル回帰・スプライン)。 関数形を仮定せず推定
- DGP は複雑 + データ豊富? Yes → RF / NN。 表現力で DGP を近似
- DGP の因果構造を知りたい? Yes → 因果推論 (DAG + DID + IV)。 介入効果を分離
SSDSE-B-2026 で「子育て支援 → 出生率」を分析する場合、 単なる相関ではなく DGP (政策 → 経済 → 出生意思 → 出生率) を DAG で明示してから因果推論に進むのが王道。
📝 補足: 「真のプロセス」をもう一段深く
本セクションは既存の解説を壊さずに追記した「深掘りノート」です。 直感・落とし穴・発展の 3 本立てで、 上のウィジェットや数式で扱った内容を別の角度から言い直します。
💡 直感: 私たちが見ているのは「本体」ではなく「影」
観測データの背後には、 直接は覗けない 真のデータ生成過程 (DGP: Data-Generating Process) があります。 データはその DGP が吐き出した「影」であり、 モデルはその影から本体を逆算しようとする 近似装置にすぎません。 だからこそ統計学者 George Box の 「全てのモデルは間違っているが、 一部は有用である」 (All models are wrong, but some are useful) という言葉が効いてきます。 目標は「真の DGP に一致するモデル」を作ることではなく、 目的に対して十分役立つ近似を選ぶことです。
この視点に立つと、 上の 🎮 触って理解する ウィジェットで「緑の線 (f*) は本来見えない・黒い点だけが手に入る」という設定の意味が腑に落ちます。 「データによく当てはまる」ことと「真の過程をよく捉えている」ことは別物 — これが真のプロセスを学ぶ最大の教訓です。
⚠️ 落とし穴の深掘り (重要) — DGP を巡る 5 つの誤り
- 真の過程は未知・観測不能: f* は「自然が知っていて我々は知らない」関数。 どれだけデータを集めても f* そのものを直接見ることはできず、 手に入るのは常にノイズ込みの観測値だけです。
- モデルを DGP と混同する: 推定した $\hat f$ を「これが真の関係だ」と言い切ると、 モデルの仮定 (線形性・正規ノイズなど) を現実そのものと取り違えます。 正しくは「現在のデータ・現在の仮定の下では f* は $\hat f$ に近いと推定される」という慎重な言い方です。 → モデル選択
- 過学習でノイズを DGP と誤認する: モデルの複雑さを上げると訓練誤差はいくらでも下がりますが、 それは偶然のノイズ形状を「意味のある構造」として暗記しているだけのことがあります。 → 過学習 / モデルの複雑さ
- 外挿で DGP 仮定が崩れる: 訓練データの範囲外では、 近似が f* から大きく外れることがあります。 上の「外挿の難しさ」実験で、 小中規模県から学んだ線形モデルが東京都を約 4,120 施設も過小予測したのがその実例です。 → 汎化
- 識別不能性 (non-identifiability): 異なるパラメータが同じデータ分布をほぼ等しく生む場合、 「どちらが真か」をデータだけでは決められません。 多重共線性や交絡がその典型。 → 多重共線性 / 交絡
🔭 発展: 統計モデルと DGP の関係を俯瞰する
- 統計モデル = DGP の近似仮説: $y = f^*(x) + \epsilon$ という DGP に対し、 モデル族 $\mathcal F$ から $\hat f$ を選ぶ。 f* が $\mathcal F$ に含まれていなければ、 どれだけデータを増やしても消えない 近似誤差 (モデル誤特定) が残ります。
- バイアス-バリアンス分解: f* との距離は バイアス² + バリアンス + 既約ノイズ に分解される。 単純なモデルはバイアス大、 複雑なモデルはバリアンス大。 → バイアス-バリアンス分解
- 生成モデル的な見方: DGP を「データの生成レシピ」とみなすと、 ノイズ $\epsilon$ の分布仮定 (等分散・正規性など) が推定の妥当性を左右します。 → ノイズ / 残差
- 因果的 DGP: Judea Pearl 流では、 真の過程を単なる相関ではなく 介入 do() の下でも成り立つ因果構造とみなします。 相関ベースの $\hat f$ は介入予測には使えないことがある。 → 因果
- シミュレーションでは真値が既知: 現実では f* は不可知ですが、 自分で f* を決めてデータを生成すれば、 推定値と真値の距離を直接測れます。 これが推定手法のバイアス・バリアンスを定量化できる理由です。 → シミュレーションデータ
🧪 架空シミュレーション: 「真値が既知」だから過学習を数値で見られる
【架空データ・真値既知】 真の過程を $f^*(x) = \sin(2\pi x)$、 $x \in [0,1]$、 ノイズ $\epsilon \sim \mathcal N(0, 0.3^2)$、 標本サイズ $n=25$ と自分で決めて生成します (seed 固定)。 実データと違い f* が分かっているので、 訓練 MSE (データへの当てはまり) と 真の過程との距離 (f* からの平均二乗差) の両方を計算できます。
| モデル次数 d | 訓練 MSE (低いほど当てはまり良) | f* との距離 (低いほど真に近い) | 診断 |
|---|---|---|---|
| 1 (直線) | 0.2574 | 0.1986 | 過小学習 (両方高い) |
| 3 | 0.0441 | 0.0136 | ちょうど良い |
| 9 | 0.0285 | 1.2248 | 過学習 (当てはまり最良でも真から最遠) |
💬 読み方: d=9 は訓練 MSE が最小なのに、 f* との距離は d=1 の約 6 倍・d=3 の約 90 倍に膨れ上がります。 「データに最もよく当てはまるモデル」がノイズを DGP と誤認した典型で、 真値が既知だからこそこのズレを数値で可視化できます。 実データでは f* との距離は測れないため、 代わりに 交差検証 や テストデータ で間接的に確認します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # 架空データ・真値既知のシミュレーション(seed 固定で再現可能)
import numpy as np
rng = np.random.default_rng(42)
fstar = lambda x: np.sin(2 * np.pi * x) # 真の過程 f*
n, sigma = 25, 0.3
x = np.sort(rng.uniform(0, 1, n))
y = fstar(x) + rng.normal(0, sigma, n) # 観測 = f* + ノイズ
xg = np.linspace(0, 1, 400); ftrue = fstar(xg)
for d in (1, 3, 9):
c = np.polyfit(x, y, d)
train = ((np.polyval(c, x) - y) ** 2).mean()
dist = ((np.polyval(c, xg) - ftrue) ** 2).mean() # f* との距離
print(f'd={d}: 訓練MSE={train:.4f} f*との距離={dist:.4f}')
|
📤 実行結果:
※ 上の表・コード・出力はすべて架空の生成過程 (f*=sin) による合成データです。 実在の SSDSE データではありません。
🔗 実データでの注意 (SSDSE-B-2026, 2023 年 47 都道府県)
実データでは真値既知の贅沢はありません。 例えば総人口 (A1101) と一般診療所数 (I5102) の相関係数は 0.9717 と非常に高く、 線形回帰の決定係数は $R^2=0.9442$、 2 次式では $R^2=0.9697$ に上がります。 しかし当てはまりの良さは「真の過程を当てた」証拠にはなりません。 上の外挿実験が示すように、 高相関の裏で大都市の医療集積という別構造が残差に隠れています。 「$R^2$ が高い ≠ DGP を捉えた」という慎重さこそ、 誠実な統計推論の姿勢です。