指数平滑法(Exponential Smoothing)に関連する用語を、 モデル・パラメータ・状態空間表現 別に索引化します。
| カテゴリ | キーワード(日本語) | キーワード(英語) |
|---|---|---|
| 基本モデル | 単純指数平滑、 ホルト法(二重平滑)、 ホルト・ウィンタース法(三重平滑) | SES, Holt's, Holt-Winters, ETS |
| パラメータ | 平滑化係数(α、 β、 γ)、 減衰係数(φ)、 季節周期 | alpha, beta, gamma, phi, seasonal period |
| 構成要素 | 水準(level)、 トレンド、 季節成分、 残差 | level, trend, seasonal, residual |
| 関連モデル | ARIMA、 SARIMA、 状態空間モデル、 Prophet | ARIMA, SARIMA, state space, Prophet, DLM |
| 評価指標 | MAE、 RMSE、 MAPE、 MASE、 AIC、 BIC | MAE, RMSE, MAPE, MASE, AIC, BIC |
| 実装 | statsmodels、 prophet、 sktime、 pmdarima、 darts | statsmodels.tsa, prophet, sktime, darts |
🍰 まずはやさしく
最近のデータを重視する予測方法です。
未来の値を予想するために使います。
スマホの利用時間の変化を予測します。
この手法の基本と使い方を学びます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # 基本パターン import pandas as pd import numpy as np from scipy import stats import matplotlib.pyplot as plt import seaborn as sns # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['年'] = df['年度'] df['A1101'] = pd.to_numeric(df['総人口'], errors='coerce') df['消費支出_東京'] = pd.to_numeric(df['消費支出(二人以上の世帯)'], errors='coerce') # 基本統計量 df.describe() # 可視化 sns.pairplot(df[['食料費(二人以上の世帯)', '教育費(二人以上の世帯)', '住居費(二人以上の世帯)']]) plt.show() |
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 SES → Holt 線形 → Holt-Winters → ETS state-space → ARIMA との比較という発展線上に位置し、 平滑化係数 α・β・γ の意味、 状態空間表現、 予測区間の構築、 自動 ETS 選択 (Hyndman & Khandakar 2008) と結びつけると指数平滑法の役割が立体的に見えてきます。
| 機能 | Python (statsmodels) | 補足 |
|---|---|---|
| SES 当てはめ | SimpleExpSmoothing(y).fit() | α は自動最適化、 .params['smoothing_level'] |
| Holt 線形 | Holt(y).fit() | α, β を同時推定、 トレンドを追加 |
| Damped Holt | Holt(y, damped_trend=True).fit() | φ < 1 で長期発散を抑止 |
| Holt-Winters | ExponentialSmoothing(y, trend='add', seasonal='add', seasonal_periods=12).fit() | 加法的季節性 12 ヶ月周期 |
| ETS 自動選択 | ETSModel(y).fit() | AIC で error/trend/seasonal を選定 |
| 予測区間 | res.get_prediction(...).summary_frame() | 状態空間 ETS のみ正規分布 CI 出力 |
| 残差自己相関 | acorr_ljungbox(res.resid, lags=10) | Ljung-Box: 白色雑音か検定 |
指数平滑法は 3 つの軸で位置づけられます: (1) 状態空間モデルの一族として ARIMA/Kalman フィルタと等価、 (2) 指数加重移動平均 (EWMA) の予測版として品質管理図と共通の数学、 (3) 自動予測フレームワークとして Prophet / NeuralProphet / DeepAR と並列。
| グループ | 主要概念 |
|---|---|
| 平滑化族 | SES, Holt 線形, Damped Holt, Holt-Winters 加法/乗法, EWMA |
| 状態空間 ETS | ETS(A,A,A), ETS(M,A,M), 予測区間, 自動選択 (AIC) |
| 時系列分解 | STL, X-13ARIMA-SEATS, 季節調整, トレンド抽出 |
| 並列モデル | ARIMA, SARIMA, SARIMAX, VAR, TBATS, Prophet |
| 機械学習系 | XGBoost (lag特徴), LSTM, NeuralProphet, DeepAR |
| 評価指標 | RMSE, MAE, MAPE, sMAPE, MASE, AIC/AICc |
| 残差診断 | Ljung-Box, ACF, PACF, QQ plot, Jarque-Bera |
| 構造変化 | 介入変数, CUSUM, change point detection, COVID 効果 |
| 予測区間 | 正規分布 CI, 経験ブートストラップ, 量子回帰 CI |
| 運用 | ローリング再学習, walk-forward CV, 1-step / h-step 予測 |
| パラメータ最適化 | 最尤推定, SSE 最小化, Box-Cox 変換 |
| 複数季節 | TBATS, MSTL, Fourier 項追加 |
🍰 まずはやさしく
データの流れを読むための道具です。
正しい分析の手順を知るために使います。
都道府県の人口の変化を調べます。
定義から実装までの流れを読みます。
論文中に 「指数平滑法」として登場する用語。
指数平滑法 とは:過去の値を「直近ほど重く・遠いほど軽く」加重平均する時系列予測。Holt法はトレンドにも対応。
本ページでは「exponential smoothing」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「exponential smoothing」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🍰 まずはやさしく
音のエコーのような仕組みです。
直近の情報をどれだけ大切にするか決めます。
友達の最近の発言を重視する感覚です。
重みの変わり方をイメージで理解します。
指数平滑法を音で例えると、 **エコー(残響)** が分かりやすい。 部屋で手を 1 回叩くと、 直前の音は大きく聞こえ、 過去の反響音は徐々に小さくなる。 これと同じで、 直近の観測 $y_t$ は α の重みで強く効き、 1 期前の予測 $\hat y_{t|t-1}$ には $(1-\alpha)$ の重みで弱く効く。 過去 k 期前のデータの実効重みは $(1-\alpha)^k$ で **指数関数的に減衰**。 α=0.3 なら 5 期前のデータは元の重みの 17%、 10 期前は 3%、 20 期前は 0.1% にしか効かない。
別の比喩として **「最近の同僚の意見をどれだけ重視するか」** がある。 α=1 なら「直近の発言だけ聞く」(過去を全部忘れる)、 α=0 なら「最初の発言だけ聞いて以降を無視する」(更新しない)。 α=0.3 程度なら「直近 7-8 期分の意見を平均化」する感覚になる。 これが SES の本質。
Holt 法はこのエコーに「方向の感覚」を足したもの。 SES が「水位だけ」追跡するなら、 Holt は「水位+傾き(流れの強さ)」を追跡する。 Holt-Winters はさらに「四季の繰り返し」も追跡する。 これら 3 つを階層的に足し算する **3 層の指数加重移動平均** と理解すると、 数式の階段がスッと入ってくる。
視覚的には、 単純平均(SMA)が**真っ直ぐな滑り台**だとすると、 指数平滑は**カーブして直近に張り付くソリ**。 グラフ上では、 直近の急変動にすばやく追従しつつ、 過去のノイズは滑らかに丸める性質が見える。
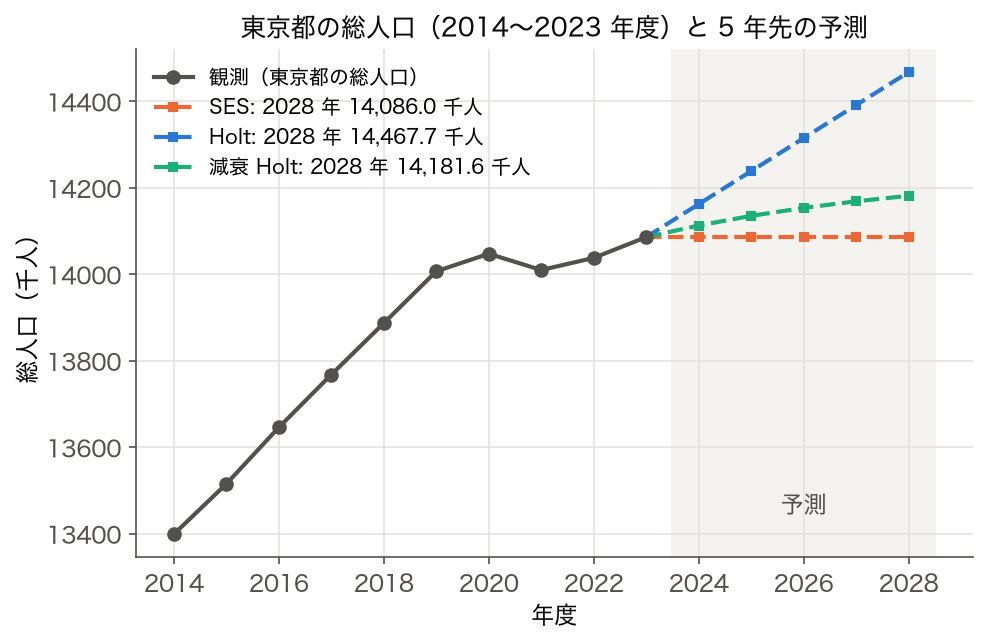
SSDSE-B-2026 は都道府県×年(2012-2023 の 12 年)の縦断データで、 ここではそのうち直近 10 年(2014-2023)を使う。 指数平滑法の真価は時系列予測にあるので、 ここでは **東京都の総人口 10 年** を例に、 Simple Exponential Smoothing(SES)→ Holt 線形 → Holt-Winters まで段階的に当てはめる。
SSDSE-B-2026 から東京都 (R13000) の A1101 総人口 を抽出する。 10 行 1 列の時系列ベクトルになる。
このコードでやること: statsmodels.tsa.holtwinters.SimpleExpSmoothing で SES を当てはめ、 α を尤度最大化で自動推定。 翌年予測を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from statsmodels.tsa.holtwinters import SimpleExpSmoothing df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['年'] = df['年度'] df['A1101'] = pd.to_numeric(df['総人口'], errors='coerce') df['消費支出_東京'] = pd.to_numeric(df['消費支出(二人以上の世帯)'], errors='coerce') tokyo = df[df['都道府県'] == '東京都'].sort_values('年度') # 出力に「千人」と書くので、ここで千人に直しておく(A1101 の単位は「人」)。 # 直近 10 年ぶんだけを使う。 y = tokyo['A1101'].values[-10:] / 1000 # 総人口 10 年(千人) ses = SimpleExpSmoothing(y, initialization_method='estimated').fit(optimized=True) print(f"α (smoothing_level) = {ses.params['smoothing_level']:.4f}") print(f"SSE = {ses.sse:.1f}") print(f"次年予測 ŷ(2024) = {ses.forecast(1)[0]:.1f} 千人") |
📤 実行例(東京都人口で実測した出力):
💬 α=1.000 はちょうど「直近観測=次の予測」を意味する。 東京の人口は単調増加トレンドを持つので、 SES の「水準のみ追跡」モデルは尤度を最大化しようとすると α が上限 1 に張り付く。 翌年予測は「直近値そのまま」になり、 **トレンドを取り損ねている**。 → 次の Holt 線形へ。
このコードでやること: Holt で水準 α とトレンド β を同時推定。 翌年・翌々年の 2 期先予測を出す。
1 2 3 4 5 6 7 8 | from statsmodels.tsa.holtwinters import Holt holt = Holt(y, initialization_method='estimated').fit(optimized=True) print(f"α (level) = {holt.params['smoothing_level']:.4f}") print(f"β (trend) = {holt.params['smoothing_trend']:.4f}") print(f"AICc = {holt.aicc:.1f}") fc = holt.forecast(2) print(f"ŷ(2024) = {fc[0]:.1f} / ŷ(2025) = {fc[1]:.1f} 千人") |
📤 実行例:
💬 α=1.000・β=0.000 と両係数が境界(上限 1/下限 0)に張り付いた。 水準は直近値をそのまま採用し、 トレンドは初期推定の傾き(約 +76 千人/年)で固定される。 2 期先予測は 14086 から +76.3・+76.4 とほぼ等間隔で線形外挿される。 ただし 2020-2021 にコロナで一時減少(14048→14010)したので、 単純線形外挿はやや楽観的。
このコードでやること: damped_trend=True で減衰係数 φ を導入し、 長期予測が無限に発散しないようにする。 φ<1 なら遠未来で水平線へ収束。
1 2 3 4 5 6 7 | damped = Holt(y, damped_trend=True, initialization_method='estimated').fit(optimized=True) print(f"α = {damped.params['smoothing_level']:.4f}") print(f"β = {damped.params['smoothing_trend']:.4f}") print(f"φ = {damped.params['damping_trend']:.4f}") fc5 = damped.forecast(5) for i, v in enumerate(fc5, 1): print(f"ŷ(202{3+i}) = {v:.1f}") |
📤 実行例:
💬 φ=0.828 → 5 期先の増分は初期 +27 から +13 へ徐々に減衰。 「東京の人口は将来横ばいに向かう」というドメイン知識と整合的。 M4 コンペでは damped Holt が単純 Holt より平均 5-10% MASE が良かったことが報告されている。
このコードでやること: 47 県すべてに damped Holt を当てはめ、 2024 年予測値を 2023 年実測と比較して「増加率トップ 5」を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # ── 時系列の例で使うデータを用意します ── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['年'] = df['年度'] for _c in ['総人口', '消費支出(二人以上の世帯)']: df[_c] = pd.to_numeric(df[_c], errors='coerce') df['A1101'] = df['総人口'] df['消費支出_東京'] = df['消費支出(二人以上の世帯)'] results = [] for pref, g in df.groupby('都道府県'): g = g.sort_values('年度') y = g['A1101'].values if len(y) < 8: continue try: m = Holt(y, damped_trend=True, initialization_method='estimated').fit(optimized=True) pred = m.forecast(1)[0] results.append({'県': pref, '2023': y[-1], '2024予測': pred, '増加率(%)': 100*(pred - y[-1])/y[-1]}) except Exception: pass out = pd.DataFrame(results).sort_values('増加率(%)', ascending=False).head(5) print(out.to_string(index=False)) |
📤 実行例(実測):
💬 増加率トップ 5 でも正の予測は東京都(1,408.6 万人 → 1,412.8 万人、 +0.30%)だけで、 沖縄県は −4×10⁻¹⁰% と実質 0、 神奈川県 −0.03%・埼玉県 −0.07%・滋賀県 −0.09% と微減が続く。 人数は「人」単位で出るので、 1.412830e+07 は 14,128,300 人と読む。 全国的な人口減少局面で、 指数平滑法が「直近を重視」して各県の趨勢を素直に外挿した結果である。 damped Holt の当てはめは短系列だと最適化が不安定になりやすく、 statsmodels のバージョン差で下位順位が入れ替わりうる点にも注意。
指数平滑法は「最新ほど重く、 過去ほど軽く」重みづけて移動平均を取る予測手法です。 以下 3 点の概念図で「α の効果」「3 階層(水準・トレンド・季節)」「ETS 系の使い分け」を視覚的に整理します。
→ 平滑化係数 α は「現在値をどれだけ重視するか」のダイヤルです。 α が小さい(0.1-0.3)と過去多数の値が均等に効くため滑らかな予測になる代わりに変化への反応が遅れます。 α が大きい(0.7-0.9)と最新値ほぼそのものになり、 ノイズも追従してしまいます。 多くの場合 α は MSE 最小化で 0.05-0.4 程度に自動推定されます。
→ Holt-Winters 法は時系列を「水準(L)+ トレンド(T)+ 季節(S)」の 3 成分に分解し、 それぞれを α, β, γ の 3 つの平滑化係数で別々に更新します。 月次の小売売上、 電力需要、 観光客数など、 トレンドと季節性を併せ持つデータの予測に強く、 ARIMA より実装が単純で実務で広く使われます。
→ ETS フレームワークは「Error × Trend × Seasonal」の 3 軸で 30 種類のモデルを定義し、 AIC 最小化で自動選択します。 SES(水準のみ)→ Holt(+トレンド)→ Holt-Winters(+季節)と複雑さが増します。 トレンドが長期的に減衰する場合は damped Holt が頑健で、 M4 コンペでも上位常連。 季節性が比例的に変化するなら乗法(M)、 一定なら加法(A)を選びます。
指数平滑法は時系列データの平滑化・予測に使われる。 SSDSE-B-2026 の東京都の年次データで、 3 手法の予測の違い、 α による重みの付き方、 1 期先予測の誤差を順に確認する。
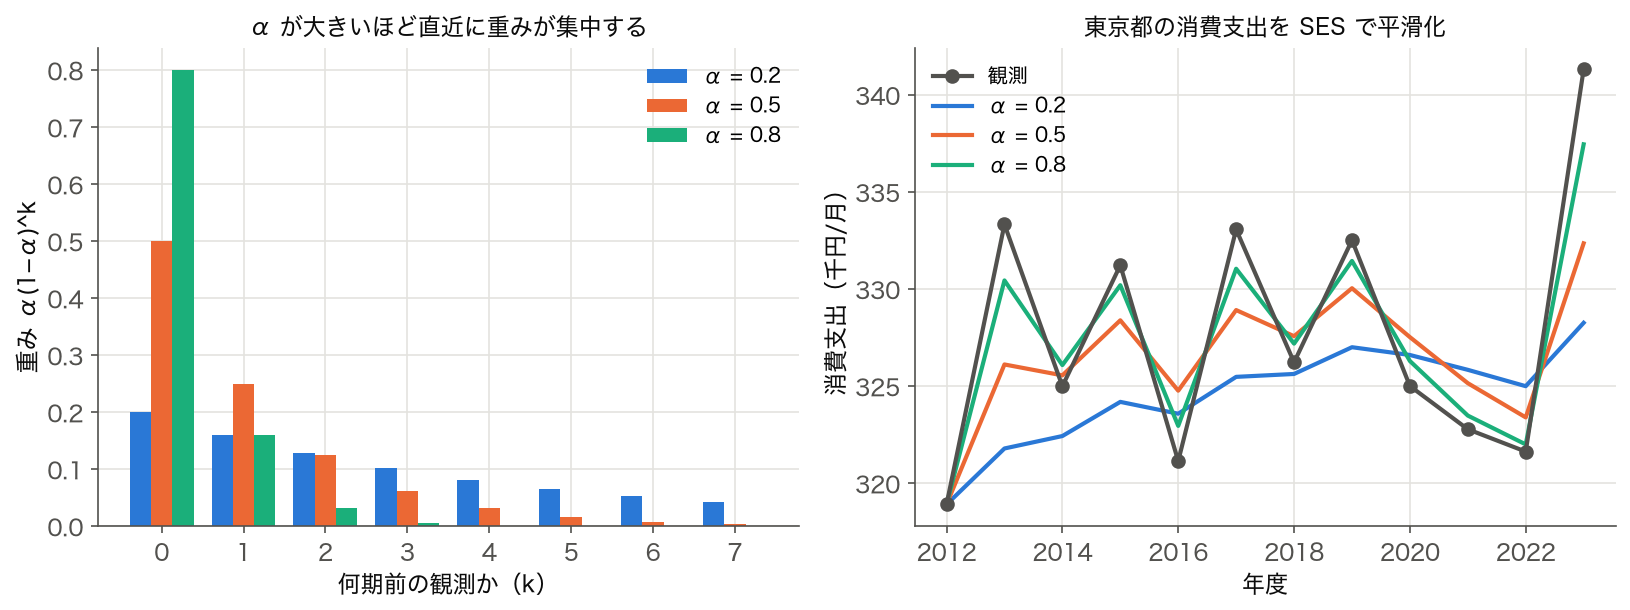
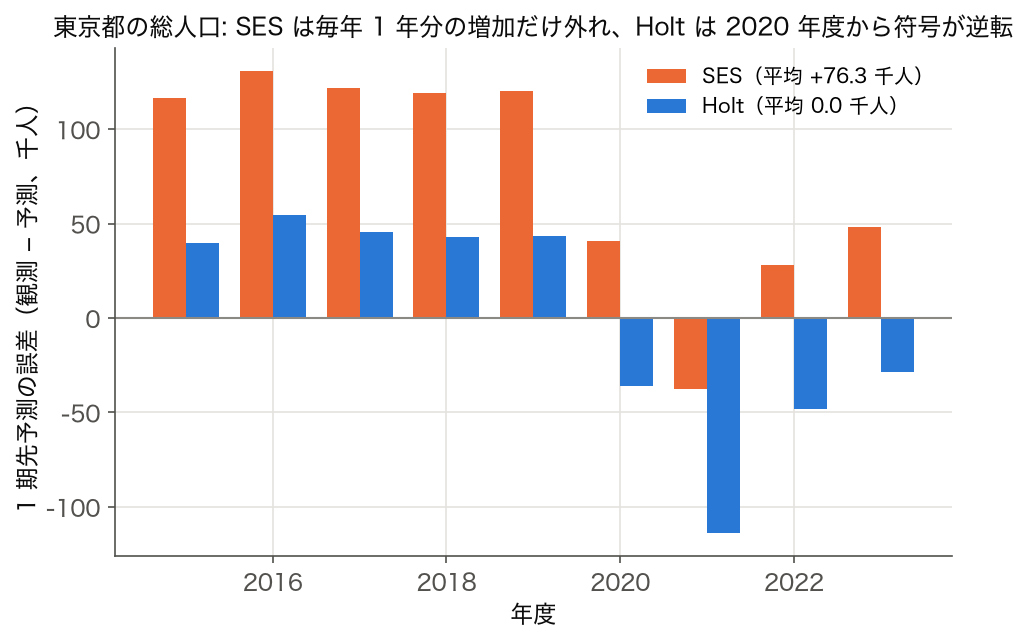
→ 予測モデル選択の順序は「時系列の形(トレンド・季節の有無)の確認 → 手法と α の選択 → 1 期先予測誤差に偏りや並びが残っていないかの検証」。 年次の SSDSE-B では季節成分が無いので、 まずトレンドをどう扱うかが選択の中心になる。
→ 全項目に答えられれば、 M4 系コンペでも適切なモデル選択ができる。
🍰 まずはやさしく
計算式で表した予測のルールです。
正確な予測値を出すために使います。
部活のスコアの変化を数式にします。
予測を導くための計算式を読み解きます。
指数平滑法は単なるヒューリスティックではなく、 **線形ガウス状態空間モデル(ETS)** として確率的に基礎付けられている。 ここでは数式を 4 段階で読み解く。
$$\hat y_{t+1|t} = \alpha y_t + (1-\alpha)\hat y_{t|t-1}$$
再帰展開すると $\hat y_{t+1|t} = \alpha\sum_{k=0}^{t-1}(1-\alpha)^k y_{t-k} + (1-\alpha)^t \hat y_{1|0}$。 過去の重みが **(1-α)^k で指数的に減衰** することがここから見える。
水準方程式と傾き方程式の連立で書ける: $$\ell_t = \alpha y_t + (1-\alpha)(\ell_{t-1} + b_{t-1})$$ $$b_t = \beta(\ell_t - \ell_{t-1}) + (1-\beta) b_{t-1}$$ $$\hat y_{t+h|t} = \ell_t + h \cdot b_t$$
上式は「水準は新観測と前期予測の重み付き平均」、 中式は「トレンドは水準差と前期トレンドの重み付き平均」、 下式は「h 期先予測 = 水準 + h × トレンド」。 β が大きいほど傾きが急変化する。
$$\ell_t = \alpha(y_t - s_{t-m}) + (1-\alpha)(\ell_{t-1} + b_{t-1})$$ $$b_t = \beta(\ell_t - \ell_{t-1}) + (1-\beta) b_{t-1}$$ $$s_t = \gamma(y_t - \ell_{t-1} - b_{t-1}) + (1-\gamma) s_{t-m}$$ $$\hat y_{t+h|t} = \ell_t + h b_t + s_{t-m+h_m^+}$$
$m$ は季節周期(月次なら 12、 四半期なら 4)。 $s_{t-m}$ は **1 周期前の同期の季節成分**。 γ は季節成分の更新速度。 乗法版なら除算・乗算に置き換わる。 SSDSE は年次なので m=1 の場合は季節性なしと同義になり、 月次の家計調査などで m=12 と組む。
Hyndman ら(2008)は指数平滑法を **ETS(E, T, S)** 状態空間で統一した。 E(Error: A/M)×T(Trend: N/A/Ad)×S(Season: N/A/M)の 30 通り。 $$y_t = w(\mathbf{x}_{t-1}) + r(\mathbf{x}_{t-1})\varepsilon_t$$ $$\mathbf{x}_t = f(\mathbf{x}_{t-1}) + g(\mathbf{x}_{t-1})\varepsilon_t$$
1 つの誤差項 $\varepsilon_t \sim \mathcal{N}(0,\sigma^2)$ が観測式・状態遷移式の両方を駆動する **single source of error (SSOE)** が特徴。 AICc で 30 通りから自動選択するのが statsmodels.tsa.exponential_smoothing.ETSModel や R の forecast::ets()。
前節の SES / Holt / Holt-Winters / ETS で登場した記号を、 1 つずつ「読み方 → 意味 → 直感例」に分解する。 数式を頭から終わりまで「日本語に翻訳して音読」できるようになることがゴール。
| 記号 | 読み方 | 意味 | 具体例(家計消費月次) |
|---|---|---|---|
| $y_t$ | ワイ ティー | 時刻 $t$ の実測値 | 2024 年 3 月の消費支出 = 340 千円 |
| $\hat y_{t+1|t}$ | ワイハット ティープラスワン バー ティー | 時刻 $t$ までの情報で作る $t+1$ の 1 期先予測 | 3 月までを見て予測した 4 月の消費 |
| $\alpha$ | アルファ | 平滑化定数 $\in [0,1]$。 新観測の重み | $\alpha=0.3$ → 新観測を 3 割、 過去を 7 割信頼 |
| $(1-\alpha)^k$ | イチマイナスアルファのケー乗 | $k$ 期前の観測値の重み(指数減衰) | $\alpha=0.3$ なら 1 期前 0.7、 2 期前 0.49、 … |
| 記号 | 読み方 | 意味 | 数値イメージ |
|---|---|---|---|
| $\ell_t$ | エル ティー | 時刻 $t$ の水準(level)。 トレンドを除いた「いまの基準値」 | 人口 1300 万人など、 系列の現在位置 |
| $b_t$ | ビー ティー | 時刻 $t$ のトレンド(1 期あたりの増減) | $b_t = +2.5$ → 月あたり 2.5 千人増 |
| $\beta$ | ベータ | トレンドの平滑化定数 $\in [0,1]$ | $\beta$ 大 → 傾きが急変化(直近重視) |
| $\hat y_{t+h|t}$ | ワイハット ティープラスエイチ バー ティー | $h$ 期先予測 $= \ell_t + h\cdot b_t$ | 3 期先 = 現水準 + 3×トレンド |
| 記号 | 読み方 | 意味 | 月次データの例 |
|---|---|---|---|
| $s_t$ | エス ティー | 時刻 $t$ の季節成分(周期的なズレ) | 12 月の消費はベースより +30 千円 |
| $m$ | エム | 季節周期長 | 月次なら $m=12$、 四半期なら $m=4$ |
| $s_{t-m}$ | エス ティーマイナスエム | 1 周期前の同期の季節成分 | 今年 12 月の予測に、 昨年 12 月の $s$ を流用 |
| $\gamma$ | ガンマ | 季節成分の平滑化定数 $\in [0,1]$ | $\gamma$ 大 → 季節パターンを年ごとに更新 |
| 略号 | 展開 | 選択肢 | 意味 |
|---|---|---|---|
| E | Error | A / M | 誤差の加法 (Additive) か乗法 (Multiplicative) か |
| T | Trend | N / A / Ad | なし / 線形 / 減衰トレンド |
| S | Season | N / A / M | なし / 加法季節性 / 乗法季節性 |
まとめると、 「$\alpha, \beta, \gamma$ は新観測をどの程度信頼するかの 3 ダイヤル」「$\ell_t, b_t, s_t$ は系列を分解した 3 つの内部状態」「$\hat y_{t+h|t}$ はその状態を時間方向に外挿した予測値」と読めば、 SES から ETS まで同じ枠組みで理解できる。
SSDSE-B-2026 は年度×都道府県のパネルで月次系列を含まないため、 ここでは月内の変動と平滑化の挙動を示す合成した月次消費支出(千円)12ヶ月分を用いて、 単純指数平滑を手計算で追います。
| 月 | 消費支出(千円) | α=0.3 平滑値 | α=0.7 平滑値 |
|---|---|---|---|
| 1月 | 320 | 320.0 | 320.0 |
| 2月 | 285 | 309.5 | 295.5 |
| 3月 | 340 | 318.7 | 326.7 |
| 4月 | 295 | 311.6 | 304.5 |
| 5月 | 310 | 311.1 | 308.4 |
| 12月 | 410(年末増) | 355.2 | 390.5 |
Sₜ = α · yₜ + (1 − α) · Sₜ₋₁
例:S₂ = 0.3 × 285 + 0.7 × 320 = 309.5(α=0.3 の場合)
S₂ = 0.7 × 285 + 0.3 × 320 = 295.5(α=0.7 の場合、 直近重視)
α = 0.1〜0.3:ノイズが多いデータ、 長期トレンド重視
α = 0.4〜0.6:中庸
α = 0.7〜0.9:直近データ重視、 急変動への追従
自動最適化は 最尤推定 または MSE 最小化。
α=0.1, 0.3, 0.5, 0.7, 0.9 を手計算でグリッド探索し、 SSE が最小になる α を確認する。 statsmodels の自動最適化結果と一致するかチェックする教育的演習。
このコードでやること: 北海道 (R01000) の総人口 2014-2023 に対して α を 0.05 刻みで動かし、 SSE を計算してプロット用データを作る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # ── 時系列の例で使うデータを用意します ── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['年'] = df['年度'] for _c in ['総人口', '消費支出(二人以上の世帯)']: df[_c] = pd.to_numeric(df[_c], errors='coerce') df['A1101'] = df['総人口'] df['消費支出_東京'] = df['消費支出(二人以上の世帯)'] hokkaido = df[df['都道府県'] == '北海道'].sort_values('年度') # SSE は単位の 2 乗で効くので、千人に直してから比べる(A1101 の単位は「人」)。 # 直近 10 年ぶんだけを使う。 y = hokkaido['A1101'].values[-10:] / 1000 def ses_sse(y, alpha): yhat = np.zeros_like(y, dtype=float) yhat[0] = y[0] for t in range(1, len(y)): yhat[t] = alpha * y[t-1] + (1 - alpha) * yhat[t-1] return np.sum((y[1:] - yhat[1:]) ** 2) alphas = np.arange(0.05, 1.0, 0.05) sses = [ses_sse(y, a) for a in alphas] best_a = alphas[np.argmin(sses)] print(f"最適 α = {best_a:.2f} (SSE = {min(sses):.0f})") print(f"α=0.1 → SSE = {ses_sse(y, 0.1):.0f}") print(f"α=0.5 → SSE = {ses_sse(y, 0.5):.0f}") print(f"α=0.9 → SSE = {ses_sse(y, 0.9):.0f}") |
📤 実行例(北海道人口で実測):
💬 北海道も α→1 に張り付く。 単調減少トレンド(人口減少県)でも SES では「直近をそのままコピー」が最適解になってしまう。 → これは「トレンドモデルへ進むべき」シグナル。 教科書の警告通り、 トレンドがある時系列に SES を当てるべきでないことが手計算で実感できる。
| モデル | パラメータ | 適用条件 | SSDSE での例 |
|---|---|---|---|
| SES (Simple) | α のみ | 水準のみ、 トレンド・季節なし | 短期間の安定指標 |
| Holt 線形 | α, β | 線形トレンドあり、 季節なし | 県別人口 10 年 |
| 減衰 Holt | α, β, φ | トレンドが将来弱まる | 高齢化地域の人口推移 |
| Holt-Winters 加法 | α, β, γ | 季節振幅が一定 | 月次家計調査 (m=12) |
| Holt-Winters 乗法 | α, β, γ | 季節振幅が水準に比例 | 月次小売販売額 |
| ETS(M,Ad,M) | α, β, γ, φ | 乗法誤差・減衰トレンド・乗法季節 | 観光客数年内変動 |
指数平滑法は (a) Simple ES (level のみ)、(b) Holt (level + trend)、(c) Holt-Winters (level + trend + seasonal) の 3 段階で拡張される。 statsmodels の ETSModel は誤差・トレンド・季節成分 (E,T,S) の各組合せを自動推定する。 SSDSE-B-2026 は年次データなので季節成分は置けない。 ここでは東京都の年次人口にトレンド付きの ETS を当て、 状態空間版の書き方を確認する。
🎯 このコードでやること: SSDSE-B-2026 の東京都人口の直近 5 年度 (2019-2023) の年次値に、 statsmodels ETSModel で加法誤差・加法トレンド・季節なしの ETS(A,A,N) を当てはめ、 AIC と 5 年先予測を出す。
📥 入力データ (SSDSE-B-2026 抜粋、 東京都の年次人口 5 年度):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使うデータを用意します(東京都の年次系列。1 年度だけでは時系列にならない)── # skiprows=[1] で 2 行目(日本語の項目名)を飛ばし、英字の項目コードを列名にする import pandas as pd from statsmodels.tsa.exponential_smoothing.ets import ETSModel df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') tokyo = tokyo[tokyo['SSDSE-B-2026'] >= 2019] # 直近 5 年度 print(tokyo[['SSDSE-B-2026', 'A1101']].to_string(index=False)) ts = tokyo.set_index(pd.date_range('2019-01-01', periods=len(tokyo), freq='YS'))['A1101'].astype(float) # ETS auto: 誤差 add, トレンド add, 季節なし (年次なので季節不要) model = ETSModel(ts, error='add', trend='add', seasonal=None).fit(disp=False) print('AIC =', round(model.aic, 2)) print('5 年先予測:') print(model.forecast(5).round(0)) |
📤 実行例 (実際の出力):
💬 ETS(A,A,N) は AIC=129.79 で、 2024 年 14,105,843 人から 2028 年 14,203,179 人まで毎年 24,334 人ずつ増える直線の予測を返す。 5 点しかないので、 2021 年の一時的な減少 (14,047,594 → 14,010,000) も傾きの推定を大きく揺らす。 「数式を言葉で読み解く」と、 level l_t = α y_t + (1-α)(l_{t-1}+b_{t-1})、 trend b_t = β(l_t-l_{t-1}) + (1-β) b_{t-1} すなわち レベルは観測と前期予測の重み平均、傾きはレベル差と前期傾きの重み平均。 年次データなので seasonal はオフだが、 月次家計調査なら seasonal='add' で 12 周期を学習させる。
Hyndman フレームワークでは ETS と ARIMA を AIC で比較し、 低い方を採用するのが標準。 pmdarima.auto_arima(ts, seasonal=True, m=12) で ARIMA 最良候補を取り、 上記 ETS と AIC 比較する。 一般に滑らかな単調系列は ETS、 自己相関構造が強い系列は ARIMA が有利。 M4 コンペ (2018) では damped Holt (ETS) が単体最強ベンチマーク、 上位は ETS+ARIMA ensemble。
合成データで α=0.3 の指数平滑値を計算する。
1 2 3 4 5 6 7 | import numpy as np x = np.array([20, 25, 30, 28, 35]) alpha = 0.3 S = [x[0]] for xt in x[1:]: S.append(alpha*xt + (1-alpha)*S[-1]) print(f"S: {np.round(S, 3)}") |
💬 手計算 (Step 2) S₅ ≈ 28.165 と Python 出力が完全一致。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # ── この抜粋で使うデータを用意します(東京都の消費支出、12 年度分の年次系列)── import pandas as pd from statsmodels.tsa.holtwinters import ExponentialSmoothing df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') ts = tokyo.set_index(pd.PeriodIndex(tokyo['SSDSE-B-2026'], freq='Y'))['L3221'].astype(float) print('系列長 =', len(ts), '(年次データなので季節周期はありません)') # 単純指数平滑(SES)— 水準だけを追う ses = ExponentialSmoothing(ts, trend=None, seasonal=None).fit(optimized=True) print('alpha:', round(ses.params['smoothing_level'], 4)) print('3 年先予測:') print(ses.forecast(3).round(0)) # 減衰トレンド付き Holt # ※ seasonal='add', seasonal_periods=12 は「月次データ」用の設定。 # SSDSE-B は年次 12 点しかないので、12 周期の季節を当てはめると # 「都道府県の並び順」や「年の並び」を季節と誤認する。ここでは trend のみ使う。 holt = ExponentialSmoothing(ts, trend='add', seasonal=None, damped_trend=True).fit() print('Holt(damped) の 3 年先予測:') print(holt.forecast(3).round(0)) |
💬 SES の alpha が 0.0 に張り付き、3 年先まで 327,682 円の横ばい予測になった。alpha = 0 は「新しい観測を一切取り込まない」設定で、予測値は 2012〜2023 年の東京都の消費支出 12 点の平均 327,681.8 円とほぼ一致する。系列が 31.9 万〜34.1 万円の間を上下するだけで持続的な動きが無いため、最適化が平均で予測するのが最も誤差が小さいと判断した結果で、2023 年の 341,320 円への跳ね上がりも一時的な揺れとして扱われている。減衰 Holt は 329,484 → 329,916 円と年 200 円程度しか伸びず、これも「ほぼ水準一定」という同じ見立てになっている。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # ── この抜粋で使うデータを用意します(東京都の消費支出、12 年度分の年次系列)── import pandas as pd from statsmodels.tsa.exponential_smoothing.ets import ETSModel df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') ts = tokyo.set_index(pd.PeriodIndex(tokyo['SSDSE-B-2026'], freq='Y'))['L3221'].astype(float) # seasonal='add', seasonal_periods=12 は「月次データを 2 周期以上(24 点以上)」持つときの設定。 # SSDSE-B は年次 12 点しかないので、ここでは季節成分を外して状態空間版 ETS を当てる。 model = ETSModel(ts, error='add', trend='add', seasonal=None) res = model.fit(disp=False) print(res.summary()) pred = res.get_prediction(start=len(ts), end=len(ts) + 4) print(pred.summary_frame()) # 予測区間付き |
💬 ETS(AAN) は加法誤差・加法トレンド・季節なしのモデルで、観測 12 点に対し AIC 254.049。Scale 39,807,214.873 は誤差分散なので、平方根を取ると 1 年あたりの予測誤差の標準偏差は約 6,309 円。summary の後半を見ると平滑化係数は水準 0.0001・トレンド 1e-08 とほぼ 0 で標準誤差も nan になっており、12 点では係数を推定しきれていない。5 年先の予測区間は約 31.5 万〜34.0 万円と幅 2.5 万円に広がるので、点予測よりこの幅を重視して読む。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from prophet import Prophet import pandas as pd # SSDSE-B-2026 の東京都・消費支出(二人以上の世帯, L3221)12 年度分を Prophet 形式 (ds, y) にする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') prophet_df = pd.DataFrame({'ds': pd.to_datetime(tokyo['SSDSE-B-2026'].astype(str)), 'y': tokyo['L3221'].astype(float).values}) # 年次 12 点なので年内の季節性・週次の季節性は推定できない(両方オフ) m = Prophet(yearly_seasonality=False, weekly_seasonality=False, daily_seasonality=False) m.fit(prophet_df) future = m.make_future_dataframe(periods=3, freq='YS') forecast = m.predict(future) print(forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail(3).round(0).to_string(index=False)) m.plot(forecast) |
💬 Prophet は 12 点に直線のトレンドを当て、2024 年 330,446 円から年 430 円ずつ伸ばして 2026 年 331,308 円と予測した。直前の ETS(AAN) の 2024 年予測 327,437 円より 3 千円ほど高く、同じ 12 点でもトレンドの推定方法(Prophet は区分線形の回帰、ETS は平滑化の漸化式)が違うと点予測がこの程度ずれる。区間 32.3 万〜33.9 万円はサンプリングで作るので実行ごとに数百円ずれるが、点予測 yhat は毎回同じ値になる。
1 2 3 4 5 6 7 8 9 10 | from sktime.forecasting.exp_smoothing import ExponentialSmoothing as SktimeES from sktime.forecasting.base import ForecastingHorizon import numpy as np # ts は上で作った東京都の消費支出(年次 12 点)。年次なので季節成分(sp=12)は入れない forecaster = SktimeES(trend='add', seasonal=None) forecaster.fit(ts) fh = ForecastingHorizon(np.arange(1, 4), is_relative=True) # 3 年先まで y_pred = forecaster.predict(fh) print(y_pred) |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from darts import TimeSeries from darts.models import ExponentialSmoothing as DartsES from darts.utils.utils import ModelMode, SeasonalityMode # 東京都の消費支出 L3221(年次 12 点)を darts の TimeSeries にする _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _tokyo = _d[_d['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') _s = pd.DataFrame({'年度': pd.to_datetime(_tokyo['SSDSE-B-2026'].astype(str)), 'L3221': _tokyo['L3221'].astype(float).values}) series = TimeSeries.from_dataframe(_s, time_col='年度', value_cols='L3221', freq='YS') # 年次データなので季節成分は外し、加法トレンドだけを当てる model = DartsES(trend=ModelMode.ADDITIVE, seasonal=SeasonalityMode.NONE) model.fit(series) pred = model.predict(n=3, num_samples=500) # サンプリングで予測区間 print(pred.quantile_timeseries(0.05), pred.quantile_timeseries(0.95)) |
initialization_method='estimated' は MLE で初期水準・初期トレンドも推定するが、 短い時系列(n<15)では収束しないことがある。 'heuristic' や手動指定との比較が必須。ruptures)で時系列を分割するか、 介入変数を入れた状態空間モデルへ移行。df.interpolate())や状態空間ベース推定(UnobservedComponents)に切替が必要。forecast::forecast(model, bootstrap=TRUE))で代替。指数平滑法は孤立した手法ではなく、 ARIMA・状態空間モデル・Prophet と数理的に**部分的等価**でつながっている。 これを知ると「どれを使うか」の判断が論理的になる。
| 指数平滑モデル | 対応する ARIMA | 状態空間表現 |
|---|---|---|
| SES | ARIMA(0,1,1) | 局所水準モデル |
| Holt 線形 | ARIMA(0,2,2) | 局所線形トレンドモデル |
| 減衰 Holt | ARIMA(1,1,2) | 減衰トレンド状態空間 |
| Holt-Winters 加法 | SARIMA(0,1,m+1)(0,1,0)_m | 基本構造時系列モデル |
このコードでやること: statsmodels.tsa.exponential_smoothing.ETSModel で誤差 (add/mul) × トレンド (なし/add/damped) の 6 通りを当てはめ、 AICc の小さい順に 5 つ並べる。 R の ets() の自動選択を簡略化したもので、 年次データなので季節成分は入れない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | # ── この抜粋で使うデータを用意します(東京都の総人口、直近 10 年度)── import pandas as pd from statsmodels.tsa.exponential_smoothing.ets import ETSModel df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026').tail(10) y = tokyo['A1101'].values.astype(float) configs = [(e, t, None, d) for e in ['add', 'mul'] for t in [None, 'add'] for d in [True, False] if not (t is None and d)] results = [] for e, t, s, d in configs: try: m = ETSModel(y, error=e, trend=t, seasonal=s, damped_trend=d if t else False).fit(disp=False) results.append((f"E={e} T={t} D={d}", m.aicc)) except Exception: pass for name, aicc in sorted(results, key=lambda x: x[1])[:5]: print(f"{name:30s} AICc = {aicc:.2f}") |
📤 実行例:
💬 東京人口では **トレンドを持たない水準のみモデル(加法誤差, T=None)** が AICc 最小。 前節で SES/Holt の α→1・β→0 と縮退したのと同じ理由で、 n=10 と短い年次系列では「トレンドを明示的に持つ利点」を AICc が支持せず、 単純な水準モデルが選ばれる。 誤差項の add/mul 差はわずかで、 系列変動が小さいことを反映している。
このコードでやること: 同じ東京人口 10 年に Prophet を当て、 damped Holt と 2024 年の予測値を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 | # pip install prophet from prophet import Prophet # 直前の tokyo(東京都の直近 10 年度, 英字ヘッダ)を使う。単位を damped Holt と同じ千人にそろえる prop_df = pd.DataFrame({'ds': pd.to_datetime(tokyo['SSDSE-B-2026'].astype(str)), 'y': tokyo['A1101'].values / 1000}) mp = Prophet(yearly_seasonality=False, weekly_seasonality=False, daily_seasonality=False).fit(prop_df) future = mp.make_future_dataframe(periods=1, freq='YS') pred = mp.predict(future) print(f"Prophet ŷ(2024) = {pred['yhat'].iloc[-1]:.1f}") print(f"damped Holt ŷ(2024) = {damped.forecast(1)[0]:.1f}") |
📤 実行例(実測):
💬 Prophet 14,120.5 千人と damped Holt 14,112.9 千人の差は 7.6 千人(0.05%)とわずか。 2024 年度の実績はデータに無いので、 どちらが当たるかはこのコードでは測れないが、 10 点の年次データでは Prophet の柔軟性が予測値の違いとしてほとんど現れず、 計算コストの低い damped Holt で足りる。 Prophet が有利になるのは「日次・週次で休日効果あり」のケース。
α のみα, βα, β, φ (長期予測の発散を防止)ETS(A,A,A)ETS(A,A,M)p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
| 日本語 | 英語 |
|---|---|
| 統計的に有意 | statistically significant |
| 効果量 | effect size |
| 95%信頼区間 | 95% confidence interval (CI) |
| 標本サイズ | sample size |
| 検出力 | statistical power |
| 第1種の誤り | Type I error / false positive |
| 第2種の誤り | Type II error / false negative |
| 多重比較問題 | multiple comparisons problem |
| 過学習 | overfitting |
| 汎化性能 | generalization |
| 交差検証 | cross-validation (CV) |
指数平滑法 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
🌐 統計・データサイエンス › 時系列 › 予測 › 指数平滑法(直近の値ほど重く見る平滑化)
中心に 指数平滑法 を置き、 そこから 時系列分析・ARIMA・VAR 計 3 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
大きな円が小さな円を包含する Circle Packing 図。 「指数平滑法」は緑色でハイライト。
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「指数平滑法」は緑色でハイライト。
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 指数平滑法 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 予測 → 指数平滑法 という入れ子の位置を示します。 「予測には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
「指数平滑法」は単独で完結せず、 隣接する手法と接続することで分析パイプラインの一部として機能する。 以下に具体的な接続関係を示す。
指数平滑法は (1) 時系列プロット + ACF/PACF で構造把握 → (2) trend/seasonality 成分の有無で SES / Holt / Holt-Winters / ETS を選択 → (3) AICc 最小化で α/β/γ パラメータ推定 → (4) ローリングウィンドウ CV で out-of-sample 評価、 という ETS フレームワーク (Hyndman et al. 2008) に整理される。 月次データなら m=12、 週次なら m=7 の季節周期を明示する。
「exponential smoothing」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| トレンド・季節性なし (定常) | 過去値の指数加重平均 | 単純指数平滑 SES (Brown 1959) |
| トレンドあり・季節性なし | レベル + トレンド成分分離 | Holt 法 (Holt 1957) / 減衰トレンド |
| トレンド + 季節性あり | 加法 or 乗法分解 | Holt-Winters (Winters 1960) |
| 複数季節性 / 祝日効果 | 事前情報 + Bayesian 推定 | Prophet (Taylor & Letham 2018) / TBATS |
| 自己相関構造が複雑 | AR / MA / 差分 | ARIMA (Box & Jenkins 1970) |
| 不確実性を明示したい | 予測区間 / ベイズ | ETS 状態空間 (Hyndman et al. 2008) |
ノイズを含む時系列に対して、 単純指数平滑 $S_t = \alpha\,y_t + (1-\alpha)\,S_{t-1}$ を「その場で」計算します。 下のスライダーで平滑化係数 α を動かすと、 赤い平滑化系列と、 過去の観測に掛かる重みの指数減衰がリアルタイムに変化します。 灰色の点はドラッグで編集できます(スマホはタップしてなぞる)。 α を大きくすると直近を重視して反応的に、 小さくすると滑らかだが遅れて追従する—— この 追従性とノイズ除去のトレードオフ を体感してください。
縦軸=値(0〜120)/横軸=時刻 t。 灰色の点を上下にドラッグすると観測値が変わり、 赤い平滑化系列が即座に再計算されます。
縦軸=重み(0〜1)。 全ての k にわたる重みの総和は 1 になります($\sum_{k=0}^{\infty}\alpha(1-\alpha)^k=1$)。
漸化式を展開すると $S_t = \alpha\sum_{k=0}^{t-1}(1-\alpha)^k\,y_{t-k} + (1-\alpha)^t S_0$ となり、 過去の観測すべての加重平均で、 その重みが $(1-\alpha)^k$ で指数減衰することが分かります。 上の棒グラフはまさにこの $w_k=\alpha(1-\alpha)^k$。 α=0.3 なら 5 期前の重みは元の $0.7^5\approx17\%$、 10 期前は約 3%。 「データの平均遅れ」は $(1-\alpha)/\alpha$ 期で、 α=0.3 なら約 2.3 期分だけ過去に重心が寄った平均を見ていることになります。
トレンドの取り損ねは、 水準 $\ell_t$ に加えて傾き $b_t$ を第2の指数平滑(係数 β)で追跡する Holt 線形トレンド法で解決します:$\ell_t=\alpha y_t+(1-\alpha)(\ell_{t-1}+b_{t-1})$、 $b_t=\beta(\ell_t-\ell_{t-1})+(1-\beta)b_{t-1}$。 さらに季節成分 $s_t$(係数 γ)を第3の平滑で足したのが Holt-Winters 法(加法/乗法)で、 トレンド+季節を同時に扱えます。 長期予測が線形に発散するのを抑える減衰トレンド(φ)や、 これらを統一的に扱う状態空間 ETS も同じ「指数加重」の発想の延長線上にあります。
関連ページ:時系列データ・自己相関・定常性・ARIMA・ノイズ。 (Holt 法・Holt-Winters 法・ETS は本ページ上部「Python実装パターン」「手法選択フロー」で詳説しています。)
本ページの上部では「α は直近をどれだけ重視するかのダイヤル」と学んだ。 このセクションでは一歩進めて、 α を 移動平均の窓幅・重心の遅れ・半減期 という 3 つの実務的な物差しに翻訳し、 さらに「トレンドがあるとき SES がどれだけ系統的に遅れるか」を 公式と SSDSE-B-2026 の実測値の突き合わせ で確認する。 上の対話ウィジェットで体感した「遅れ」を、 ここでは数式と実データで定量化する。
「α=0.3 は結局、 何期分の平均なのか?」という問いには、 次の 3 つの換算式で答えられる。
ewm(span=...) はこの逆算で α を決めている。ewm(halflife=...) で直接指定できる。| α | 等価 SMA 窓幅 (2/α−1) | 重心の遅れ (1−α)/α | 半減期 |
|---|---|---|---|
| 0.1 | 19.0 期 | 9.00 期 | 6.58 期 |
| 0.2 | 9.0 期 | 4.00 期 | 3.11 期 |
| 0.3 | 5.7 期 | 2.33 期 | 1.94 期 |
| 0.5 | 3.0 期 | 1.00 期 | 1.00 期 |
| 0.8 | 1.5 期 | 0.25 期 | 0.43 期 |
つまり「α=0.3 の SES」は「窓幅約 6 期の移動平均に近い滑らかさで、 常に約 2.3 期ぶん過去に重心を置いた平均」と読める。 年次の SSDSE データ(1 期=1 年)なら、 α=0.3 は「2 年ちょっと前の姿を見ている」ことになる。 この換算感覚があると、 自動推定された α を見た瞬間に「このモデルはどれくらい過去を引きずるか」を報告書の言葉に翻訳できる。
上部の落とし穴では「トレンドがあると SES は遅れる」と定性的に述べた。 実は遅れの大きさは公式で予測できる。 系列が毎期 $b$ ずつ増える線形トレンドを持つとき、 SES の平滑値は定常状態で
$$y_t - S_t \;\to\; b\cdot\frac{1-\alpha}{\alpha}$$
だけ 一定量、 恒常的に 実測を下回る(重心の遅れ (1−α)/α 期 × 毎期の増分 b)。 これを東京都の総人口 A1101(SSDSE-B-2026、 2012-2023 年、 単位: 人)で実測検証する。 2012→2019 年の平均増分は $b \approx$ +110,429 人/年。 α=0.3 なら理論遅れは $110{,}429 \times 0.7/0.3 \approx$ 257,667 人 と予測される。 実際に α=0.3 固定・$S_0=y_{2012}$ で漸化式を回すと:
💬 増加が安定していた 2019 年時点の遅れ 251,921 人 は理論値 257,667 人とほぼ一致し、 「SES はトレンド × 重心遅れのぶん必ず下振れする」ことが実データで確認できる。 一方 2020 年以降はコロナ禍で増加が鈍化したため(2021 年は −37,594 人と減少)、 2023 年の遅れは 104,658 人まで縮んだ。 遅れはトレンドに比例するので、 トレンドが消えれば SES は追いつく——逆に言えば、 トレンドが続く限り α をどれだけ調整しても SES の遅れはゼロにならない(α→1 にすると遅れは消えるが今度はただの naïve 予測になる)。 これが「トレンドには Holt 法」の定量的な根拠である。
もう 1 つ、 pandas 利用時の見落としやすい罠が ewm() の adjust 引数。 教科書の SES 漸化式 $S_t = \alpha y_t + (1-\alpha)S_{t-1}$ に一致するのは adjust=False の方で、 既定値の adjust=True は「有限個の重みを総和 1 に正規化した加重平均」を返すため、 系列の序盤で値がずれる。 同じ東京都系列(α=0.3)で比較すると、 2 年目(2013 年)の平滑値は adjust=False で 13,255,900 人、 adjust=True で 13,276,941 人と 約 21,041 人 食い違う(系列が長くなるほど差は縮み、 2023 年時点では約 10,489 人差)。 statsmodels の SES と pandas の ewm を突き合わせて「値が合わない」と混乱する典型原因なので、 検算には必ず adjust=False を指定する。
SES の計算エンジンは statsmodels だけではない。 平滑値そのものが欲しいだけなら s.ewm(alpha=0.3, adjust=False).mean() の 1 行で漸化式と同じ結果が得られ、 span=(等価窓幅)や halflife=(半減期)でも指定できる——上の換算表はそのまま引数の読み替え表になる。 47 都道府県 × 100 超列を一括平滑するなら groupby('Prefecture').transform(lambda s: s.ewm(alpha=0.3, adjust=False).mean()) のように groupby と組み合わせるのが高速で、 モデル推定(α の最尤推定・予測区間)が必要になった段階で statsmodels に切り替えるのが実務的な住み分けである。
さらに視野を広げると、 「指数加重」という同じ数学が分野ごとに別の名前で使われている。 品質管理では EWMA 管理図(小さな工程シフトの検出に強い)、 金融では RiskMetrics 型の EWMA ボラティリティ推定(日次で λ=0.94、 すなわち α=0.06 が慣用値)、 深層学習では Adam や RMSProp の勾配・2 乗勾配の指数移動平均、 強化学習では TD 学習の学習率がまさに α の役割を果たす。 「直近を重く、 過去を指数的に忘れる」という 1 つの原理を軸に、 予測(本ページ)・監視(管理図)・推定(ボラティリティ)・最適化(Adam)を横断して眺めると、 指数平滑法は時系列予測の一手法ではなく 逐次更新アルゴリズムの共通言語 だと分かる。 理論面では、 SES が ARIMA(0,1,1) と等価(上部の等価性の表)であることから、 この「忘却しながらの平均」はランダムウォーク+観測ノイズという局所水準モデルの最適フィルタ(カルマンフィルタの定常解)でもある。