🔖 キーワード索引(深掘り)
🔖 キーワード索引(深掘り)
本ページでは四分位数(Q1/Q2/Q3)と四分位範囲(IQR)を、 計算方法・補間アルゴリズム・外れ値検出(1.5 IQR 法)・SSDSE-B-2026 実データへの適用まで網羅します。
💡 30秒で分かる結論
🍰 まずはやさしく
データを4つのグループに分ける方法です。
データのばらつきを正しく知るために使います。
テストの点数の順位などを調べる時に便利です。
四分位やIQRなどの基本的な用語を学びます。
- 四分位:データを大きさ順に並べた 25%/50%/75% の値。
- IQR = Q3 - Q1。 中央50% のばらつき。 標準偏差より頑健。
- 箱ひげ図:5数要約 + 外れ値を視覚化。
- Tukey の外れ値ルール:Q1 - 1.5·IQR 未満 or Q3 + 1.5·IQR 超で外れ値。
- パーセンタイル:n% 以下にデータが含まれる点(偏差値・成績順位等)。
- MAD:中央値からの絶対偏差の中央値。 最も頑健な分散。
- 分位点回帰:平均ではなく分位点をモデル化(極端値を見たい時)。
💡 30 秒で分かる結論(深掘り版)
- 四分位数は順序統計量を 4 等分する点。 Q1 = 25%、 Q2 = 50%(中央値)、 Q3 = 75%。
- IQR = Q3 - Q1。 データの中央 50% の散らばりを表し、 外れ値に強いロバストな散布尺度。
- 外れ値の1.5 IQR フェンス: $[Q_1 - 1.5 \cdot IQR, \; Q_3 + 1.5 \cdot IQR]$ の外を外れ値候補とする。
- 補間方法に注意。 NumPy 既定は
linear、 R 既定はtype=7。 結果がライブラリ間で微妙に異なる原因はここにある。 - SSDSE-B-2026 の 47 都道府県人口で計算すると、 IQR は約 160 万人、 東京・神奈川・大阪は明確に外れ値領域。
📍 あなたが今見ているもの
🍰 まずはやさしく
順位を使ってデータをまとめる方法です。
極端な値に振り回されずに分析するために使います。
一部の人が桁違いに高い買い物をする例などで役立ちます。
外れ値(極端な値)に強い指標について詳しく読みます。
本ページでは、 順位ベースの記述統計を統合的に解説します。 四分位・四分位範囲 (IQR)・パーセンタイル・箱ひげ図・外れ値検出を一気通貫で扱います。
これらは外れ値に頑健な指標で、 歪んだ分布や外れ値を含むデータの記述に最適です。 SSDSE-B のように地域差が大きいデータの可視化で頻出します。
📍 文脈ボックス(あなたが今見ているもの)
四分位数・IQR は記述統計の中の散らばり(dispersion)に属し、 標準偏差のロバスト版として位置づきます。 標準偏差が二乗を含むため外れ値に敏感なのに対し、 IQR は順位だけで計算されるため外れ値の影響をほぼ受けないのが最大の利点。 箱ひげ図の箱の長さは IQR、 ひげの長さは Tukey フェンス、 点は外れ値という具合に、 ほぼすべての情報を四分位数で語ります。
| 尺度 | 代表的指標 | 外れ値耐性 |
|---|---|---|
| 中心 | 平均 / 中央値 (=Q2) | 平均は弱、 中央値は強 |
| 散らばり | 標準偏差 / IQR | SD は弱、 IQR は強 |
| 形状 | 歪度 / 尖度 / 四分位歪度 | 通常版は弱、 四分位版は強 |
🎨 直感で掴む — 1. なぜ順位ベース統計が必要か
🍰 まずはやさしく
データを順番に並べて切るイメージです。
平均では分からないデータの本当の姿を見るために使います。
クラスの中で自分の順位がどのあたりか考える時に似ています。
図を使ってデータの散らばり方を直感的に理解します。
- 平均・標準偏差は外れ値に弱い。 1 つの極端値で大きく動く
- 歪んだ分布では「平均」が代表しない
- 所得・地価のように強い右歪みのデータでは中央値・IQR が現実的
SSDSE-B でも東京都の総人口(A1101)は他の46県と比べて極端な値で、 平均は引っ張られるが中央値は影響を受けにくい。
🌐 関連手法・派生:四分位は中央値を一般化したもの。 派生として 箱ひげ図、 上位概念として代表値、 並列概念として分散・標準偏差があります。
🖼️ 図で掴む:四分位・IQR の姿(SSDSE-B-2026)
四分位・IQR は「数値の並び順を 25% ずつに切る」操作で、 図にすると挙動が一目で分かります。 ここでは SSDSE-B-2026 都道府県データを材料に、 (1) 散布図で 順位の濃淡、 (2) ヒストグラムで 分位点と分布形、 (3) 多群箱ひげで 群ごとの IQR 比較の 3 つの視点を示します。
図 1 — 散布図で見る順位の濃淡
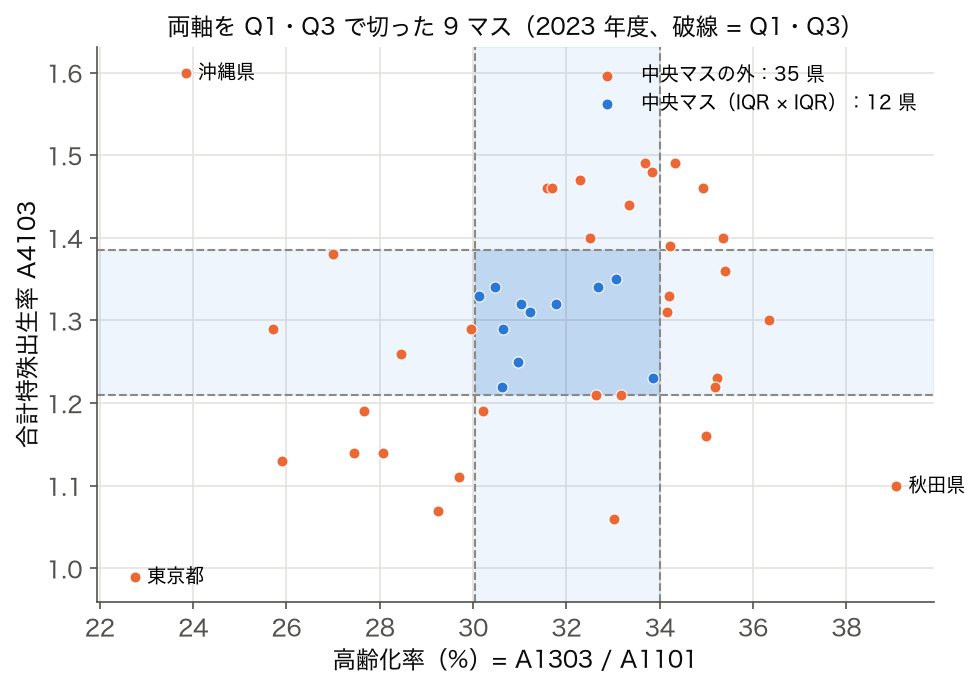
💬 横軸を Q1・Q3 で切り、 縦軸を Q1・Q3 で切ると、 散布図は 9 マスに分割されます。 中央の IQR×IQR の矩形に全体の約 25% 前後(独立な 2 変量なら 0.5×0.5=0.25)が入り、 四隅には外れ気味の点が落ちます。 図は 2023 年度の高齢化率 (Q1 30.1%・Q3 34.0%) × 合計特殊出生率 (Q1 1.21・Q3 1.39) で、 2 変数の相関は r = 0.20 と弱く、 中央マスに入るのは 12 県 = 25.5% とほぼ 0.25 どおり。 四隅には 14 県が落ち、 東京都 (高齢化率 22.8%・出生率 0.99)、 沖縄県 (23.8%・1.60)、 秋田県 (39.1%・1.10) が両軸で端にいます。 「中央 50% の塊」と「外側 50% の散らばり」を視覚的に切り分けられるのが四分位の最大の利点です。
図 2 — ヒストグラム+分位点で分布形を読む
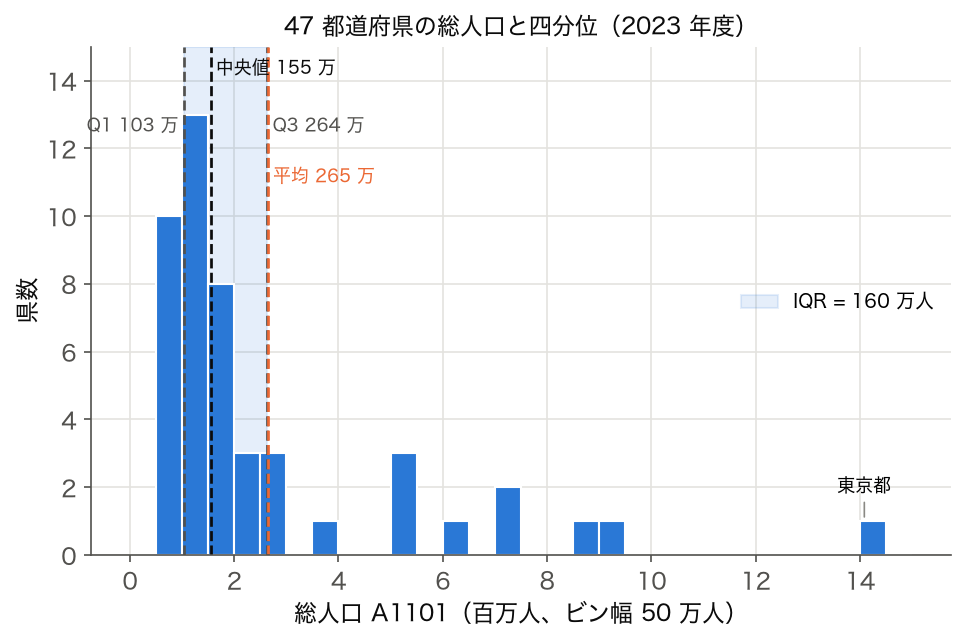
💬 ヒストグラムに Q1(25%)・中央値(50%)・Q3(75%)の縦線を重ねると、 中央 50% がどの区間に集中しているかが一目で分かります。 右に長く尾を引く分布(人口・所得など)では中央値より平均が右にずれ、 Q3 と最大値の距離が Q1 と最小値の距離よりずっと長くなります。 図の総人口 (2023 年度) では Q1 103 万・中央値 155 万・Q3 264 万人 (IQR 160 万人) に対し平均は 265 万人で、 Q3 とほぼ同じ位置まで引っ張られています。 最小 (鳥取県 54 万) から Q1 までは 50 万人しかないのに、 Q3 から最大 (東京都 1,409 万) までは 1,145 万人あります。 これが「歪んだ分布では IQR の方が代表として頑健」という根拠です。
図 3 — 多群箱ひげで群間の IQR を比較
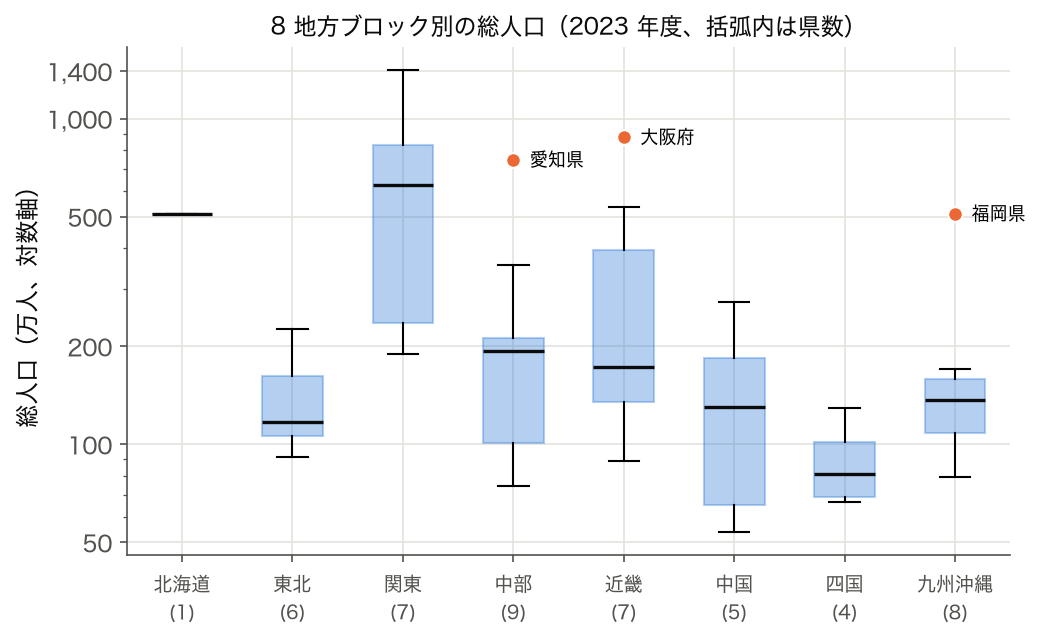
💬 群ごとに箱ひげを並べると、 各群の 箱の高さ (= IQR)・中央線・ひげの長さ・外れ値が同じ縮尺で比較できます。 平均と SD だけでは「東京を含む関東は分散が大きい」としか言えませんが、 四分位ベースなら具体的な差異が見えます。 図 (2023 年度の総人口、 対数軸) では関東の中央値 626 万人・IQR 592 万人が他ブロック (中央値 81〜193 万人、 1 県だけの北海道を除く) より桁違いに大きい一方、 東京都は関東の中では 1.5×IQR の外れ値になりません。 外れ値として点で描かれるのは、 自分のブロックの中で突出する愛知県 (中部)・大阪府 (近畿)・福岡県 (九州沖縄) で、 「外れ値かどうか」が群の IQR 次第で決まることも分かります。 教育・行政データのレポートで頻用される理由です。
図のまとめ
| 図 | 読みどころ | 四分位・IQR との関係 |
|---|---|---|
| 図 1 散布図 | Q1/Q3 で切った 9 マスの濃淡 | 中央矩形に IQR×IQR の点が集中 |
| 図 2 ヒスト | Q1/中央値/Q3 の縦線で歪み判定 | IQR が分布の中央 50% 幅 |
| 図 3 箱ひげ | 群間で箱の高さ・位置を比較 | 群ごとの IQR・外れ値が一望 |
📊 2. パーセンタイル(百分位点)
$p$-パーセンタイルとは「データの $p\%$ 以下にあたる値」。
- 50パーセンタイル=中央値
- 25パーセンタイル=第1四分位 (Q1)
- 75パーセンタイル=第3四分位 (Q3)
- 10/90 パーセンタイル=デシル(10分位の 1/9)
2.1 パーセンタイルの計算方法
標本点の中間にあたるパーセンタイルは内挿で計算。 NumPy には 9 種類の方法。
- linear(既定):線形内挿
- lower / higher:下側・上側の標本点を採用
- nearest:最近隣
- midpoint:両隣の中点
1 2 3 4 5 6 7 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023年度47都道府県 x = df['L3221'] # 消費支出(二人以上の世帯) print('10%, 25%, 50%, 75%, 90% パーセンタイル:') print(np.percentile(x, [10, 25, 50, 75, 90]).round(0)) |
💬 月あたり消費支出は 10% 点 262,920 円・中央値 300,652 円・90% 点 323,886 円。 25% 点 279,506 円と 75% 点 307,502 円の間隔が 27,996 円しかないのに対し、 その外側は 10% 点まで 16,586 円・90% 点まで 16,384 円あり、 中位 50% が詰まって両裾が伸びている。 47 点しかないので 10% 点は下から 4〜5 番目あたりの内挿値になる。
🎨 直感で掴む(深掘り)
100 人の試験得点を低い順に並べたとき、 下から 25 番目が Q1、 50 番目が Q2(中央値)、 75 番目が Q3。 「真ん中半分(25 番〜75 番)」の幅が IQR です。 1 人だけ 9999 点という極端な外れ値が混ざっても、 順位は動かないので Q1・Q3 は変わりません。 これが「順位で測る → 外れ値に強い」の本質です。
標準偏差は「平均からのズレを二乗して平均する」ため、 1 つの極値が SD を 2〜10 倍にすることがあります。 IQR にはそれが起きません。 「中央 50% に何が起きているか」だけを見るので、 上下 25% に何があっても影響しない。 これが distribution-free(分布形状に依存しない)な指標と呼ばれる理由でもあります。
Tukey が提案した 1.5 IQR フェンスは、 正規分布なら約 99.3% のデータをカバーする閾値。 これより外側に出るデータは「分布の素性から見て珍しい」とみなされ、 箱ひげ図では点としてプロットされます。 「外れ値は機械的に削除すべきではない」が原則 —— 入力ミス・計測エラー・本当に貴重な情報、 のどれかを判断するのは人間です。
🎮 触って理解する — IQR フェンスと外れ値検出
点をドラッグしたり、 帯の空白部分をタップ/クリックして点を追加すると、 Q1・Q2・Q3・IQR と外れ値フェンス($Q_1 - k\cdot IQR,\; Q_3 + k\cdot IQR$)がリアルタイムに再計算され、 下段の箱ひげ図も連動します。 右端へ極端な点を足すと、 IQR 法は外れ値を検出し続けるのに対し、 平均 ± 3×SD の SD 法はしばしば見逃す(マスキング効果)ことを体感できます。
—
📖 この操作で何が分かる? — IQR・外れ値検出の理屈
IQR(四分位範囲)の定義
IQR = Q3 − Q1。 データを大きさ順に並べたときの「中央 50%」が占める幅です。 Q1(25% 点)と Q3(75% 点)だけで決まるため、 上下 25% に何が起ころうと値が動きません。 これが標準偏差との決定的な違いで、 ロバスト統計の代表例です。 詳しい定義は 四分位 のページも参照してください。
なぜ「1.5」なのか(フェンス係数の由来)
正規分布では Q1 ≈ −0.6745σ、 Q3 ≈ +0.6745σ なので IQR ≈ 1.349σ。 上フェンス $Q_3 + 1.5\cdot IQR$ は約 +2.70σ、 下フェンスは約 −2.70σ に対応します。 $P(|Z|>2.698)\approx0.7\%$ なので、 正規分布ならおよそ 99.3% のデータがフェンス内に収まる計算です。 Tukey はこの 1.5 を「厳しすぎず緩すぎない実用値」として提案し、 さらに外側の $3\cdot IQR$ を “far out(極端な外れ値)” の目安としました。 上のスライダーで k を動かすと、 k が小さいほど判定が厳しく(外れ値が増え)、 大きいほど緩くなる様子が確認できます。
SD 法との比較 — なぜ IQR は頑健か
平均 ± 3×SD(3σ 法)は、 外れ値そのものが平均と SD の両方を押し上げるという弱点を持ちます。 極端な 1 点が加わると許容域が一気に広がり、 その点すら「範囲内」に見えてしまう —— これがマスキング効果です(上で「外れ値を追加」すると再現できます)。 IQR フェンスは順位(Q1・Q3)だけで決まるので、 外れ値を 1 個足しても Q1・Q3 はほぼ動かず、 フェンスも安定します。 平均・SD の頑健性(breakdown point)は事実上 0% ですが、 中央値・四分位は 25% まで汚染に耐えます。
箱ひげ図での役割
下段の箱ひげ図は、 このフェンス計算をそのまま図にしたものです。 箱の長さ = IQR、 箱の中の線 = 中央値(Q2)、 ひげ = フェンス内に収まる最小・最大の実データ点、 ひげの外の点 = 外れ値。 つまり箱ひげ図の「点」は、 まさに $Q_1-k\cdot IQR$/$Q_3+k\cdot IQR$ を超えた値です。
検出したあとの扱い方
フェンスはあくまで外れ値検出の出発点であり、 自動削除の指示ではありません。 入力ミス・計測エラー・分布の裾・本当に貴重な稀少事象のどれなのかを見極める必要があります。 具体的な対処(除外・ウィンズライズ・変換・頑健推定など)は 外れ値の扱い方 と 外れ値 のページで扱います。
📐 3. 四分位
🍰 まずはやさしく
データの区切り方を決めるルールです。
数値でばらつきを正確に計算するために使います。
部活の記録を小さい順に並べて分ける時に使えます。
四分位数の計算方法や箱ひげ図の書き方を学びます。
📐 3. 四分位
| 記号 | 名前 | 意味 |
|---|---|---|
| $Q_1$ | 第1四分位 | 25パーセンタイル(下位 1/4) |
| $Q_2$ | 第2四分位 | 中央値 |
| $Q_3$ | 第3四分位 | 75パーセンタイル(上位 1/4) |
3.1 5数要約 (Five-Number Summary)
- 最小値 (min)
- $Q_1$
- 中央値 ($Q_2$)
- $Q_3$
- 最大値 (max)
1 | print(df['L3221'].describe()[['min','25%','50%','75%','max']]) |
💬 5 数要約は 223,423 / 279,506 / 300,652 / 307,502 / 344,092 円。 中央値から上の Q3 まで 6,850 円しかないのに、 下の Q1 までは 21,146 円あり、 分布は左に裾を引いている。 最小の愛媛県 223,423 円は Q1 から 56,083 円離れており、 これが #8 で唯一の外れ値になる。
3.2 実値計算
9 個のソート済みデータ [10, 20, 30, 40, 50, 60, 70, 80, 90] の四分位:
- $Q_1$(25%):(20 + 30)/2 → 線形内挿で 30 程度
- $Q_2$(50%):中央値 = 50
- $Q_3$(75%):70 程度
- IQR = 70 - 30 = 40
📏 4. IQR(四分位範囲)
$$\mathrm{IQR} = Q_3 - Q_1$$
- 中央 50% のデータが収まる範囲
- 外れ値に頑健(25-75% は外れ値の影響を受けない)
- 正規分布なら IQR ≈ 1.349·σ
- 標準偏差の代替指標として広く使われる
4.1 MAD(Median Absolute Deviation)
$$\mathrm{MAD} = \mathrm{median}(|x_i - \tilde{x}|)$$
中央値からの絶対偏差の中央値。 最も頑健な「ばらつき指標」。 1.4826·MAD で正規分布の σ を推定できる。
1 2 3 4 5 | from scipy import stats mad = stats.median_abs_deviation(df['L3221']) print(f'MAD = {mad:.0f}') print(f'σ推定 (1.4826·MAD) = {1.4826*mad:.0f}') print(f'実 σ = {df["L3221"].std():.0f}') |
💬 MAD 13,682 円から推定した σ は 20,285 円で、 実際の標準偏差 24,144 円より 16% 小さい。 差が出るのは愛媛県のような下側の外れ値が σ を押し上げているためで、 MAD は中央値まわりの半数しか見ないので影響を受けない。 1.4826 という係数は、 正規分布で MAD が σ の 0.6745 倍になることの逆数。
📦 5. 箱ひげ図 (Boxplot)
5数要約と外れ値を 1 枚に集約する可視化。 群間比較に最適。
5.1 ひげの定義
ひげは「最大/最小 within フェンス」までで切る:
- 下ひげ:max(min, $Q_1 - 1.5 \cdot \mathrm{IQR}$)
- 上ひげ:min(max, $Q_3 + 1.5 \cdot \mathrm{IQR}$)
- ひげの外側の点が「外れ値」として個別プロット
1 2 3 4 5 6 | import seaborn as sns import matplotlib.pyplot as plt df['人口規模'] = pd.qcut(df['A1101'], q=3, labels=['小','中','大']) sns.boxplot(data=df, x='人口規模', y='L3221') plt.title('人口規模別の消費支出(二人以上の世帯)') plt.show() |
5.2 バイオリンプロット
箱ひげ + KDE(カーネル密度推定)。 分布形も同時に見える。
5.3 ノッチ付き箱ひげ図
中央値の信頼区間をノッチで表示。 ノッチが重ならないなら 5% で中央値に有意差あり(簡易検定)。
🚨 6. 外れ値検出ルール
6.1 Tukey のフェンス
$$\text{下限} = Q_1 - 1.5 \cdot \mathrm{IQR}, \quad \text{上限} = Q_3 + 1.5 \cdot \mathrm{IQR}$$
「3.0·IQR」を使うと「極端な外れ値」のみを検出。
1 2 3 4 5 6 | q1, q3 = df['A1101'].quantile([0.25, 0.75]) iqr = q3 - q1 lower, upper = q1 - 1.5*iqr, q3 + 1.5*iqr outliers = df[(df['A1101'] < lower) | (df['A1101'] > upper)] print(f'外れ値: {len(outliers)} 件') print(outliers[['Prefecture', 'A1101']]) |
💬 総人口では 9 県が外れ値。 Q3 + 1.5 IQR を超えた側だけで、 下側には 1 件も出ない。 人口は下限 0 で頭打ちがなく右に伸びる分布なので、 Tukey のフェンスは構造的に上側だけを拾う。 東京 1,409 万人は 2 位の神奈川 923 万人より 486 万人多く、 同じ「外れ値」でも程度が違う点は件数からは読めない。
6.2 Z-score ルール
|z| > 3 を外れ値(正規分布なら 0.27%)。 ただし平均・σ が外れ値に引っ張られるため、 ロバスト Z-score(中央値・MAD)の方が良い。
6.3 IsolationForest(ML)
1 2 3 4 | from sklearn.ensemble import IsolationForest iso = IsolationForest(contamination=0.05, random_state=42) df['outlier'] = iso.fit_predict(df[['L3221', 'A1101']]) print(df[df['outlier'] == -1][['Prefecture']]) |
💬 消費支出と総人口の 2 次元で見ると東京・大阪・愛媛の 3 件。 contamination=0.05 を指定したので 47 × 0.05 ≒ 2.4 件が目安で、 出た数はほぼその通り。 #4 の Tukey が人口だけで 9 県を挙げたのに対し、 ここでは人口が大きいだけの埼玉や神奈川は落ちる。 2 変数の組み合わせとして珍しいかを見ているため。
6.4 外れ値の扱い方
- 削除:明らかな計測ミス時のみ
- ウィンザライズ:上下を切り詰める(例:上下 1% で)
- 変換:log / Box-Cox で影響緩和
- 頑健統計の使用:中央値・IQR・MAD
- 頑健モデル:Huber 回帰、 分位点回帰
📈 7. 分位点回帰
OLS は条件付き「平均」を推定するが、 分位点回帰は条件付き「分位点」を推定。 不均一分散・歪んだ分布で有用。
$$\hat{\boldsymbol{\beta}}_\tau = \arg\min_{\boldsymbol{\beta}} \sum_i \rho_\tau(y_i - \mathbf{x}_i^\top \boldsymbol{\beta})$$
$\rho_\tau(u) = u(\tau - \mathbb{1}[u < 0])$(pinball loss)。
1 2 3 4 | import statsmodels.formula.api as smf for tau in [0.1, 0.5, 0.9]: m = smf.quantreg('L322101 ~ L3221 + A1101', data=df).fit(q=tau) # 食料費 ~ 消費支出 + 総人口 print(f'τ={tau}: 消費支出係数={m.params["L3221"]:.4f}') |
💬 消費支出が 1 円増えたときの食料費の増え方が、 下位 10% 層で 0.2395、 中央で 0.2682、 上位 90% 層で 0.2850。 支出の多い世帯ほど食料費の傾きが急という並びだが、 実際の食料費割合は 47 県で 23.9〜31.8%(平均 27.3%)に収まっており、 差は小さい。 分位点回帰は平均に潰さず、 分布のどの高さでも傾きを測れる。
📊 8. ばらつき指標の比較
| 指標 | 定義 | 頑健性 | 推奨 |
|---|---|---|---|
| 標準偏差 | $\sqrt{\mathbb{V}[X]}$ | 弱い | 正規分布 |
| IQR | $Q_3 - Q_1$ | 強い | 外れ値あり |
| MAD | $\mathrm{median}(|x - \tilde{x}|)$ | 最強 | 外れ値多 |
| 範囲 | max - min | 最弱 | 入門・簡易確認 |
| 変動係数 | $\sigma/\bar{x}$ | 弱い | スケール比較 |
$n$ 個の観測値を昇順に並べた順序統計量を $x_{(1)} \le x_{(2)} \le \dots \le x_{(n)}$ とする。 一般化された四分位数 $Q_p$($p \in [0,1]$)は補間位置 $h$ から計算される:
$$h = (n - 1) p + 1, \quad Q_p = x_{(\lfloor h \rfloor)} + (h - \lfloor h \rfloor) \, (x_{(\lceil h \rceil)} - x_{(\lfloor h \rfloor)})$$
これが NumPy 既定 (linear / type=7) の式。 $p = 0.25, 0.5, 0.75$ がそれぞれ Q1, Q2, Q3。
$$\text{IQR} = Q_3 - Q_1$$
Tukey の外れ値フェンス: 内側フェンス(mild outlier)と外側フェンス(extreme outlier):
$$\text{下限} = Q_1 - 1.5 \cdot \text{IQR}, \quad \text{上限} = Q_3 + 1.5 \cdot \text{IQR}$$
$$\text{外側下限} = Q_1 - 3.0 \cdot \text{IQR}, \quad \text{外側上限} = Q_3 + 3.0 \cdot \text{IQR}$$
📐 補強:分位点の数学的背景・推定誤差・現代的応用(R435)
K. 分位点の数学的定義(厳密版)
確率変数 X の累積分布関数を F(x) とすると、 p 分位点 Q(p) は F(Q(p)) = p を満たす値として定義される。 ただし F が連続でない(離散分布、 標本データの経験分布など)場合は、 厳密には次の一般化逆関数(generalized inverse)で定義する:
Q(p) = inf { x ∈ ℝ : F(x) ≥ p }
この定義により、 階段関数(経験 CDF)でも一意に分位点が定まる。 標本データの場合、 n 個の観測値を 順序統計量 X_(1) ≤ X_(2) ≤ … ≤ X_(n) に並べると、 経験分位点 Q̂(p) は p に応じて X_(k) の値(k = ⌈np⌉)あるいは隣接する 2 点の補間値となる。 Hyndman–Fan (1996) の 9 つの定義は、 すべて「どの 2 点をどう補間するか」のバリエーションである。
L. 分位点推定の標準誤差
標本分位点 Q̂(p) の漸近的標準誤差は次の式で与えられる:
SE[Q̂(p)] ≈ √(p(1−p) / (n · f(Q(p))²))
ここで f は確率密度関数。 この式は2 つの重要な含意を持つ:
- 裾の分位点(p が 0 または 1 に近い)ほど推定精度が低い:p=0.99 や p=0.01 では p(1−p)=0.0099 と小さくなるが、 同時にその位置での密度 f(Q(p)) も通常非常に小さい。 結果として比率は大きくなり、 標準誤差が増大する。 SSDSE-B-2026 で消費支出(L3221)の 99 パーセンタイルを推定すると、 47 都道府県では極めて不安定な推定になる。
- 密度が低い領域(多峰性の谷など)では分位点の標準誤差が大きくなる:分布の窪み部分にちょうど分位点が位置すると、 標本ごとに大きく揺らぐ。 多峰性データでは中央値ですら不安定になる場合がある。
実務的には、 密度 f が未知の場合はカーネル密度推定で推定するか、 ブートストラップで経験的に標準誤差を求めるのが頑健である。 後者は scipy.stats.bootstrap や独自実装で容易に得られる。
M. ブートストラップで分位点の信頼区間を作る
分位点の信頼区間は、 順序統計量に基づくノンパラ法とブートストラップ法の 2 通りがある。 順序統計量法では、 中央値の 95% 信頼区間として X_(k) ≤ Median ≤ X_(n−k+1) の範囲を選ぶ(k は二項分布の累積で決定)。 これは n=47 の場合、 中央値 X_(24) について 95% 信頼区間は概ね [X_(18), X_(30)] になる。 一方ブートストラップでは、 標本から復元抽出を B 回(典型 B=10,000)行い、 それぞれの分位点を計算した分布の 2.5% / 97.5% パーセンタイルを区間とする。 後者は任意の分位点(Q1, Q3, 90 パーセンタイルなど)にも適用でき、 分布形を仮定しない柔軟さがある。
SSDSE-B-2026 の消費支出(L3221・二人以上の世帯・2023 年度・n=47)で中央値 300,652 円の 95% ブートストラップ信頼区間を計算すると、 概ね [294,800 円, 305,600 円](B=10,000・seed=42 での実測)になる。 この幅は中央値の約 3.6% で、 「中央値は安定」と一見思える 47 都道府県でも、 無視できない不確実性があることが分かる。 政策議論で「中央値が前年比 +1.5% 動いた」と主張するときは、 この信頼区間の幅(±2% 弱)と比較して、 動きが信号なのかノイズなのかを判断する必要がある。
N. 機械学習における IQR の使い方
scikit-learn の RobustScaler は次の変換を行う:
x_scaled = (x − Q2) / IQR
この変換により、 外れ値が含まれる特徴量でも安定したスケーリングが可能になる。 StandardScaler(平均と標準偏差を使う)は数件の極端な値で平均と標準偏差が歪み、 残りの大多数のデータが [-0.1, 0.1] のような狭い範囲に押し込まれてしまう。 これに対し RobustScaler はデータ点 50% を [−0.5, 0.5] に揃え、 外れ値は外側にはみ出すだけで本体の分布が保たれる。
SVM、 k-NN、 ニューラルネットなど距離・スケールに敏感なアルゴリズムでは、 外れ値を含むデータに対してRobustScaler のほうが汎化性能が高くなることが多い。 一方、 決定木系(Random Forest, XGBoost, LightGBM)は分位点ベースの分割を内部で行うため、 そもそもスケーリング不要だが、 外れ値処理の意思決定としては IQR を一つの基準にできる。
O. 異常検知における分位点ベース手法
時系列の異常検知では、 移動 IQR(rolling IQR)が広く使われる。 過去 30 日の Q1, Q3 を計算し、 当日の値が Q3 + 1.5·IQR を超えれば異常としてアラート。 この手法は分布形を仮定せず、 平均的な季節変動・周期性に追従しながら異常を捉えるため、 サーバー監視、 IoT センサー、 金融トランザクションなど幅広く採用されている。
高度な手法としては、 分位点回帰による予測区間がある。 「平均」ではなく「中央値・Q1・Q3」を回帰モデルで予測し、 実測値が Q1−1.5·IQR を下回るか Q3+1.5·IQR を上回ったら異常とする。 これは LSTM や Transformer のような深層モデルでも、 損失関数を pinball loss(分位点損失)に置き換えることで実装できる。 推定された予測区間そのものが意思決定の対象になる場合(電力需要予測の上限/下限、 リスク管理など)にも本質的に有用である。
P. 累積分布と分位点の対応関係を「描く」
分位点と累積分布関数(CDF)は、 同じ関数の見方を変えただけである。 CDF を縦軸 = 累積確率、 横軸 = 値で描いたグラフを「90 度回転して縦横を入れ替える」と、 分位点関数(quantile function)になる。 つまり Q(p) は CDF のグラフの「水平線 y=p との交点」として読める。
この視覚的な対応関係は、 教材で「分位点とは何か」を説明する最も直感的な方法である。 経験 CDF(ECDF)プロットの上に水平線 y=0.25, 0.50, 0.75 を引けば、 Q1, Q2, Q3 がそのまま見える。 SSDSE-B-2026 の都道府県データで ECDF を描けば、 「下から 25% にあたるのはどの県か」が一目で分かる。 このような「分布の絵で議論する」習慣を持つことで、 平均値の単純比較に陥ることを防げる。
Q. 教材としての箱ひげ図の使い方(教育的観点)
高校・大学初等教育では、 箱ひげ図は「分布の概形を 5 つの数値で要約する道具」として導入される。 ただし学習者がよく陥る誤解として:
- 「箱の中に点が 50% 入っている」を「箱の中央あたりにデータが集中している」と読んでしまう(実際は均等分布の場合も箱の幅は同じ)
- 「ひげが長いほどデータが多い」と誤読する(ひげは max/min または 1.5·IQR の位置を示すだけで、 個数とは無関係)
- 「中央値の位置が箱の中央にない=外れ値がある」と短絡する(実際は分布の歪みを示しているが、 必ずしも外れ値の存在ではない)
- 「ひげの外の点(外れ値マーカー)はすべて除外すべきデータ」と思い込む
これらの誤解を防ぐには、 教材内で「同じ箱ひげ図に対応する複数の分布形」を並べて見せることが効果的。 ベル型・一様・双峰・指数分布から、 中央値・Q1・Q3 がほぼ同じになる例を作って提示すれば、 「箱ひげ図だけでは分布形は決まらない」ことを身体化できる。 そのうえで、 ヒストグラム・ECDF・バイオリン図を併用する習慣をつけてもらうのが望ましい。
R. SSDSE-B-2026 を使った 5 分間ミニ演習(教材例)
教室での 5 分間ミニ演習として、 次のような流れが推奨される。 学習者は SSDSE-B-2026 を pandas で読み込み(2023 年度に絞る)、 「消費支出(L3221)」「総人口(A1101)」「食料費(L322101)」のいずれかの列について次の作業を行う:
- (1) 5 数要約を計算:
df['L3221'].describe()で min, Q1, Q2, Q3, max を確認 - (2) 箱ひげ図を描画:
df.boxplot(column='L3221')で図示 - (3) Tukey フェンスで外れ値判定:手計算 or
scipy.stats.iqrで IQR を出し、 上限・下限フェンスを越える県を抽出 - (4) フラグされた県名を確認:総人口なら東京・神奈川など上位 9 都道府県(上側)、 消費支出なら愛媛県(下側)が出てくる。 「これは測定エラーか、 真に極端な個体か」を議論
- (5) 中央値と平均値を比較:両者がどれだけ違うか、 なぜ違うかを分布の形から説明
この演習を通じて、 学習者は「分位点」を単なる数式ではなく、 「実データの現実」を読み解くための道具として身につけることができる。 教材としては、 必ず「フラグされた県は何県か」「その県名は何か」「平均と中央値はどう違ったか」を学習者自身に発見させる流れにすることが、 教育効果を最大化する。
S. 統計報告における「分布の語り方」テンプレート
論文や報告書で分布を語るときの推奨フォーマットを 3 段階で示す:
段階 1(最小): 消費支出(L3221・2023 年度)なら「Median = 300,652 円(IQR: 279,506–307,502)」のように、 中央値とその IQR をペアで報告。 これだけで分布の中心とばらつきの最低限が伝わる。
段階 2(標準): 上記に加えて、 「Mean = 295,856 円(SD = 24,144)」を併記。 中央値と平均の比較で分布の歪みを示唆。 さらに「Range: 223,423–344,092」も併記すると、 裾の極値が見える。
段階 3(厳密): 上記に加えて、 ブートストラップ 95% 信頼区間(中央値: [294,837, 305,586]、 B=10,000・seed=42)、 歪度(skewness)、 尖度(kurtosis)、 シャピロ–ウィルク検定の p 値(正規性)、 そして必要に応じて外れ値の県名を明記。 査読論文や政策報告書のような厳密さを求められる場面で用いる。
読み手のリテラシーや目的に応じて段階を選ぶことで、 「過剰でも不足でもない」適切な情報量で分布を語ることができる。 SSDSE-B-2026 を使った演習でも、 学習者にこの 3 段階を意識させながら報告書を書かせると、 統計的な文書記述スキルが伸びる。
T. まとめ:四分位・IQR が「日常感覚」と一致する場面
四分位という概念は、 実は日常言語の感覚と非常に近い。 「真ん中くらい」「上位四分の一」「下位四分の一」「半数の人」といった表現は、 そのまま中央値・Q3・Q1・IQR に対応する。 つまり「平均値・分散」よりも「分位点・IQR」のほうが、 受け手の直感に親和的なのである。
この親和性を活かして、 政策担当者や一般市民への報告では分位点ベースの表現を主軸に据えるのが、 コミュニケーション上も統計的にも合理的である。 「平均年収 500 万円」と聞いても多くの人は「自分は平均より下だ」と感じるが、 「中央値 430 万、 真ん中 50% は 320-580 万」と聞けば自分の位置を正確に把握できる。 これが分位点ベース統計の真の価値である。 SSDSE-B-2026 を使った教育・分析でも、 この観点を常に意識することで、 統計を「数字遊び」から「意思決定の言語」へと昇華させることができる。
🌍 補強:国際比較・分野別事例・関連トピックの整理(R435)
U. 国際機関での分位点活用
OECD、 世界銀行、 IMF などの国際機関は、 各国の所得分布・教育格差・健康格差を比較するときに分位点(特に十分位 decile, 五分位 quintile)を主軸に据える。 例えば OECD の「Income Distribution Database」では、 各国の所得を 10 分位に分け、 「最下位 10% の所得が中央値の何% か(P10/P50)」「上位 10% が中央値の何倍か(P90/P50)」を国際比較指標としている。 これは平均と分散による比較では捉えられない分布の形状そのものの違いを可視化する手法である。
SSDSE-B-2026 の都道府県データに同じ発想を適用すると、 「Q3/Q1 比」「最大/最小比」「ジニ係数」「タイル指数」などの指標を併記することで、 県間格差の構造を立体的に把握できる。 単純な平均比較に留まらず、 分布の形と格差の量を同時に語れるようになる。
V. 医療分野での分位点活用
小児科の発育曲線、 成人の血圧基準、 BMI 分布など、 医療では「年齢・性別ごとの分位点(percentile)」が患者個人の評価基準として広く使われる。 「身長が 90 パーセンタイルにある」とは「同年齢同性別の中で上位 10% にあたる身長」という意味で、 平均からのズレ(Z-score)よりも直感的かつ非対称な分布(成長曲線)に頑健である。
医師は患者ごとに分位点を継続観測し、 急速な変動(例:90 パーセンタイル→50 パーセンタイルへの低下)があれば疾患を疑う。 こうした「分位点の縦断的追跡」は分散統計の枠組みでは表現しづらく、 分位点ベース統計の独壇場である。
W. 金融分野での分位点活用(VaR と CVaR)
金融リスク管理の核心指標であるVaR(Value at Risk)は、 損失分布の分位点そのものである。 「99% VaR が 1 億円」とは「損失が 1 億円を超える確率は 1% 以下」という意味であり、 損失分布の 99 パーセンタイルを推定する作業に他ならない。 またCVaR(条件付き VaR、 Expected Shortfall)は VaR を超えた領域の平均で、 「裾の重さ」を考慮した補完的指標として導入されている。
VaR の推定には、 ヒストリカル法(経験分位点)、 パラメトリック法(分布仮定)、 モンテカルロ法(シミュレーション)の 3 通りがあり、 それぞれに利点と限界がある。 ヒストリカル法は IQR ベースの考え方に近く、 分布形を仮定しない反面、 観測されていない極端な損失は捉えられない。 こうしたトレードオフは、 SSDSE-B-2026 で外れ値分析するときの判断と本質的に同じ構造を持つ。
X. 教育分野での分位点活用
学校教育では、 各児童・生徒の標準化テスト得点が全国分布のどの分位点にあるかを進路指導や個別支援に活用する。 「数学が 75 パーセンタイル」とは「全国の中で上位 25% に位置する」という意味で、 偏差値より直感的である。 偏差値は平均 50・標準偏差 10 の正規分布を仮定するため、 分布が歪んでいると意味が崩れる。 一方パーセンタイルは分布形を問わず常に解釈可能である。
国レベルの教育評価(PISA、 TIMSS など)でも、 OECD は各国を平均で比較するだけでなく、 「下位 25% パーセンタイル」「上位 25% パーセンタイル」「分布の歪み」を分析する。 これにより「平均が高くても下位層が極めて弱い国」「平均は中位だが均等性が高い国」など、 同じ平均値の裏にある分布の違いを政策論議に持ち込むことができる。
Y. 環境・気象データでの分位点活用
気象庁や IPCC(気候変動に関する政府間パネル)は、 気温・降水量・台風強度などの極値分位点を気候変動の指標として用いる。 「100 年に 1 度の極端な気温(99 パーセンタイル)」「過去 30 年の最大値分布の中央値」など、 分位点ベースの表現で異常気象の頻度変化を定量化している。 これは平均気温の上昇よりも、 一般市民・政策担当者にとって直感的に伝わりやすい。
気候モデルの予測でも、 分位点回帰(quantile regression)が「将来の極値分布の変化」を捉える基本ツールとして使われる。 平均値の予測だけでは捉えられない「裾が長くなる」「裾が低くなる」といった非対称な変化を、 分位点ごとに別個に推定できるのが強みである。 こうした文脈で IQR や四分位範囲は、 単なる教科書的概念ではなく地球規模の意思決定の基盤指標として機能している。
Z. まとめと次のステップ
四分位・IQR・分位点・箱ひげ図は、 単に「平均と分散の代替」ではない。 むしろ「分布形を仮定しない頑健な統計フレームワーク」として、 国際機関の格差比較、 医療の患者評価、 金融のリスク管理、 教育の到達度評価、 気候変動の極値分析など、 現代社会の意思決定の多くの局面で基幹的役割を果たしている。 SSDSE-B-2026 のような公的データを通じて、 これらの概念を実データで操作する経験は、 統計学を「数式」から「現実の意思決定言語」へと変換する基礎力を養う。
次のステップとしては、 (1) 分位点回帰(statsmodels の QuantReg)で SSDSE-B の「食料費(L322101) ~ 消費支出(L3221)」「出生数(A4101) ~ 総人口(A1101)」の関係を Q1/Q2/Q3 別に推定する、 (2) ブートストラップで主要分位点の信頼区間を計算する、 (3) RobustScaler を使った機械学習パイプラインを構築する、 (4) 多群の比較で Kruskal–Wallis と Dunn 検定を実装する、 などが推奨される。 こうした実装演習を通じて、 分位点ベース統計の実務的価値を体感することで、 単なる教科書知識を超えた応用力が身につく。
最後に強調したいのは、 統計分析のゴールは「数値の正確さ」ではなく「意思決定の質の向上」だということである。 四分位・IQR は、 そのゴールに直接寄与する道具であり、 平均と分散の補完物ではなく独立した重要なツール群として位置づけるべきである。 SSDSE-B-2026 を題材とした学習・実務を通じて、 この視点を身体化することが、 統計リテラシーの中核を形作る。
🧭 補強:実装ベストプラクティスと再現性のチェックポイント(R435)
AA. 再現性の確保:分位点計算結果を 100% 一致させるための作法
同じデータ・同じ目的でも、 ツール(Python の numpy・pandas・scipy、 R、 SAS、 Excel)と補間タイプの違いで結果が分単位で異なる。 学術論文や政策報告書での再現性を確保するには次の手順が必要:
- ツール名・バージョンを明記: 「numpy 1.26.0 の
quantile(method='linear')」のように具体的に。 - 欠損値の扱いを明記:
NaNを除外したか、 補完したか、 リスト ワイズ削除したか。 結果が全く違う数値になる。 - ソート前の同値処理: 同じ値が複数ある場合の順序統計量の決め方を明示。
- 標本サイズ n を併記: 同じデータでも母集団サイズ・サンプル方法で n が変わると Q1/Q3 は変わる。
- 乱数シードを記録: ブートストラップ信頼区間を出した場合、 同じシードを使えば再現可能。
SSDSE-B-2026 のような公的データを扱う場合、 「SSDSE-B-2026.csv 元データそのまま、 numpy 1.26.0 の quantile(method='linear') 使用、 欠損値なし、 n=47」のように一行で書くだけで、 後の研究者・分析者が完全に再現できる状態を作れる。 これは「分析結果は再現可能性が命」という統計実務の鉄則を守るための最低限の作法である。
BB. パイプライン設計:分位点ベース処理を組み込む例
scikit-learn の Pipeline に分位点ベース処理を組み込むことで、 学習データと未知データに対して同一の前処理ロジックを保証できる。 典型的なパイプラインは:
このパイプラインは「外れ値に頑健な特徴量変換 → 外れ値に頑健なモデル」という一貫した設計で、 SSDSE-B-2026 のような実データに対して安定した予測を生む。 比較として SimpleImputer(strategy='mean') → StandardScaler → LinearRegression の組み合わせを使うと、 数件の極値県(東京・大阪)に引きずられて全体の予測がブレることがある。
CC. ダッシュボード表示での分位点の見せ方
BI ダッシュボード(Tableau、 Power BI、 Looker など)で分位点を表示するベストプラクティス:
- 箱ひげ図に必ず点群を重ねる: 箱ひげ単独だと分布形が見えないので、 swarmplot や jitter strip を併用。
- 中央値・Q1・Q3 の数値を吹き出しで表示: マウスオーバーで見えるようにする。
- 外れ値ポイントには識別ラベル: 「東京都」「大阪府」のように県名・組織名を直接表示すると意思決定に直結する。
- 時系列ダッシュボードでは IQR バンドを描画: 中央値の線に Q1-Q3 の帯を重ねると、 中央集団のばらつきが時間とともにどう変わるかが一目で分かる。
- 群間比較ではノッチ付き箱ひげ図: ノッチが重ならない箱は中央値が有意に異なる可能性が高い。
これらの表示原則を守ることで、 ダッシュボード閲覧者(経営層、 自治体首長、 一般市民)が誤読せずに分布を理解できる。 単に「平均値の棒グラフ」と「ヒストグラム」を並べるだけのダッシュボードよりも、 はるかに高い情報伝達効率を持つ。
DD. 分位点ベース機械学習モデルの選び方
予測タスクで「中央値(または任意の分位点)を予測したい」場合の主要モデル:
- 線形回帰系:
statsmodels.QuantReg(古典的分位点回帰)、sklearn.linear_model.QuantileRegressor(scikit-learn 公式)。 解釈性が高い。 - 勾配ブースティング系:
sklearn.ensemble.GradientBoostingRegressor(loss='quantile', alpha=p)、lightgbmのobjective='quantile'、xgboostの Tweedie 損失派生など。 非線形に強い。 - ニューラルネット: TensorFlow / PyTorch でカスタム pinball loss を実装。 複数分位点を同時に予測する Multi-Quantile DNN も普及。
- 確率予測モデル: NGBoost、 conformal prediction など、 分布全体(任意の分位点)を返す手法。 不確実性付き予測の現代的標準。
SSDSE-B-2026 のような小規模データ(n=47)では、 まず statsmodels.QuantReg から始めて、 結果の解釈とモデル前提の妥当性を確認するのが望ましい。 データ量が増えたら(市町村レベル、 個人レベル)勾配ブースティングや NN ベース手法に進む流れが自然である。
EE. 最終チェック:報告書を読み手の視点で見直す
分位点ベース統計を使った報告書を仕上げる前に、 次の問いで自己チェックする:
- 受け手は誰か? 専門家・政策担当者・一般市民で必要な詳細度が違う。
- その受け手は「中央値」と「平均値」の違いを理解しているか? していないなら、 簡潔な定義文を添える。
- 箱ひげ図を出すなら、 凡例で各要素(箱、 ひげ、 外れ値マーカー)を明示したか?
- 分位点の数値だけでなく、 県名・組織名などの具体例を併記したか? 抽象数値だけでは記憶に残りにくい。
- 外れ値を除外した分析と、 含めた分析の両方を提示したか? 一方だけだと意思決定者の判断材料が不足する。
- 分位点の値が「四捨五入の桁数」によって変わるリスクを認識しているか? 報告書では桁数を統一しておく。
- 「IQR」「Q1」「Q3」などの用語を初出時に説明したか? 一般読者向けなら必須。
これらの問いに「Yes」と答えられる報告書は、 統計的にも倫理的にもコミュニケーション的にも質が高い。 SSDSE-B-2026 を使った教育演習でも、 学習者にこれらの問いを自己チェックさせる習慣をつけることで、 単なる数値分析を超えた「意思決定言語としての統計」を体得できる。
FF. 関連用語の整理(再掲・補完)
本記事で扱った概念と、 さらに学ぶための関連用語を分野別に整理する。 各用語は別記事で詳細を扱っているため、 リンク先で深掘りできる:
- 記述統計の基本: 中央値、 平均、 分散、 標準偏差、 範囲
- 分布の特徴: ヒストグラム、 箱ひげ図、 歪度、 尖度
- 頑健統計: MAD、 ロバスト回帰、 トリム平均、 Winsor 化、 M-推定量
- 外れ値検出: Tukey フェンス、 Z-score、 IsolationForest、 LOF、 One-Class SVM
- 分位点回帰: QuantReg、 勾配ブースティングの quantile loss、 pinball loss、 conformal prediction
- 関連視覚化: バイオリン図、 stripplot、 swarmplot、 ECDF、 ridgeline plot
これらの用語群を横断的に学ぶことで、 「四分位・IQR」を中心とした分位点ベース統計の体系を立体的に理解できる。 単独で覚えるのではなく、 関連用語と組み合わせて学ぶことで、 実務応用の幅が大きく広がる。
GG. 補論:四分位を使った「分布の比較診断」
2 つ以上の分布を比較するときの診断テクニックとして、 分位点を活用する方法は多岐にわたる。 単純な平均比較を超えて分布全体を比較できる手法を以下に整理する。
- QQ プロット(Quantile-Quantile Plot): 2 つの分布の同じ分位点を縦軸・横軸にプロット。 一直線に並べば分布形が等しい、 曲がっていれば歪みが異なる。 SSDSE-B-2026 で「都市部県の所得分布」と「地方県の所得分布」を QQ プロットすると、 単なる平均差以上の構造的違いが見える。
- 分位点差プロット(Difference Plot): 2 つの分布の同じ分位点の差を p に対してプロット。 「下位 25% では 50 万円差、 上位 25% では 200 万円差」のように、 分布のどこで差が大きいかが視覚化される。
- 分位点比プロット(Ratio Plot): 差ではなく比を取ることで、 相対的な格差の構造を見る。 教育費・医療費など対数的に変動する量で有用。
- 累積分位点プロット(Lorenz Curve): 経済格差で標準的な手法。 「下位 N% が全体の所得の何 % を持つか」を曲線化し、 ジニ係数(曲線と対角線の面積比)で要約。
これらの診断手法は、 単純な「平均値棒グラフ + エラーバー」では絶対に得られない「分布構造の比較」を可能にする。 政策評価で「介入前と介入後の所得分布の変化」を見るとき、 中央値や平均値だけでは「介入が誰に効いたか」が見えないが、 分位点差プロットや QQ プロットを使えば「下位層に強く効いた」「上位層には効かなかった」といった具体的な解釈が得られる。
HH. 補論:分位点関連の Python ライブラリ早見表
分位点・IQR 関連で実務的に使う Python ライブラリの代表機能と用途:
numpy.quantile / numpy.percentile: 基本の分位点計算。 9 種の補間 method 指定可。pandas.DataFrame.quantile: DataFrame 全列または特定列の分位点。 グループ別groupby().quantile()も強力。pandas.DataFrame.describe(): count, mean, std, min, 25%, 50%, 75%, max の一括表示。 EDA の第一手。scipy.stats.iqr: IQR を直接計算。 軸指定や補間 method も指定可。scipy.stats.mstats.mquantiles: Hyndman–Fan の 9 タイプを α, β で指定可能。scipy.stats.bootstrap: 分位点の信頼区間をブートストラップで計算。statsmodels.regression.quantile_regression.QuantReg: 古典的分位点回帰。sklearn.preprocessing.RobustScaler: 中央値・IQR を使ったスケーリング。sklearn.linear_model.QuantileRegressor: scikit-learn 公式の分位点回帰(L1 正則化付き)。sklearn.ensemble.GradientBoostingRegressor(loss='quantile'): 勾配ブースティングで分位点予測。matplotlib.pyplot.boxplot/seaborn.boxplot/plotly.express.box: 箱ひげ図の描画。seaborn.violinplot/seaborn.stripplot/seaborn.swarmplot: 分布の補助視覚化。
これらのライブラリは互いに補完関係にあり、 単独で使うのではなく組み合わせて使うことで分位点ベース統計の真価が発揮される。 SSDSE-B-2026 のような実データで一通り触れる経験を持つことが、 実務力の基盤となる。
II. 補論:四分位を「教える」ためのストーリーライン
教育場面で四分位を導入するとき、 次の順番で語ると学習者の理解が早い。 まず「ある日のクラスのテスト点数」のような身近な例から始めて、 「最低点・最高点・中央の点」を読み取らせる。 次に「上の半分・下の半分」をさらに半分にする発想を導入し、 「全体を 4 等分するとどんな数値になるか」を考えさせる。 これが Q1・Q2・Q3 への自然な導入となる。
続いて「真ん中 50% の幅」としての IQR を導入し、 「上位 25% と下位 25% は『目立つけれど少数』」という直感を獲得させる。 ここで初めて箱ひげ図を導入すれば、 5 つの数値(min, Q1, Q2, Q3, max)の視覚化としての必然性が伝わる。 最後に SSDSE-B-2026 のような実データで具体的な県名を入れた箱ひげ図を見せれば、 「東京・大阪は外れ値マーカー、 中央値は和歌山あたり」という「物語と数値の対応関係」が記憶に定着する。
このストーリーラインは、 一見遠回りに見えるが、 数式から入る教科書的アプローチよりも長期記憶への定着率が高い。 統計教育の研究でも、 「身近な例 → 直感 → 視覚化 → 実データ → 数式」の順が推奨されている。 四分位・IQR はこの順番に最も適した素材の一つであり、 統計入門の早期段階で導入する価値が極めて高い。
JJ. 補論:「やってみよう」課題の設計鉄則
学習者向けの「やってみよう」課題を設計するときには、 次の鉄則を守ると効果が高い。 まず「データを実際に動かす」こと。 静的な数値表ではなく、 SSDSE-B-2026 のような実データを pandas に読み込ませて、 自分の手で describe() や quantile() を呼ばせる。 次に「結果を予想させてから実行」させること。 「東京の所得は何パーセンタイル?」と先に問い、 その後で計算する。 予想と結果のズレが最大の学習機会となる。
最後に「結果を言語化させる」こと。 数値を出して終わりではなく、 「中央値は X、 IQR は Y、 これは何を意味するか」を 3 行程度で書かせる。 この言語化作業を通じて、 統計的事実が「読み解ける物語」として学習者の中に定着する。 SSDSE-B-2026 を題材にすれば、 「総人口(2023 年度)の中央値が鹿児島県」「Q3 が京都府と広島県の間」「東京が外れ値」のように、 県名と数値の対応で記憶が立体化される。 これが分位点ベース統計の教材設計における最重要ポイントである。
さらに発展課題として、 「中央値前後で 2 群に分けて、 別の変数(総人口・出生率・地価)と関連を調べる」「Q3 以上の県だけを抽出して、 その特徴を多変量で記述する」「分位点回帰で『食料費 ~ 消費支出』を Q1/Q2/Q3 別に推定する」などを設定すると、 学習者は分位点を出発点にした多変量分析を自然に体験できる。 これは単なる教科書的演習を超えた、 真のデータサイエンス入門となる。
こうした課題群を順に解いていくことで、 四分位・IQR は「箱ひげ図を描くための数値」から「実データから示唆を引き出すための語彙」へと役割が拡張する。 SSDSE-B-2026 を中心に、 学習者は実データの手応えとともに、 統計の応用力を体系的に身につけることができる。 これこそが、 ジャストインタイム型データサイエンス教育が目指す「知識から実行力へ」の転換点である。 教える側も学ぶ側も、 この変化を意識して向き合うことで、 統計教育の質が一段引き上がる。 四分位・IQR は、 その変化の起点として最適な題材である。
🔬 17. パーセンタイル計算法の数値差
🔬 17. パーセンタイル計算法の数値差
9種類のメソッドで結果がどのくらい違うかを比較:
1 2 3 4 5 6 | import numpy as np x = df["L3221"].values for m in ['lower', 'higher', 'nearest', 'midpoint', 'linear']: q1 = np.percentile(x, 25, method=m) q3 = np.percentile(x, 75, method=m) print(f'method={m}: Q1={q1:.0f}, Q3={q3:.0f}, IQR={q3-q1:.0f}') |
💬 5 つの方法で IQR が 27,306〜28,054 円と 750 円ほど違う。 47 個のデータで 25% 点はちょうど 12 番目と 13 番目の間に落ちるため、 どちらを取るか(lower / higher)内挿するか(linear)で値が動く。 nearest だけ IQR が 27,306 と小さいのは、 Q1 は上側 279,880、 Q3 は下側 307,186 に丸められて幅が両側から狭まったため。 既定の linear と midpoint は一致する。
補間位置 $h = (n-1)p + 1$ の読み方: $n$ 個のデータを 1, 2, ..., $n$ 番目に並べたとき、 $p \cdot 100$ パーセンタイルの「理想的な位置」を表す実数値。 $p = 0.5$、 $n = 47$ なら $h = 46 \cdot 0.5 + 1 = 24$ となり、 ちょうど 24 番目が中央値。 $h$ が整数でないとき(例 $h = 12.75$)、 12 番目と 13 番目の値を 0.75 : 0.25 の重みで補間します。
$Q_p = x_{(\lfloor h \rfloor)} + (h - \lfloor h \rfloor)(x_{(\lceil h \rceil)} - x_{(\lfloor h \rfloor)})$ の読み方: 右辺の第 1 項 $x_{(\lfloor h \rfloor)}$ は「$h$ を切り下げた整数番目の値」、 第 2 項は「上下の値の差に補間率 $(h - \lfloor h \rfloor)$ を掛けた量」。 つまり「下の値からスタートし、 上の値との差の何 % まで進むか」を表す線形補間の式です。 $h$ が整数なら第 2 項は 0 となり、 そのままその順位の値が四分位数。
1.5 IQR フェンスの数式を言葉で読み解く: $Q_1 - 1.5 \cdot \text{IQR}$ は「箱の下端から、 箱の長さの 1.5 倍下に伸ばした位置」。 これより小さい値を「分布の素性に対して例外的に小さい」と判定。 上端も同様。 なぜ「1.5」か? 正規分布だと $Q_1 \approx \mu - 0.6745 \sigma$、 $Q_3 \approx \mu + 0.6745 \sigma$ なので、 IQR $\approx 1.349 \sigma$、 $1.5 \cdot \text{IQR} \approx 2.0 \sigma$。 つまり「±2.7σ 相当」を内側フェンスとしており、 正規分布で外側に出る確率は約 0.7%。 Tukey はこれを「珍しい」の妥当な閾値として経験的に選んだ、 という背景があります。
🧮 SSDSE-B-2026 実値計算例 — 「消費支出(L3221・二人以上の世帯・月額)」の Q1/Q2/Q3 と IQR
2023 年度・47 都道府県の消費支出分布を四分位で記述し、 外れ値(Tukey フェンス)を抽出します。
| 指標 | SSDSE-B 実測値(2023 年度) | 解釈 |
|---|---|---|
| Q1(25%点) | 279,506 円 | 下位 1/4 県の境 |
| Q2(中央値) | 300,652 円 | 中央 24 番目の県(静岡県) |
| Q3(75%点) | 307,502 円 | 上位 1/4 県の境 |
| IQR | 27,996 円 | 中央 50% の幅 |
| 下フェンス Q1−1.5·IQR | 237,513 円 | これ以下は外れ値候補(愛媛県 223,423 円が該当) |
| 上フェンス Q3+1.5·IQR | 349,495 円 | 最大の埼玉県(344,092 円)でも超えない |
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) x = df[df['SSDSE-B-2026'] == 2023]['L3221'] # 消費支出(2023年度) q1, q2, q3 = x.quantile([0.25, 0.5, 0.75]) iqr = q3 - q1 low, high = q1 - 1.5 * iqr, q3 + 1.5 * iqr print(f'Q1={q1:.0f}, Q2={q2:.0f}, Q3={q3:.0f}, IQR={iqr:.0f}') print(f'下フェンス={low:.0f}, 上フェンス={high:.0f}') outliers = df.loc[x[(x < low) | (x > high)].index, ['Prefecture','L3221']] print('外れ値県:'); print(outliers) |
💬 Q1 279,506・Q2 300,652・Q3 307,502 円、 IQR 27,996 円。 フェンスは 237,513〜349,495 円で、 外れ値は愛媛県 223,423 円の 1 件だけ。 最大の埼玉県 344,092 円は上フェンスの内側に収まる。 index 444 は元 CSV の行番号で、 12 年度分あるため 0 始まりで 37 番目(都道府県コード 38)の愛媛県が 37 × 12 = 444 行目に来る。
🧮 実値で計算してみる(SSDSE-B-2026 都道府県人口 47 件)
47 都道府県の総人口(A1101)を昇順にソートし、 Q1・Q2・Q3 と IQR、 そして 1.5 IQR フェンス外の外れ値を手計算で再現してみます。
$n = 47$ なので補間位置は次の通り:
h(Q2) = (47 - 1) × 0.50 + 1 = 24.0 → 24 番目そのもの
h(Q3) = (47 - 1) × 0.75 + 1 = 35.5 → 35 番目と 36 番目の平均
SSDSE-B-2026 の値を昇順に並べたとき:
| 順位 | 県 | 総人口 |
|---|---|---|
| 1 | 鳥取県 | 537,000 |
| 12 | 山形県 | 1,026,000 |
| 13 | 宮崎県 | 1,042,000 |
| 24(中央) | 鹿児島県 | 1,549,000 |
| 35 | 京都府 | 2,535,000 |
| 36 | 広島県 | 2,738,000 |
| 47 | 東京都 | 14,086,000 |
よって四分位数は:
Q2 = 1,549,000
Q3 = (2,535,000 + 2,738,000) / 2 = 2,636,500
IQR = Q3 - Q1 = 2,636,500 - 1,034,000 = 1,602,500
1.5 IQR フェンス:
上限 = 2,636,500 + 1.5 × 1,602,500 = 5,040,250
上限を超える外れ値: 東京・神奈川・大阪・愛知・埼玉・千葉・兵庫・福岡・北海道 の 9 都道府県
→ IQR は約 160 万人。 つまり「中位 50% の都道府県」は人口 103 万〜264 万人のレンジに収まっている。 一方で9 都道府県が上側に外れ値として検出された。 これは正規分布的に「珍しい」を意味するのではなく、 都市集中の構造的な現実を反映している。 1.5 IQR フェンスは「外れ値検出の出発点であって最終判断ではない」という点が重要です。
🧮 数式に値を入れて手で計算する: 四分位範囲 (IQR) と外れ値
合成 11 件で Q1, Q3, IQR と外れ値判定を計算する。
Step 1: ソート
Step 2: Q1, Q3
Step 3: 外れ値境界
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np x = np.array([5, 7, 8, 10, 12, 15, 18, 20, 25, 30, 80]) q1, q3 = np.percentile(x, [25, 75]) iqr = q3 - q1 outliers = x[x > q3 + 1.5*iqr] print(f"Q1: {q1}, Q3: {q3}, IQR: {iqr}") print(f"外れ値: {outliers}") |
📤 実行結果
💬 手計算の Q1 = 9・Q3 = 22.5・IQR = 13.5 が Python 出力と一致し、 上境界 42.75 を超える 80 だけが外れ値になる。 2 番目に大きい 30 は境界まで 12.75 の余裕があり、 80 が 1 つ混ざっても Q1・Q3 は順位で決まるので動かない。
🐍 12. ライブラリ早見表
🐍 12. ライブラリ早見表
| 用途 | 関数 |
|---|---|
| パーセンタイル | np.percentile, pd.Series.quantile |
| 5数要約 | df.describe() |
| IQR | scipy.stats.iqr |
| MAD | scipy.stats.median_abs_deviation |
| 箱ひげ図 | matplotlib.pyplot.boxplot, seaborn.boxplot |
| バイオリン | seaborn.violinplot |
| 分位点回帰 | statsmodels.formula.api.quantreg |
| IsolationForest | sklearn.ensemble.IsolationForest |
| LOF | sklearn.neighbors.LocalOutlierFactor |
| ウィンザライズ | scipy.stats.mstats.winsorize |
📜 13. 順位統計・箱ひげ図の歴史
- 19世紀:Galton らが順位統計を導入
- 1970年:Tukey が探索的データ分析 (EDA) を提唱
- 1977:Tukey 「Exploratory Data Analysis」で箱ひげ図を体系化
- 1978:Koenker & Bassett の分位点回帰
- 1998:Hyndman & Fan が 9 種類のパーセンタイル計算法を整理
- 1999:バイオリンプロット(Hintze & Nelson)
- 2008:IsolationForest(Liu ら)
💼 14. 実務応用
- 所得・賃金分析:右歪み著しい → 中央値・分位点比較
- SLA 報告:応答時間の 95/99 パーセンタイル
- 教育:成績の四分位、 偏差値(パーセンタイル変換)
- 医療検査:基準範囲 = 2.5–97.5 パーセンタイル
- 製造:管理図・SPC で外れ値検出
- 金融:VaR(Value at Risk)= 損益の 5 パーセンタイル
- 不動産:地域別の四分位賃料
🅰️ numpy.quantile — 9 種類の補間法
1 2 3 4 5 | import numpy as np x = df[df['SSDSE-B-2026'] == 2023]['L3221'].values for m in ['linear', 'lower', 'higher', 'midpoint', 'nearest']: q1, q3 = np.quantile(x, [0.25, 0.75], method=m) print(f'{m}: Q1={q1:.1f}, Q3={q3:.1f}, IQR={q3-q1:.1f}') |
💬 #7 と同じ 5 方法だが、 表示桁を 1 桁増やしたので linear と midpoint が 279,506.0 / 307,501.5 と小数を持つことが見える。 47 は 4 で割り切れないので、 Q3 は 2 つの観測値のちょうど中間に落ちる。 IQR の差は最大 748 円で、 消費支出 30 万円に対して 0.25% 程度。 方法の違いを気にするより、 どれか 1 つに決めて通す方が実務的。
🅱️ pandas の quantile / describe
1 2 3 4 5 | import pandas as pd # df は 47 県 × 12 年度の 564 行。 年度で絞らないと同じ県が 12 回数えられる d = df[df['SSDSE-B-2026'] == 2023] print(d['L3221'].describe()) # min/Q1/Q2/Q3/max print(d['L3221'].quantile([0.1, 0.25, 0.5, 0.75, 0.9])) |
💬 47 県の消費支出は平均 295,856 円に対し中央値 300,652 円で、 平均の方が 4,796 円低い。 これは愛媛県などの下側の値が平均を引き下げるためで、 分布が左に裾を引いていることの数値的な現れ。 describe の 25%/50%/75% は #8 の Q1/Q2/Q3 と完全に一致し、 quantile を明示しなくても 5 数要約は取れる。
🅲 scipy.stats.iqr
1 2 3 | from scipy import stats print('IQR:', stats.iqr(x)) print('IQR(rng=10-90):', stats.iqr(x, rng=(10, 90))) # 範囲を変えられる |
💬 IQR は 27,995.5 円、 範囲を 10〜90% に広げると 60,965.8 円で 2.2 倍になる。 正規分布なら 10-90% 幅は IQR の約 1.9 倍なので、 これより大きいのは両裾が正規分布より厚いということ。 rng を変えられるので、 外れ値をどこまで許容するかを分析の目的に合わせて決められる。
🅳 ロバストな外れ値判定(MAD ベース)
1 2 3 4 5 6 7 | import numpy as np median = np.median(x) mad = np.median(np.abs(x - median)) # MAD ベースの外れ値判定(Hampel 法、 |z| > 3.5 を外れ値) modified_z = 0.6745 * (x - median) / mad outlier_idx = np.where(np.abs(modified_z) > 3.5)[0] print('外れ値インデックス:', outlier_idx) |
💬 外れ値は index 37 の 1 件、 2023 年度に絞った並びの 38 番目で愛媛県。 修正 Z は -3.81 で閾値 3.5 を超える。 同じ愛媛県を通常の Z-score で測ると -3.00 とちょうど 3 前後にしかならず、 標準偏差が当の外れ値に引っ張られている分だけ小さく出る。 MAD ベースにすると、 その引っ張りが消えて逸脱がはっきり出る。
📦 分位点・ばらつき指標早見表
| 指標 | 特徴 | 外れ値感度 |
|---|---|---|
| 分散・SD | 数値計算が易 | 高(弱い) |
| IQR (Q3−Q1) | 中央50% | 低(強い) |
| MAD | 中央値からの中央絶対偏差 | 最低(最強) |
| 範囲(max−min) | 直感的 | 最高(最弱) |
| 十分位範囲(P90−P10) | 中央 80% | 中 |
| 変動係数 CV | 単位なしの相対指標 | 高 |
🐍 Python 実装(深掘り)
① pandas.quantile で SSDSE-B-2026 の四分位を計算
🎯 このコードでやること:SSDSE-B-2026 から都道府県人口列 A1101 を取り出し、 quantile([0.25, 0.5, 0.75]) で Q1/Q2/Q3 と IQR を計算する。
📥 入力データ:SSDSE-B-2026 の 47 行 × A1101 列。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'] q = pop.quantile([0.25, 0.5, 0.75]) iqr = q[0.75] - q[0.25] print(f'Q1={q[0.25]:,.0f}') print(f'Q2={q[0.5]:,.0f}') print(f'Q3={q[0.75]:,.0f}') print(f'IQR={iqr:,.0f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:手計算と完全一致。 中央 50% の県は 103.4 万〜263.7 万人のレンジ。 IQR は約 160 万人で「典型的な県のあいだの差は最大でも 160 万人程度」と読める。
② 1.5 IQR フェンスで外れ値を検出
🎯 このコードでやること:Tukey の 1.5 IQR ルールで外れ値の県をリストアップ。
📥 入力データ:① の df と q、 iqr を再利用。
1 2 3 4 5 6 | lower = q[0.25] - 1.5 * iqr upper = q[0.75] + 1.5 * iqr mask = (df['A1101'] < lower) | (df['A1101'] > upper) out = df.loc[mask, ['Prefecture', 'A1101']].sort_values('A1101', ascending=False) print(f'lower={lower:,.0f} upper={upper:,.0f}') print(out.to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:9 都道府県が上側外れ値。 これらは「異常」ではなく「構造的な大都市」。 統計的検定や回帰モデルで人口を説明変数にするときは、 ログ変換や層別化が必要、 と判断する材料になる。
③ seaborn.boxplot で可視化
🎯 このコードでやること:箱ひげ図で Q1/Q2/Q3 と外れ値を一目で見えるようにする。
📥 入力データ:① の df['A1101'] を Series として渡す。
1 2 3 4 5 6 7 8 | import seaborn as sns import matplotlib.pyplot as plt fig, ax = plt.subplots(figsize=(8, 5)) sns.boxplot(x=df['A1101'], ax=ax, color='#7B1FA2') ax.set_xlabel('総人口') ax.set_title('47 都道府県の総人口(SSDSE-B-2026)') plt.tight_layout() |
📤 実行すると次の出力が得られる:
💬 結果の読み方:箱の中央線(中央値)は左寄り、 右に外れ値が長く伸びる右裾の重い分布。 つまり都道府県人口は対数正規分布に近い形状。 log 変換すると同じ 1.5 IQR ルールでの外れ値は 9 県から東京都 1 県に減り(境界は約 1,072 万人)、 歪度も 2.22 から 0.79 に下がるが、 東京だけはなお外れる。
④ numpy.percentile の補間方法による違い
🎯 このコードでやること:NumPy の補間方法のうち基本の 5 種類(linear, lower, higher, nearest, midpoint)で Q1/Q3 がどう変わるかを比較する(hazen, weibull, median_unbiased, normal_unbiased なども method に指定できる)。
📥 入力データ:① の pop(47 都道府県の人口値)。
1 2 3 4 5 6 7 | import numpy as np methods = ['linear', 'lower', 'higher', 'nearest', 'midpoint'] for m in methods: q1 = np.percentile(pop, 25, method=m) q3 = np.percentile(pop, 75, method=m) print(f'{m:9} Q1={q1:,.0f} Q3={q3:,.0f} IQR={q3-q1:,.0f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:補間方法によって IQR は 1,493,000 〜 1,696,000 と最大 14% 違う。 R の quantile() 既定(type=7)は NumPy の linear と同等。 Excel の QUARTILE.INC も同じ。 ライブラリを跨ぐ報告では「どの補間方法を使ったか」を明記する習慣が大事。
🐍 補足: 複数列の IQR を一括計算
🎯 このコードでやること:SSDSE-B-2026 の主要 4 列(総人口・出生数・65 歳以上人口・婚姻件数)の IQR を DataFrame.describe() で一覧化する。
📥 入力データ:SSDSE-B-2026 全列、 必要な 4 列だけ取り出す。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cols = ['A1101', 'A4101', 'A1303', 'A9101'] # 総人口 出生数 65歳以上 婚姻 desc = df[df['SSDSE-B-2026'] == 2023][cols].describe() iqr = desc.loc['75%'] - desc.loc['25%'] print(desc.loc[['25%', '50%', '75%']].round(0)) print('IQR:', iqr.round(0).to_dict()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:4 列とも中位 50% の幅(IQR)が中央値の 84〜103% に達し、 都道府県差の大きさが定量化される。 特に総人口と婚姻件数は IQR / median ≈ 1.0 と相対的な散らばりが大きい。 IQR は「相対散らばり」の比較にも便利。
⚠️ 9. よくある落とし穴
| 落とし穴 | 対処 |
|---|---|
| パーセンタイル計算法の違いで結果ぶれ | interpolation 引数を明示し、 同一の方法で比較。 |
| 外れ値を機械的に削除 | 外れ値こそ重要情報のことも。 まず原因を調査。 |
| 小標本に Tukey ルール | n < 20 では信頼性低い。 個別検討。 |
| 箱ひげ図のひげと範囲を混同 | ひげは「フェンス内の最小/最大」、 範囲全体ではない。 |
| 標準偏差と IQR を「同じ」扱い | 正規分布なら IQR ≈ 1.349σ だが歪んでいると関係性なし。 |
| 対数スケールで箱ひげ図 | 変換後のスケールで作成し、 軸ラベルに明記。 |
| 5数要約だけで分布を語る | 同じ 5 数で異なる分布もある。 ヒストグラム併用。 |
🏋️ 10. 練習問題(SSDSE-B-2026)
Q1. すべての数値変数の 5数要約を作り、 平均と中央値が大きく乖離する変数を 3 つ挙げなさい。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) num = df[df['SSDSE-B-2026'] == 2023].select_dtypes(include='number') summary = num.describe() gap = (summary.loc['mean'] - summary.loc['50%']) / summary.loc['std'] print(gap.abs().sort_values(ascending=False).head()) |
💬 平均と中央値の差を標準偏差で割った値の上位。 待機児童数 J250502 が 0.483 で最も歪んでおり、 平均 57.0 人に対し中央値は 10.0 人。 少数の都市部が平均を押し上げ、 半数の県はほぼゼロという分布。 幼稚園の在園者数・教員数、 男性人口が続くのも同じ構造で、 いずれも人口集中がそのまま効く量。 この指標が大きい列は、 平均で語ると実態を外す。
Q2. 「総人口(A1101)」「消費支出(L3221)」について、 Tukey ルールで外れ値を検出し、 どの都道府県かを示しなさい。
1 2 3 4 5 6 7 8 9 | d = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 県だけを対象にする for col in ['A1101', 'L3221']: q1, q3 = d[col].quantile([0.25, 0.75]) iqr = q3 - q1 lo, hi = q1 - 1.5*iqr, q3 + 1.5*iqr out = d[(d[col] < lo) | (d[col] > hi)] print(f'{col}: 外れ値 {len(out)} 件') print(out[['Prefecture', col]]) print() |
💬 総人口は 9 件(#4 と同じ 9 県)、 消費支出は愛媛県 1 件だけ。 同じ 1.5 IQR ルールでも、 人口のように右に大きく伸びる量では 47 県の 2 割が外れ値になり、 一世帯あたりの支出のように上限が実質決まっている量では 1 件しか出ない。 「外れ値が多い」のはデータの異常ではなく、 分布の形がフェンスの前提に合っていないことを示す。 年度で絞らないと同じ県が 12 回数えられ、 件数が 89 に膨らむ。
Q3. 食料費(L322101)を被説明変数、 消費支出(L3221)を説明変数として、 τ=0.1, 0.5, 0.9 の分位点回帰を行い、 係数の違いを解釈しなさい。
1 2 3 4 5 | import statsmodels.formula.api as smf d = df[df['SSDSE-B-2026'] == 2023] # 年度をまたぐと同じ県が 12 回入る for tau in [0.1, 0.5, 0.9]: m = smf.quantreg('L322101 ~ L3221', data=d).fit(q=tau) print(f'τ={tau}: β_消費支出 = {m.params["L3221"]:.4f}') |
💬 説明変数を消費支出だけにすると τ=0.1 で 0.2490、 τ=0.5 で 0.2881、 τ=0.9 で 0.1913。 #6 で人口も入れたときは τ が上がるほど係数も増えていたが、 ここでは上位 90% 層だけ 0.1913 と下がり、 順序が入れ替わる。 食料費の多い側では支出が増えても食料費はそれほど増えない、 つまりエンゲル的な頭打ちが見える。 47 点で 90% 点を推定しているので、 この係数はもともと不安定な点にも注意。
📝 11. 報告フォーマット
❌ NG例
「東京は外れ値なので除外しました。」
✅ OK例
「総人口(A1101・2023 年度)の 5数要約は (最小 53.7 万, Q1 103.4 万, 中央 154.9 万, Q3 263.7 万, 最大 1,408.6 万)、 IQR = 160.3 万。 Tukey の上限 504.0 万を超える観測値が 9 件(東京都・神奈川県など)。 ただし大都市圏の高人口はデータの構造的特徴であり、 削除は不適切と判断。 代わりに log 変換(変換後の歪度 0.79、 変換前 2.22)し、 平均ではなく中央値・IQR で記述、 回帰は分位点回帰で頑健に推定した。」
⚠️ 落とし穴(補強版 — 四分位・IQR で踏みやすい7つの罠)
method='linear' など使用法を明示すること。 numpy 1.22 以降は numpy.quantile(method=...) で 9 種類全部選べます。whis= 引数で挙動を制御できます。numpy.quantile を使うと不偏推定になりません。 加重分位点(weighted quantile)が必要。 statsmodels.stats.weightstats.DescrStatsW や numpy.percentile は加重対応不十分なので、 pandas.Series.quantile(weights=...) (pandas 2.x 以降)または自前で計算する必要があります。⚠️ 落とし穴(5 件、 各 80-150 字)
- 補間方法の暗黙設定:NumPy・pandas・R・Excel・Minitab で既定が異なる。 同じデータでも 5〜20% 違う四分位数が出る。 報告時は
methodを明示。 - 小サンプル(n < 10):Q1・Q3 が個別の観測値に強く依存する。 1 件の入力ミスが IQR を半分または倍にしうる。 n < 20 では信頼区間を併記。
- 歪んだ分布の解釈:右裾の重い分布(収入・人口等)では「外れ値」が大量に出るが、 これは異常ではなく構造。 log 変換後の四分位や、 分位回帰で正しく扱う。
- 多峰分布の Q2 ≠ 重心:2 つの山がある分布では、 中央値が「谷」の位置に来ることがあり、 典型値を表さない。 ヒストグラムで分布形を先に確認すべき。
- 1.5 IQR の機械的削除:外れ値検出は「除外すべきデータ」ではなく「調べるべきデータ」のサイン。 異常な状況の発見こそ EDA の本質、 という意識が必要。
🗺 概念マップ
四分位 (Q1/Q2/Q3) と IQR・パーセンタイル・箱ひげ図・外れ値検出 (Tukey 1.5×IQR) との関係を俯瞰する概念マップ。 中央値・分散と並ぶ位置指標・散らばり指標としての位置づけを示す。
IQR = Q3 - Q1。 データの中央 50% が占める幅で、 外れ値に頑健な散らばり指標。 SSDSE-B-2026 の 47 都道府県人口で Q1 ≈ 100 万、 Q3 ≈ 264 万、 IQR ≈ 160 万、 外れ値判定の閾値 Q3 + 1.5×IQR ≈ 504 万を上回るのが東京・大阪・神奈川など。
🔗 隣接手法への橋渡し
「四分位・IQR・パーセンタイル」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
SSDSE-B-2026 の 47 都道府県人口で IQR ≈ 160 万、 1.5×IQR ルールで外れ値判定すると東京・大阪・神奈川・愛知が引っかかる。 箱ひげ図で可視化すれば自然と確認できる。
🌳 手法選択フロー
「四分位数・IQR」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 分布は正規に近いか? 近い → 標準偏差で十分、 歪み大 → IQR で頑健に要約
- 外れ値を機械的に検出するか? Yes → Q1-1.5×IQR / Q3+1.5×IQR ルール、 No → 散布の概観のみ
- 複数群を比較するか? Yes → 箱ひげ図で IQR を並列表示、 No → 単一群の IQR を文章で報告
SSDSE-B-2026 の都道府県人口で Q1=100 万・Q3=264 万 → IQR=160 万。 上限 Q3+1.5×IQR=504 万を超える東京・神奈川・大阪は外れ値判定となる。
🎨 深掘り直感 — 「IQR ÷ σ」で分布の素性を一発診断する
ここまでで「IQR は外れ値に頑健」「σ は外れ値に弱い」と繰り返してきました。 この深掘りセクションでは、 その 2 つを割り算するという独自の切り口を示します。 IQR ÷ σ(比)は、 それ自体が分布が正規からどれだけ外れているかの物差しになります。 別ページ 四分位(個別) では四分位数そのものの定義を深掘りしましたが、 ここでは「IQR と σ の関係比」に絞って扱います。
基準値は 1.349。 正規分布では $Q_1 = \mu - 0.6745\sigma$、 $Q_3 = \mu + 0.6745\sigma$ なので $\mathrm{IQR} = 1.349\,\sigma$、 つまり $\mathrm{IQR}/\sigma = 1.349$ にぴったり乗ります。 実データの比がこの 1.349 からどちらへどれだけズレるかで、 分布の裾の重さが読めます。
- 比 < 1.349:σ が IQR に対して相対的に大きい=外れ値/重い裾が σ を膨らませている(右歪み・ロングテール)。
- 比 ≈ 1.349:中央 50% と全体のスケールが釣り合う=正規分布に近い。
- 比 > 1.349:σ が IQR に対して相対的に小さい=裾が短い(一様寄り・短裾)。
SSDSE-B-2026 実測:6 変数の IQR/σ 比(2023 年度・n=47)
| 変数(列コード) | IQR | σ(不偏SD) | IQR/σ 実測 | 歪度 | 読み取り |
|---|---|---|---|---|---|
| 婚姻件数(A9101) | 5,724 | 13,061 | 0.438 | 2.97 | 最も重い右裾。 σ は IQR の 2.3 倍 |
| 出生数(A4101) | 8,918 | 17,155 | 0.520 | 2.37 | 大都市が σ を押し上げる |
| 総人口(A1101) | 1,602,500 | 2,797,551 | 0.573 | 2.29 | 東京が σ を約 2.8 倍に膨張 |
| 65 歳以上人口(A1303) | 438,500 | 693,839 | 0.632 | 1.84 | 右裾だが総人口よりは穏やか |
| 消費支出(L3221) | 27,996 | 24,144 | 1.160 | -0.54 | ほぼ対称〜軽い左歪み。 1.349 に最も近い |
| 食料費(L322101) | 9,074 | 5,842 | 1.553 | 0.67 | σ が相対的に小さい=短めの裾 |
💬 ひと目で分かること:人口・出生・婚姻のような「大都市が突出する量」は比が 0.4〜0.6 と基準 1.349 の半分以下まで落ちます。 これは分布が異常なのではなく、 σ 側が外れ値で膨張していることのサインです。 一方、 1 世帯あたりの金額である消費支出・食料費は都道府県間でスケールが揃うため比が 1.2〜1.6 に収まり、 正規基準に近づきます。 「金額(比率量)は比が高く、 総量(絶対量)は比が低い」という対比が、 SSDSE-B の 6 変数で綺麗に出ています。
この「IQR/σ 比」は、 正規分布への近さを 1 つの数字で要約する簡便な診断です。 厳密な正規性検定(シャピロ–ウィルク検定など)の前に、 まず比を眺めて「そもそも σ を代表値として使ってよい分布か」の見当をつけるのに役立ちます。
⚠️ 深掘り落とし穴 — フェンス係数 k の任意性を SSDSE-B で可視化する
「1.5×IQR」は Tukey が経験的に選んだ値であり、 数学的必然ではありません(1.0 で厳しく、 3.0 で極端外れ値のみ)。 では係数 k を動かすと外れ値の件数はどう変わるのか。 SSDSE-B-2026 の 3 変数で実測しました。
| 変数 | k=1.0 | k=1.5(既定) | k=2.0 | k=3.0 |
|---|---|---|---|---|
| 総人口(A1101) | 9 件 | 9 件 | 6 件 | 4 件 |
| 65 歳以上人口(A1303) | 9 件 | 9 件 | 7 件 | 3 件 |
| 消費支出(L3221) | 4 件 | 1 件 | 1 件 | 0 件 |
💬 教訓は 2 つ。 (1) 重い右裾の総人口・65 歳以上人口は、 大都市クラスターが遥か外側にあるため k=1.0〜1.5 では 9 件で安定し、 k を上げて初めて減り始めます。 (2) 対して消費支出は k=1.0 で 4 件、 k=1.5 で 1 件、 k=3.0 で 0 件と係数の選択で結論が激変します。 つまり「1.5 か 2.0 か」の任意性が最も効くのは、 皮肉にも外れ値が少なくスケールの揃った分布の方だということです。 報告書では必ず k を明記してください。
🚀 深掘り発展 — 頑健スケール推定量の三つ巴(IQR・四分位偏差・MAD)
「中央 50% でスケールを測る」道具は IQR だけではありません。 実務で使う頑健スケール推定量を、 正規分布に合わせる整合定数(consistency factor)とともに整理します。 いずれも正規分布のとき σ に一致するよう定数で調整されている点がポイントです。
| 推定量 | 定義 | σ への換算(正規) | 頑健性(崩壊点) |
|---|---|---|---|
| IQR | $Q_3 - Q_1$ | $\hat\sigma = 0.7413\cdot\mathrm{IQR}$ | 25% |
| 四分位偏差 QD | $\mathrm{IQR}/2 = (Q_3-Q_1)/2$ | $\hat\sigma = 1.4826\cdot\mathrm{QD}$ | 25% |
| MAD | $\mathrm{median}(|x_i-\tilde x|)$ | $\hat\sigma = 1.4826\cdot\mathrm{MAD}$ | 50% |
| 標準偏差 σ | $\sqrt{\frac{1}{n-1}\sum(x_i-\bar x)^2}$ | (そのもの) | 0% |
四分位偏差 QDは IQR の半分で、 「中央値から Q1/Q3 まで平均してどれだけ離れているか」を表す半幅。 IQR = 1.349σ なので QD = 0.6745σ、 よって $\hat\sigma = \mathrm{QD}/0.6745 = 1.4826\cdot\mathrm{QD}$。 偶然にも MAD の整合定数と同じ 1.4826 になります(正規分布では QD と MAD が一致するため)。
SSDSE-B-2026 実測:3 つの σ 推定値の一致・不一致(2023 年度)
| 変数 | 実測 σ(SD) | 0.7413·IQR | 1.4826·MAD |
|---|---|---|---|
| 消費支出(L3221・ほぼ対称) | 24,144 | 20,753 | 20,285 |
| 食料費(L322101・軽い右歪み) | 5,842 | 6,727 | 6,922 |
| 総人口(A1101・重い右裾) | 2,797,551 | 1,187,933 | 923,660 |
💬 対称に近い消費支出・食料費では 3 つの推定値が数 % 以内で一致します(この一致自体が「正規に近い」ことの傍証)。 一方総人口では、 実測 σ が 280 万に対し IQR ベースは 119 万、 MAD ベースは 92 万と3 分の 1 前後。 頑健推定量は東京都という 1 点を無視して「大多数の県のスケール」を測るため、 この差こそが外れ値の影響量を定量化しています。 崩壊点は IQR・QD が 25%(データの 1/4 まで汚染に耐える)、 MAD が 50%(最強)、 σ は 0%(1 点で崩壊)。
関連ページへ(すべて glossary 内の実在ファイル)
- 四分位(個別) — 四分位数そのものの定義・補間 9 種の深掘り
- 箱ひげ図 — IQR・フェンスを図にした可視化
- 外れ値 / 外れ値の扱い方 — 検出後の意思決定
- 中央値 — Q2 の別名。 頑健な代表値
- 標準偏差 / 分散 — 対比される非頑健なスケール
- MAD / ロバスト統計 — 崩壊点 50% の最強頑健スケール
- 正規分布 / シャピロ–ウィルク検定 — IQR/σ 比の基準 1.349 の出どころと正規性の検定
- 分位点回帰 / ばらつき / 代表値 — 発展・上位概念
注:本追記の数値はすべて SSDSE-B-2026.csv(cp932, skiprows=[1], 2023 年度 47 都道府県)の実測。 σ は不偏標準偏差(ddof=1)、 四分位は linear 補間(numpy 既定)。 正規基準 1.349・換算定数 0.7413/1.4826 は正規分布の理論値。
🔖 キーワード索引(拡張版 — 四分位・IQR)
分位点の定義・補間方法、 箱ひげ図、 外れ値検出を一気に把握。