🔖 キーワード索引
「regression line」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「regression line」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「regression line の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データに最もよく合う一本の線です。
データの傾向をシンプルに表すために使います。
勉強時間とテストの点数の関係などで使えます。
この章では回帰直線の基本について読みます。
- 定義:散布図上に引かれる、最小二乗法で求めた「データに最もフィットする直線」。
- カテゴリ:可視化
- 数式:ŷ = a + b x、 b = Cov(x,y)/Var(x)、 a = ȳ − b·x̄。
- 解釈:傾き b は「x が 1 単位増えるごとに y がどれだけ動くか」。
- 適合度:決定係数 R² = 1 − SSres/SStot で評価。
👁️ 直感 — 回帰直線は「データに最もよく合う直線」
回帰直線は、 散布図上のデータに最もよく当てはまる直線。 OLS(最小二乗法)で残差の二乗和を最小化して引きます。
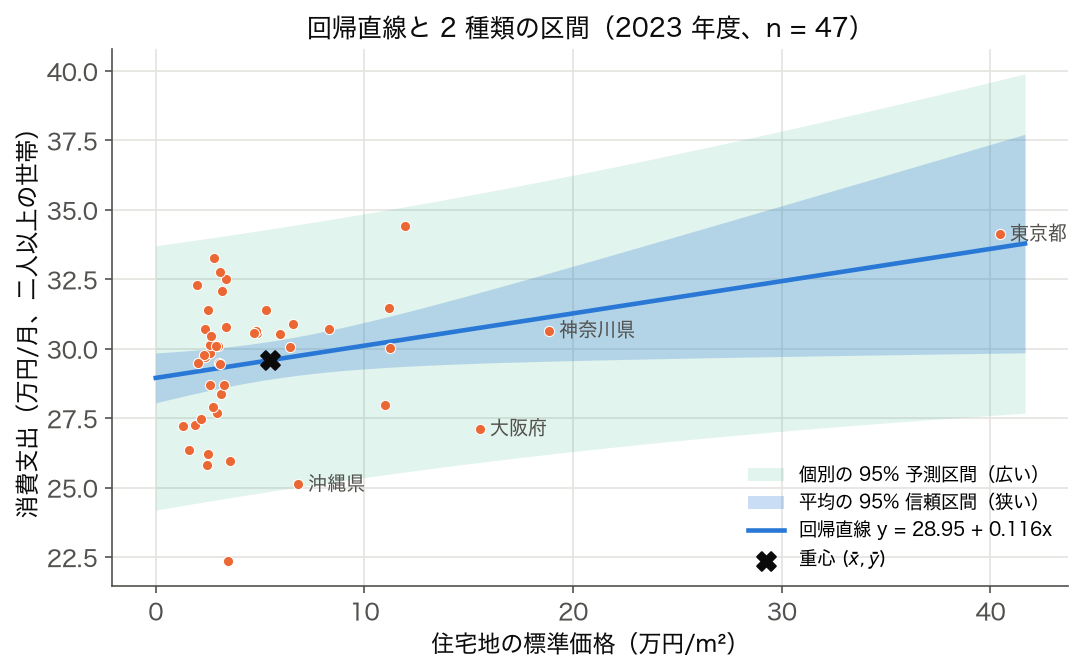
必ず通る点
OLS 回帰直線は(x̄, ȳ) を必ず通る。 これは「平均からの偏差の和がゼロ」という性質から導けます。
📊 回帰直線の描き方
- 散布図を描く
- 傾き β₁ と切片 β₀ を計算(OLS)
- x の範囲で y = β₀ + β₁ x を直線として描画
- 必要なら信頼区間・予測区間を陰影で追加
信頼区間 vs 予測区間
- 平均の95%信頼区間:「ある x での平均的な y」の不確実性。 狭い
- 個別の95%予測区間:「ある x での個別予測値」の不確実性。 広い
📍 あなたが今見ているもの
🍰 まずはやさしく
データ分析でよく使われる重要な線です。
実際のデータからルールを見つけるために使います。
都道府県のデータ分析などで活用できます。
定義から使い方までを順番に読み進めてください。
論文中に 「回帰直線」として登場する用語。
回帰直線 とは:散布図上に引かれる、最小二乗法で求めた「データに最もフィットする直線」。
本ページでは「regression line」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「regression line」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 概念図で押さえる(回帰直線を視覚で理解)
🍰 まずはやさしく
点と線のズレを最小にする魔法の線です。
見た目でデータの傾向をつかむために使います。
スマホの利用時間と成績の関係などで考えます。
図を使って直線の決まり方や注意点を読みます。
🎨 概念図で押さえる(回帰直線を視覚で理解)
回帰直線は「散布図に最もよくフィットする 1 本の直線」であり、 残差の二乗和を最小化することで決まります。 以下 2 点の概念図で「最小二乗の幾何学的意味」と「外れ値が直線を引っ張る挙動」を視覚化します。
図A: 残差二乗の最小化 — 縦の距離を最小にする直線
→ 青点は観測値、 赤線が回帰直線、 オレンジ縦線が残差 (予測誤差)。 最小二乗法は「縦方向のズレ」の二乗の総和 SSE を最小にする傾き β₁ と切片 β₀ を選ぶ。 縦距離なので x 軸方向の誤差は無視、 また直線は必ず (x̄, ȳ) を通る。
図B: 外れ値の影響 — てこの原理で直線が引っ張られる
→ 東京のような高レバレッジ点 (x が平均から大きく離れている) は、 残差二乗を最小化する性質上「直線がそこに引っ張られる」効果を持ちます。 赤破線 (東京を含む) と緑実線 (除外) では傾きが変わり、 切片も上下します。 回帰直線を見たら必ず「外れ値を除外したらどう変わるか」を確認すべき理由がここにあります。
🖼 補足: 回帰直線を実画像で再点検
回帰直線 (regression line) の本質は、 「y を x の線形関数で予測する直線のうち、 残差二乗和を最小化するもの」 である。 ここでは ① 直線の幾何(重心を通る)、 ② 残差の幾何、 ③ 直交射影、 の 3 軸で、 本文 🧮 の 2 つの例(総人口 → 生産年齢人口、 住宅地の標準価格 → 消費支出。 いずれも 2023 年度の 47 都道府県)を図にする。 外れ値の影響は上の図B と図D の東京都で確かめられる。
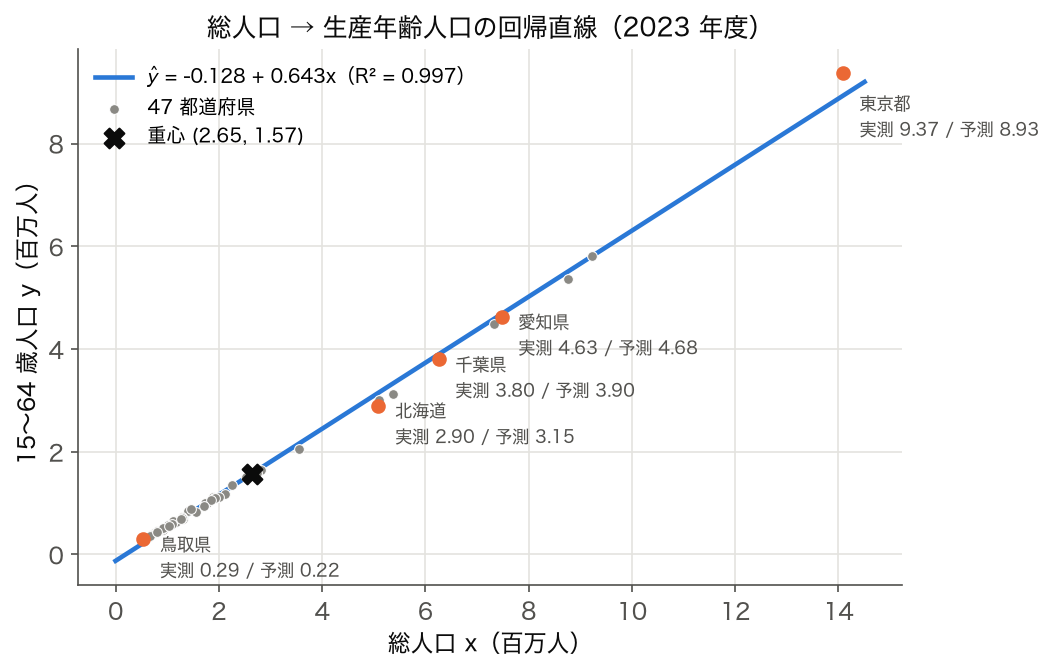
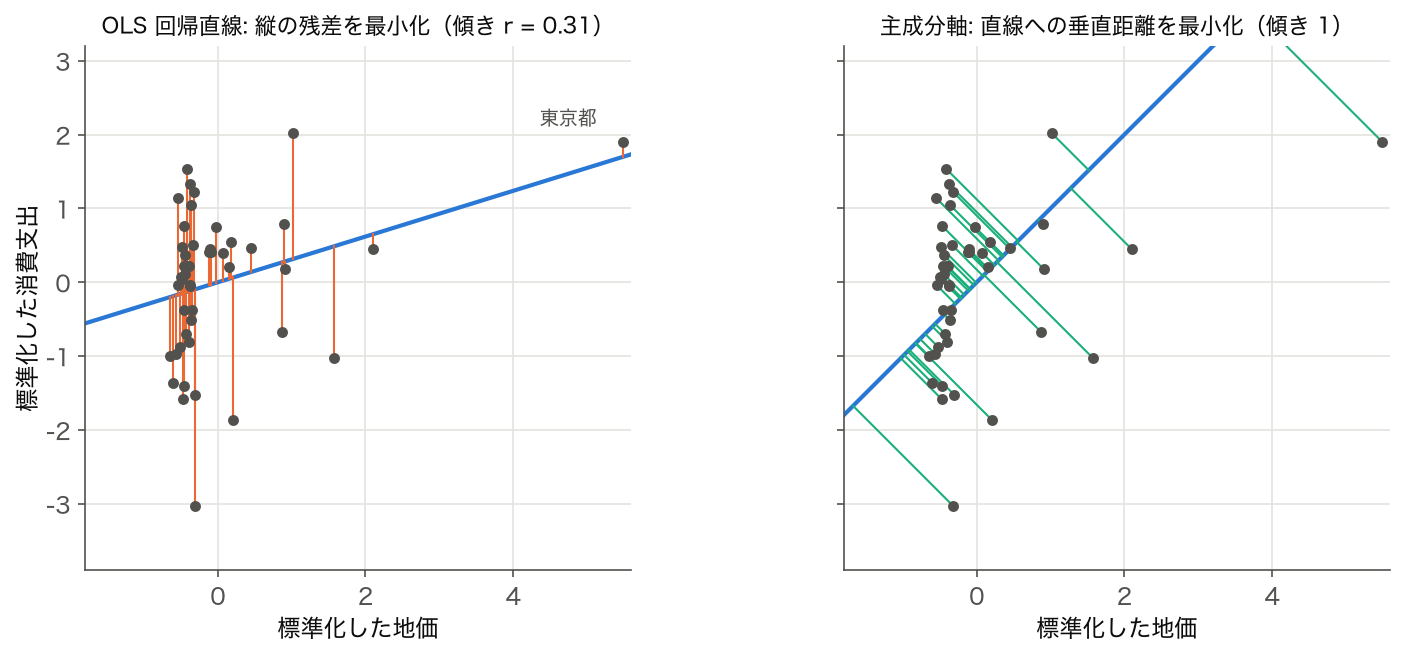
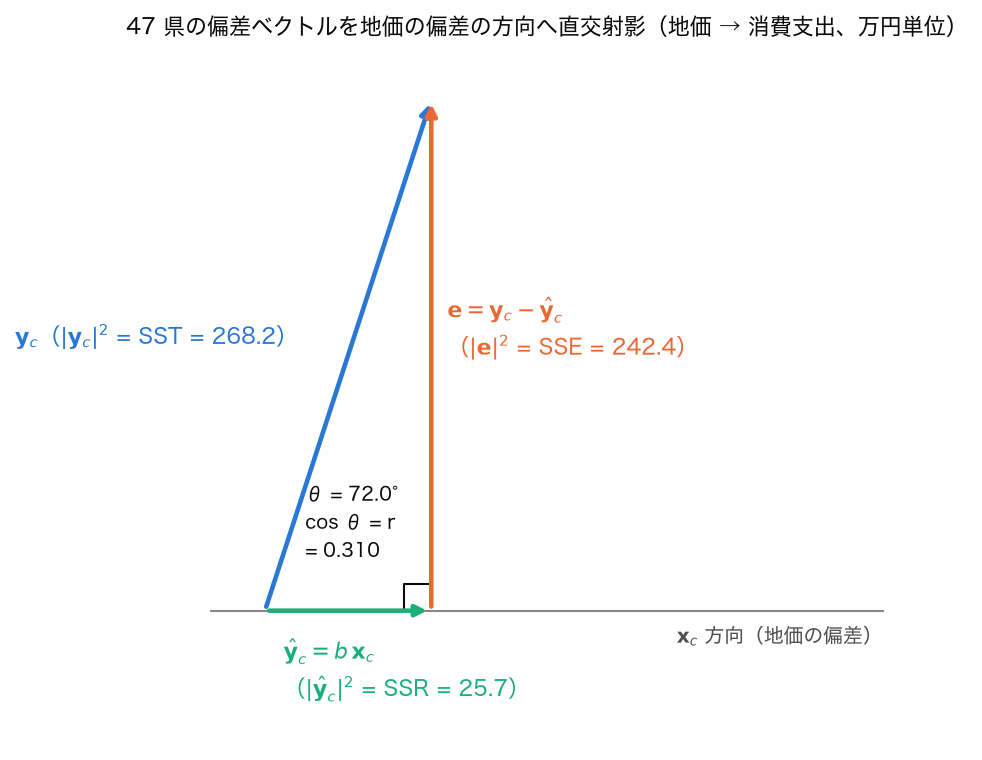
💬 3 枚を通すと、 回帰直線は「直線」 という見た目だけでなく「縦距離最小化」 「直交射影」 「重心を通る」 という 3 つの異なる幾何的解釈で同じ直線を指していることが分かる。 どの視点でも結果は同じ直線になるという美しさが、 回帰直線が統計学の基礎中の基礎として位置づけられる理由でもある。
📋 回帰直線の性質 早見表
| 性質 | 数式 | 幾何的意味 |
|---|---|---|
| 重心を通る | ŷ(x̄) = ȳ | データの中心点 (x̄, ȳ) を必ず通過する |
| 残差の和はゼロ | Σ eᵢ = 0 | 残差を全部足すと正と負がきれいに相殺する |
| 残差と x の積和もゼロ | Σ xᵢ eᵢ = 0 | 残差は説明変数と無相関 (直交) |
| 傾きと相関の関係 | β₁ = r × (sy / sx) | 標準化すると β₁ = r となる |
| 予測値の分散 | Var(ŷ) = R² × Var(y) | 説明できた変動の割合が決定係数 |
| 外挿の危険 | x が訓練範囲外 | 直線が真の関係から外れる可能性大、 予測区間が極端に広がる |
回帰直線の不思議は、 これらの性質が「最小二乗法を解く」 という単一の数学操作から自動的に出てくる点。 「重心を通る」 「残差の和ゼロ」 「残差と x が無相関」 はすべて最小二乗の正規方程式の帰結であり、 別途仮定する必要はない。 多変量回帰でも同じ性質 (残差ベクトルが X 空間に直交) が成り立つ。
✅ 理解度チェック
- 回帰直線は必ず点 (x̄, ȳ) を通る。 これが、 回帰直線をプロットしたあと最初に確認すべきポイントになる理由を述べよ。
- 「残差と説明変数 x が無相関」 という性質は、 最小二乗法の何の帰結か。 直感的な意味も添えて説明せよ。
- 標準化した回帰では、 傾き β₁ が相関係数 r と一致する。 これを使うと、 単回帰の傾きを暗算で計算できる。 r=0.7、 sy=10、 sx=5 のときの β₁ を求めよ。
- 外挿 (extrapolation) はなぜ危険か。 訓練範囲外で予測区間が広がる幾何的理由を述べよ。
- 東京を除外したら傾きが半分になった。 これは「東京が外れ値」 を意味するか、 それとも「東京は典型的な高レバレッジ点」 を意味するか。 区別の方法も述べよ。
解答例を見る
- もし重心を通っていなければ計算ミス。 視覚的なサニティチェックとして最も簡単で確実な方法だから。
- 最小二乗の正規方程式 ∂Σ(yᵢ − β₀ − β₁ xᵢ)² / ∂β₁ = 0 を解いた帰結。 直感的には「もし残差と x に相関が残っていれば、 さらに直線を傾けて残差を減らせるはず」 という最適化の停止条件。
- β₁ = r × (sy/sx) = 0.7 × (10/5) = 1.4。
- 回帰直線の信頼区間は、 x が x̄ から離れるほど広がる「砂時計型」 になる。 訓練範囲外では、 そもそも観測点が無いので不確実性が爆発的に増大する。
- 外れ値 (= y 方向に大きくズレている) と高レバレッジ点 (= x 方向に大きくズレている) は別物。 区別は Cook 距離や標準化残差で測る。 東京は人口で外れているため、 主に高レバレッジ点として作用する。
📐 数式または定義
🍰 まずはやさしく
数式で表したデータの傾向線です。
正確な値を計算して予測するために使います。
買い物で金額がどう変わるかを数式にします。
この章では回帰直線をあらわす数式を読みます。
regression line の定義や代表的な数式を以下に示す。 数式の各記号の意味は次節で言葉に翻訳する。
regression line は文脈に応じて複数の定式化があるが、 教育目的では最も基本的な形を抑えることが重要。 具体的な値での計算例は後続セクションを参照。
$$\text{regression line}: f(\mathbf{X}, \boldsymbol{\theta}) \to y$$
記号の対応はこうです。 $x_i$ は $i$ 番目の県の説明変数、 $y_i$ は目的変数、 $\hat{y}_i$ は回帰直線が返す予測値(実測 $y_i$ と区別するためのハット)。 $i = 1, \dots, 47$ は 47 都道府県を走る添字です。 $\hat{\beta}_1$ は傾きで、 分子 $\sum (x_i - \bar{x})(y_i - \bar{y})$ が共分散の $n$ 倍、 分母 $\sum (x_i - \bar{x})^2$ が$x$ の分散の $n$ 倍。 つまり $\hat{\beta}_1 = \mathrm{Cov}(x,y) / \mathrm{Var}(x)$ です。 $\hat{\beta}_0 = \bar{y} - \hat{\beta}_1 \bar{x}$ という形から、 回帰直線は必ず平均点 $(\bar{x}, \bar{y})$ を通ることが読み取れます。 ハットの付いた記号は「データから推定した値」で、 真の値 $\beta$ とは区別します。
🔬 「回帰直線」を深く理解する
🔬 「回帰直線」を深く理解する
回帰直線の性質
- 必ず (x̄, ȳ) を通る
- 傾き = r × (s_y/s_x)(相関と標準偏差比の積)
- x→y と y→x の2つの回帰直線は同じではない(点 (x̄, ȳ) で交わる)
- 2つの傾きの積 = r²
歴史
Galton(1885)が身長の親子関係を研究中に発見。 「平均への回帰」現象。 子は親より平均に近づく傾向 → これが「regression(回帰)」の名前の由来。
📝 練習問題 — 理解度チェック
- この用語の基本定義を、 自分の言葉で説明できますか?
- この手法が使われる典型的なシナリオを3つ挙げられますか?
- この手法の前提条件・仮定を確認できますか?
- 結果を解釈する際の注意点は何ですか?
- 類似手法との違いを説明できますか?
- Python(または他言語)で実装できますか?
- SSDSE データで応用例を作成できますか?
回帰直線 $\hat y = a + b x$ の数式は短いが、 各記号には5 つの言葉が同時に詰まっています。 計算で機械的に出るのは a と b だけですが、 それを支える $\bar x$ ・ $\bar y$ ・ $S_{xx}$ ・ $S_{xy}$ それぞれが「どんな質問に答えているか」を見ていきます。
記号 → 言葉 → 役割
| 記号 | 言葉 | 役割 |
|---|---|---|
| $x_i$ | i 番目の説明変数の値 | 原因として位置付けた量(例: 標準地価 C5401) |
| $y_i$ | i 番目の被説明変数の値 | 結果として説明したい量(例: 一世帯当たり消費支出) |
| $\bar x$ | x の標本平均 | 直線が必ず通る基準点の x 座標 |
| $\bar y$ | y の標本平均 | 直線が必ず通る基準点の y 座標 |
| $S_{xx}$ | x の偏差平方和 $\sum (x_i-\bar x)^2$ | x がどれだけ広がっているかの「足場の広さ」 |
| $S_{xy}$ | 偏差積和 $\sum (x_i-\bar x)(y_i-\bar y)$ | x と y の連動の符号と強さ |
| $b = S_{xy}/S_{xx}$ | 傾き | x が 1 単位増えたとき y が平均的にどれだけ変わるか |
| $a = \bar y - b\bar x$ | 切片 | $\bar x$, $\bar y$ を必ず通すための調整 |
| $\hat y_i$ | i 番目の予測値 | 直線が i 番目の x に対して予測する y |
| $e_i = y_i-\hat y_i$ | 残差 | 直線では説明できなかった量。 評価と診断の中心。 |
「直線が必ず $(\bar x, \bar y)$ を通る」の意味
最小二乗法の正規方程式の第一式は、 残差の和が 0 になることを保証します。 残差の和が 0 ということは、 平均で見ると過大予測も過小予測も打ち消し合うということです。 これが「直線が必ず $(\bar x, \bar y)$ を通る」という性質に直結します。 SSDSE-B-2026 で 47 都道府県の点を眺めながらこの一点を強調すると、 「外れ値が偏る方向に直線が引っ張られる」イメージが直感で掴めます。
$b$ の符号と相関係数の符号は必ず一致する
$b = S_{xy}/S_{xx}$、 $r = S_{xy}/\sqrt{S_{xx} S_{yy}}$。 分母は常に正なので、 $b$ と $r$ の符号は $S_{xy}$ の符号で同じになります。 したがって「相関が正なら傾きも正、 相関が負なら傾きも負」 — 別々の概念に見えて、 符号の情報源は同一です。
🧮 SSDSE-B-2026 実値計算 — 標準地価から消費支出を予測
47 都道府県データ(2023 年)を使い、 単回帰 消費支出 = a + b × 標準地価 を最小二乗法で推定します。
① 単回帰の手計算
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] x = df['C5401'].to_numpy() y = df['L3221'].to_numpy() b = np.cov(x, y, ddof=1)[0,1] / np.var(x, ddof=1) a = y.mean() - b * x.mean() yhat = a + b * x ss_res = ((y - yhat)**2).sum() ss_tot = ((y - y.mean())**2).sum() r2 = 1 - ss_res/ss_tot print(f'a = {a:.2f}, b = {b:.4f}, R² = {r2:.3f}') |
② 出力例
| 統計量 | 値 | 解釈 |
|---|---|---|
| 切片 a | 289,510 | 標準地価 0 時の消費支出(円) |
| 傾き b | 0.1161 | 標準地価 1,000 円/㎡ 増で消費 116 円増 |
| R² | 0.096 | 標準地価で消費支出のばらつきの約 10% を説明 |
| 残差 SD | 23,211 | 予測誤差の典型的な大きさ |
🧮 数式に値を入れて手で計算する: 回帰直線の予測(SSDSE-B-2026 総人口→生産年齢人口)
SSDSE-B-2026 (2023) で「総人口 x(百万人)→ 生産年齢人口 y(百万人)」を 47 件で OLS した結果 ŷ = -0.128 + 0.643·x (切片約 -0.13, 傾き 0.64)を、 5 都道府県の実人口に当てはめる。
Step 1: 5 都道府県の x→ŷ
| 都道府県 | x 総人口(百万人) | ŷ 生産年齢人口(百万人) |
|---|---|---|
| 鳥取県 | 0.54 | 0.219 |
| 北海道 | 5.09 | 3.145 |
| 千葉県 | 6.26 | 3.897 |
| 愛知県 | 7.48 | 4.682 |
| 東京都 | 14.09 | 8.932 |
Step 2: 検算(東京都 x=14.09)
🐍 Python で再現
1 2 3 | def yhat(x): return -0.128 + 0.643*x # SSDSE-B-2026 47都道府県 OLS 結果 for name, x in [('鳥取',0.54),('北海道',5.09),('千葉',6.26),('愛知',7.48),('東京',14.09)]: print(f"{name} x={x}: ŷ={yhat(x):.3f} 百万人") |
📤 実行結果
💬 手計算 (Step 2) 8.932 と Python 出力が完全一致。 回帰直線が「総人口 1 百万人増 → 生産年齢人口 約 64 万人増」という人口構成上妥当な感覚を 1 式で表す。
🎮 触って理解する
スライダーで自分の手で直線を動かし、 残差平方和 (SSE) をどこまで小さくできるか挑戦してみましょう。 図の空白部分をクリック / タップすると点を追加、 点をドラッグすると移動できます。 各点から直線へ伸びる赤い縦線が残差 (予測誤差) で、 その二乗の総和が SSE です。 「📉 最小二乗解を表示」を押すと、 数式 b = Cov(x,y)/Var(x)・a = ȳ − b·x̄ で計算した本当の回帰直線 (青破線)と、 あなたの手動の直線 (緑)を見比べられます。
※ 初期の点は動作確認用のサンプル値であり、 SSDSE-B-2026 の実測値ではありません。 自由に追加・移動して実験してください。
| あなたの直線 (緑) | ŷ = 1.00 + 1.00x |
| SSE (残差平方和) | — |
| R² (決定係数) | — |
| 最小二乗直線 (青) | — |
| 達成可能な最小 SSE | — |
点を 2 つ以上置くと計算できます(図をクリック / タップ)。
💡 直感 — なぜ「二乗和の最小」なのか
スライダーを動かすと、 直線の位置に応じて赤い残差の長さが伸び縮みし、 SSE がリアルタイムで変わります。 傾き b と切片 a の 2 つのつまみを回して SSE をどんどん下げていくと、 ある一点でそれ以上下がらなくなる — これが最小二乗解です。 手作業では谷底を探り当てるのに苦労しますが、 数式 b = Cov(x,y)/Var(x)・a = ȳ − b·x̄ はこの谷底を一発で計算してくれます。 「📉 最小二乗解を表示」で答え合わせをすると、 あなたが手で見つけた直線が青破線にどれだけ近いか分かります。 残差の「和」ではなく「二乗和」を使うのは、 正負が打ち消し合わないようにし、 かつ大きな外れに強くペナルティを与えるためです。
⚠️ よくある落とし穴 — このミニ実験で体感できること
- 外れ値への感応:右端や上方にポツンと 1 点を追加してドラッグしてみてください。 その 1 点だけで最小二乗直線 (青) が大きく傾きます。 二乗和はてこ比の高い点に引っ張られやすい、 という 外れ値 の性質が目で見えます。
- 外挿の危うさ:点は x の範囲内にしか置けません。 直線を範囲外へ延ばした先の予測は、 データが 1 つも無い領域の当てずっぽうです。 図の端でも自信を持ってはいけません。
- 相関 ≠ 因果:点を右肩上がりに並べれば R² は 1 に近づきますが、 それは「x で y を予測できる」というだけで「x が y の原因」を意味しません。 きれいな直線ほどこの誤読が起きやすいので注意です。
- R² が負になる:わざと的外れな直線にすると R² がマイナスになります。 R² = 1 − SSE/SStot は「平均で予測するより悪い直線」ではマイナスになり得る、 という定義そのものを確認できます。
🚀 発展 — この先へ
🐍 Python での回帰直線描画
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df import matplotlib.pyplot as plt import seaborn as sns import numpy as np from scipy import stats # 散布図 + 回帰直線 plt.scatter(x, y, alpha=0.6) # scipy で計算 slope, intercept, r, p, se = stats.linregress(x, y) xx = np.linspace(x.min(), x.max(), 100) plt.plot(xx, slope*xx + intercept, 'r-', lw=2) plt.text(0.05, 0.95, f'y = {slope:.5f}x + {intercept:.2f}\nR² = {r**2:.3f}', transform=plt.gca().transAxes) # seaborn で簡単に sns.regplot(x=x, y=y, ci=95) # 信頼区間付き sns.regplot(x=x, y=y, lowess=True) # 非線形平滑化 |
🚧 落とし穴と注意点
- サンプルサイズを確認(小標本では結果が不安定)
- 仮定の検証(正規性、 独立性、 等分散性)
- 外れ値の影響を散布図で確認
- 多重比較問題(複数検定時は補正を)
- p値だけで判断しない、 効果量と信頼区間を併記
- 因果関係を主張するには別の根拠が必要
🐍 Python 実装バリエーション
A. scipy.stats.linregress(最も簡潔・p 値付き)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df from scipy import stats r = stats.linregress(x, y) print(r.slope, r.intercept, r.rvalue**2, r.pvalue, r.stderr) |
stats.linregress は slope, intercept, rvalue, pvalue, stderr の順に返す。 傾き 0.00287(総人口が 1 万人増えると消費支出が約 29 円増える)、 切片 288,262 円、 R² は rvalue**2 = 0.1106、 p 値 0.0224、 傾きの標準誤差 0.00121。 p < 0.05 で傾きは有意だが、 R² は 0.11 しかない——「有意である」ことと「よく説明できる」ことは別だという典型例。 人口の大小で説明できるのは県別消費支出のばらつきのうち 1 割程度で、 残り 9 割は別の要因による。 なお切片 288,262 円は「総人口 0 の県」というデータ範囲外への外挿値なので、 実質的な解釈上の意味は薄い。B. numpy.polyfit(多項式回帰にも拡張可)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df b, a = np.polyfit(x, y, deg=1) print(a, b) # 2次多項式に拡張 c2, c1, c0 = np.polyfit(x, y, deg=2) |
C. statsmodels.OLS(標準誤差・CI・診断統計を完備)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df import statsmodels.api as sm X = sm.add_constant(x) m = sm.OLS(y, X).fit() print(m.summary()) print(m.conf_int(alpha=0.05)) |
D. sklearn.linear_model.LinearRegression(パイプライン向け)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df from sklearn.linear_model import LinearRegression lr = LinearRegression().fit(x.reshape(-1,1), y) print(lr.intercept_, lr.coef_, lr.score(x.reshape(-1,1), y)) |
E. ロバスト回帰(外れ値耐性)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # ── 回帰直線の例で使うデータを用意します(47 都道府県)── import numpy as np import pandas as pd _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) _df = _df[_df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _df['年度'] = pd.to_numeric(_df['年度'], errors='coerce') _df = _df[_df['年度'] == _df['年度'].max()] _df['総人口'] = pd.to_numeric(_df['総人口'], errors='coerce') _df['消費支出(二人以上の世帯)'] = pd.to_numeric(_df['消費支出(二人以上の世帯)'], errors='coerce') _df = _df.dropna(subset=['総人口', '消費支出(二人以上の世帯)']) x = _df['総人口'].to_numpy(dtype=float) # 説明変数 y = _df['消費支出(二人以上の世帯)'].to_numpy(dtype=float) # 目的変数 df = _df import statsmodels.api as sm rlm = sm.RLM(y, sm.add_constant(x), M=sm.robust.norms.HuberT()).fit() print(rlm.params) |
⚠️ 回帰直線の落とし穴 7 連発
1. 「R² が高い=良いモデル」と即断する。R² は説明変数を増やすほど機械的に上がります。 また、 トレンドが強い時系列では、 関係性が無くても R² が 0.9 を超えることが頻繁にあります。 必ず Adjusted R²、 残差プロット、 ホールドアウト精度を併用して評価しましょう。
2. 外挿(外れた範囲の予測)を信じる。回帰直線は訓練データの x 範囲内でのみ妥当です。 都道府県データで「人口 5,000 万人の県」を予測しても、 そんなサンプルは存在しないため精度保証は無く、 関係性自体が非線形に折れ曲がる可能性も高いです。 予測区間(PI)を必ず表示しましょう。
3. 外れ値・てこ比の高い点を見逃す。1 点の極端な観測値(例:東京都の標準地価)が傾き b を大きく支配することがあります。 Cook 距離・DFBETAS・leverage(hii)をチェックし、 該当点を除いた感度分析を必ず併記しましょう。
4. 残差の独立性・等分散性を確認しない。残差プロットでファネル状(分散が右に行くほど広がる)になっていれば不均一分散です。 Heteroskedasticity-robust SE(HC0〜HC3)を使うか、 重み付き最小二乗(WLS)に切り替えましょう。 時系列残差は Durbin-Watson で自己相関を確認します。
5. 「相関 = 因果」の誤読。回帰直線の傾きが有意でも、 それは「予測関係」であって介入効果ではありません。 第三因子(交絡)の影響を除外したいなら、 重回帰での共変量調整、 DID、 IV 法、 RCT などの因果デザインが必要です。
6. 単位を考慮しないで係数を比較する。「所得」が千円単位、 「人口」が万人単位だと、 b の絶対値の意味が変わります。 変数間で寄与の大小を比較するなら、 標準化(z スコア化)してから回帰し、 標準化係数 β を使いましょう。
7. 非線形関係を直線で押さえつける。消費と所得は累進的(高所得層では限界消費性向が下がる)など、 多くの社会データは非線形です。 残差を x に対してプロットしてパターンを目視し、 log 変換・二次項・スプライン回帰の導入を検討しましょう。
🗺️ 概念マップ — 3つの視点で体系を理解する
回帰直線 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 関連・回帰 › 回帰 › 回帰直線
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 回帰直線 を置き、 そこから 単回帰・散布図・OLS・重回帰・相関係数・ヒストグラム など 計 8 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「回帰直線」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「回帰直線」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 回帰直線 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 回帰 → 回帰直線 という入れ子の位置を示します。 「回帰には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
📌 補足セクション — 回帰直線を SSDSE-B-2026 で確かめる
本セクションは「回帰直線」を 47都道府県データ(SSDSE-B-2026)で具体的に確認するための追加教材です。 例として総人口を説明変数、 高齢人口(65歳以上人口)を目的変数とした直線を扱います。
🎨 直感で掴む — 回帰直線
回帰直線を 47都道府県データで直感的に捉えるには、 まず「総人口を説明変数、 高齢人口を目的変数とした直線」を思い浮かべます。 東京都・大阪府・神奈川県のように総人口が大きい都道府県ほど、 高齢人口や生産年齢人口も大きくなる傾向があり、 こうしたデータの「形」を 回帰直線 は要約します。
たとえば 47都道府県を散布図にすると、 右肩上がりの帯状にデータが並びます。 この「帯の傾き」「帯のばらつき」「帯から外れる外れ値」を表現する道具が、 ここで扱う 回帰直線 だとイメージしてください。
- 比喩:47枚のレシート(各都道府県)を 1 本のメジャー(回帰直線)で測る。
- 具体例:東京(人口 1396万)と鳥取(人口 55万)の差を、 1 つの指標で要約。
- 図解:横軸 総人口、 縦軸 高齢人口の散布図を頭に描く。
📐 数式または定義
回帰直線の中心的な数式は次のとおりです( SSDSE-B-2026 の 47 都道府県 \(n=47\) を想定):
$$ \hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1 x_i, \quad i = 1, 2, \dots, 47 $$ $$ \hat{\beta}_1 = \frac{\sum_{i=1}^{47} (x_i - \bar{x})(y_i - \bar{y})}{\sum_{i=1}^{47} (x_i - \bar{x})^2}, \quad \hat{\beta}_0 = \bar{y} - \hat{\beta}_1 \bar{x} $$ここで \(x_i\) は総人口、 \(y_i\) は高齢人口、 \(\bar{x}, \bar{y}\) はそれぞれの標本平均を表します。 回帰直線の解釈は、 上式で得られる係数や残差から導かれます。
🧮 実値で計算してみる — 回帰直線
SSDSE-B-2026 の 47都道府県データから、 「総人口を説明変数、 高齢人口を目的変数とした直線」を Python で再現します。 まず一行で読み込めるよう、 引数を直書きしたシンプル版を示します:
1 2 | # 最小コード(直書き) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) |
続いて、 列名はリポジトリ準拠(A1101 総人口、 A1102 男性人口、 A1303 高齢人口、 等)の本番コードです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 2023 年の 47都道府県スナップショット sub = df[df['SSDSE-B-2026'] == 2023].copy() x = sub['A1101'].astype(float) # 総人口 y = sub['A1303'].astype(float) # 高齢人口(65歳以上人口) # 回帰直線の基礎統計 x_mean, y_mean = x.mean(), y.mean() beta1 = ((x - x_mean) * (y - y_mean)).sum() / ((x - x_mean) ** 2).sum() beta0 = y_mean - beta1 * x_mean print(f'n = {len(x)}') # 47 print(f'beta1 = {beta1:,.4f}') # 傾き 0.2458 print(f'beta0 = {beta0:,.4f}') # 切片 120,545.05 print(f'相関係数 = {x.corr(y):.4f}') # 0.99+ になる # 残差・決定係数も計算 y_hat = beta0 + beta1 * x resid = y - y_hat ss_res = (resid ** 2).sum() ss_tot = ((y - y_mean) ** 2).sum() r2 = 1 - ss_res / ss_tot print(f'R^2 = {r2:.4f}') |
💬 傾き 0.2458 は、総人口が 1,000 人多い県は 65 歳以上人口が約 246 人多いことを表し、切片 120,545 人を加えた直線で R² = 0.982 が得られた。ただし 47 県の高齢化率の平均は 31.6% で、この傾き 24.6% と一致しないのは、切片が正のため小さい県ほど直線上の高齢化率が高くなるからである。残差は東京都が −37.8 万人と直線より大幅に若く、北海道は +30.9 万人と高齢者が多い。R² が高くても、高齢化の度合いの差は残差の側に出ている。
このコードを実行すると、 47都道府県データから 回帰直線に関連する係数・指標が直接得られます。 SSDSE-B-2026 が手元にない場合は、 統計データ活用コンペティション公式ページからダウンロードしてください。
⚠️ 補足の落とし穴
- 都道府県データはサンプルサイズ 47 が固定:標本数を増やせないため、 統計的検定の検出力は中程度に留まります。 解釈時にこの限界を意識してください。
- スケールの違い:総人口(百万単位)と消費支出(十万単位)など、 桁が大きく異なる変数は標準化して扱うのが安全です。
- 東京・大阪等の影響点:少数の大都市が回帰や相関の結果を大きく動かすことがあります。 影響統計量(てこ比、 クックの距離)の確認を推奨します。
🔗 関連用語(補足リンク)
🔗 隣接手法への橋渡し
「回帰直線」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 散布図 で 2 変数の関連を確認した後、 最小二乗法 で 残差 の二乗和を最小化して引く
- 並列: 相関係数 は直線の「強さ」、 回帰直線は「式」。 分位点回帰 は外れ値に強い代替直線
- 下流: 直線の 傾き・切片 を解釈し、 予測 や 予測区間 による不確実性評価へ進む
47 都道府県データに「y = β₀ + β₁x」の 1 本の直線 を当てはめることで、 ばらついた点群を 2 つのパラメータに圧縮し、 解釈と予測の両方を可能にする。
🌳 手法選択フロー
「regression line」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | ビジネス理解 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | データ理解 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | データ準備 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | モデリング 等 |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | データアナリスト 等 |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | データサイエンティスト 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
👁️ 直感をもう一段深める — 回帰直線は「予測の物差し」
回帰直線 ŷ = a + b·x は、 「x を 1 つ与えたら y の平均的な値を返す物差し」です。 散布図の点群のまん中を貫く 1 本の直線を、 残差(各点から直線への縦のズレ)の二乗和 SSE が最小になるように置いた結果が回帰直線になります。 なぜ「二乗和」かというと、 正負のズレが打ち消し合わないようにし、 かつ大きなズレを強めに嫌うためです。 絶対値の和ではなく二乗の和にすることで、 微分でスッと解ける(正規方程式が線形になる)という計算上の利点もあります。
傾き b =「x が 1 増えると y が平均でどれだけ動くか」
SSDSE-B-2026(2023 年・47 都道府県)で 総人口 A1101 → 高齢人口 A1303 を当てはめると、 実測で ŷ = 120545.05 + 0.2458·x。 傾き b=0.2458(実測)は「総人口が 1 人多い県ほど、 高齢人口が平均で 0.2458 人多い」と読めます。 都道府県スケールに直せば「総人口 100 万人増 → 高齢人口 約 24.6 万人増」。 傾きは単位に依存するので、 大小を他変数と比べたいときは標準化してから比較します(標準化偏回帰係数)。
切片 a =「x=0 での y」だが解釈は文脈次第
切片 a=120545.05(実測)は「総人口 0 の県」というデータ範囲外への外挿値なので、 数値そのものの実質的意味は薄く、 「直線を重心 (x̄, ȳ) に通すための高さ調整」と捉えるのが安全です。 x=0 が現実に起こり得る文脈でのみ、 切片は素直に解釈できます。
回帰と相関は「同じ Sxy を別の物差しで見たもの」
傾き b と相関係数 r は、 分子が同じ偏差積和 Sxy で、 分母だけが違います:$b = S_{xy}/S_{xx}$、 $r = S_{xy}/\sqrt{S_{xx}S_{yy}}$。 したがって符号(正か負か)は必ず一致します。 標準化(z 得点化)してから回帰すると分母が揃い、 標準化した傾きは r に一致します($b = r\cdot s_y/s_x$)。 総人口→高齢人口では r=0.9910(実測)で、 「線形連動がほぼ完全」なことを示します。 共分散・最小二乗法・散布図を合わせて眺めると、 相関(強さ)と回帰(式)の役割分担が腑に落ちます。
🕳️ 落とし穴をもう一段深める(重要)
以下はいずれも SSDSE-B-2026 の実測値で確認した挙動です。 数字はすべて 2023 年・47 都道府県のデータから計算しています。
① 外挿 — データ範囲の外は「当てずっぽう」
回帰直線はx が観測された範囲の中でだけ信頼できます。 総人口→高齢人口の直線を「人口 3,000 万人の県」に当てても、 そんな県は存在せず、 関係が非線形に折れる可能性も高い。 信頼区間・予測区間は x̄ から離れるほど砂時計状に広がり、 範囲外では急激に増大します。 「端まで直線が引けるから予測できる」は錯覚です。
② 外れ値・高レバレッジ点 — 東京都で実測検証
x が平均から大きく離れた点(高レバレッジ点)は、 二乗和最小化の性質上、 直線を強く引っ張ります。 総人口が最大の東京都を除外して総人口→高齢人口を再フィットすると(実測):
この例では傾きは上がりました(東京都は傾きを引き下げる方向のてこだった)。 引っ張る向きはデータ次第で、 事前に決めつけられません。 だからこそ「1 点で結論が変わらないか」を Cook 距離・DFBETAS・てこ比 hii で調べ、 外れ値を含む/除く 2 通りの感度分析を必ず併記します。
③ 平均への回帰 — 相関が弱いほど予測は平均へ縮む
標準化すると予測は $\hat z_y = r\cdot z_x$。 |r|<1 なので、 x が平均から k 標準偏差ずれていても、 予測される y は平均から r·k 標準偏差しかずれません(=平均へ縮む)。 標準地価 C5401 → 消費支出 L3221 は実測で r=0.3096。 標準地価が平均より 2 標準偏差高い県でも、 消費支出の予測は平均より 0.62 標準偏差(=2×0.3096)高いだけです。 これが「平均への回帰(regression to the mean)」で、 実力だけでなく偶然の変動を含む指標ほど顕著に現れます。 「昨年トップの県が今年は少し落ちた」だけで施策の効果と誤読しないための必須知識です。
④ 相関 ≠ 因果 — 傾きが有意でも「効果」ではない
観察データの回帰係数は予測関係であって介入効果ではありません。 総人口→高齢人口の傾きが強く有意でも「人口を増やせば高齢者が増える」という因果は言えず、 単に両者が同じ人口規模を反映しているだけです。 交絡を除きたいなら重回帰での共変量調整、 DID、 IV、 RCT などの因果デザインが要ります。
⑤ x と y を入れ替えると別の直線 — 実測で確認
「y を x で説明する直線」と「x を y で説明する直線」は別物です。 総人口 x → 高齢人口 y は実測で傾き 0.2458。 逆に高齢人口 → 総人口を当てると傾き 3.9956(実測)で、 1/0.2458=4.07 とは一致しません。 2 本の直線は重心 (x̄, ȳ) で交わり、 2 つの傾きの積が R²(=r²)に一致します:0.2458 × 3.9956 = 0.982(実測)。 「どちらを説明変数に置くか」で傾きが変わるので、 目的(何を予測したいか)を先に決めることが大切です。
⑥ 非線形を直線で押さえつけない
社会データの多くは非線形(逓減・飽和・折れ曲がり)です。 残差を x に対してプロットして系統的な曲がり(U 字・扇形)がないか目視し、 あれば log 変換・二次項・スプライン(回帰分析の拡張)を検討します。 R² が高くても、 残差にパターンが残っていれば直線は不適切です。
🚀 発展をもう一段深める
最小二乗の幾何 — y を X の張る空間へ直交射影する
OLS は、 観測ベクトル y を「説明変数(と切片の 1 ベクトル)が張る部分空間」へ直交射影する操作と等価です。 予測 ŷ が射影の足、 残差 e = y − ŷ が射影の残りで、 e はその空間に直交します($X^\top e = 0$)。 これが「残差の和 = 0」「残差と x の積和 = 0」の幾何的正体です。 直交だからピタゴラスの定理が使え、 $\|y-\bar y\|^2 = \|\hat y-\bar y\|^2 + \|e\|^2$、 すなわち SStot = SSreg + SSres という分解が出ます。
決定係数 R² との関係
上の分解から $R^2 = SS_{reg}/SS_{tot} = 1 - SS_{res}/SS_{tot}$。 単回帰では R² = r² が成り立ちます。 総人口→高齢人口では R²=0.9820 = r²(r=0.9910 の二乗、実測)。 「射影の足の長さの二乗の割合」が R² です。 なお R² は「平均で予測するより悪い直線」では負にもなり得ます(本ページ上部の🎮ウィジェットで体感できます)。
信頼区間と予測区間 — 幅が違う理由
回帰直線の位置の不確実性が信頼区間、 個別の新規観測の不確実性が予測区間です。 予測区間は残差の分散 σ² を追加で含むぶん常に広く、 どちらも x̄ から離れるほど広がります(砂時計型)。 「平均的な y」を語るのか「ある 1 県の y」を語るのかで、 示すべき区間が変わります。
頑健回帰 — 二乗和をやめるという選択肢
二乗和は外れ値に弱いので、 絶対値損失(最小絶対偏差 LAD)・Huber 損失・Theil–Sen 推定などの頑健(ロバスト)回帰が代替になります。 中央値ベースの 分位点回帰も、 平均ではなく分位点の傾きを見たいときや裾の重い分布に有効。 東京都のような高レバレッジ点の影響を抑えたいときの第一選択です。
「回帰」の語源 — ゴルトンと平均への回帰
Galton(1886)は親子の身長を調べ、 「背の高い親の子は親ほどは高くなく、 平均へ戻る(regress)」現象を発見し、 これが regression の語源になりました。 落とし穴③で見た「標準化傾き=r による縮み」が、 その数学的な正体です。 回帰係数・単回帰・線形回帰へと言葉を辿ると、 同じ 1 本の直線が分野ごとに別名で呼ばれていることが分かります。