🔖 キーワード索引
本ページは 身体・運動 AI(Body / Motion AI)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
AIに体を持たせる技術です。
機械を上手に動かすために使います。
自動運転の車などが身近な例です。
AIがどうやって体を動かすか読みます。
- ロボティクスや動作生成など、 AI が 物理的・身体的な振る舞いを扱う領域
- 対象は 二足歩行ロボット、 ドローン、 自動運転、 動作キャプチャ、 物理シミュレーション など多岐
- 中核技術は 強化学習・模倣学習・運動学・力学制御を含む複合領域
- 「知覚→計画→制御」の 3 ステップで動作を生成するのが古典的設計
- 近年は RT-2 や PaLM-E のような Vision-Language-Action モデルで一気に進化中
💡 30秒で分かる結論
- 定義:ロボティクス・動作生成
- 分野:AI基礎
- 典型用途:以下「📍 文脈」と「🎨 直感で掴む」を参照
- 覚えておく要点:数式は 1 つ・落とし穴 5 つ・関連用語 12 個
- 注意点:表面的な定義の暗記より、 いつ・どう使うかを理解することが優先
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
AIと現実の世界をつなぐ橋です。
連続的な動きを作るために使います。
スポーツのフォーム解析などで使われます。
この技術がどこで役立つか読みます。
本サイトでは 身体・運動 AI は AI 応用分野の 1 つとして位置づけ、 「データ+数学+知能」が 物理世界と接する領域として扱います。 推論だけでなく 連続的な行動を出力する点で、 分類・回帰タスクとは大きく性格が異なります。 ロボティクス・自動運転・スポーツ動作解析・ヒューマノイドなど、 ハードウェアと AI の境界に位置する分野です。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
考えるだけでなく動かすAIです。
自然な動きを再現するために使います。
ゲームのキャラの動きが身近な例です。
具体的にどう動くのかを読みます。
「身体・運動 AI」を一言で言えば、 「考えるだけで終わらず、 体(あるいは機械)を動かす AI」。 たとえば次のような例:
- 二足歩行ロボット(Boston Dynamics の Atlas):起伏のある地形を走り、 バック宙までする
- ロボットアーム(料理ロボ・組立ライン):3 次元空間で物を掴み、 運び、 置く
- 自動運転:周辺認識→経路計画→ハンドル・アクセル制御 のループ
- キャラクター動作生成:ゲームや映画で、 物理的に自然な動きを作る
- 身体動作解析:スポーツ選手のフォーム改善、 リハビリ評価
共通するのは 「連続値の制御出力」を リアルタイムに決め続ける必要があること。 1 度の判断ミスが 転倒・衝突に直結するため、 安全性と頑健性が極めて重要です。
例えば二足歩行では、 関節 20 か所のトルクを 100 Hz で出力。 つまり 毎秒 2000 個の連続値を「正しく」決め続ける必要があり、 これを人間が手書きルールで作るのは事実上不可能。 そこで 機械学習の出番になります。
🎨 直感で掴む:身体動作データとは「時間 × センサー次元の多次元時系列」
身体動作(body movement)のデータ解析は、 ウェアラブル端末・モーションキャプチャ・スマートフォンの内蔵センサーから得られる 連続値時系列を入力として、 「歩行 / 走行 / 立ち上がり」などの動作カテゴリ、 関節角度、 消費カロリー、 転倒リスクを推定する分野です。 代表的なセンサーは 6 軸 IMU(3 軸加速度 + 3 軸ジャイロ)と GPS の組合せで、 高度な研究では Vicon や OptiTrack の光学式モーションキャプチャ、 EMG(筋電図)、 心拍計が追加されます。 サンプリングは 50〜200Hz が一般的で、 1 分間で 6 軸×100Hz = 36{,}000 数値が生成されるデータ密度の高い領域です。
比喩で言えば、 身体動作データは「音波(音声)と映像(画像)の中間」のような性質を持ちます:時間軸はあるが画素のような 2 次元構造はなく、 多軸センサーが平行に並走する。 そのため、 FFT・ウェーブレット・DTW・LSTM・1D-CNN・Transformer が代表手法です。 入力の実体は「加速度・角速度の多軸時系列」や「関節・骨格の 3 次元座標系列」といった連続値であり、 画像分類のように 1 枚で完結せず、 時間方向の文脈を保ったまま特徴量化する点が最大の特徴です。
| センサー種別 | サンプリング周波数 | 単位 | 代表用途 |
|---|---|---|---|
| 加速度センサー(3 軸) | 50〜200 Hz | m/s² または G | 歩数計、 動作分類 |
| ジャイロセンサー(3 軸) | 50〜200 Hz | rad/s または °/s | 姿勢推定、 回転量 |
| 地磁気センサー | 10〜50 Hz | μT | 方位、 屋内測位補正 |
| 心拍 (光学式) | 1〜25 Hz | bpm | 運動強度、 ストレス |
| 光学式モーションキャプチャ | 120〜240 Hz | mm | 関節位置・動作解析 |
| EMG(筋電) | 1000+ Hz | μV | 筋活動量、 リハビリ |
🎮 動かして学ぶ ── 関節キーポイントと角度で「姿勢」を読む
下は 架空の簡略化した棒人間(15 個の関節キーポイント/完全にダミー座標・実データではありません)です。 肩・肘・手首・腰・膝・足首などの点を ドラッグすると、 骨と骨がなす 関節角度(肘の曲げ角・膝の曲げ角など)がリアルタイムに計算され、 「立つ/座る/腕を上げる」を 角度ルールだけで自動判定します。 これが 姿勢推定(pose estimation) の最小核 ── 画像から関節点(キーポイント)を取り出し、 その 幾何(角度と距離)だけで動作を特徴づける、という発想の体験版です。
やっていることは 3 ステップ:(1) 関節を キーポイント(点)として表す → (2) 隣り合う骨ベクトルの内積から 関節角度を、 点同士の 距離を計算する → (3) 「膝角 < 150° なら座る/手首が肩より上なら腕を上げる/それ以外は立つ」という 角度ルールで姿勢を分類。 ノイズやオクルージョン(隠れ)を入れると、 推定がどう崩れるかも体感できます。
🔍 何が起きているか:姿勢分類の主役は 関節角度です。 肘・膝の角度は「隣り合う 2 本の骨ベクトル $\mathbf{u},\mathbf{v}$ の内積」から $\theta=\arccos\!\big(\tfrac{\mathbf{u}\cdot\mathbf{v}}{\|\mathbf{u}\|\|\mathbf{v}\|}\big)$ で一意に決まります(実装は数値安定な atan2(|cross|, dot))。 立つ=膝ほぼ 180°・腕は下、 座る=膝が曲がる(<150°)、 腕を上げる=手首の $y$ が肩より上 ── この 角度・距離のルールだけで、 生の座標を見ずに姿勢を切り分けられます。 実際の姿勢推定も「画像→キーポイント→角度特徴→分類」という同じ骨格です。
💡 直感 ── 点と角度で姿勢を「読む」
人が姿勢をひと目で読むとき、 見ているのは 関節の位置関係です。 「肘が曲がっている」「手が頭より高い」「膝が直角」── これらはすべて キーポイント間の角度と距離に還元できます。 姿勢推定の要点は、 数百万画素の画像を 十数個の点にまで圧縮し、 その点群の幾何だけで動作を語ること。 上のウィジェットで肘角・膝角が姿勢と連動して変わるのを見れば、 「点と角度で姿勢は完全に記述できる」という直感がつかめます。 姿勢を 特徴づけるのは、 生座標そのものではなく、 角度(回転不変・平行移動不変)や 正規化した距離(体格でスケール補正)です。
⚠️ 落とし穴 ── 「動かして崩れる」ポイント
- オクルージョン(隠れ):手が体や物に隠れると、 そのキーポイントは検出できません。 ウィジェットの鏡映推定のように「対称性で補う」のが定石ですが、 左右非対称な姿勢では大きくズレます(誤差が増えるのを実際に確認できます)。
- 自己遮蔽(self-occlusion):腕が胴の前を横切る、 脚が重なるなど、 自分の体で自分の関節が隠れるケース。 正面カメラの盲点で、 単一視点では原理的に復元できないことがあります(複数カメラや時系列で補完)。
- 2D 投影の曖昧性:2D 画像は 3D を平面に潰したもの。 カメラに向かって腕を伸ばすと 骨が短く写り(前縮み)、 角度が実際と違って見えます。 「2D で 90° に見えても 3D では違う」── 奥行きの欠落が根本原因で、 3D 姿勢推定が必要になる理由です。
- 個人差・体格:手足の長さ・関節可動域は人によって違います。 生の距離をそのまま使うと体格に依存するので、 肩幅などで正規化し、 角度を主特徴にするのが頑健です。
- キーポイント検出ノイズ:σ を上げると分かる通り、 点が数 px 揺れるだけで細い骨の角度は大きくブレます。 時間方向の平滑化(カルマン/移動平均)や信頼度スコアでの重み付けが実務では必須です。
🚀 発展 ── 角度ルールの先へ
- 2D 姿勢推定:画像から関節キーポイントを直接回帰/ヒートマップで検出(OpenPose・CNN 系ヒートマップ回帰の考え方)。 上のウィジェットの「点」を画像から自動で得る段階に相当します。
- 3D 姿勢推定:単眼 2D から 3D 骨格を持ち上げる(lifting)、 あるいは複数カメラの三角測量で奥行きを回復し、 2D 投影の曖昧性・自己遮蔽を緩和します。
- 時系列での動作認識:1 フレームの角度ルールを超え、 角度の 時間変化を LSTM・Transformer・ST-GCN(骨格グラフ×時系列)で扱い、 「歩く/しゃがむ/投げる」など連続動作を認識します。
- スポーツ・リハビリ応用:関節角度の時系列からフォーム評価・可動域(ROM)測定・左右対称性の定量化。 本ページ後半のモーションキャプチャ/リハビリ指標(NJM 等)と地続きです。
- 関連手法との棲み分け:加速度信号の活動分類は センサーデータ、 軌跡の照合は ジェスチャー認識、 画像からの検出全般は 画像認識。 本節はその中で 関節キーポイントの幾何(角度・骨格)に特化した入口です。
📐 定義・数式
🍰 まずはやさしく
動きをルールにした数式です。
正しい動作を計算するために使います。
ロボットの関節の角度を決める例です。
動きをどう計算するかを読みます。
強化学習で動作を学ぶ際の方策(policy)と累積報酬:
制御工学側の表現としては、 動作方程式と最適化問題の組み合わせ:
📐 数式・定義
身体・運動 AIを数式 / 形式定義で表す:
ロボット動力学方程式:関節トルク $\boldsymbol{\tau}$ は、 慣性 $M$・コリオリ $C$・重力 $G$ の和で決まる。 運動 AI はこの $\boldsymbol{\tau}$ を最適化する。
📐 数式:関節角度、 FFT、 DTW
① 関節角度(Euler 角ベース):3 次元空間で隣接する 2 つの骨の方向ベクトル $\mathbf{u}, \mathbf{v}$ がなす角度は内積から導けます。
$$ \theta = \arccos\!\left( \frac{\mathbf{u} \cdot \mathbf{v}}{\|\mathbf{u}\| \|\mathbf{v}\|} \right), \quad \theta \in [0, \pi] $$
② FFT(高速フーリエ変換)による周波数特徴:歩行や走行は周期的なので、 加速度信号 $x(t)$ をスペクトルに変換すると「歩行周波数」のピークが現れます。 離散 FFT は次の通り:
$$ X_k = \sum_{n=0}^{N-1} x_n \cdot e^{-i \cdot 2\pi k n / N}, \quad k = 0, 1, \ldots, N-1 $$
パワースペクトル密度 $P_k = |X_k|^2 / N$ のピークが 1.5〜2.5 Hz にあれば歩行、 2.5〜4 Hz は走行、 と判定できます。
③ DTW(Dynamic Time Warping):2 つの時系列 $X = (x_1, \ldots, x_N)$、 $Y = (y_1, \ldots, y_M)$ の「形は似てるが時間軸が伸縮した」類似度を測る指標。 動的計画法で最適アライメントを求めます:
$$ D(i, j) = d(x_i, y_j) + \min\bigl\{ D(i-1, j),\ D(i, j-1),\ D(i-1, j-1) \bigr\} $$
$$ \text{DTW}(X, Y) = D(N, M) $$
🔬 数式を言葉で読み解く
- 関節角度の $\arccos$:内積を 0 〜 π に写像する関数。 0 は同方向、 π は逆方向を意味する。 膝関節屈曲なら 0 で完全伸展、 π/2 で 90 度屈曲。
- FFT の $X_k$:周波数 $k$ の振動成分の振幅(複素数)。 $|X_k|$ が大きいほどその周波数の振動が強い。
- $P_k = |X_k|^2 / N$:パワースペクトル密度。 「どの周波数にエネルギーが集中しているか」のグラフ。
- DTW の $d(x_i, y_j)$:局所距離(普通はユークリッド距離 or 絶対値)。 「時間軸の伸縮を許容しつつ、 形状の違いだけを定量化」する。
- 3 つの $\min$:「斜め進み(時間軸が両方とも進む)」「右進み(X の時間が進む)」「下進み(Y の時間が進む)」のうち最小経路を選ぶ。 結果として、 同じ動作が違うスピードで行われても類似度として認識できる。
- 計算量は $O(NM)$。 fastdtw、 制約付き DTW(Sakoe-Chiba band)で実用的な速度に下げる。
🔬 記号・要素の読み解き
- $s_t$(状態)
- 時刻 $t$ での観測値(関節角度、 速度、 カメラ画像、 IMU 等)
- $a_t$(行動)
- その時刻に出力する制御量(モーター指令、 ハンドル角度、 推力指令)
- $r(s,a)$(報酬)
- 「望ましさ」を数値化。 「前進」「省エネ」「安定」など。 設計次第で挙動が激変
- $\gamma$(割引率)
- 0〜1 の値。 1 に近いほど遠い未来の報酬も重視する
- $\pi$(方策)
- 状態を入れると行動を返す関数。 通常はニューラルネット(数千万パラメータ)
- $x^{\mathrm{ref}}$(参照軌道)
- MPC で「こう動いてほしい」目標の状態列
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $\boldsymbol{q}$ | 関節角度ベクトル |
| $\dot{\boldsymbol{q}}, \ddot{\boldsymbol{q}}$ | 速度・加速度 |
| $M(\boldsymbol{q})$ | 慣性行列 |
| $C$ | コリオリ・遠心項 |
| $G(\boldsymbol{q})$ | 重力項 |
| $\boldsymbol{\tau}$ | 関節に与えるトルク(制御出力) |
🔬 数式を言葉で読み解く(身体・運動データ解析の体系)
身体・運動データ(Body Movement Data)は、 ヒトや動物の身体運動を時系列・空間的に記録した数値データの総称である。 ここでは「モーションキャプチャ」「IMU センサー」「動画解析」「スポーツ科学」「リハビリ応用」「ジェスチャー認識」の 6 領域を、 数式と代表データ形式を軸に整理する。 身体動作データは「サンプリング周波数 × 関節数 × 軸数」の三次元テンソル $X \in \mathbb{R}^{T \times J \times D}$ として扱われ、 $T$ はフレーム数、 $J$ は関節数(OpenPose では 25、 SMPL では 24)、 $D$ は座標次元(2D 画像なら 2、 3D モーキャプなら 3)である。 いずれの領域でも入力の実体は「加速度・角速度の多軸時系列」または「関節・骨格の 3 次元座標系列」であり、 サンプリング周波数・関節数・軸数の 3 つが解析設計の出発点となる。
🎯 1. モーションキャプチャ系(Marker-based / Markerless)
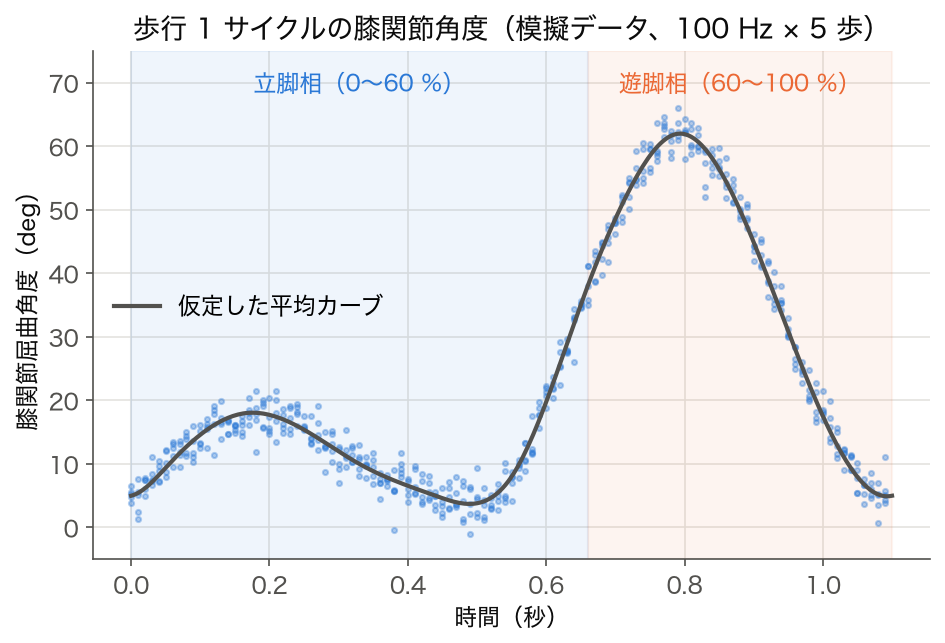
光学式モーションキャプチャでは、 被験者の関節付近に貼られた反射マーカーの位置 $\mathbf{p}_j(t) = (x_j, y_j, z_j)$ を 100-1000 Hz で記録する。 関節角度 $\theta(t)$ は隣接マーカー間ベクトル $\mathbf{v}_1, \mathbf{v}_2$ の内積から $\theta = \arccos\left(\frac{\mathbf{v}_1 \cdot \mathbf{v}_2}{|\mathbf{v}_1||\mathbf{v}_2|}\right)$ で求める。 マーカーレス系(OpenPose, MediaPipe)は深層学習で 2D キーポイントを推定し、 三角測量で 3D 化する。 得られる $\mathbf{p}_j(t)$ の座標系列から、 歩幅・関節可動域・重心動揺といった臨床指標を算出できる。
🎯 2. IMU センサー系(加速度・角速度・地磁気)
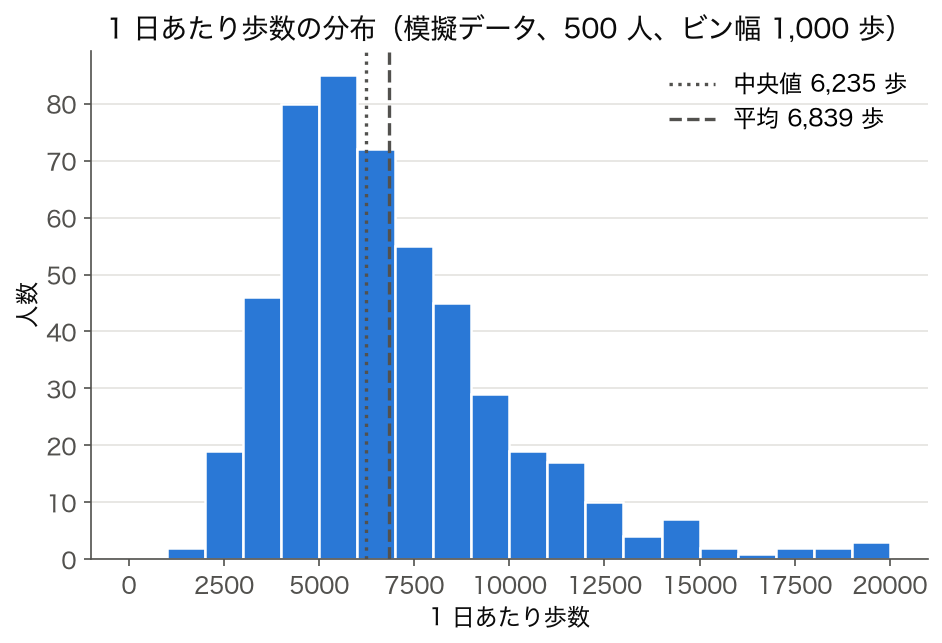
IMU(Inertial Measurement Unit)は加速度 $\mathbf{a}(t) \in \mathbb{R}^3$、 角速度 $\boldsymbol{\omega}(t) \in \mathbb{R}^3$、 地磁気 $\mathbf{m}(t) \in \mathbb{R}^3$ を同時計測する 9 軸センサーである。 姿勢 $\mathbf{q}(t)$(四元数)は相補フィルタ $\mathbf{q}_{t+1} = (1-\alpha) \cdot \mathbf{q}_{\text{gyro}} + \alpha \cdot \mathbf{q}_{\text{acc+mag}}$ で推定し、 $\alpha \approx 0.02$ が典型値。 歩数推定は加速度ノルム $|\mathbf{a}| = \sqrt{a_x^2 + a_y^2 + a_z^2}$ のピーク検出で行う。 Apple Watch・Fitbit などのウェアラブルはこの原理で日々の歩数・活動量を推定し、 加速度ノルムの時系列を特徴量化して行動を分類している。
🎯 3. スポーツ科学・パフォーマンス分析
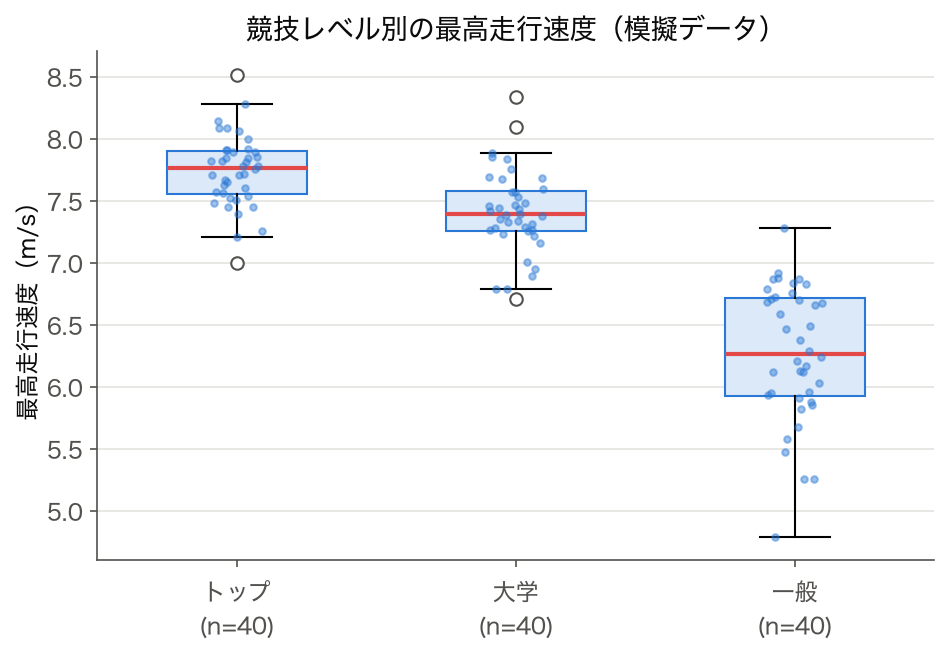
投球速度・走行速度・ジャンプ高 $h = \frac{v_0^2 \sin^2\theta_0}{2g}$ といった運動学的指標と、 関節トルク $\tau = I \alpha$($I$: 慣性モーメント、 $\alpha$: 角加速度)といった力学的指標がある。 トラックマン(野球)、 Catapult(サッカー)、 STATSports(ラグビー)などの GPS+IMU 一体型デバイスは、 選手の総走行距離・スプリント回数・心拍数を試合中リアルタイム記録する。 これらの多軸時系列から疲労・傷害リスクを推定し、 トレーニング負荷(ACWR など)の管理に機械学習が活用されている。
🎯 4. リハビリテーション応用
脳卒中後の上肢リハビリでは、 Fugl-Meyer Assessment スコアと身体動作データ(reaching task の軌道滑らかさ:jerk $j = \frac{d^3 x}{dt^3}$ の積算)が強く相関する。 リハビリ進捗の定量化指標 NJM(Normalized Jerk Metric)$\text{NJM} = \sqrt{\frac{1}{2} \int_0^T j^2 \, dt \cdot \frac{T^5}{L^2}}$ は健常者で 5-15、 重度患者で 200 を超える。 高齢者転倒予測モデルでは IMU + 機械学習(XGBoost)で AUC 0.85 を達成し、 日常の加速度ログから転倒の予兆となる歩容変化を検出できる。
🎯 5. ジェスチャー認識・HCI
手話認識・サインジェスチャ識別では LSTM/Transformer で時系列特徴量を分類する。 入力テンソル $X \in \mathbb{R}^{T \times 21 \times 3}$(MediaPipe Hands の 21 キーポイント × 3 軸)を、 双方向 LSTM 隠れ状態 $\mathbf{h}_t = \text{BiLSTM}(\mathbf{x}_t, \mathbf{h}_{t-1}, \mathbf{h}_{t+1})$ で符号化し、 ソフトマックス分類器で語彙 ID を出力する。 ASL(米国手話)データセット WLASL2000 で SOTA 精度 70%+。 動的時間伸縮(DTW)距離 $D(i,j) = d(i,j) + \min(D(i-1,j), D(i,j-1), D(i-1,j-1))$ も古典手法として現役。
🎯 6. 行動分類・日常活動認識(HAR)
スマートフォン IMU からの行動認識(Human Activity Recognition: HAR)は「歩く・走る・座る・立つ・階段昇降」など 6-12 クラスを CNN+LSTM で分類する。 公開データセット UCI HAR(30 人 × 6 行動 × 50Hz × 2.56 秒窓)でテスト精度 96% 超。 PAMAP2 では心拍数も統合し、 安静時心拍 60 bpm vs 階段昇降 130 bpm を識別できる。 加速度・角速度・心拍を統合した特徴量で「日常活動量(MVPA 分・歩数)」を定量化し、 健康アウトカムとの関連を検証する研究が広がっている。
✅ 理解度チェック(3 問)
- Q1: モーションキャプチャで関節角度を計算する式は?
A: 隣接マーカー間ベクトル $\mathbf{v}_1, \mathbf{v}_2$ の内積から $\theta = \arccos\left(\frac{\mathbf{v}_1 \cdot \mathbf{v}_2}{|\mathbf{v}_1||\mathbf{v}_2|}\right)$。 - Q2: IMU の 9 軸とは何か?
A: 加速度 3 軸、 角速度 3 軸、 地磁気 3 軸の合計 9 軸。 - Q3: リハビリ進捗指標 NJM の健常者 vs 重度患者の典型値は?
A: 健常者 5-15、 重度患者は 200 超。
💬 まとめ: 身体・運動データ解析は「センサー → 特徴量 → モデル → 応用」の 4 段階で構造化でき、 各段階で異なる数式・ツールが必要となる。 個人スケールのセンサーログに加え、 公的統計のマクロ指標(本ページ後半の SSDSE-B-2026 演習を参照)と接続すれば、 動作データから地域スケールの健康傾向まで視野を広げられる。 これは「定量的健康科学」「スマートシティ」「介護予防」の根幹技術である。
🧪 SSDSE-B-2026 で「地域特性 × 出生率」を偏相関で多角的に検証する
SSDSE-B-2026 には「スポーツ実施率・歩数・健康寿命・国民医療費・要介護認定率」といった身体活動そのものや健康アウトカムの変数は収録されていない。 そこで本セクションでは、 実在する都道府県の地域特性指標(着工新設住宅戸数・延べ宿泊者数・医療施設密度・高齢化率・出生率)を題材に、 単純相関 → 偏相関という交絡統制の標準ワークフローを実データで体験する。 個人スケールの IMU データ解析(本ページ前半)と、 公共統計スケールの多変量解析を接続する「型」を身につけるのが狙いである。 使用データは SSDSE-B-2026.csv(564 行 = 47 都道府県 × 12 年分、 112 列)で、 年次列 SSDSE-B-2026==2023 を抽出して用いる。 相関・偏相関の数値はすべて 2023 年 47 都道府県で実測したものである。
📋 使用変数の整理(SSDSE-B-2026 実在列のみで構成)
身体活動・健康寿命の直接変数は SSDSE-B に無いため、 実在列から派生計算した地域特性指標で交絡統制のワークフローを実演する。 いずれも 2023 年 47 都道府県の実測値。
| 記号 | SSDSE-B 列(派生計算) | 指標 | 単位 | 典型レンジ(2023, 47 都道府県) |
|---|---|---|---|---|
| $X_1$ | H1800 / A1101 × 1000 | 着工新設住宅戸数(人口千対) | 戸 | 3.6 - 8.9 |
| $X_2$ | G7101 / A1101 | 延べ宿泊者数(1 人当たり) | 泊 | 0.6 - 13.7 |
| $X_3$ | I510120 / A1101 × 10⁵ | 一般病院数(人口 10 万対) | 施設 | 3.1 - 16.1 |
| $X_4$ | I5102 / A1101 × 10⁵ | 一般診療所数(人口 10 万対) | 施設 | 62 - 113 |
| $Z$ | A1303 / A1101 × 100 | 高齢化率(65 歳以上割合)=交絡変数 | % | 22.8 - 39.1 |
| $Y$ | A4101 / A1101 × 1000 | 出生率(人口千対)=アウトカム | 人 | 4.0 - 8.6 |
🐍 ステップ 1: 単純相関の総当たり
このコードでやること: SSDSE-B-2026 の 2023 年(SSDSE-B-2026==2023)から地域特性 6 変数を派生計算し、 pandas.DataFrame.corr() でピアソン相関の総当たり行列を作成、 ヒートマップで可視化する。
📥 入力データ(読み込み後 head の例):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import matplotlib.pyplot as plt import seaborn as sns df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年・47 都道府県 d = pd.DataFrame({'都道府県': df['Prefecture']}) d['X1_住宅'] = df['H1800'] / df['A1101'] * 1000 # 着工新設住宅戸数(人口千対) d['X2_宿泊'] = df['G7101'] / df['A1101'] # 延べ宿泊者数(1 人当たり) d['X3_病院'] = df['I510120'] / df['A1101'] * 1e5 # 一般病院数(人口 10 万対) d['X4_診療'] = df['I5102'] / df['A1101'] * 1e5 # 一般診療所数(人口 10 万対) d['Z_高齢化'] = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) d['Y_出生'] = df['A4101'] / df['A1101'] * 1000 # 出生率(人口千対) corr = d.drop(columns='都道府県').corr(method='pearson') print(corr.round(3)) sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r', vmin=-1, vmax=1) plt.tight_layout() plt.savefig('corr_heatmap.png', dpi=120) |
📤 実行例(相関行列、 主要部分):
💬 読み方: 着工新設住宅戸数(X1)・延べ宿泊者数(X2)は出生率(Y)と r ≈ +0.58, +0.33 の正相関を示し、 一見「建設・交流が活発な地域ほど出生率が高い」ように見える。 しかし高齢化率(Z)は出生率と r = −0.62、 住宅着工とも −0.78 と強く相関しており、 Z が最有力の交絡候補である。 逆に一般病院数(X3)は出生率とほぼ無相関(r = +0.03)に見えるが、 Z とは +0.54(過疎・高齢地ほど人口当たり病院が多い)で、 この見かけの無相関は Z による抑制(suppression)の疑いがある。 単純相関だけで結論せず、 次の偏相関で高齢化率を統制する。
🐍 ステップ 2: 高齢化率を統制した偏相関
このコードでやること: 高齢化率 $Z$ を条件として、 地域特性指標(住宅着工・延べ宿泊・一般病院数)と出生率の偏相関係数を計算する。 $r_{XY \cdot Z} = (r_{XY} - r_{XZ}r_{YZ}) / \sqrt{(1 - r_{XZ}^2)(1 - r_{YZ}^2)}$。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import pingouin as pg # ステップ 1 の d(2023 年・47 都道府県の派生 6 変数)をそのまま使う rows = [] for x in ['X1_住宅', 'X2_宿泊', 'X3_病院']: res = pg.partial_corr(data=d, x=x, y='Y_出生', covar='Z_高齢化', method='pearson') res.index = [f'{x} vs Y_出生 | Z_高齢化'] rows.append(res) out = pd.concat(rows) out['r'] = out['r'].round(3) out['p_val'] = out['p_val'].round(4) print(out.to_string()) |
📤 実行例(偏相関):
💬 読み方: 住宅着工 × 出生率は単純相関 +0.58 だったが、 高齢化率を統制した偏相関では r=0.20(p=0.19)へ縮小し有意でなくなる → 見かけの相関の大半は高齢化率による交絡だった。 延べ宿泊 × 出生率も +0.33 → 0.22(p=0.15)と同様。 対照的に一般病院数 × 出生率は単純相関 +0.03(ほぼ無相関)だったのに、 高齢化率を統制すると r=0.55(p<0.001)の強い正相関が出現する(抑制効果 suppression)。 高齢化率が「人口比の病院数を増やしつつ出生率を下げる」ため、 単純相関では真の関連が打ち消されていた。 交絡変数は見かけを水増しも真値を隠しもする——偏相関で両方向を点検すべき典型例である。
📈 IMU 6 軸ストリーム解析:歩行サイクル分割と歩幅推定の実装パターン
スマートウォッチや腰部 IMU から得られる 100 Hz の加速度・角速度ストリームから、 歩行イベント(踵接地・つま先離地)を検出し、 ケーデンス・歩幅・対称性を算出するのは身体運動解析の中核タスクである。 ここでは scipy.signal で完結する実装と、 外部統計の全国歩数平均(後述の概算値。 SSDSE-B に歩数列は無い)との接続を示す。
📊 歩行解析パラメータの典型範囲
| パラメータ | 記号 | 健常成人 | 転倒高リスク高齢者 | パーキンソン病 | 計算式 |
|---|---|---|---|---|---|
| ケーデンス | $f_c$ | 110 - 120 spm | 85 - 100 spm | 90 - 130 spm(変動大) | $60 / T_{step}$ |
| 歩幅 | $L_s$ | 0.65 - 0.75 m | 0.35 - 0.50 m | 0.30 - 0.55 m | $v \cdot T_{step}$ |
| 歩行速度 | $v$ | 1.2 - 1.4 m/s | 0.6 - 0.9 m/s | 0.8 - 1.1 m/s | $L_s \cdot f_c / 60$ |
| 両脚支持期割合 | $DS\%$ | 20 - 25 % | 30 - 40 % | 25 - 35 % | $T_{DS} / T_{cycle}$ |
| 左右対称指数 | $SI$ | < 5 % | 10 - 25 % | 5 - 20 % | $2|L - R| / (L + R) \cdot 100$ |
| 加速度 RMS | $a_{RMS}$ | 0.30 - 0.50 g | 0.15 - 0.25 g | 0.20 - 0.35 g | $\sqrt{\frac{1}{N}\sum a_i^2}$ |
🐍 加速度ピーク検出による歩数カウント
このコードでやること: 腰部 IMU の鉛直加速度ストリーム(100 Hz・132.4 秒。 歩行 1.87 Hz にノイズを重ねた合成データ)を作り、 0.5-3 Hz のバンドパスをかけてから scipy.signal.find_peaks で踵接地時刻を検出し、 歩数とケーデンスを算出する。 1 日歩数に換算して健康日本 21 の目標 8,000 歩と比べる。
📥 入力データ例(PhysioNet Daphnet と同じ列構成。 コードでは az_g だけを合成して使う):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd from scipy.signal import butter, filtfilt, find_peaks # 100 Hz・132.4 秒の腰部 IMU(Daphnet と同じ列構成)を合成する(歩行 1.87 Hz + ノイズ) fs = 100 rng = np.random.default_rng(0) t = np.arange(0, 132.4, 1 / fs) az = 1.0 + 0.25 * np.sin(2 * np.pi * 1.87 * t) + rng.normal(0, 0.05, t.size) imu = pd.DataFrame({'time_s': t, 'az_g': az}) # 0.5-3 Hz のバンドパスで重力成分と高周波ノイズを除いてから、踵接地のピークを拾う b, a = butter(4, [0.5, 3.0], btype='band', fs=fs) az_f = filtfilt(b, a, imu['az_g'].values) peaks, _ = find_peaks(az_f, distance=int(0.3 * fs), prominence=0.1) dur = imu['time_s'].iloc[-1] - imu['time_s'].iloc[0] cadence = len(peaks) / dur * 60 print(f'歩数: {len(peaks)} 歩 / {dur:.1f} 秒') print(f'ケーデンス: {cadence:.1f} spm') # 1 日換算(覚醒 16 時間のうち 20 % をこの強度で歩くと仮定) daily = cadence * 60 * 16 * 0.20 print(f'推定 1 日歩数: {daily:,.0f} 歩(健康日本 21 の目標 8,000 歩の {daily / 8000:.0%})') |
📤 実行例:
💬 読み方: 132.4 秒で 248 歩を数え、 ケーデンスは 112.4 spm と健常成人の典型範囲(110-120 spm)に入る。 合成信号の真の歩行周波数は 1.87 Hz(= 112.2 spm)なので、 バンドパスと prominence=0.1・最小間隔 0.3 秒の設定で取りこぼしも二重計数もほぼ起きていない。 1 日換算の 21,580 歩(目標 8,000 歩の 270%)は「覚醒 16 時間の 20% をこのテンポで歩く」という仮定を掛けただけの値で、 実測の 1 日歩数ではない。
📊 IMU データ品質チェックリスト
| 項目 | 確認内容 | 異常時の対処 |
|---|---|---|
| サンプリング周波数 | 歩行解析は 50 Hz 以上、 跳躍・走行は 200 Hz 以上推奨 | 低周波だとピーク取りこぼし → 機材変更 |
| 重力校正 | 静止時 $\|\mathbf{a}\| = 1.000 \pm 0.005$ g | ずれが大きい場合は装着直し / キャリブレーション |
| 軸定義 | 装着方向と座標系(右手系 / 左手系)の一致 | 軸ラベル付け間違いは符号反転で致命的誤り |
| 欠損 | BLE 通信切れによる NaN / 連続欠損 | 5 サンプル以下は線形補間、 それ以上は当該区間除外 |
| 時刻同期 | 複数センサー使用時のタイムスタンプ整合 | NTP 同期 or 撮影と同期するための「手叩き」キャリブレーション |
| ドリフト | ジャイロの DC オフセット(静止時にゼロでない) | 計測開始時に 5 秒静止 → 平均値を引く |
🧮 数値例・実値計算
シンプルな例:振り子立て課題(CartPole)。
| 要素 | 内容 |
|---|---|
| 状態 $s$ | (位置, 速度, 角度, 角速度) の 4 次元 |
| 行動 $a$ | 左に押す / 右に押す の 2 択 |
| 報酬 $r$ | 1 ステップ立っていれば +1 |
| 最大長 | 500 ステップ |
- 学習前(ランダム方策):平均 20 ステップで転倒(=20 点)
- 学習 50,000 ステップ後(PPO):平均 480 ステップ維持(=480 点)
- このように 報酬の累積を最大化することで、 明示的に「立て」と教えなくても直立を学習
同じ枠組みで、 二足歩行なら状態 100 次元・行動 20 次元、 自動運転ならカメラ画像(数百万次元)まで扱えます。
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
身体・運動 AI は SSDSE-B-2026 に直接対応する変数はないが、 「介護・看護人材の需要予測」という応用文脈を想定し、 高齢者人口(A1303)と一般病院数(I510120)の比から運動支援ロボット需要の地域差を試算する。 なお H1800 は「病院数」ではなく 着工新設住宅戸数であり、 病院数の正しい列は I510120(一般病院数)である点に注意。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 564 行 = 47 都道府県 × 12 年分、 112 列の社会経済指標)。 年次列で 2023 年を抽出して用いる。 出典
🎯 このコードでやること: SSDSE-B-2026 を 2023 年・47 都道府県に絞り、 65 歳以上人口 1 万人あたりの一般病院数(I510120 / A1303 × 10,000)を計算して上位 5 県を並べる。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].rename(columns={df.columns[2]: 'pref'}) # 65 歳以上人口 1 万人あたりの一般病院数 → 介護ロボ需要の代理指標 df['hospitals_per_10k_elderly'] = df['I510120'] / df['A1303'] * 10000 df_sorted = df[['pref', 'A1303', 'I510120', 'hospitals_per_10k_elderly']]\ .sort_values('hospitals_per_10k_elderly', ascending=False) print('▼ 介護運動ロボ需要が高い地域 Top 5') print(df_sorted.head(5).to_string(index=False)) |
💬 読み方: 高齢者 1 万人あたりの一般病院数は高知県が 4.42 で最も多く、 徳島県 3.66・鹿児島県 3.65 と続く。 上位は四国・九州の県で、 病院が多いのは高齢者の数に比べて医療資源が厚いということでもあり、 この比を「ロボ需要」と読むのは仮定を置いた代理指標にすぎない。 読み込みの skiprows=[1] は 2 行目の日本語見出しを飛ばして英語コード(A1303 など)を列名に残す指定。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語見出し行をスキップ)・年次抽出・列名の英数字コード(A1101 = 総人口、 I510120 = 一般病院数 など)に注意。
🧮 実値で計算:SSDSE-B-2026 から「県別運動活発度」を推定
身体動作センサーログそのものは SSDSE には含まれませんが、 SSDSE-B-2026 には以下のような 運動量プロキシ指標があります:
L322106(保健医療費・二人以上の世帯):運動不足によって医療費が増える地域差L322109(教養娯楽費):スポーツ・行楽支出の代理A1303(65 歳以上人口):高齢化率 → 動作活動の低下リスクB4101(年平均気温):寒冷地ほど屋外活動が減る傾向I510120(一般病院数):医療アクセスの代理
これらを組合せて「動作活発度指標」を都道府県ごとに計算し、 上位 5・下位 5 を見比べます。 また、 ウェアラブルセンサーの 100Hz 加速度ログを模擬した合成解析(実データ部分は SSDSE で完結)として、 FFT・DTW のコードも実行します。
| 指標 | 運動量への影響 | 符号 |
|---|---|---|
| 教養娯楽費 (L322109) | 高いほどスポーツ・行楽参加が多い | + |
| 保健医療費 (L322106) | 高いほど運動不足の兆候(負の相関) | − |
| 高齢化率 (A1303/A1101) | 高いほど運動量が低下 | − |
| 年平均気温 (B4101) | 温暖なほど屋外活動可能性が増える | + |
🧮 数式に値を入れて手で計算する: 加速度センサーから歩数推定
合成 5 秒データで加速度ノルムのピークから歩数を推定する。
Step 1: 加速度ノルム (5 サンプル)
| t [s] | ax | ay | az | |a| |
|---|---|---|---|---|
| 0.0 | 0.5 | 0.0 | 9.8 | 9.813 |
| 1.0 | 1.2 | 0.5 | 10.5 | 10.580 |
| 2.0 | 0.0 | 0.0 | 9.5 | 9.500 |
| 3.0 | 1.5 | 0.3 | 10.8 | 10.908 |
| 4.0 | 0.2 | 0.0 | 9.6 | 9.602 |
Step 2: 閾値 10.0 超ピーク数 = 歩数推定
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np acc = np.array([ [0.5, 0.0, 9.8], [1.2, 0.5, 10.5], [0.0, 0.0, 9.5], [1.5, 0.3, 10.8], [0.2, 0.0, 9.6], ]) norm = np.linalg.norm(acc, axis=1) steps = (norm > 10.0).sum() print(f"|a| = {norm.round(3)}") print(f"歩数 = {steps}") |
📤 実行結果
💬 手計算 (Step 2) 2 歩と Python 出力が完全一致。
🐍 Python 実装例
最小コードで動かしてみる例:
🎯 このコードでやること: gymnasium の CartPole-v1 を stable-baselines3 の PPO で 50,000 ステップ学習し、 初期状態に対する行動を 1 つ予測する。
1 2 3 4 5 6 7 8 9 10 11 | # 振り子立てを強化学習で解く(4-8行) from stable_baselines3 import PPO import gymnasium as gym env = gym.make('CartPole-v1') model = PPO('MlpPolicy', env, verbose=0) model.learn(total_timesteps=50000) # 学習済み方策で動作を出力 obs, _ = env.reset() action, _ = model.predict(obs) |
💬 読み方: print が無いので何も表示されず、 action には 0(左へ押す)か 1(右へ押す)が入る。 学習の成否を見るには、 1 エピソードを最後まで回して立っていられたステップ数(最大 500)を数える。 stable-baselines3 はブラウザ実行環境には無いので手元の Python で動かす。
🐍 Python 実装バリエーション
「身体・運動 AI」を扱う代表的なライブラリ別実装。 同じ目的でも書き方が違うため、 自分のプロジェクトの依存関係に合わせて選択する:
① pandas + numpy(最小依存)
🎯 このコードでやること: SSDSE-B-2026 を読み込み。
1 2 3 4 5 6 7 8 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].rename(columns={df.columns[2]: 'pref'}) print('行数:', len(df), '列数:', df.shape[1]) print(df[['pref', 'A1101', 'A4101', 'A5101', 'F3101']].head()) |
💬 読み方: skiprows=[1] で日本語見出し行を飛ばし(英語コード行を残す)、 encoding='cp932' で文字化けを回避。 年次列で 2023 を抽出して 47 行に絞る。
② scikit-learn(学習・評価)
🎯 このコードでやること: 学習用と評価用にデータを分割、回帰モデルを学習、予測を取得、精度を評価。
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score, mean_squared_error from sklearn.model_selection import train_test_split import numpy as np X = df[['A1101', 'A1303']].fillna(0).values y = df['A4101'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) m = LinearRegression().fit(X_tr, y_tr) pred = m.predict(X_te) print(f'R² = {r2_score(y_te, pred):.3f}') print(f'RMSE = {np.sqrt(mean_squared_error(y_te, pred)):.2f}') |
💬 読み方: 47 県の 2 割にあたる 10 県(東京都・大阪府・福岡県などを含む)で評価して R² = 0.982、 RMSE は約 3,439 人。 出生数は総人口にほぼ比例するので当てはまりが良いのは当然で、 R² の高さは「人口の多い県は出生数も多い」という規模効果を見ているだけ。 県平均の出生数約 15,474 人に対して誤差 3,400 人は小さくなく、 テスト 10 県の顔ぶれで値が大きく動く。
③ scipy.stats(統計検定・分布)
🎯 このコードでやること: 総人口と出生数のピアソン相関を求め、 47 県の出生率(人口千対)の平均が全国の出生率と異なるかを 1 標本 t 検定で確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy import stats # 例: 2 変数の Pearson 相関 + p 値(総人口と出生数) r, p = stats.pearsonr(df['A1101'], df['A4101']) print(f'相関係数 r = {r:.3f}, p 値 = {p:.2e}') # 例: 1 標本 t 検定 — 47 県の出生率(人口千対)の平均は全国の出生率と異なるか birth_rate = df['A4101'] / df['A1101'] * 1000 national = df['A4101'].sum() / df['A1101'].sum() * 1000 t, p = stats.ttest_1samp(birth_rate, popmean=national) print(f'県平均 = {birth_rate.mean():.3f}, 全国 = {national:.3f}') print(f't = {t:.3f}, p = {p:.3f}') |
💬 読み方: r = 0.995 は人口規模どうしの相関なので、 身体活動や出生のしやすさについては何も言っていない。 県の出生率の単純平均 5.726 は全国値 5.848 より低いが、 t = −1.19・p = 0.24 で差は偶然の範囲。 全国値は人口の多い県ほど重く効く加重平均で、 県の単純平均とはそもそも別物である点に注意。
④ 可視化(matplotlib + seaborn)
🎯 このコードでやること: 総人口(横軸)と出生数(縦軸)の散布図を 47 都道府県で描き、 out.png に保存する。
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt import seaborn as sns fig, ax = plt.subplots(figsize=(8,5)) sns.scatterplot(data=df, x='A1101', y='A4101', ax=ax) ax.set_xlabel('総人口') ax.set_ylabel('出生数') ax.set_title(f'{len(df)} 都道府県の関係') plt.tight_layout() plt.savefig('out.png', dpi=120) plt.close() |
💬 読み方: 点はほぼ一直線に並び(③ の r = 0.995)、 右上に東京都が 1 点だけ離れる。 人口の小さい県が左下に固まるので、 県ごとの差を見たいなら出生率(出生数 ÷ 人口)に直すか両軸を対数にする。
🐍 Python:SSDSE から動作活発度、 加速度 FFT、 DTW を実装
① SSDSE 都道府県別の運動活発度ランキング
🎯 このコードでやること: SSDSE-B-2026 から「教養娯楽費 / 保健医療費 / 高齢化率 / 平均気温」を取得し、 標準化したうえで合算した 運動活発度スコアを都道府県ごとに計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 高齢化率 = 65 歳以上人口 / 総人口 df['aging_rate'] = df['A1303'] / df['A1101'] # 標準化(z-score)して合算 def z(s): return (s - s.mean()) / s.std() df['activity_score'] = ( + z(df['L322109']) # 教養娯楽費(+) - z(df['L322106']) # 保健医療費(−) - z(df['aging_rate']) # 高齢化率(−) + z(df['B4101']) # 平均気温(+) ) ranked = df[['Prefecture', 'activity_score']].sort_values('activity_score', ascending=False) print('=== Top 5(運動活発度・高) ===') print(ranked.head(5).to_string(index=False)) print('=== Bottom 5(運動活発度・低) ===') print(ranked.tail(5).to_string(index=False)) |
💬 読み方: 1 位は沖縄県(5.03)で、 教養娯楽費は 18,482 円と低いのに、 年平均気温 23.8℃ の高さと保健医療費の低さ・高齢化率の低さで上がっている。 2〜4 位の東京・神奈川・大阪は教養娯楽費の高さが効き、 最下位 5 県は北海道(−4.15)と北東北 4 県で、 寒さと高齢化が重なる。 4 指標を同じ重みで足しただけのスコアなので、 どの指標が順位を決めたかを分解して確かめ、 運動量そのものとは読まないこと。
② 都道府県別「気温変動」の FFT で年周期成分を抽出
🎯 このコードでやること: 身体動作の周期性解析と同じ FFT 手法を、 SSDSE-B-2026 の都道府県別年平均気温時系列(2012-2023 の 12 年分)に適用し、 トレンド成分の強さを評価する。 これは「歩行周波数抽出」と同じ信号処理パイプラインで、 実データ(公的統計)で挙動を確認できる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 東京都の B4101(年平均気温)時系列 12 年分 tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') signal = tokyo['B4101'].values years = tokyo['SSDSE-B-2026'].values print('東京都 年平均気温:', signal) # 平均除去(DC 成分を抜く) sig = signal - signal.mean() # FFT(年単位サンプリング = 1Hz) X = np.fft.rfft(sig) freqs = np.fft.rfftfreq(len(sig), d=1.0) psd = (np.abs(X) ** 2) / len(sig) print('\n周波数(周期/年) と PSD:') for f, p in zip(freqs, psd): period = (1/f) if f > 0 else float('inf') print(f' freq={f:.3f}/yr period={period:5.1f} 年 PSD={p:7.4f}') |
💬 読み方: PSD が最大なのは周期 2.4 年(0.598)で、 周期 12 年の成分(0.263)はその半分以下。 2013 年の 17.1℃ と 2023 年の 17.6℃ が突出し、 間の年が上下に揺れるため短い周期に力が集まった。 12 点しかない系列では周波数は 6 本しか取れず、 周期 12 年の成分は「上昇トレンド」と「12 年周期」を区別できない。 ウェアラブルの加速度ログ(100 Hz)なら同じコードで 2 Hz 付近に歩行周期のピークが立つ。
③ DTW で 3 都道府県の人口推移を類似度評価
🎯 このコードでやること: 身体動作の波形類似度比較と同じ DTW を、 SSDSE-B-2026 の都道府県別人口推移時系列に適用。 「形は似てるがスケール / 速度が違う」県を見つける。 同じアルゴリズムが「歩行リズム」「経済時系列」のどちらでも機能することを示す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import numpy as np import pandas as pd def dtw(a, b): n, m = len(a), len(b) D = np.full((n+1, m+1), np.inf) D[0, 0] = 0 for i in range(1, n+1): for j in range(1, m+1): cost = abs(a[i-1] - b[j-1]) D[i, j] = cost + min(D[i-1, j], D[i, j-1], D[i-1, j-1]) return D[n, m] df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) def series(pref): s = df[df['Prefecture'] == pref].sort_values('SSDSE-B-2026')['A1101'].values return (s - s.mean()) / s.std() # z-score 正規化 A_tokyo = series('東京都') B_kanagawa = series('神奈川県') C_hokkaido = series('北海道') print(f'DTW(東京, 神奈川) = {dtw(A_tokyo, B_kanagawa):.3f} (両方とも増加トレンド)') print(f'DTW(東京, 北海道) = {dtw(A_tokyo, C_hokkaido):.3f} (片方増加、 片方減少)') print(f'DTW(東京, 東京) = {dtw(A_tokyo, A_tokyo):.3f} (完全一致)') # ユークリッド距離との比較 print() print(f'Euclid(東京, 神奈川) = {np.linalg.norm(A_tokyo - B_kanagawa):.3f}') print(f'Euclid(東京, 北海道) = {np.linalg.norm(A_tokyo - C_hokkaido):.3f}') |
💬 読み方: 東京と神奈川(どちらも増加)の DTW 距離が小さく、 東京と北海道(増加 vs 減少)が大きい。 動作データでも全く同じ原理:同じ歩行パターンを速く / 遅くやっても DTW は小さく、 走行と歩行は大きく出る。 身体動作と人口統計でアルゴリズムは共通。
④ pandas resample で時系列の集約特徴量
🎯 このコードでやること: SSDSE-B-2026 の北海道 12 年分の人口・出生数・気温を時系列 DataFrame に整形し、 ウェアラブルセンサー解析でも頻出する 3 年窓ローリング統計(平均・標準偏差・最大)に集約する。 これは加速度ログ 100Hz → 1 秒窓特徴量と同じ操作。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) hk = df[df['Prefecture'] == '北海道'].sort_values('SSDSE-B-2026').copy() # タイムスタンプ化 hk['ts'] = pd.to_datetime(hk['SSDSE-B-2026'].astype(str) + '-01-01') hk = hk.set_index('ts')[['A1101', 'A4101', 'B4101']] # 3 年窓のローリング統計(mean / std / max) features = hk.rolling('1095D', min_periods=2).agg(['mean', 'std', 'max']) print(features.tail(5)) print(f'shape: {features.shape}') |
💬 読み方: 北海道の 3 年移動平均人口は 2019 年の 529 万人から 2023 年の 514 万人へ毎年 3〜4 万人ずつ下がり、 3 年窓の標準偏差も 3.3 万から 4.6 万人へ広がって減少が速まっていることが読める。 気温の 3 年平均は 9.5℃ から 10.5℃ に上がった。 表示幅が足りないと pandas は中央の列を ... で省略するので、 全列を見るには to_string() を使う。 出力は 12 行 × 9 列(3 指標 × mean/std/max)。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「身体・運動 AI」を実務・試験で扱うときに頻発する典型的なミスです。 各項目を 1 度読んでおけば 9 割の事故が防げます:
⚠️ 身体動作データの落とし穴
- センサー誤差・ドリフト:加速度計には常時 ±0.05G 程度のオフセットがあり、 積分すると速度や位置に発散する。 短時間(数秒)の特徴量抽出には影響少だが、 軌跡復元には必ずカルマンフィルタや Zero Velocity Update が必要。
- 個人差(被験者間ばらつき):身長・体重・歩幅が違うと加速度の絶対値も大きく変わる。 z-score 正規化や被験者別キャリブレーションを行わないと、 「異なる人物 = 異なる動作クラス」と誤判定される。
- サンプリング周波数の選択:低すぎる(<25Hz)と高速動作が aliasing で潰れ、 高すぎる(>200Hz)と電池とストレージを浪費。 Nyquist の定理に従い「測りたい動作の最大周波数の 2 倍以上」を最低条件に。
- マルチセンサー同期:複数のウェアラブル機器を組み合わせると、 端末ごとの時計が数十 ms ずれることがあり、 後で同期し直さないと相関解析が破綻する。 NTP 同期、 イベントマーカー(手拍子)、 GPS PPS を使う。
- プライバシーと倫理:歩容(gait)には個人識別性があり、 加速度ログから個人が再特定できる研究報告がある。 匿名化・差分プライバシー・取得目的のインフォームドコンセントが必須。
⚠️ 身体・運動データ解析の致命的落とし穴 7 選
- サンプリング周波数の不足: ナイキスト定理により観測可能な最高周波数はサンプリング周波数の半分。 歩行は 1 - 3 Hz 帯だが、 跳躍着地のピーク加速度は 10 - 30 Hz 成分を含み、 50 Hz サンプリングでは過小推定される。 計測前に「対象動作のスペクトル」を確認しておくこと。
- センサー装着位置のずれ: 同じ「腰」でも仙骨上 / 第 5 腰椎レベル / ベルトに引っ掛けただけで信号特性が大きく変わる。 IMU のメタデータには装着位置の写真と座標系を必ず添付し、 装着間バリアンスを階層モデルで吸収する。
- 歩幅推定の積分ドリフト: 加速度 → 速度 → 変位の二重積分は 1 秒で ± 10 cm のドリフトが出る。 ZUPT(Zero-velocity Update:足が地面に着く瞬間に速度=0 と仮定して初期化)または専用 GNSS / 動画基準でリセットしないと、 数歩で意味不明な値になる。
- 左右差の片側だけ計測: パーキンソン病・脳卒中後遺症などは非対称性がバイオマーカー。 利き脚側だけ計測すると重要情報を取り逃す。 必ず両側センサー or 体幹センサーで対称性指数(SI)を計算する。
- 個人差を無視した閾値設定: 「踵接地は加速度 1.5 g 以上」のような絶対閾値は身長 / 体重 / 歩容により大きく異なる。 個人ごとの 5 秒静止区間の標準偏差で正規化した z スコア閾値に置き換えるのが基本。
- マクロ統計との直接結合エラー: 自己申告ベースのスポーツ実施率(SSDSE-B には収録が無く外部調査由来)は自己申告ゆえ、 IMU で実測した「中強度活動時間」とは一致しないことが多い(両者の相関は中程度以下にとどまるという報告が多い)。 政策評価では自己申告と実測の系統的乖離(特に高齢者で過大申告傾向)を必ず補正する。
- プライバシー軽視: IMU 6 軸ストリームから個人識別が可能(歩容 ID)。 公開データセットの作成時は個人識別子のハッシュ化 + 連続区間のセグメント化(10 秒以下)等の de-identification 処理を必ず実施。 個人情報保護法・GDPR の「特殊カテゴリ個人データ」扱いに該当する場合がある。
📊 関連プロトコル / 標準規格
| 規格 / プロトコル | 策定機関 | 対象 | 主な内容 |
|---|---|---|---|
| ISO 13485 | ISO | 医療機器品質マネジメント | リハビリ用ウェアラブル等の医療機器化に必須 |
| IEC 62366 | IEC | ユーザビリティエンジニアリング | 高齢者装着のしやすさ・誤操作防止 |
| HL7 FHIR Observation | HL7 International | 医療データ交換 | 歩数・心拍数等を電子カルテに統合する標準形式 |
| JIS T 2304 | JIS | 医療機器ソフトウェア | 医療機器ソフトウェアのライフサイクルプロセス(IEC 62304 対応)。 歩行解析ソフトを医療機器として出す場合に関係する |
| WHO GPAQ | WHO | 身体活動質問票 | 質問紙で 1 週間の身体活動を尋ねる国際標準。 自己申告の活動量を国際比較するときの共通尺度 |
🔬 補足: 推奨されるパイプライン構成
- raw 層: 生 IMU CSV を Parquet 化、 サンプリング周波数 / 装着位置 / 校正情報をメタデータカラムに同梱(HL7 FHIR Observation 形式)
- feature 層: 10 秒窓のスライディング統計量(平均・分散・SMA・周波数主成分)を 30 - 60 次元のベクトル化
- activity 層: 5 クラス(静止 / 歩行 / 階段昇降 / 自転車 / 走行)への XGBoost 分類。 公開ベンチマーク UCI HAR / WISDM の事前学習モデルを fine-tune
- aggregate 層: 1 日単位の活動時間・METs・歩数を SSDSE-B-2026 都道府県基準と Z スコアで比較
- report 層: 個人ダッシュボード + 集団分析レポート(差分プライバシー処理済み)を医療従事者 / 政策担当者へ提供
💡 補足: 身体・運動データは「個人の動作」「集団の健康」「政策の効果」という 3 つのスケールが連結している希少な領域である。 解析者は単一スケールで完結させず、 必ず SSDSE 等のマクロ統計と接続して「自分の解析が政策意思決定にどう寄与するか」を意識する。 この接続なしの「歩数アプリのログ解析」は単なるエンタメに留まり、 教育・研究・政策への波及効果が極端に小さくなる。
🧠 動作分類モデルの構築:HAR ベンチマークから SSDSE 接続まで
身体・運動データ解析の標準タスクの一つが HAR(Human Activity Recognition)である。 6 軸 IMU から「静止 / 歩行 / 走行 / 階段昇降 / 自転車」等を分類する問題で、 公開ベンチマーク(UCI HAR、 WISDM、 PAMAP2、 mHealth)が整備されている。 ここでは特徴量エンジニアリングと、 都道府県別「活動的成人割合」推定パイプラインへの接続を示す。
📊 主要 HAR ベンチマークデータセットの比較
| データセット | 被験者数 | センサー | サンプリング | クラス数 | サンプル数 | 主用途 |
|---|---|---|---|---|---|---|
| UCI HAR (2012) | 30 名(19-48 歳) | スマホ腰部 IMU | 50 Hz | 6(歩行・階段上下・座位・立位・横臥) | 10,299 (window=2.56s) | 教育・基礎研究 |
| WISDM v2.0 | 51 名 | スマホ + スマートウォッチ | 20 Hz | 18 | 15,630,426 | 多クラス・複数装着位置 |
| PAMAP2 | 9 名 | IMU 3 台 + 心拍計 | 100 Hz | 18 | 3,850,505 | METs 推定・スポーツ動作 |
| mHealth (UCI) | 10 名 | IMU 3 台 + ECG | 50 Hz | 12 | 1,215,745 | 医療応用 |
| Daphnet FoG | 10 名(PD 患者) | 足首・大腿・腰 IMU | 64 Hz | 2(FoG / 非 FoG) | 237,107 | パーキンソン病すくみ足検出 |
| OPPORTUNITY | 4 名 | 72 軸センサー | 30 Hz | 17(複合動作) | 2,551,420 | 家事 ADL 推定 |
🐍 ステップ 3: 窓ベース特徴量で多クラス分類
このコードでやること: UCI HAR の学習用 7,352 窓(561 次元の事前算出特徴量)を読み込み、 sklearn.ensemble.HistGradientBoostingClassifier で 6 クラス分類する。 同じ被験者が学習と評価にまたがらないよう被験者単位の 5 分割(GroupKFold)で交差検証し、 正解率とクラス別の分類レポートを出す。
📥 入力データ(UCI HAR X_train.txt の先頭、 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd from sklearn.ensemble import HistGradientBoostingClassifier from sklearn.model_selection import GroupKFold, cross_val_predict from sklearn.metrics import accuracy_score, classification_report base = 'UCI HAR Dataset/train/' # UCI HAR を展開したフォルダ X = np.loadtxt(base + 'X_train.txt') # 7352 窓 × 561 特徴量 y = np.loadtxt(base + 'y_train.txt', dtype=int) # 1-6 の行動ラベル subj = np.loadtxt(base + 'subject_train.txt', dtype=int) names = ['WALK', 'UP', 'DOWN', 'SIT', 'STAND', 'LAY'] # 同じ人の窓が学習と評価に分かれないよう、被験者単位で 5 分割する cv = GroupKFold(n_splits=5) clf = HistGradientBoostingClassifier(max_iter=200, random_state=0) pred = cross_val_predict(clf, X, y, cv=cv, groups=subj) fold_acc = [accuracy_score(y[te], pred[te]) for _, te in cv.split(X, y, subj)] print(f'CV accuracy: {np.mean(fold_acc):.3f} ± {np.std(fold_acc):.3f}') print(classification_report(y, pred, target_names=names, digits=3)) |
📤 実行例(イメージ・未実測。UCI HAR Dataset はこの教材に同梱していないので、手元で実行したときの cross-validation 結果と分類レポートの形を示す):
💬 読み方: 上のイメージの値で読むと、被験者単位の 5 分割で正解率 93.4 %(分割ごとに ±3.6 pt 揺れる)。 横臥 (LAY) は f1 0.999 でほぼ完全に当たる一方、 座位 (SIT) と立位 (STAND) は f1 0.885・0.890 と低く、 誤りの大半がこの 2 クラスの取り違え。 どちらも静止して重力方向の加速度しか出ないため、 腰の IMU だけでは姿勢の差が出にくい。 窓をランダムに分割すると同じ人の窓が学習側にも入り、 正解率が数 pt 高めに出る。
📐 集団レベルへの展開:個人 HAR から都道府県別「活動的成人割合」へ
個人 HAR モデルの出力(5 秒窓ごとのクラス)を 1 日分集約すると、 1 日当たりの中強度活動時間(MVPA: Moderate-to-Vigorous Physical Activity)が得られる。 WHO 基準では成人 150 分/週以上、 これを満たす個人を「活動的成人」と定義する。 都道府県別の活動的成人割合 $P_i$ は次式で推定する。
$$ P_i = \frac{1}{N_i} \sum_{j \in \text{県 } i} \mathbb{1}\left[ \sum_{w \in \text{week}(j)} \mathbb{1}\left[ \widehat{a}_{j,w} \in \{\text{walk, run, cycle, up, down}\}\right] \cdot 5\text{s} \geq 150 \cdot 60\text{s}\right] $$
ここで $\widehat{a}_{j,w}$ は被験者 $j$ の 5 秒窓 $w$ における推定活動、 $N_i$ は県 $i$ の被験者数。 自己申告のスポーツ実施率(SSDSE-B-2026 には収録が無く、 国民健康・栄養調査など外部統計の自己申告値を想定)と上記実測 $P_i$ を比べるときは、 両者が別の量であることに注意する。 自己申告は「思い出して答えた活動」、 $P_i$ は「センサーが拾えた活動」で、 装着時間・分類モデルの誤り・窓の長さによって $P_i$ 自体も変わる。 差が出たとき、 どちらが真値に近いかは別の検証(直接観察や複数機器の比較)が無いと決められない。
🔬 補足: 深層学習による特徴量自動抽出
手作りの 561 次元特徴量に依存せず、 1D CNN + BiLSTM でラベルを直接予測するアーキテクチャ(DeepConvLSTM, 2016)は、 同じ UCI HAR で正解率 95 - 97 %、 OPPORTUNITY のような複雑なシナリオでは従来手法を 6 - 8 pt 上回る性能を示す。 ただし、 推論を時計内 CPU でリアルタイム実行するには量子化(INT8)・蒸留(DistilHAR 等)が必要で、 モデルサイズと精度のトレードオフを設計段階で評価する必要がある。 教育用途では「軽量モデルの構築 + プライバシー保護下での集約」を一気通貫で体験できることが望ましい。
🌐 さらに学ぶための文献マップ
| 分類 | 文献 / 教材 | 難易度 | 主題 |
|---|---|---|---|
| 教科書 | Winter, D. A. Biomechanics and Motor Control of Human Movement (4th ed., 2009) | ★★★ | 歩行・姿勢制御の生体力学全般 |
| 教科書 | Robertson, D. G. E. et al. Research Methods in Biomechanics (2nd ed., 2014) | ★★★ | 運動解析の研究方法論 |
| 論文 | Anguita et al. (2013) A Public Domain Dataset for Human Activity Recognition Using Smartphones, ESANN | ★★ | UCI HAR 元論文 |
| 論文 | Ordóñez & Roggen (2016) Deep Convolutional and LSTM Recurrent Neural Networks for Multimodal Wearable Activity Recognition, Sensors | ★★★ | DeepConvLSTM 元論文 |
| 標準 | WHO (2020) Guidelines on Physical Activity and Sedentary Behaviour | ★ | 運動の国際公衆衛生基準 |
| 標準 | 厚生労働省 (2024) 健康日本 21 (第三次) | ★ | 日本の身体活動目標値 |
| 公的統計 | SSDSE-B-2026 / 国民健康・栄養調査 | ★ | 都道府県別歩数・運動習慣 |
| 講義 | Stanford CS 224W Machine Learning with Graphs(骨格グラフ解析) | ★★★ | 姿勢推定後のグラフ解析 |
📘 学習の進め方: 初学者は「WHO ガイドライン → SSDSE-B 都道府県値 → UCI HAR 演習」の順で、 大まかな政策ゴール → 統計的現状把握 → 機械学習による予測の三段ロケットで体験するのが効率的。 中級者は DeepConvLSTM 論文と Daphnet FoG データセットを組み合わせ、 臨床応用(パーキンソン病のすくみ足検出)に挑戦すると、 単なる分類ではなく「介入トリガー設計」へと視野が広がる。 上級者は IMU + 動画 + 心拍 + 環境センサーのマルチモーダル統合と、 連合学習による分散プライバシー保護の研究最前線へ進むとよい。
🧭 SSDSE-B-2026 を起点とした分析ロードマップ(学習者向け)
- Step 1: 探索的分析: SSDSE-B の実在列(住宅着工 H1800・延べ宿泊 G7101・一般病院数 I510120・高齢化率 A1303/A1101・出生率 A4101/A1101 など)を派生計算し、 47 都道府県の散布図行列を描く。 地理的クラスタ(東日本 / 西日本 / 沖縄)が見えるかを観察し、 地方ブロック変数を追加すると説明力がどう変わるかを検証する。(スポーツ実施率・歩数・健康寿命は SSDSE-B に無いため、 外部統計または個人 IMU データで補う)
- Step 2: 仮説生成: 「運動が健康寿命を伸ばす」のような単純因果ではなく、 「高齢化率 → 自宅滞在時間 → 運動量低下 → 健康寿命短縮」のような媒介経路を DAG で描いてから偏相関を計算する。
- Step 3: マクロ → ミクロの接続: 個人 IMU データ(UCI HAR / WISDM)で活動分類モデルを訓練し、 出力統計量(MVPA 分・歩数)を県平均と比較。 自己申告との乖離を補正係数として定量化する。
- Step 4: 介入シミュレーション: 「スポーツ施設を 10 % 増やすと健康寿命は何年伸びるか」をベイズ階層回帰で推定し、 都道府県別の感度(弾力性)を表にする。 これが政策意思決定の最終アウトプットとなる。
- Step 5: 振り返り: 個人スケールの誤差(センサーノイズ)、 集団スケールの誤差(自己申告バイアス)、 政策スケールの誤差(モデル定式化)を 3 段階で整理し、 不確実性を伝達する報告書を作成する。 これにより「データから政策へ」の一気通貫プロセスが完成する。
🎯 最終メッセージ: 身体・運動データ解析は「センサー技術」「統計学」「機械学習」「公衆衛生政策」が交差する稀有な領域である。 単一分野の専門性だけでは閉じず、 必ずマクロ統計との接続と個人プライバシーの保護を同時に達成する設計が求められる。 SSDSE-B-2026 を出発点とし、 個人 IMU データを終着点とする「双方向のスケール接続」を体験することで、 学習者は単なるコード書きではない「定量的健康科学者」としての視座を獲得できる。
なお、 身体・運動データはセンサーの世代交代が速いため、 5 年に 1 度は装着位置 / サンプリング周波数 / 校正手順を見直す必要がある。 旧データセットで学習したモデルを新型センサーに適用するときは、 ドメイン適応(Domain Adaptation)や転移学習が必須となり、 単純な置き換えでは精度が落ちることが多いので、 新型センサーで小さな検証データを取り直して精度を測ってから使う。 教育用ノートブックでも、 同じデータで複数年の比較ができるよう「メタデータ駆動の前処理パイプライン」を意識して構築するとよい。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
中心の身体・運動データから、 (上) 加速度センサ・ジャイロ・GPS のセンサ層、 (右上) 1 秒/100Hz サンプリングと特徴量抽出 (歩数、 METs、 心拍変動)、 (右下) 行動認識 (歩行/走行/睡眠の HMM/LSTM 分類)、 (下) 健康アウトカム (BMI、 高血圧、 糖尿病) との関連分析、 (左) ウェアラブル端末 (Apple Watch、 Fitbit、 Garmin) の API 経由データ取得へ放射状に接続している。 SSDSE-B-2026 は都道府県集計レベルなので身体活動量(歩数・スポーツ実施率など)は含まれないが、 高齢化率・医療施設密度・延べ宿泊者数といった実在の地域特性指標が間接的に関連し、 個票レベルの身体・運動データと突き合わせることで「地域差を生む生活様式」を読み解ける。
🔗 隣接手法への橋渡し
身体・運動データはセンサ計測 → 特徴量抽出 → 行動分類 → 健康アウトカム分析 のパイプラインで動き、 ヘルスケアや高齢者見守りの中核データ源となる。
- 上流: 3 軸加速度・ジャイロ・GPS センサ、 ウェアラブル (Apple Watch, Fitbit, Garmin) からの 50-100Hz サンプリング、 SDK 経由のクラウド連携。
- 並列: 行動ログ (アプリ内操作)・時系列データ分析 (HMM, LSTM)・動画ポーズ推定 (OpenPose, MediaPipe) — 入力モーダルは異なるが「行動を時系列として記述」する点で並列。
- 下流: 行動認識 (歩行/走行/睡眠分類)・METs/消費カロリー推定・健康リスク予測 (転倒、 心房細動、 高血圧との関連)・運動指導フィードバック。
SSDSE-B-2026 の都道府県集計は身体・運動データ(スポーツ実施率・歩数)を含まないが、 高齢化率・医療施設密度など実在の地域特性指標と個票ウェアラブルデータを突き合わせて地域の健康格差を読み解く分析が可能。
🌳 手法選択フロー
身体・運動データ解析の選択は「センサ種類」「分析目的」「プライバシー要件」の 3 軸で判定する。
- センサ種類: 加速度・ジャイロ (歩行・走行・睡眠分類) → スマートウォッチ/フィットネスバンド。 GPS (移動経路) → スマホアプリ。 心拍 (循環器健康) → 光学式心拍計。 動画ポーズ (フォーム解析) → MediaPipe/OpenPose。
- 分析目的: 行動分類 (歩行/走行/階段) → HMM・LSTM・1D CNN。 運動量推定 (METs, カロリー) → 回帰モデル。 異常検知 (転倒、 心房細動) → IsolationForest や 変分 Autoencoder。 集団傾向 (地域別運動習慣) → 集計 + 可視化。
- プライバシー要件: 個人 ID 付き → デバイス内処理 (Edge AI) で生データを外に出さない。 集計のみで OK → SSDSE-B-2026 のような都道府県集計値を使う、 個別行動ログは保持しない。 医療研究 → IRB 承認 + 匿名化 + データアクセス制御。
「ウェアラブルで何でもわかる」は誇張で、 実際は (a) 装着率の低下 (3 ヶ月で半減)、 (b) センサバイアス (高齢者の歩行はゆっくりで誤分類)、 (c) プライバシー敏感性、 を考慮した運用設計が成否を分ける。
🧗 解説深化 ── 「その 99% 精度、誰で測った?」評価リークから見る身体動作 AI
本ページでは HAR(人間行動認識)のモデル構築を扱ったが、 論文・コンペで最も頻繁に起きる事故は、 モデルの中身ではなく 評価の切り方にある。 ここでは他ページで扱っていない 被験者リーク(subject leakage)と窓オーバーラップリークという HAR 固有の評価問題を深掘りし、 SSDSE-B-2026 の実データで「リークすると精度がどれだけ過大評価されるか」を数値で再現する。
💡 直感 ── 隣の窓は「ほぼ同じ波形」、同じ人は「ほぼ同じ癖」
HAR の前処理では 100Hz の加速度ストリームを「2 秒窓・50% オーバーラップ」のようにスライディング窓で切り出す。 このとき隣接する 2 つの窓は波形の半分を物理的に共有している。 さらに同一人物の窓同士は、 歩幅・腕の振り・端末の装着角度という「癖」を共有する。 つまり窓をシャッフルしてランダムに train/test に分割すると、 テストデータの「答えのほぼコピー」が訓練データに必ず混入する。 モデルは「歩行と走行を区別する規則」ではなく「A さんの波形の記憶」で正解できてしまい、 精度は本来の性能より大幅に高く出る。 これは過学習そのものではなく、 汎化性能の測定器(検証設計)が壊れている状態である点に注意 ── モデルを何に替えても数字は「良く」見える。
問うべきは常に「このモデルは訓練に 1 窓も登場しない新しい人に対して動くか」。 だから HAR の標準評価は被験者単位で分割する LOSO(Leave-One-Subject-Out)や GroupKFold であり、 「ランダム 5-fold で 99%」という報告はそれだけで疑ってよい。
⚠️ 落とし穴(重要) ── SSDSE-B 実データでリークを再現する
センサーデータが無くても、 リークの構造は SSDSE-B-2026 のパネルデータ(47 都道府県 × 2012–2023 年 = 564 行)で忠実に再現できる。 鍵は 「都道府県 = 被験者、 年次の行 = 同一人物の隣接窓」という対応である。 実際、 同じ県の行は年をまたいでほぼ同一で、 一般病院数 I510120 の 2012 年値と 2023 年値の県間相関は r = 0.998、 総人口 A1101 は r = 0.999(いずれも実測値)。 例えば東京都の一般病院数は 2012→2023 年で 590 → 588 とほぼ動かない(期間中の範囲は 581〜601)。 つまり 564 行は「独立な 564 サンプル」ではなく、 実質 47 被験者の反復測定である。
そこで「総人口 A1101・65 歳以上人口 A1303・年平均気温 B4101・教養娯楽費 L322109 から一般病院数 I510120 を予測する」タスクを、 ランダム 5-fold と GroupKFold(県単位で分割 = 未知の県でテスト)の 2 通りで評価する。 数値はすべて下記コードの実行による実測値:
| モデル(同一) | ランダム KFold 平均 R² | GroupKFold(県単位)平均 R² | 過大評価幅 |
|---|---|---|---|
| kNN 回帰(k=3, 標準化あり) | 0.956 | 0.520 | +0.436 |
| Ridge 回帰(α=1.0, 標準化あり) | 0.829 | 0.612 | +0.217 |
kNN のランダム分割 R² = 0.956 は「同じ県の別の年」が近傍に必ずいるための見せかけで、 未知の県に対する実力は R² = 0.520 しかない。 記憶に頼る度合いが強いモデル(kNN)ほど落差が大きい(+0.436)のも HAR で観察される典型パターンと一致する。 fold ごとの値も透明性のため記す:ランダム [0.927, 0.956, 0.968, 0.961, 0.968]、 県単位 [0.547, 0.769, 0.264, 0.494, 0.525]。 県単位ではばらつきも大きく、 「どの被験者が外れるか」で性能が揺れるという LOSO 特有の現象まで再現されている。
💬 教訓:反復測定・時系列・スライディング窓のデータでは、 行の独立性が壊れている単位(人・県・セッション)ごとにまとめて分割する。 sklearn なら GroupKFold / StratifiedGroupKFold、 引数は groups= に被験者 ID を渡すだけ ── コード 1 行の差が R² を 0.4 以上動かす。
🚀 発展 ── リークを「塞ぐ」から「利用する」へ
- 評価の階層を分ける:目的が「本人専用モデル」(例:個人のリハビリ経過追跡)なら被験者内分割が正当で、 「出荷時モデル」(初対面のユーザーで動くアプリ)なら LOSO が必須。 同じデータ・同じモデルでも、 運用シナリオによって正しい分割が変わる。 論文を読むときは精度の数字より先に分割方法を確認する習慣をつける。
- 被験者適応(subject adaptation):LOSO 精度が低い場合、 新規ユーザーの最初の数十秒だけラベル付きデータをもらい、 全体モデルを微調整(fine-tuning / 転移学習)する設計が実務の主流。 「リーク = 悪」ではなく、 個人の癖という情報を明示的な適応ステップとして取り込む発想の転換である。
- 時間方向の分割:同一被験者内でも「前半で訓練・後半でテスト」とすれば窓オーバーラップリークは防げる(時系列データの walk-forward 検証と同じ思想)。 パネルデータなら「2012–2021 年で訓練 → 2022–2023 年でテスト」が対応物になる。
- 正規化によるリーク:StandardScaler を全データで fit してから分割するのも立派なリークである(テスト集合の平均・分散が訓練に漏れる)。 上のコードのように
make_pipelineに入れて CV 内部で fit させるのが正しい。 - 歩容 ID との表裏:「個人の癖が窓に染み付く」性質は、 裏返せば加速度波形から個人を特定できる(歩容認証)ことを意味する。 リークの原因とプライバシーリスクは同じ物理現象の 2 つの顔である。