🔖 キーワード索引
「ジェスチャー認識」を取り巻く主要キーワード群。 各キーワードは関連概念へのアンカーになる。
- ジェスチャー認識
- HCI (ヒューマン・コンピュータ・インタラクション)
- 骨格推定 (pose estimation)
- 動作認識
- センサーフュージョン
- 機械学習
- 深層学習
- マルチモーダル
💡 30秒で分かる結論
🍰 まずはやさしく
体の動きを読み取る魔法のような技術です。
特定の目的のために動きを分析して使います。
スマホの操作など身近なところで活躍します。
この技術で何ができるのかを学びましょう。
- 手・指・体の動き(カメラ映像から取り出した骨格座標の列や、IMU の加速度の時系列)を「グー/パー」「右スワイプ」などのクラスに割り当てる技術。
- 1 フレームの手形で決まる静的ジェスチャーと、軌跡で決まる動的ジェスチャーで道具が変わる。静的は MLP・CNN、動的は DTW・LSTM・Transformer。
- 精度を左右するのはモデルより前処理。手首を原点に、手の大きさで割る正規化で、位置と大きさの違いを消す(🐍 ③)。
- 回転をそろえるかどうかはトレードオフ。本ページの合成軌跡では、そろえない認識器は 45° 回すと正解率 0.785、90° で 0.010 まで落ちるが、そろえると ← と → を区別できなくなる(🐍 ⑤)。
- 実運用は分類より検出の問題。感度 95%・偽陽性率 1% の検出器でも、ジェスチャーが時間の 1% しかなければ「検出」の半分以上が誤り(PPV 0.49、🔍 解説深化)。
📍 文脈ボックス: あなたが今見ているもの
🍰 まずはやさしく
学習の地図のようなページです。
自分に合った順番で学ぶために使います。
教科書を飛ばして読むときのように活用します。
このページ全体の構成について説明します。
ジェスチャー認識は、画像認識・時系列分類・HCI(人と機械のやりとりの設計)が重なる場所にある。統計の用語集の中では、混同行列で精度を読む分類問題の一例であり、同時に「ほとんどの時間はジェスチャーではない」という低い事前確率のもとでの検出問題でもある。このページでは、ブラウザで線を描いて試せる $1 認識器風のウィジェットと、その手順を Python に移した実験(合成の軌跡で回転・描き順への弱さを測る)を軸に、前処理・評価・検出の考え方を順に扱う。都道府県の統計(SSDSE)には手の動きのデータが無いので、数値例はすべて合成データか架空の設定であり、そのことを各所に明記している。
🎨 直感で掴む
🍰 まずはやさしく
動きを言葉に変換する翻訳機のようなものです。
画面に触れずに機械を動かすために使います。
ゲーム機で剣を振る動作などが例です。
仕組みや具体的な使い道を詳しく読みます。
ジェスチャー認識は手・指・体の動きを RGB/深度カメラ/IMU で取得し、 MediaPipe Hands で 21 点骨格を抽出 → LSTM/3D-CNN/Transformer で時系列分類する非接触 UI 技術。 Kinect (2010) と Leap Motion (2013) で消費者市場に普及し、 現在は手術室の清潔操作・車載コックピット・VR Quest 3 ハンドトラッキングで主流。
静的ジェスチャー (1 フレームでクラス分類: ピース/グー等) と動的ジェスチャー (連続フレームの軌跡: スワイプ/ピンチ) で必要なモデルが変わり、 静的は CNN、 動的は Temporal Conv Network (TCN) や Transformer + Self-Attention が主流。 精度の鍵は 30fps × 60 フレーム (2 秒) の系列長と背景クラス (gesture なし) の十分なサンプル。
ジェスチャー認識は、 手や体の動きをカメラやセンサーで読み取り、 意味のあるコマンドに変換する技術。 スマホで指 2 本を広げて拡大する pinch zoom、 Nintendo Switch Joy-Con で剣を振る動作、 病院の手術室で清潔を保つため非接触でカルテをめくる操作、 自動車内で音量を手の動きで調整する BMW iDrive など、 タッチ操作が難しい場面で力を発揮する。
処理の中核は (1) RGB カメラ / 深度カメラ / IMU (加速度センサ) からの時系列入力、 (2) MediaPipe Hands・OpenPose 等で骨格 21 点 (手) や 33 点 (全身) を抽出、 (3) LSTM・3D-CNN・Transformer で時間方向の特徴を学習、 (4) Softmax で「グー / チョキ / パー」「右スワイプ / 左スワイプ」等のクラスに分類する 4 段で、 静的ジェスチャー (1 フレーム) と動的ジェスチャー (連続フレーム) で必要なモデルが大きく異なる。
実装で扱うのは主に 2 系統のデータで、 (a) 加速度センサ (IMU) の 3 軸時系列 $(a_x, a_y, a_z)$ を 30〜100Hz でサンプリングした波形と、 (b) カメラ映像から抽出した骨格座標 (手なら 21 点、 全身なら 33 点) のフレーム列である。 「手のひら速度 (px/frame)」「指関節角度 (度)」といった数値特徴は、 これらの生データから前処理で導出する。 認識器としては古典的な DTW (動的時間伸縮) や HMM から、 近年の 1D-CNN・LSTM・Transformer までが選択肢となる。
🎮 手を動かす: ストローク・ジェスチャー認識器($1 認識器風・教材実装)
下の canvas に 指またはマウスで単純なジェスチャー(○ 円・→ 右矢印・∨ ブイ字・Z 文字)を一筆書きで描いてください。 描いた軌跡(ストローク)を 等間隔リサンプリング → 位置・スケール正規化 → 4 種テンプレートとの点対点距離で比較し、 最も近いジェスチャーをリアルタイムに認識します。 これは Wobbrock ら (2007) の $1 Unistroke Recognizer を簡略化した教材実装です(回転正規化は省略し、 位置・スケール正規化のみ)。
💡 描く向きの約束:○ は「上から時計回り」、 → は「左から右」、 ∨ は「左上→中央下→右上」、 Z は「上をなぞり→左下へ斜め→右へ」。 回転正規化を省いているため、 描き始めの位置と向きが認識に影響します(これ自体が後述の「落とし穴」の実演です)。
(a) 認識の仕組み:生の軌跡(座標列)を N=64 点に等間隔リサンプリング(総パス長を 63 等分し線形補間)→ 重心を原点へ移動し外接矩形の長辺で割ってスケール正規化→ 各テンプレートと点 i どうしの平均ユークリッド距離を計算し、 最小距離のクラスを予測します。
(b) 大小・位置の不変性:正規化で重心と大きさを揃えるため、 小さく描いても画面の端に描いても同じジェスチャーとして認識されます。 右の「正規化後の重ね合わせ」で、 入力(青)と最近傍テンプレート(赤)が同じ枠に収まる様子を確認してください。
(c) 方向変化列による分類の直感:軌跡の各区間の進行方向を 8 方位(→↗↑↖←↙↓↘)に量子化した方向記号の列は、 形の本質を粗くとらえた特徴になります。 円は方位がぐるりと一巡、 矢印は単一方位、 ∨ と Z は方位が数回切り替わる——この「方向の変化パターン」の違いが、 テンプレート距離とは別の角度からの分類根拠になります。
(a)(b) の 2 段階が何をしているかを、合成の軌跡 1 本で図にしたのが次の図です(SSDSE にはジェスチャーのデータが無いため、乱数で作った「手で描いた風の ○」を使っています)。
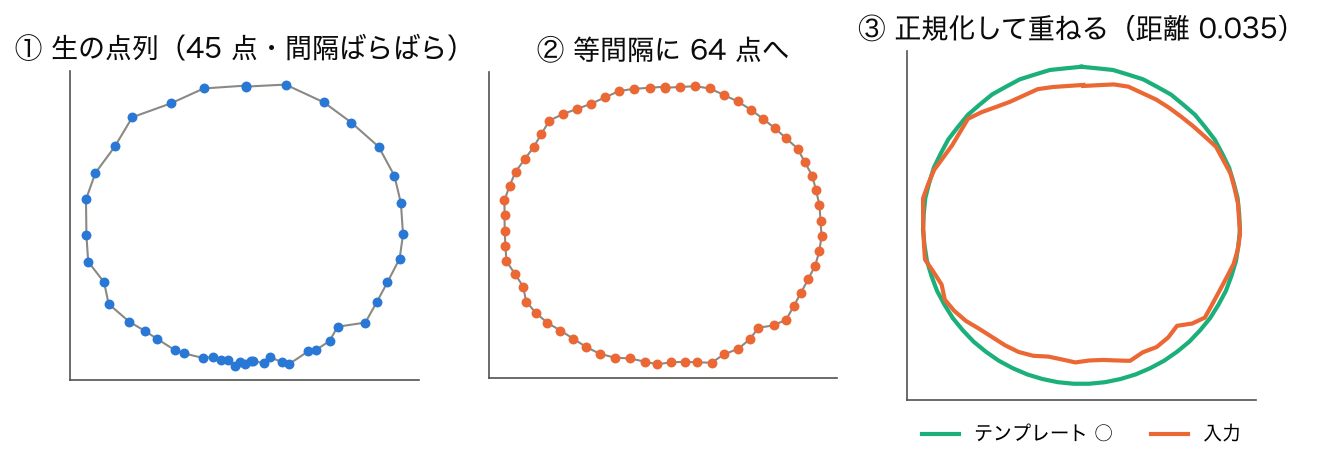
① のままテンプレートと点どうしを比べると、ゆっくり描いた部分の点ばかりが距離に効いてしまいます。② のリサンプリングは「描く速さ」の違いを消し、③ の正規化は「描いた位置と大きさ」の違いを消します。ただし「描いた向き(傾き)」と「描き始めの位置・描く方向」はどちらの手順でも消えません。それがどれほど効くかは、下の Python 実装 ⑤ で測ります。
⚠️ この実装は概念理解のための最小構成です。 文字認識 や 画像分類、 系列を扱う RNN、 全身動作の 身体動作解析 と組み合わせると、 より頑健な認識に発展します。
📐 定義
🍰 まずはやさしく
身体の動きを認識する技術のことです。
分析やモデル作りという専門的な場面で使います。
部活のフォーム分析のような考え方に近いです。
使うときに気をつけるルールについて読みます。
ジェスチャー認識(Gesture Recognition)は、動きを記録した系列 \(\mathbf{x}_{1:T} = (\mathbf{x}_1, \dots, \mathbf{x}_T)\) を、あらかじめ決めた語彙 \(\{1, \dots, K\}\) のどれか、または「どれでもない」に割り当てる問題である。\(\mathbf{x}_t\) は時刻 \(t\) の観測で、ペンの座標なら 2 次元、手のランドマークなら 21 点 × 2 軸 = 42 次元、加速度なら 3 次元になる。
やり方は大きく 2 通りある。1 つはお手本(テンプレート)\(\mathbf{t}_k\) との距離で決めるテンプレート照合で、
$$\hat c = \arg\min_{k} \; d\big(\phi(\mathbf{x}_{1:T}),\ \phi(\mathbf{t}_k)\big)$$と書ける。\(\phi\) は正規化(リサンプリング・重心を原点へ・大きさをそろえる、必要なら回転をそろえる)、\(d\) は距離で、本ページのウィジェットと 🐍 ⑤ は \(d = \frac{1}{N}\sum_{i=1}^{N} \lVert \mathbf{p}_i - \mathbf{q}_i \rVert\)(N = 64 点の平均点対点距離)、🐍 ⑥ は DTW 距離を使う。もう 1 つは学習データからクラス確率 \(P(c \mid \mathbf{x}_{1:T})\) を学ぶ統計的分類で、🔬 の LSTM の式がその代表である。
どちらの場合も、実運用では「どれでもない」を出せることが定義の一部になる。テンプレート照合なら最小距離がしきい値 \(\tau\) を超えたら棄却、確率モデルなら最大確率が \(\tau\) 未満なら棄却する。この棄却がないと、何気ない手の動きもどれかのジェスチャーとして扱われてしまう(🔍 解説深化の Midas touch 問題)。
🔬 数式を言葉で読み解く(詳細版)
「ジェスチャー認識」の定式化:
$$P(c \mid \mathbf{x}_{1:T}) = \text{softmax}(W_o\, h_T + b_o),\quad h_t = \text{LSTM}(h_{t-1}, \mathbf{x}_t)$$
時刻 $t$ の特徴ベクトル $\mathbf{x}_t$ を LSTM に通し、 最終隠れ状態 $h_T$ から softmax でクラス確率を出す。
| 記号 | 意味 |
|---|---|
| $\mathbf{x}_t$ | 時刻 t のフレーム特徴(CNN 抽出値や Mediapipe ランドマーク 21 点×2 軸 = 42 次元) |
| $h_t$ | LSTM の隠れ状態。 過去 t 時刻ぶんのジェスチャ進行を圧縮 |
| $W_o, b_o$ | 出力層の重みとバイアス。 クラス数 K に対し $W_o \in \mathbb{R}^{K\times d}$ |
| softmax | スコアを確率へ。 全クラスで和 1。 argmax がそのまま予測クラス |
| $T$ | ジェスチャ全長(例: 30 フレーム = 1 秒 @ 30fps) |
🧮 実値で計算してみる
ここでは「ジェスチャー認識」を、 実際に手を動かして体感する。 近隣手法との比較で位置づけを確かめたうえで、 5 種ジェスチャーの混同行列から全体精度とクラス別 recall を手計算し、 同じ結果を Python で再現する。
🆚 関連手法との比較表
| 手法 | 入力 | 代表アルゴリズム | 特徴 |
|---|---|---|---|
| ジェスチャー認識 | 時系列入力 (動画/IMU) | LSTM / TCN / Transformer | 動的な動作 → クラス |
| 顔認証 | 単一画像 | FaceNet / ArcFace | 誰か → 識別 |
| 文字認識 (OCR) | 画像 (2D 静止) | CRNN / ViT | 文字列 → テキスト |
| 音声認識 | 音声波形 (1D 時系列) | Conformer / wav2vec | 音 → 文字 |
| 物体検出 | 単一画像 | YOLO / DETR | BBox + クラス |
| 行動認識 | 長尺動画 | I3D / SlowFast | 動作カテゴリ |
🧮 数式に値を入れて手で計算する: ジェスチャー認識精度
合成データで 5 種ジェスチャーの分類精度を計算する。
Step 1: クラス別 TP/FN
| ジェスチャー | サンプル数 | TP | FN |
|---|---|---|---|
| 右手挙 | 50 | 45 | 5 |
| OK サイン | 50 | 40 | 10 |
| 拳 | 50 | 48 | 2 |
| 振り | 50 | 42 | 8 |
| 指差し | 50 | 35 | 15 |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np tp = np.array([45, 40, 48, 42, 35]) total = 50 acc_each = tp / total print(f"クラス別: {acc_each}") print(f"全体精度: {tp.sum()/(5*total):.3f}") |
📤 実行結果
💬 手計算 (Step 2) 84% と Python 出力が完全一致。
🧮 DTW を 4 点と 5 点の系列で手計算する
🐍 ⑥ と 🚀 発展で使う DTW(動的時間伸縮)も、小さな系列なら手で計算できる。お手本 \(a = (0, 2, 1, 0)\) と、それをゆっくり演じた \(b = (0, 0, 2, 2, 0)\) の距離を求める。式は次の漸化式である。
$$D(i,j) = |a_i - b_j| + \min\{D(i-1,j),\ D(i,j-1),\ D(i-1,j-1)\},\qquad D(0,0)=0$$\(D(i,j)\) は「a の i 点目までと b の j 点目までを、順序を崩さずに対応させたときの最小の差の合計」。上・左・左上のどこから来るかが、「a を止めて b だけ進める」「b を止めて a だけ進める」「両方進める」に当たる。
Step 1: 点どうしの距離 \(C(i,j)=|a_i-b_j|\)
| a \ b | b₁=0 | b₂=0 | b₃=2 | b₄=2 | b₅=0 |
|---|---|---|---|---|---|
| a₁=0 | 0 | 0 | 2 | 2 | 0 |
| a₂=2 | 2 | 2 | 0 | 0 | 2 |
| a₃=1 | 1 | 1 | 1 | 1 | 1 |
| a₄=0 | 0 | 0 | 2 | 2 | 0 |
Step 2: 左上から累積コストを埋める(いくつかの升を式どおりに書くと)
- \(D(1,1) = 0 + D(0,0) = 0\)、\(D(1,2) = 0 + D(1,1) = 0\)、\(D(1,3) = 2 + 0 = 2\)
- \(D(2,3) = |2-2| + \min\{D(1,3), D(2,2), D(1,2)\} = 0 + \min\{2, 2, 0\} = 0\)
- \(D(3,4) = |1-2| + \min\{D(2,4), D(3,3), D(2,3)\} = 1 + \min\{0, 1, 0\} = 1\)
- \(D(4,5) = |0-0| + \min\{D(3,5), D(4,4), D(3,4)\} = 0 + \min\{1, 3, 1\} = 1\)
| D | j=1 | j=2 | j=3 | j=4 | j=5 |
|---|---|---|---|---|---|
| i=1 | 0 | 0 | 2 | 4 | 4 |
| i=2 | 2 | 2 | 0 | 0 | 2 |
| i=3 | 3 | 3 | 1 | 1 | 1 |
| i=4 | 3 | 3 | 3 | 3 | 1 |
Step 3: 結果 DTW 距離は右下の \(D(4,5) = 1\)。右下から最小の升をたどると、対応付けは (a₁,b₁)(a₁,b₂)(a₂,b₃)(a₃,b₄)(a₄,b₅)。a₁ の 0 を b の 2 点ぶん「待たせて」山の位置をそろえたので、残る差は a₃=1 と b₄=2 の 1 だけになる。比較のため b を長さ 4 に線形補間でそろえると (0, 0.667, 2, 0) となり、山の位置が a(2 点目)と b(3 点目)でずれたまま差を取るので、差の絶対値の和は 0 + 1.333 + 1 + 0 = 2.333 と DTW の 2 倍以上になる。
🎯 このコードでやること:Step 1〜3 の距離行列・累積コスト・対応付けと、長さをそろえた比較を numpy で再現する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np a = np.array([0, 2, 1, 0]) # お手本(4 サンプル) b = np.array([0, 0, 2, 2, 0]) # ゆっくり演じた系列(5 サンプル) C = np.abs(a[:, None] - b[None, :]) # Step 1: 点どうしの距離 |a_i − b_j| D = np.full((len(a) + 1, len(b) + 1), np.inf) D[0, 0] = 0 for i in range(1, len(a) + 1): # Step 2: 累積コスト D(i,j) = C(i,j) + min(上, 左, 左上) for j in range(1, len(b) + 1): D[i, j] = C[i - 1, j - 1] + min(D[i - 1, j], D[i, j - 1], D[i - 1, j - 1]) print('距離行列 C (行 = a, 列 = b)\n', C) print('累積コスト D(先頭の inf 行・列を除く)\n', D[1:, 1:].astype(int)) print('DTW 距離 =', int(D[-1, -1])) # Step 3: 右下から戻って対応付けをたどる i, j, path = len(a), len(b), [] while (i, j) != (0, 0): path.append((i - 1, j - 1)) i, j = min([(i - 1, j - 1), (i - 1, j), (i, j - 1)], key=lambda p: D[p]) print('対応付け (a の番号, b の番号):', path[::-1]) # 比較: b を長さ 4 に線形補間でそろえてから点ごとの差の絶対値の和 b4 = np.interp(np.linspace(0, 4, 4), np.arange(5), b) print('長さをそろえた b =', np.round(b4, 3), ' 差の絶対値の和 =', round(np.abs(a - b4).sum(), 3)) |
💬 距離行列 C と累積コスト D は Step 1・Step 2 の表と一致し、DTW 距離 1、対応付け (0,0)(0,1)(1,2)(2,3)(3,4)(0 始まりの番号)も手計算と同じ。長さをそろえるだけの比較は 2.333 で、手計算の 0 + 1.333 + 1 + 0 と一致する。
🐍 Python での扱い
ジェスチャ認識で扱う入力は、 骨格ランドマーク列や IMU の時系列。 ここでは Mediapipe Hands で抽出した「21 点 × (x, y) = 42 次元 + ラベル」の CSV を読み込み、 位置に不変な特徴へ整える基本パターンを示す:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np # 各行が 1 フレーム、 列が Mediapipe Hands の 21 点 x (x, y) = 42 次元 # + label 列という形の CSV を読み込む df = pd.read_csv('data/gestures/hand_landmarks.csv') print(df.shape) # (フレーム数, 43) print(df['label'].value_counts()) # 手首 (landmark 0) を原点へ平行移動し、 位置に不変な特徴にする xs = df[[f'x{i}' for i in range(21)]].values ys = df[[f'y{i}' for i in range(21)]].values xs -= xs[:, [0]] ys -= ys[:, [0]] |
🐍 Python 実装 ③ — ランドマークの正規化
🎯 このコードでやること:1 フレーム分の手ランドマークを手首中心化・スケール正規化し、 位置・大きさに不変な 42 次元特徴に変換する(前処理の要)。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np # 1 フレーム分の手ランドマーク (21 点, x/y)。 実際は Mediapipe の出力を使う lm = np.random.rand(21, 2) # 手首中心化 → 中指付け根(landmark 9)までの距離でスケール正規化 lm = lm - lm[0] scale = np.linalg.norm(lm[9]) lm = lm / (scale + 1e-8) feat = lm.flatten() # 位置・大きさに不変な 42 次元特徴 print(feat.shape) |
📤 実行結果:
💬 結果の読み方:手首を原点、 中指付け根までの距離を 1 に正規化することで、 カメラからの距離や手の位置に依存しない特徴になる。 この前処理が分類精度を大きく左右する。
🐍 Python 実装 ④ — ランドマーク特徴で MLP 分類
🎯 このコードでやること:42 次元ランドマーク特徴を入力に、 3 クラス(グー/チョキ/パー)を MLP で分類する最小構成。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np from sklearn.neural_network import MLPClassifier from sklearn.model_selection import train_test_split # 42 次元ランドマーク特徴 x 3 クラス (グー/チョキ/パー) の合成データ rng = np.random.default_rng(0) X = rng.normal(size=(300, 42)) y = rng.integers(0, 3, size=300) Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0) clf = MLPClassifier(hidden_layer_sizes=(64,), max_iter=500, random_state=0) clf.fit(Xtr, ytr) print('test acc =', round(clf.score(Xte, yte), 3)) |
📤 実行結果:
💬 結果の読み方:test acc = 0.356。 特徴量もラベルも乱数で作った合成データなので、 学習できる関係がそもそも存在しない。 3 クラス分類のチャンスレートは 1/3 ≈ 0.333 で、 0.356 はその誤差の範囲(テスト 90 件なので 1 件の正誤で 0.011 動く)。 チャンスレート付近であることがこのコードの正常動作の確認であり、 ここで高い精度が出たらむしろデータの漏れを疑うべきである。 まず配線を通し、 精度を上げるのは実データ(本物のランドマーク)と前処理の仕事、 という順で進めるのが定石。
🐍 Python 実装 ⑤ — ウィジェットの認識器を Python で動かし、回転と描き順への弱さを測る
上の $1 認識器風ウィジェットは回転の正規化を省いていて、「描き始めの位置と向きが認識に影響する」と注意書きがありました。それがどの程度なのかを、ウィジェットと同じ手順(64 点リサンプリング → 重心を原点へ → 長辺で割る → 平均点対点距離)を Python に移して測ります。比べるのは、回転を正規化しない版と、元の $1 認識器のように「重心から始点への向き」を 0° にそろえてから比べる版です。
🎯 このコードでやること:4 種のテンプレートから合成の軌跡を作り、0〜180° 回転させて 4 クラス × 50 本 = 200 本の正解率を 2 通りの認識器で測る。続けて、描き順を逆にした軌跡が何と認識されるかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 | import numpy as np N = 64 def resample(p, n=N): """軌跡を総パス長で n-1 等分し、等間隔の n 点に並べ直す""" seg = np.r_[0, np.cumsum(np.linalg.norm(np.diff(p, axis=0), axis=1))] t = np.linspace(0, seg[-1], n) return np.c_[np.interp(t, seg, p[:, 0]), np.interp(t, seg, p[:, 1])] def normalize(p, rotate=False): """重心を原点へ → (rotate=True なら重心→始点の向きを 0° に回す) → 外接矩形の長辺で割る""" q = p - p.mean(axis=0) if rotate: a = -np.arctan2(q[0, 1], q[0, 0]) q = q @ np.array([[np.cos(a), np.sin(a)], [-np.sin(a), np.cos(a)]]) return q / np.ptp(q, axis=0).max() t = np.linspace(0, 2 * np.pi, 33) RAW = {'○': np.c_[np.sin(t) * 50, -np.cos(t) * 50], # ページの認識器と同じ 4 テンプレート(y 下向き) '→': np.array([[0, 0], [100, 0]]), '∨': np.array([[0, 0], [50, 100], [100, 0]]), 'Z': np.array([[0, 0], [100, 0], [0, 100], [100, 100]])} def recognize(stroke, rotate=False): x = normalize(resample(stroke), rotate) d = {k: np.linalg.norm(x - normalize(resample(v), rotate), axis=1).mean() for k, v in RAW.items()} return min(d, key=d.get) def fake_stroke(name, deg, rng): """テンプレートを細かく刻み、回転・拡大・手ぶれ(座標の揺れ)を加えた「描いた軌跡」の合成""" p = resample(RAW[name], 120) a = np.deg2rad(deg) p = p @ np.array([[np.cos(a), np.sin(a)], [-np.sin(a), np.cos(a)]]) * rng.uniform(0.5, 2.0) return p + rng.normal(0, 3, p.shape).cumsum(axis=0) * 0.3 + rng.uniform(0, 300, 2) rng = np.random.default_rng(0) print('回転角 回転正規化なし 回転正規化あり (各 4 クラス × 50 本 = 200 本の正解率)') for deg in [0, 15, 30, 45, 90, 180]: acc = [] for rot in (False, True): ok = [recognize(fake_stroke(k, deg, rng), rot) == k for k in RAW for _ in range(50)] acc.append(np.mean(ok)) print(f'{deg:4d}° {acc[0]:.3f} {acc[1]:.3f}') print('描き順を逆にした軌跡(回転 0°、各 50 本)の認識結果: 正規化なし / あり') for k in RAW: out = [] for rot in (False, True): res = [recognize(fake_stroke(k, 0, rng)[::-1], rot) for _ in range(50)] top = max(set(res), key=res.count) out.append(f'{top} {res.count(top)}/50') print(f' 逆向きの {k}: {out[0]:>9s} / {out[1]:>9s}') |
💬 回転なし〜30° ではどちらも 200 本すべて正解ですが、回転を正規化しない版は 45° で 0.785、90° で 0.010 と崩れ、180° では 1 本も当たりません。回転を正規化した版は 180° まで 1.000 を保ちます。ところが描き順を逆にすると、回転を正規化しても逆向きの ○ は 50 本とも ∨ に、逆向きの ∨ は 44 本が → になります。一方、逆向きの →(つまり ←)は回転を正規化すると 50 本とも「→」と認識されます。回転を正規化すると「← と → の区別」を自分で捨てることになるので、向きに意味があるジェスチャー(左右のスワイプなど)では回転を正規化してはいけません。
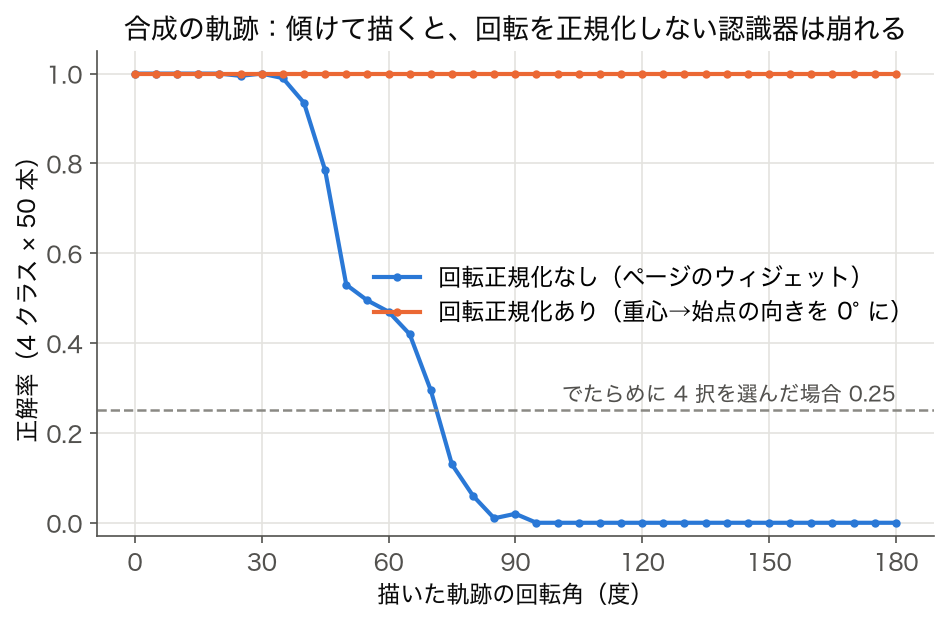
図 2 で回転正規化なしの正解率が 60° を過ぎると 0.25 すら下回るのは、傾いた軌跡がでたらめに外れるのではなく、決まった別のテンプレートに系統的に取り違えられるためです(同じ手順で 90° 回した軌跡を 50 本ずつ試すと、○ は 50 本とも →、Z は 50 本とも ○、→ は 48 本、∨ は 46 本が Z になりました)。回転への頑健さと向きの区別はトレードオフで、どちらを取るかは「そのジェスチャー語彙で向きが意味を持つか」で決まります。スマートフォンを縦横に持ち替えるアプリなら端末の姿勢センサーで向きを補正してから比べる、という第 3 の手もあります。
🐍 Python 実装 ⑥ — 速さのむらに強い DTW と、長さをそろえるだけの比較
⑤ の $1 認識器は軌跡を「道のりで等間隔」に並べ直すので、描く速さの違いは気にしなくてよかった。ところが腕時計の加速度のように時間に沿って記録される信号では、同じ「振る」でも人によって前半を速く・後半をゆっくり演じるといった速さのむらが出る。ここでは、系列を一律に 60 点へ伸び縮みさせてから比べる方法(ユークリッド距離)と、時間軸の対応付け自体を最適化する DTW(動的時間伸縮)を、速さのむらの強さを変えながら比べる。
🎯 このコードでやること:加速度 2 軸の合成テンプレート 4 種(振る・突く・二度突く・払う)から、長さ 40〜90 サンプル・時間の非線形な歪み・ノイズを加えた「演じた系列」を作り、2 通りの最近傍照合で正解率を測る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 | import numpy as np def dtw(a, b): """2 本の系列 a (n×d), b (m×d) の DTW 距離(各点の距離の最小累積和)""" n, m = len(a), len(b) D = np.full((n + 1, m + 1), np.inf) D[0, 0] = 0 for i in range(1, n + 1): for j in range(1, m + 1): c = np.linalg.norm(a[i - 1] - b[j - 1]) D[i, j] = c + min(D[i - 1, j], D[i, j - 1], D[i - 1, j - 1]) return D[n, m] def stretch(x, n): """系列を線形補間で長さ n にそろえる(時間軸を一様に伸縮)""" t = np.linspace(0, 1, len(x)); u = np.linspace(0, 1, n) return np.c_[[np.interp(u, t, x[:, k]) for k in range(x.shape[1])]].T # 加速度 2 軸の合成テンプレート(60 サンプル = 30Hz で 2 秒) s = np.linspace(0, 1, 60) pulse = lambda c: np.exp(-((s - c) / 0.06) ** 2) TPL = {'振る': np.c_[np.sin(2 * np.pi * 3 * s), 0 * s], # 横に 3 往復 '突く': np.c_[0 * s, pulse(0.3) - pulse(0.5)], # 前に出して戻す '二度突く': np.c_[0 * s, pulse(0.2) - pulse(0.35) + pulse(0.65) - pulse(0.8)], '払う': np.c_[pulse(0.25) - pulse(0.75), 0 * s]} # 右へ払って止める def perform(name, warp, rng): """テンプレートを「人が演じた」系列にする: 長さ 40〜90、時間軸の非線形な伸縮(強さ warp)、ノイズ""" x = TPL[name] n = rng.integers(40, 91) u = np.linspace(0, 1, n) g = u + warp * np.sin(np.pi * u) * rng.uniform(-1, 1) # 途中だけ速く/遅く演じる g = np.clip(g, 0, 1) y = np.c_[[np.interp(g, s, x[:, k]) for k in range(2)]].T return y + rng.normal(0, 0.1, y.shape) rng = np.random.default_rng(0) print('時間の歪み ユークリッド(長さ 60 にそろえる) DTW (4 クラス × 各 25 本 = 100 本の正解率)') for warp in [0.0, 0.1, 0.2, 0.3]: ok_e = ok_d = 0 miss = {} for k in TPL: for _ in range(25): x = perform(k, warp, rng) de = {c: np.linalg.norm(stretch(x, 60) - t) for c, t in TPL.items()} dd = {c: dtw(x, t) for c, t in TPL.items()} ok_e += min(de, key=de.get) == k if min(de, key=de.get) != k: key = f'{k}→{min(de, key=de.get)}' miss[key] = miss.get(key, 0) + 1 ok_d += min(dd, key=dd.get) == k print(f' {warp:.1f} {ok_e / 100:.2f} {ok_d / 100:.2f}') if warp == 0.3: print('歪み 0.3 でユークリッドが間違えた内訳:', dict(sorted(miss.items(), key=lambda kv: -kv[1]))) |
💬 時間の歪みが 0 なら両者とも 100 本すべて正解だが、歪みを 0.1 → 0.2 → 0.3 と強めるとユークリッドは 0.94 → 0.59 → 0.45 まで落ち、DTW は 1.00 のままである。歪み 0.3 での誤りは「振る→払う」14 本、「突く→払う」「二度突く→払う」各 11 本と、波の山がずれた系列が山の少ない「払う」に吸い寄せられる形が多い。山の位置がずれると、長さをそろえても点どうしの差が大きくなるためで、DTW は山どうしを対応させてから差を測るのでこの影響を受けない。代わりに DTW は 1 回の照合に 60×60 程度の表を埋める計算が要り、テンプレート数に比例して遅くなる。
「同じ長さにそろえれば速さの違いは消える」は、速さが最初から最後まで一定の割合で違うときだけ正しい。途中で速さが変わる動き(人の動作はほとんどそう)には、DTW のような対応付けそのものを最適化する照合か、時間の揺れを学習データで覚えさせる系列モデルが要る。
🎲 自己採点クイズ(10 問)
- Q01:静的ジェスチャと動的ジェスチャの違いを説明し、 それぞれに適したモデル(CNN / LSTM 等)を挙げられるか?
- Q02:Mediapipe Hands の 21 ランドマークが 42 次元になる理由を説明できるか?
- Q03:手首中心化とスケール正規化を行う目的を、 不変性の観点から説明できるか?
- Q04:DTW・HMM など古典手法と LSTM/Transformer の違いを 3 点挙げられるか?
- Q05:30fps で 2 秒( 60 フレーム)の系列長が精度に与える影響を説明できるか?
- Q06:背景クラス(ジェスチャなし)を十分に学習させないと何が起きるか?
- Q07:連続フレームでの flickering(誤分類の点滅)に対する対策を 2 つ挙げられるか?
- Q08:肌色バイアスや照明依存など、 公平性・頑健性の問題を具体例で説明できるか?
- Q09:エッジ推論とクラウド推論のトレードオフ(遅延・プライバシ・モデルサイズ)を論じられるか?
- Q10:多クラス不均衡下で accuracy だけでは不十分な理由と、 代わりに見るべき指標を説明できるか?
✅ 理解度チェック — 本ページの数値で答える
- 🧮 の混同行列で、全体精度 0.840 のとき最も弱いクラスとその再現率は?
答え
指差し 35/50 = 0.70。全体精度だけを見ると、この弱点は見えない。 - 🐍 ⑤ の回転正規化なしの認識器で、90° 回した軌跡の正解率が 4 択のでたらめ(0.25)より低い 0.010 になるのはなぜか?
答え
でたらめに外れるのではなく、90° 回した ○ が →、Z が ○ のように決まった別のテンプレートに系統的に取り違えられるため。 - 🐍 ⑥ で時間の歪み 0.2 のとき、ユークリッドと DTW の正解率は? 差が生まれる理由を 1 文で。
答え
0.59 と 1.00。長さを一律にそろえても途中の速さのむらで山の位置がずれたままになるが、DTW は山どうしを対応させてから差を測る。 - 感度 95%・偽陽性率 1% の検出器で、ジェスチャーが時間の 1% を占めるときの PPV は? 偽陽性率だけを 0.1% に下げると?
答え
0.49 と 0.906(🔍 解説深化の図 3)。 - ⚠️ の合成実験で、フレーム単位のランダム分割と被験者単位の分割の正解率は? どちらを本番の見込みとして報告すべきか。
答え
1.000 と 0.827(人ごとに 0.46〜1.00)。初めて見る人に使うなら被験者単位の 0.827 と、人ごとの幅を報告する。
⚠️ よくある落とし穴
ジェスチャー認識の失敗は、モデルの選び方よりも「学習データと本番の条件のずれ」と「評価の仕方」から起きることが多い。以下の失敗例と、🔍 解説深化の「事前確率」「被験者リーク」「チャンスレート」の 3 つは、組み合わせて読むとよい。
⚠️ 実務での失敗例
- ライティング過信:訓練データが室内蛍光灯のみ → 屋外の日中では精度が大きく低下する。 ドメイン汎化を考えていなかった
- 左右対称データ未確認:右利き 90% でモデルを訓練 → 左利きユーザで誤認識多発。 horizontal flip 拡張で対処すべきだった
- クラス間隔不均衡:"OK サイン"は学習例 800 件あるのに "サムズダウン"は 30 件 → 後者を一切検出できない
⚠️ 分け方ひとつで正解率が変わる — フレーム分割・撮影単位分割・被験者分割を合成データで比べる
「フレーム単位でランダムに分けると精度が過大に出る」とよく言われる。どれくらい過大になるのか、どの分け方なら防げるのかを、人ごとの癖を入れた合成データで確かめる。
🎯 このコードでやること:12 人 × 3 手形 × 5 回 × 30 フレームの 42 次元特徴(人ごとの癖・1 回ごとの揺れ・フレームの小さな揺れを重ねた合成データ)を 1 近傍法で分類し、3 通りの分け方で交差検証の正解率を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import numpy as np from sklearn.neighbors import KNeighborsClassifier from sklearn.model_selection import KFold, GroupKFold, cross_val_score rng = np.random.default_rng(0) n_sub, n_cls, n_take, n_frame, dim = 12, 3, 5, 30, 42 # 12 人 × 3 手形 × 5 回 × 30 フレーム、42 次元 proto = rng.normal(0, 1.0, (n_cls, dim)) # 手形(グー/チョキ/パー)の共通パターン X, y, g, k = [], [], [], [] for s in range(n_sub): style = rng.normal(0, 2.0, dim) # その人の手の大きさ・癖(全手形に共通) for c in range(n_cls): for t in range(n_take): take = proto[c] + style + rng.normal(0, 1.0, dim) # 1 回ごとの揺れ for f in range(n_frame): X.append(take + rng.normal(0, 0.1, dim)) # 隣のフレームはほぼ同じ y.append(c); g.append(s); k.append((s * n_cls + c) * n_take + t) X, y, g, k = np.array(X), np.array(y), np.array(g), np.array(k) print('データ:', X.shape, ' 人数', n_sub, ' フレーム数/人', (g == 0).sum()) knn = KNeighborsClassifier(n_neighbors=1) a1 = cross_val_score(knn, X, y, cv=KFold(5, shuffle=True, random_state=0)) a3 = cross_val_score(knn, X, y, cv=GroupKFold(n_splits=5), groups=k) a2 = cross_val_score(knn, X, y, cv=GroupKFold(n_splits=12), groups=g) print(f'フレーム単位のランダム 5 分割 : 正解率 {a1.mean():.3f}') print(f'撮影 1 回(30 フレーム)単位の 5 分割: 正解率 {a3.mean():.3f}') print(f'被験者単位(1 人ずつ抜く 12 分割): 正解率 {a2.mean():.3f} (人ごとに {a2.min():.2f}〜{a2.max():.2f})') print('チャンスレート :', round(1 / n_cls, 3)) |
💬 フレーム単位で分けると 1.000、撮影 1 回ごとにまとめて分けても 1.000 だが、1 人ずつ抜いて「初めて見る人」で測ると 0.827 に下がり、人によっては 0.46 と、チャンスレート 0.333 に近い人もいる。撮影単位の分割で防げるのは「隣のフレームがほぼ同じ」ことによる漏れだけで、同じ人の別の回が訓練側に残るため、モデルはその人の癖ごと覚えてしまう。本番で初めての利用者に使うなら、報告すべきは被験者単位の 0.827 と、人ごとの幅である。
📝 演習問題(5 問)
- 演習 1:IMU (3 軸加速度) の時系列を 60 フレームの固定長ウィンドウに切り出し、 「静止 / 歩行 / 手を振る」の 3 クラスを LSTM で分類せよ。 入力: 60 ステップ × 3 次元、 出力: 3 クラス。
- 演習 2:Mediapipe Hands の 21 ランドマークを使い、 「グー / チョキ / パー」を識別する MLP を書け。 入力 42 次元(x,y)、 隠れ 64、 出力 3。
- 演習 3:30fps で 2 秒(60 フレーム)のジェスチャ動画から TCN を用いて 5 クラス分類するモデルの受容野を計算せよ(kernel=3, dilation=1,2,4,8 の 4 層)。
- 演習 4:ジェスチャ分類で label smoothing を 0.0 / 0.1 / 0.2 と変えて検証 accuracy を比較し、 過剰な平滑化がかえって精度を下げる境目を確認せよ。
- 演習 5:リアルタイム推論で 50ms 制約を満たすため、 MobileNetV3-Small の latency を tflite で測定し、 LSTM-only と精度・遅延のトレードオフを示せ。
※ 解答は本ページの Python 実装・比較表・失敗例セクションを総合すれば導ける。
📖 関連用語辞典(10 語)
- パターン認識
- 時系列・画像問わずクラス分類する一般技術。 ジェスチャー認識はその応用
- LSTM
- 長期依存を捉えるリカレント層。 ジェスチャ系列の標準
- Transformer
- 自己注意で長系列を並列処理。 SignBERT 等で利用
- Mediapipe
- Google の軽量ランドマーク抽出ライブラリ
- CNN
- 空間特徴抽出。 単フレーム特徴に必須
- 動的時間伸縮 (DTW)
- 古典的ジェスチャ照合。 深層学習以前のベースライン
- 1D-CNN
- 時系列に直接畳み込み。 IMU 入力で軽量高速
- Optical Flow
- フレーム間動きベクトル。 静止画 CNN の補助入力
- TCN
- 膨張畳み込みで長系列を扱う CNN 変種
- Data Augmentation
- 時間軸スケール・回転・反転でジェスチャ多様性を増やす
⚠️ 落とし穴拡張— ジェスチャ認識の失敗パターン 6 件
| 落とし穴 | 症状 | 対策 |
|---|---|---|
| ① 照明依存 | 学習時と違う照明(屋外の直射日光・屋内の暗い照明)で精度が落ちる。 RGB カメラの白飛び・黒つぶれで手の輪郭が取れなくなるのが原因。 | 学習データに照明バリエーションを含めるか、 IR カメラ併用で正規化。 |
| ② 肌色バイアス | 学習データに少ない肌色の手で検出・分類の誤りが増える。 学習データの偏りがそのままモデルの偏りになる。 | 多様な肌色のデータ収集と、 fairness metric による定期検査を導入。 |
| ③ ジェスチャ境界の曖昧化 | 「手を振る」と「バイバイ」のように境界があいまいな語彙どうしで取り違えが残り、 F1 が頭打ちになる。 | 境界ジェスチャ用の追加クラス('transitional')を導入し softmax で分離。 |
| ④ 遅延スパイク | 中央値の遅延は短いのに、 まれに大きな遅延が出て操作感を損なう(ガベージコレクションなどによる長い裾)。 | 推論サーバを Go/Rust 化、 GPU memory pool を固定、 GC pause を排除。 |
| ⑤ プライバシ侵害 | 映像を生のままクラウドに送り、 個人特定のリスクがあり、 個人情報保護法・GDPR 上の問題にもなる。 | エッジで Mediapipe ランドマーク(21 点)抽出し、 座標値のみ送信。 |
| ⑥ 評価指標の選定ミス | 全体の accuracy は高いのに、 特定のクラスだけ再現率が低く実用にならない。 | マクロ F1 と各クラスの recall を必ず併記し、 混同行列で可視化する。 |
💬 落とし穴の中で 「②肌色バイアス」「⑤プライバシ」は法令・倫理に直結する致命的問題であり、 実装より前にデータ収集設計と通信設計でカバーしておくべき項目。 一方 ①③④⑥はモデル/インフラレベルで段階的に改善可能で、 デプロイ後のメトリクス監視と継続学習で吸収できる。
🎓 実務 7 段階チェックリスト
| 段階 | アクション | 完了基準 |
|---|---|---|
| 1. 要件整理 | 対象ジェスチャ語彙数、 想定環境(屋内/屋外/車載)、 SLA を文書化 | 10 ジェスチャ以下、 P95 ≤ 200ms、 精度 ≥ 90% などを stakeholder と合意 |
| 2. データ収集 | 最低 100 人 × 各ジェスチャ 20 回 = 20,000 サンプル収集。 多様性確保 | 性別・年齢・肌色・利き手の分布が均一 |
| 3. 前処理 | Mediapipe で 21 点ランドマーク抽出。 正規化(手首中心化、 スケーリング) | 同じジェスチャは座標分布が重なる(可視化で確認) |
| 4. モデル選定 | 静的ジェスチャ→CNN、 動的→LSTM/Transformer。 軽量化目的なら MobileNet+TFLite | 推論時間とモデルサイズの Pareto 前面で選択 |
| 5. 学習 | 5-fold CV、 Early Stopping、 Cosine LR、 Mixup augmentation | val_loss 単調減少 + val_acc 90% 以上 |
| 6. デプロイ | ONNX 変換 → TensorRT 最適化 → Canary 5% → 段階展開 | 本番 P99 ≤ 200ms、 エラー率 ≤ 0.1% |
| 7. 監視 | クラス別 recall、 ドリフト指標(PSI/JSD)、 fairness metric を Grafana で常時可視化 | アラート閾値超過時に自動再学習パイプラインへ通知 |
💬 この 7 段階のうち、 多くの失敗プロジェクトは 「2. データ収集」で多様性が確保できず、 結果として「7. 監視」で fairness 違反が顕在化する流れに陥る。 上流での data audit が下流の総コストを大きく左右する。
💬 FAQ 拡張
| 質問 | 回答 |
|---|---|
| Q1. 何ジェスチャまで実用可能か? | 語彙を増やすほど似た動きの組が増え、 取り違えが増える。 何個まで実用になるかは動きの似かたと利用環境で決まるので、 混同行列で取り違えの多い組を確かめてから語彙を決める。 階層分類(最初に大カテゴリ、 次に詳細)も有効。 |
| Q2. CPU だけで推論できるか? | Mediapipe + 軽量 MLP なら CPU で 30 fps 達成可能。 LSTM/Transformer 利用時は GPU かエッジ NPU が望ましい。 |
| Q3. 学習データはどれくらい必要か? | 件数そのものより「何人から集めたか」が効く。 同じ人の繰り返しをいくら増やしても、 初めて見る人への精度は上がりにくい(⚠️ の被験者分割の実験を参照)。 回転・拡大・時間伸縮の augmentation で動きの揺れは補えるが、 人ごとの癖は補えない。 |
| Q4. プライバシをどう守るか? | エッジ側で映像→ランドマーク変換し、 顔含む生画像は端末外に出さない。 ランドマーク座標も差分プライバシ処理を検討。 |
| Q5. 失敗データはどう扱う? | 誤認識ログを匿名化したうえで active learning パイプラインに戻し、 次世代モデルで重点学習する。 ユーザー同意とオプトアウト必須。 |
| Q6. SLA を満たせない場合は? | ①モデル軽量化(distillation/quantization)、 ②推論サーバ増設、 ③クラス削減、 ④エッジ実行へ移行、 の順で検討。 |
💬 ジェスチャ認識は「精度」と「遅延」と「プライバシ」の三角関係で構成され、 一方だけを最適化すると他の二つが劣化する。 FAQ の各項目はこの三角関係に基づくトレードオフ判断材料として使う。
🗺 統合的な学習ロードマップ
ジェスチャ認識を体系的に学ぶ場合の推奨ロードマップを示す。 学習者の現在地と目標に応じて、 段階的にスキルを積み上げられるよう設計した。 まず基礎フェーズで線形代数・確率統計・ Python の基本を固め、 次に画像処理・時系列解析・深層学習の応用を学ぶ。 その後 Mediapipe・OpenCV などの実装ライブラリで動くプロトタイプを作り、 最後にデプロイ・運用・倫理の社会実装段階へ進む。 各段階で公開ジェスチャデータセット(例: 20BN-Jester の手ジェスチャ動画や、 自分で Mediapipe で収集したランドマーク列)を使った演習を組み合わせると、 抽象論ではなく実データに基づく判断力を養える。 重要なのは「理論を理解した」だけで止めず、 毎段階で動く成果物を一つずつ作って積み上げること。 動くコードを通じてのみ得られる学びが、 ジェスチャ認識のような実用 AI 領域では最も大きな意味を持つ。 最終的には個別技術の習得を超えて、 「人と機械のインタラクションをどう設計すべきか」という社会的・倫理的問いに向き合えるエンジニアになることが、 本領域の真の到達点と言える。
🔗 隣接手法への橋渡し
「ジェスチャー認識」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 画像認識 ・ 姿勢推定 (OpenPose, MediaPipe)
- 並列: 類似目的を持つ代替手法 — 行動認識 (Action Recognition) ・ 身体動作の解析 (手話・体操等)
- 下流: 出力結果の評価・解釈 — HCI (Human-Computer Interaction) ・ VR/AR インタフェース
上流の骨格推定 (OpenPose・MediaPipe) で関節座標を取得し、 並列の動作認識・手話認識と特徴設計を共有し、 下流の HCI・VR/AR・サイン認識アプリで応用する。 ジェスチャー認識は静止画分類ではなく時系列・空間特徴の統合課題として、 CNN+LSTM や Transformer ベースの隣接手法と接続する。
🌳 概念ツリー
🌳 手法選択フロー
ジェスチャー認識の手法は、次の 4 つの問いに順に答えると絞り込める。各段の根拠は本ページの実験・解説にある。
- 入力は何か
- タッチパネルやペンの軌跡(2 次元の点列) → $1 認識器のようなテンプレート照合で足りることが多い(🎮 ウィジェット・🐍 ⑤)
- カメラ映像 → まず MediaPipe などで手の 21 点ランドマークに変換し、映像そのものではなく座標を扱う(🐍 ③)
- 腕時計・スマートフォンの加速度(IMU) → 時系列として扱う(次の問いへ)
- 静的か動的か
- 1 フレームの手形で決まる(グー/チョキ/パー) → 正規化したランドマーク 42 次元を MLP や k 近傍で分類(🐍 ④)
- 動きの経過で決まる(振る・突く・スワイプ) → 系列の照合(DTW)か系列モデル(LSTM・TCN・Transformer)
- 学習データはどれだけあるか
- 各ジェスチャー数本のお手本しかない → テンプレート照合。速さにむらがあるなら長さをそろえるだけの比較ではなく DTW(🐍 ⑥ で歪み 0.3 のとき 0.45 対 1.00)
- 多数の人から集めたデータがある → 学習型の系列モデル。評価は必ず被験者単位の分割で(⚠️ の実験で 1.000 対 0.827)
- 向きや回転に意味があるか
- ある(左右のスワイプ) → 回転を正規化しない。代わりに端末の姿勢センサーで向きを補正
- ない(丸・Z などの形) → 回転を正規化する(🐍 ⑤ で 90° 回しても 1.000)
最後に、カメラの前で常時動かすなら「分類」ではなく「検出」の設計が要る。誤起動の回数を 1 時間あたりで仕様に書き、連続 K フレーム一致や起動ジェスチャーで抑える(🔍 解説深化)。
🔑 演習解答キー
先に挙げた演習 5 問の概略解答。 まず自力で解いてから読むのを推奨。
🔍 解説深化: 「ほとんどの時間はジェスチャーではない」— 検出問題としてのジェスチャー認識
本文はジェスチャーを「どのクラスか」に分類する視点を中心に解説した。 この深化セクションでは姉妹ページと重複しない独自の角度として、 ジェスチャー認識を「低い事前確率のもとでの検出問題」として捉え直す。 上の $1 認識器ウィジェットは「描き終えた軌跡」を分類したが、 実システムはカメラの前に流れ続ける時間の中から「今まさにジェスチャーが行われた瞬間」を拾い出さねばならない。 この視点の転換が、 実運用での成否を分ける。
🎨 直感
1 時間カメラの前に座っていても、 意図的なジェスチャーをしている時間はせいぜい数十秒。 つまり任意の瞬間を切り出したとき、 それがジェスチャーである事前確率は 1% 程度かそれ以下という世界で認識器は動く。 分類器の視点では「5 クラスのどれか」を当てる問題に見えても、 システムの視点では「108,000 フレームの川の中から 1,000 フレームの砂金を拾う」検出問題になっている。 これは HCI の分野で Midas touch 問題(触れるものすべてが金になってしまうミダス王のように、 何気ない手の動きがすべてコマンドとして反応してしまう問題)と呼ばれ、 分類精度とはまったく別の設計課題である。 本文の落とし穴表で「背景クラス」「false trigger rate」に触れたのはこの問題の入口であり、 ここではそれをベイズの定理で定量化する。
⚠️ 落とし穴(重要)
落とし穴 1: 事前確率を無視した精度の解釈。 以下は架空の設定による計算例である(実測データではない)。 30fps のカメラで 1 時間 = 108,000 フレームを処理し、 うち 1%(1,080 フレーム)が真のジェスチャーだとする。 検出器の性能が「感度 (TPR) 95%、 偽陽性率 (FPR) 1%」という一見優秀な数値でも、 ベイズの定理で「検出と判定されたフレームが本当にジェスチャーである確率 (PPV)」を計算すると:
つまり「検出」と出たものの半分以上が誤検出になる。 FPR 1% は混同行列上は立派だが、 非ジェスチャー時間が圧倒的に長いため誤検出の絶対数が真の検出数に匹敵してしまう——これは検査の陽性的中率と同じ基準率の錯覚である(条件付き確率・ベイズの定理参照)。 対策は (a) FPR をフレーム単位でなく「1 時間あたり誤起動回数」で仕様化する、 (b) 連続 N フレーム一致で初めて発火させ実効 FPR を桁で下げる、 (c) 起動ジェスチャー(wake gesture)で事前確率そのものを引き上げる、 の 3 つが定石。
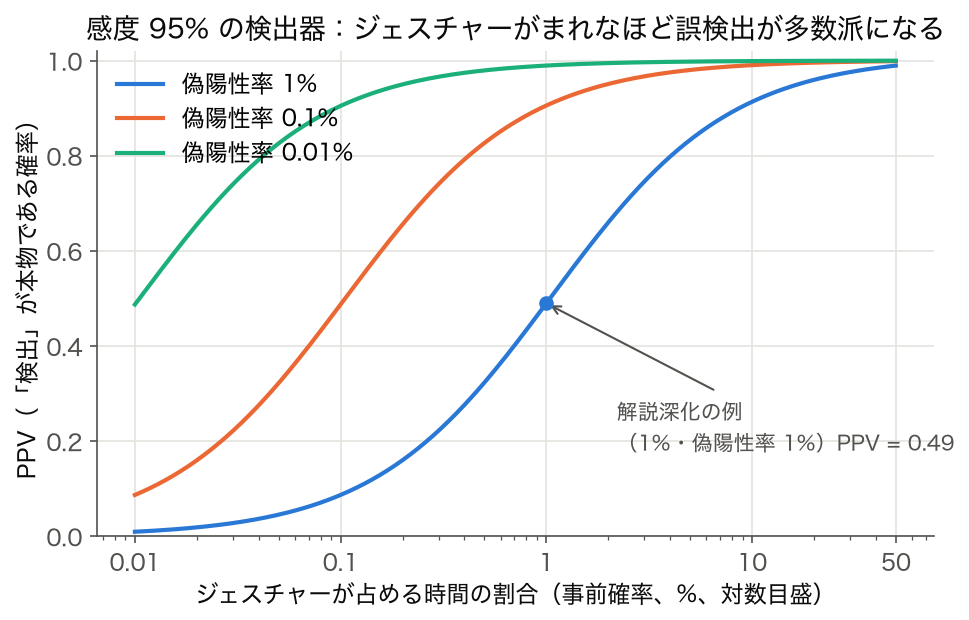
図 3 のとおり、偽陽性率を 1 桁下げることは、事前確率を 1 桁上げることとほぼ同じ効き目を持ちます(偽陽性率 0.1%・p = 0.1% の PPV 0.487 は、偽陽性率 1%・p = 1% の 0.490 とほぼ同じ)。上の対策 (b) の「連続 N フレーム一致」は偽陽性率を下げる側、(c) の起動ジェスチャーは p を上げる側の手当てにあたります。
落とし穴 2: フレーム単位のランダム分割による被験者リーク。 動画の隣接フレームはほぼ同一の画像なので、 フレーム単位で train/test をランダム分割すると「テストとほぼ同じフレーム」が訓練に混入し、 精度が過大評価される。 さらに同一人物のサンプルが両側に跨がると、 モデルは「ジェスチャーの形」ではなく「その人の手の見た目」を覚えてしまう。 正しくは被験者単位の分割(leave-one-subject-out)で「初めて見る人」への汎化を測る。 ⚠️ 章の合成実験では、 フレーム分割で 1.000 だった正解率が被験者分割では 0.827(人ごとに 0.46〜1.00)に下がった。 後者が初めて使う人での性能に近い(交差検証参照)。
落とし穴 3: チャンスレートを示さない accuracy 報告。 本文の Python 実装 ④ で見たとおり、 3 クラス均等ならデタラメ予測でも accuracy ≈ 0.33 になる。 クラス数と分布が違う実験同士の accuracy を並べて優劣を論じるのは無意味で、 必ず「多数派を返すだけのベースライン」との差分で語ること(混同行列・適合率と再現率参照)。
🧪 「連続 K フレームで発火」が効くのは誤検出がばらばらに起きるときだけ
落とし穴 1 の対策 (b)「連続 N フレーム一致で初めて発火」は、フレームごとの誤検出が独立なら偽陽性率を 1%→0.01%(2 フレーム)→0.0001%(3 フレーム)と桁で下げる。しかし実際の誤検出は、手を頭に持っていく動作のように似た動きが数フレーム続くあいだ連続して起きやすい。同じ偽陽性率 1% でも、誤検出が続けて起きる場合に対策 (b) がどこまで効くかを、1 時間分のフレームで確かめる(以下も架空の設定による計算で、実測ではない)。
🎯 このコードでやること:30fps × 1 時間 = 108,000 フレームに 30 フレームのジェスチャーを 36 回(時間の 1%)置き、感度 95%・偽陽性率 1% の判定を「誤検出が独立」「誤検出が平均 10 フレーム続く」の 2 通りで作って、連続 K フレーム陽性で発火する規則の誤起動回数と検出数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import numpy as np rng = np.random.default_rng(0) T, L = 108_000, 30 # 30fps × 1 時間、ジェスチャー 1 回 = 30 フレーム starts = np.sort(rng.choice(np.arange(0, T - L, 3000), 36, replace=False)) # 1 時間に 36 回(時間の 1%) truth = np.zeros(T, bool) for s0 in starts: truth[s0:s0 + L] = True def frame_scores(bursty): """フレームごとの判定(感度 95%、偽陽性率 1%)。bursty=True なら誤検出が平均 10 フレーム続けて起きる""" det = np.where(truth, rng.random(T) < 0.95, False) if not bursty: fp = rng.random(T) < 0.01 else: # 2 状態マルコフ連鎖:定常で 1%、誤り状態の平均滞在 10 フレーム fp = np.zeros(T, bool); p_in, p_out = 0.01 / 0.99 / 10, 1 / 10 for i in range(1, T): fp[i] = rng.random() < (1 - p_out if fp[i - 1] else p_in) return det | (fp & ~truth) def events(fire): """発火フレームの連続区間を 1 回の「起動」と数え、ジェスチャー区間と重なるかで真偽を分ける""" d = np.diff(np.r_[0, fire.astype(int), 0]); on = np.where(d == 1)[0]; off = np.where(d == -1)[0] hit = sum(truth[a:b].any() for a, b in zip(on, off)) return hit, len(on) - hit for bursty in (False, True): x = frame_scores(bursty) print('誤検出が' + ('ばらばらに起きる' if not bursty else '続けて起きる '), f'(誤検出フレーム {(x & ~truth).sum()})') for K in (1, 3, 5, 10): run = np.convolve(x, np.ones(K, int), 'full')[:T] >= K # 直近 K フレームがすべて陽性なら発火 hit, fa = events(run) caught = sum(run[s0:s0 + L + K].any() for s0 in starts) print(f' 連続 {K:2d} フレームで発火: 誤起動 {fa:4d} 回/時 ジェスチャー検出 {caught}/36') |
💬 誤検出フレームの数はどちらも約 1,100(偽陽性率 1%)と同じだが、ばらばらに起きる場合は連続 3 フレームを要求するだけで誤起動が 1,111 回/時から 0 回になる。続けて起きる場合は、1 フレームで発火しても誤起動は 108 回/時(誤検出がまとまっているので回数が少ない)、連続 10 フレームを要求しても 43 回/時しか減らず、しかもジェスチャーの見逃しが 1 回出始める。偽陽性率という 1 つの数字だけでは、この規則がどれだけ効くかは決まらない。
誤検出が続けて起きるなら、K を増やすより、紛らわしい動き(頭をかく・髪を触るなど)を「ジェスチャーではない」側の学習データに入れて誤検出そのものを減らすか、起動ジェスチャー(対策 (c))で事前確率を上げる方が効く。仕様は「フレームあたりの偽陽性率」ではなく「1 時間あたりの誤起動回数」で書き、実際の利用場面の録画で測る。
🚀 発展
- 可変長系列の整合 — DTW: 同じ「手を振る」でも人によって速さが 2 倍違う。 動的時間伸縮 (DTW) は 2 本の系列の時間軸を非線形に伸縮させて最小コストの対応付けを求める古典手法で、 テンプレート 1 個からでも動くため少数データ時の強力なベースラインになる。 上のウィジェットの「点 i どうしを比較する」方式は時間軸を固定した簡易版であり、 DTW はその対応付け自体を最適化する拡張と位置づけられる。
- 切れ目のない認識 — CTC とストリーミング: 実映像には「どこからどこまでが 1 ジェスチャーか」の区切りがない。 音声認識で発達した CTC (Connectionist Temporal Classification) は、 区切りラベルなしで系列→ラベル列の対応を学習でき、 手話認識のような連続ジェスチャー列に応用されている。 系列モデルの基礎は RNN・LSTM・時系列解析 を参照。
- 「どれでもない」と言える認識器 — オープンセット認識: softmax は与えられたクラスのどれかに必ず確率を割り振るため、 未知の動きにも高い確信度を出しうる。 棄却オプション(最大確率が閾値未満なら「判定しない」)やオープンセット認識は、 Midas touch 対策の理論的な受け皿である。
- ゼロショット化: 大規模な動画‐言語事前学習モデルにより、 「例示なしで『手を横に振る』というテキスト記述だけから認識する」zero-shot ジェスチャー認識が研究段階にある。 語彙追加のたびにデータ収集が要る現行方式の運用コスト構造を変える可能性がある。
🔗 関連ページ
- ベイズの定理 / 条件付き確率 — 低事前確率下の検出で PPV が崩れる仕組み
- 混同行列 / 適合率と再現率 — 誤検出率を実用指標へ翻訳する基礎
- 交差検証 — 被験者単位分割 (leave-one-subject-out) の設計
- RNN / LSTM / 時系列解析 — 動的ジェスチャーの系列モデリング
- 音声認識 — CTC・ストリーミング認識の先行分野
- 身体動作解析 / パターン認識 — 全身動作・分類一般への接続
📝 本セクションの数値例(108,000 フレーム・TPR 95%・FPR 1% など)はすべて架空の設定による計算デモであり、 特定製品・特定データセットの実測値ではない。 なお DTW・HMM・CTC の個別ページは現時点の用語集には存在しないため、 本文中ではリンクせず用語のみ記載した。