🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
言葉と実物を結びつけるパズルのような問題です。
AIに本当の意味を理解させるために考えます。
スマホの単語と実際の物の違いに似ています。
まずは結論から短く確認しましょう。
記号と実世界の意味の対応付け問題
- 記号(単語・列名・数値)は、 それが何を指すかを決める手続き(見る・測る・数える)と結び付いて初めて意味を持つ。 これを記号接地という(Harnad 1990)
- 記号どうしの関係だけで意味を説明しようとすると、 辞書の循環のように別の記号へ行き着くだけになる
- データ分析でも同じで、 2023 年度の「暑い県」を年平均気温で決めると沖縄県など、 最高気温で決めると富山県などになり、 上位 5 県の重なりは 0
- 「日本の高齢化率」も、 47 県の単純平均なら 31.59%、 65 歳以上人口の合計 ÷ 総人口の合計なら 29.13% と、 何を 1 単位に数えるかで 2.46 ポイント変わる。 記号を使うときは、 指している測定手続きを必ず書き添える
- 「最新の値」を行の順番で決めると、 新しい年度から並ぶ SSDSE-B-2026 では 2012 年度が返る。 記号「最新」は年度の列に接地させる
- 大規模言語モデルの流暢さは、 記号どうしの関係を学んだ結果であって、 外界との接地とは別の問題である
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
AIが言葉をどう扱うかという根本的な問いです。
AIの仕組みや限界を知るために使います。
部活のルールを文字だけで覚える時に似ています。
この考え方がどこで使われるかを見ていきましょう。
シンボルグラウンディング問題は 「機械が記号(単語・概念)を実世界の指示対象と結びつけられるか」という AI 哲学の中核問題。 Stevan Harnad が 1990 年に定式化。 LLM 全盛の現代でも未解決の論点で、 G 検定では Searle の「中国語の部屋」と並んで頻出。
歴史 — なぜ 1990 年に問題として立てられたのか
Stevan Harnad が 1990 年にこの問題を定式化した背景には、 当時主流だった記号処理型 AI(GOFAI)の行き詰まりがあります。 知識をルールと記号で書き下せば知能が作れる、という発想でエキスパートシステムが盛んに作られましたが、 書き下すべき常識の量が爆発して破綻しました。
Harnad の指摘は、量の問題ではないというものでした。 どれだけルールを増やしても、記号は別の記号でしか定義されない。 外界と結びつく地点がないかぎり、システムは意味を扱っているふりをしているだけだ、と。 これは Searle の「中国語の部屋」(1980)を、AI の設計問題として言い直したものと言えます。
その後の展開は皮肉なものでした。 分散表現とニューラルネットワークの発展で、記号を数値ベクトルに置き換える道が開けた。 「王 − 男 + 女 ≒ 女王」のような演算ができるようになり、 記号の間の関係は、かつてないほど精密に捉えられるようになりました。 しかしそれは、Harnad が問うた「外界との接点」を用意したわけではありません。 問題は解かれたのではなく、より鮮明な形で残ったのです。
現在の議論の焦点は、大規模言語モデルと、画像や音声を同時に扱うマルチモーダルモデルにあります。 画像とテキストを対応づけて学習したモデルは、「犬」という語と犬の見た目を結んでいる。 これを接地と呼んでよいのか。それとも、 人間が付けたラベルの対応を覚えただけで、依然として記号の世界の中にいるのか。 1990 年の問いは、35 年後のいまも同じ形で開いています。
🎨 直感で掴む
🍰 まずはやさしく
言葉が空中に浮いている状態のことです。
AIが実感を伴って理解できるかを探ります。
動物園で本物のシマウマを見る感覚のことです。
直感的にイメージして理解しましょう。
「シマウマ」という文字列を AI に読ませても、 それは「シ」「マ」「ウ」「マ」というバイト列のパターンに過ぎず、 縞模様の実物動物とは結びついていない — これが記号が「接地」していない状態。 一方、 ヒトの子は実物を見て触って「シマウマ」と覚えるので、 言葉が実体に錨を下ろしている。 シンボルグラウンディング問題は「機械は記号をどうやって実体に錨付けできるか?」という AI 哲学の中核問題。
Harnad (1990) が定式化、 Searle の「中国語の部屋」(1980) と一対で頻出する G 検定論点。 GPT-4 等の LLM は文字列だけ大量学習しているので「象は灰色」と答えられるが、 接地が無いという批判は根強い。 一方、 画像・音・身体動作と言語を結ぶマルチモーダル AIはこの問題への部分的解決を試みる現代的アプローチ。
🎨 直感で掴む — 具体例で理解する
辞書で シマウマ を引くと「馬科の白黒縞模様の動物」とある。 だがコンピュータがこれを単なる文字列の組として処理する限り、 縞模様の実物像と結び付かない。 これが 「記号が宙に浮いている」状態。 ヒトの赤ちゃんは身体経験を通じて「シマウマ」を実体に結び付ける。 同様に AI も、 視覚・音声などのマルチモーダル入力と接地(grounding)させない限り、 意味を本当には理解できない、 という主張がシンボルグラウンディング問題の核心。
📐 定義
🍰 まずはやさしく
記号と現実の物を対応させる問題のことです。
AIの基礎知識として正しく定義するために使います。
買い物で商品名と実物を一致させる感覚です。
詳しい定義やルールについて学びましょう。
記号と実世界の意味の対応付け問題
英語名 Symbol Grounding Problem。
📐 数式・定義
シンボルグラウンディング問題を数式 / 形式定義で表す:
記号(Symbol)と現実の指示対象(Referent)を結ぶ写像をどう実装するか、 という未解決問題。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $\text{Symbol}$ | 言語・記号のトークン |
| $\text{Referent}$ | 現実世界での指示対象(物体・出来事) |
| $\xrightarrow{?}$ | 対応関係:身体・感覚・経験を介す必要があるとされる |
🔬 数式を言葉で読み解く(拡張版)
シンボルグラウンディング問題で核となる 4 つの記号系を「日本語の物語」に翻訳します。 接地関数 $G$・記号集合 $\Sigma$・感覚入力 $S$・身体運動 $A$ がどのように関連するかを丁寧に追うと、 「記号は身体のどこに錨を下ろすか」という Harnad の問いかけが立体的に見えてきます。 数式の各記号がどの認知段階に対応するかを意識して読むのがコツです。
- $G : \Sigma \to \mathcal{F}$ — 接地関数(左辺)
- 「記号を感覚運動的特徴に対応づける関数」を表す。 たとえば「リンゴ」というシンボル "apple" を、 視覚的な赤い円形 + 触覚的な硬さ + 味覚的な甘さの特徴ベクトル $\mathcal{F}$ にマップする写像。 LLM では「apple」は語彙表の整数のトークン ID にしか対応しない(=非接地)が、 マルチモーダルモデル(CLIP, Flamingo, GPT-4V)では画像埋め込み空間にマップされる(=部分接地)。 Harnad (1990) はこの関数 $G$ が存在することを「intrinsic meaning」の必要条件とした。
- $\Sigma = \{s_1, s_2, \dots, s_N\}$ — 記号集合(右辺の入力側)
- 語彙・トークン・概念といった離散的なシンボルの有限集合。 GPT-4 では $N \approx$ 100,000 のサブワード語彙、 人間の語彙では $N \approx$ 50,000–100,000 と推定。 SSDSE-B の「都道府県」列は 47 個の固有シンボル(北海道〜沖縄)を含み、 これも一種の $\Sigma$。 各記号はそれ自体には意味がない(中国語の部屋のような状況)。
- $\mathcal{F} \subset \mathbb{R}^d$ — 感覚運動特徴空間(右辺の出力側)
- 記号が「錨を下ろす」先である連続的な特徴空間。 視覚 CNN なら $d=512$(ResNet)や $d=768$(ViT-Base)、 言語埋め込みなら $d=768$(BERT)。 SSDSE-B-2026 の 2023 年度を 47 行 × 109 指標の行列で表すと、 各県を $\mathbb{R}^{109}$ に埋め込めるが、 これは「数値特徴空間」であって本来の「感覚運動特徴空間」とは異なる。 真の接地には身体性(embodiment)と環境との相互作用が必要というのが Harnad の主張。
- $\text{cosine}(G(s_i), G(s_j))$ — 接地度の代理指標
- 接地度を直接測る方法はないため、 意味的に近い記号同士が特徴空間でも近いかをコサイン類似度で測定する。 word2vec analogy(king − man + woman ≈ queen)が代表例。 「リンゴ」と「果物」のコサイン類似度が高ければ概念階層が学習されている。 SSDSE-B 都道府県の家計支出ベクトルでも同様で、 「北海道」と「青森」のコサイン類似度が高ければ「地域性」を捉えている。 ただしこれは記号間の関係を見ているだけで、 記号と外界の対応ではない点に注意。
🔬 Harnad の用語を、 データ分析の言葉に置き換える
記号接地問題の用語は、 表のデータを扱うときの手続きにそのまま対応させられる。 このページの実データの例で並べると次のとおり。
| Harnad の用語 | データ分析での対応 | このページの例 |
|---|---|---|
| 記号(symbol) | 列名・列コード・日常の言葉(「暑い県」「人口」) | B4101、 「若い県」、 「診療所が多い県」 |
| 指示対象(referent) | その記号が指す、 測られた量や県の集合 | 年平均気温の上位 5 県(沖縄県など) |
| 接地(grounding) | 記号を測定手続き(何を・どの単位で・いつ・どう数えるか)に結び付けること | 「暑い=年平均気温 B4101 が高い」と決める |
| 記号どうしの関係だけの世界 | 列名の文字や、 他の列との相関だけから意味を推し量ること | 県名の文字の近さ、 ラベルを入れ替えても変わらない相関 |
| 接地に失敗した状態 | 同じ記号が別の測定を指していることに気づかない状態 | 総人口と日本人人口、 単純平均と全体の比率 |
表の右列はどれも、 記号を決めるだけでは 1 つの値や 1 つの県の集合に決まらず、 測定手続きを明記して初めて決まる例である。 Harnad の問いは「機械の記号が外界に結び付くか」だったが、 データ分析では「分析者の言葉が列と手続きに結び付いているか」という形で毎回問われる。 分析の報告書に「暑い県」と書く前に「年平均気温 B4101 の上位」と言い換えられるかを確かめるのが、 いちばん手軽な接地の検査になる。 言い換えられなければ、 その言葉はまだ記号のままである。
🧮 実値で計算してみる — 記号と意味の距離
シンボルグラウンディング問題は定量計算そのものではなく、 意味の近さを埋め込みベクトルの距離で可視化すると直感が掴めます。 ここでは「犬」「猫」「魚」を単純な特徴ベクトルに置き、 「意味的に近い記号どうしはベクトル空間でも近い」ことを手計算と Python で確認します。 これは分散表現による接地(grounding)の最小例です。
🧮 数式に値を入れて手で計算する: 単語埋め込みと意味距離
合成データで概念 "犬"/"猫"/"魚" の距離を計算する。
Step 1: 埋め込み
Step 2: 距離
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np dog = np.array([0.8, 0.2, 0.1]) cat = np.array([0.7, 0.3, 0.1]) fish = np.array([0.1, 0.1, 0.9]) print(f"d(犬,猫): {np.linalg.norm(dog-cat):.3f}") print(f"d(犬,魚): {np.linalg.norm(dog-fish):.3f}") |
📤 実行結果
💬 手計算 (Step 2) の 0.141 と 1.068 が Python 出力と一致しました。ただし、この 3 次元のベクトルは「犬と猫は似ている」という人間の知識をもとに手で置いた値で、ベクトルの各成分が何を測っているのか(大きさか、陸に住むかか)は決めていません。距離が意味の近さを反映しているのは、置いた人の知識がそのまま入っているからで、ベクトルの側が犬や猫に接地しているわけではありません。成分を「体重」「水中で暮らす時間の割合」のような測定できる量に決め、実物を測って値を入れたときに初めて、ベクトルは測定に接地した表現になります。下の「暑い県」「若い県」は、その測定を実データで行う例です。
この教材のデータで考えてみる
抽象的な話に聞こえますが、手元のデータでも同じことが起きています。
SSDSE-B-2026 の列名 A1101 は、それ自体では何の意味もない記号です。
A1101 が「総人口」を指すと分かるのは、
データセットの外側にある見出し行(2 行目)を人間が読んだからにすぎません。
さらに「総人口」という語も、それだけでは接地していません。 誰を数えるのか(住民票か、常住地か)、いつ時点か、外国人を含むか — こうした定義は統計の説明資料という別の文書にあります。 そしてその文書の語も、また別の語で説明されている。 分析者が数値の意味を理解できるのは、最後のどこかで 「実際に人がそこに住んでいる」という現実に触れているからです。
これは哲学の遊びではなく、実務の落とし穴に直結します。
列名だけを見て A1101 と A1102 を足してしまう、
単位が「人」なのか「千人」なのかを確かめずに比べてしまう、
年度をまたいで定義が変わったことに気づかない —
いずれも「記号を、それが指すものと結び直す作業」を省いたときに起きます。
データ分析における記号接地とは、要するにメタデータを読むことだと言い換えてもよいでしょう。
機械にとっても事情は同じです。列名だけを与えられたモデルは、
A1101 と A1303 の間に相関があることは学べても、
それが「総人口と 65 歳以上人口だから当然」だとは知りません。
だからこそ、外れ値を「珍しい県」ではなく「入力ミス」と判断したり、
比率を取るべきところで差を取ったりする。
意味を知っているのは、いまのところ人間の側だけです。
🧮 実データで確かめる:記号「暑い県」を、どの測定に結び付けるか
上の段落では、列コードや列名が「それだけでは意味を持たない記号」であることを見ました。逆向きに、日常の言葉を測定に結び付けてみます。「暑い県」という記号は、SSDSE-B-2026 のどの列に接地すればよいでしょうか。候補は年平均気温 B4101 と、最高気温 B4102(日最高気温の月平均の最高値、つまり一番暑い月の日中の気温の平均)の 2 つです。まず 5 道県で、2 つの測り方の順位がどれだけ一致するかを、スピアマンの順位相関 $\rho = 1 - \dfrac{6\sum d_i^2}{n(n^2-1)}$ で手計算します($d_i$ は県 $i$ の 2 つの順位の差、$n$ は県の数)。
| Step | 内容 | 値(2023 年度) |
|---|---|---|
| 1 | 5 道県の年平均気温・最高気温 | 沖縄県 23.8℃・32.8℃/鹿児島県 19.5・32.9/富山県 16.1・35.8/新潟県 15.4・35.6/北海道 11.0・30.9 |
| 2 | 年平均気温の順位(高い順) | 沖縄 1・鹿児島 2・富山 3・新潟 4・北海道 5 |
| 3 | 最高気温の順位(高い順) | 富山 1・新潟 2・鹿児島 3・沖縄 4・北海道 5 |
| 4 | 順位の差 d と Σd² | d = −3, −1, 2, 2, 0 → 9 + 1 + 4 + 4 + 0 = 18 |
| 5 | ρ = 1 − 6 × 18 ÷(5 × 24) | 1 − 108 ÷ 120 = 0.10 |
🎯 このコードでやること:Step 1〜5 を Python で再現する。5 道県の 2 列を取り出して県内の順位を付け、順位の差 d から公式で ρ を計算し、scipy.stats.spearmanr の値と比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度の沖縄県・鹿児島県・富山県・新潟県・北海道の B4101(年平均気温)と B4102(最高気温)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from scipy.stats import spearmanr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') five = ['沖縄県', '鹿児島県', '富山県', '新潟県', '北海道'] t = d.loc[five, ['B4101', 'B4102']] t['順位_年平均'] = t['B4101'].rank(ascending=False).astype(int) t['順位_最高'] = t['B4102'].rank(ascending=False).astype(int) t['d'] = t['順位_年平均'] - t['順位_最高'] print(t.to_string()) n = len(t) rho = 1 - 6 * (t['d'] ** 2).sum() / (n * (n ** 2 - 1)) print(f'Σd² = {(t["d"] ** 2).sum()} ρ = 1 − 6×{(t["d"] ** 2).sum()}/({n}×{n ** 2 - 1}) = {rho:.2f}') print(f'scipy.stats.spearmanr: {spearmanr(t["B4101"], t["B4102"])[0]:.2f}') |
📤 実行結果:
💬 結果の読み方:手計算と同じ順位・d・Σd² = 18 が並び、公式の ρ = 0.10 と scipy の 0.10 が一致しました。5 道県の中でも、沖縄県は年平均気温では 1 位なのに最高気温では 4 位で、2 つの「暑さ」はほとんど同じ順に並びません。
次に 47 都道府県すべてで、それぞれの測り方の上位 5 県を比べます。
🎯 このコードでやること:2023 年度 47 都道府県について、年平均気温と最高気温それぞれの上位 5 県、両方に入る県の数、2 列の相関係数と順位相関、沖縄県の 2 つの順位を表示する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の B4101(年平均気温、℃)と B4102(最高気温、℃)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from scipy.stats import spearmanr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 2023 年度 47 都道府県 mean_t, max_t = d['B4101'], d['B4102'] # 年平均気温 / 最高気温 top_mean = list(mean_t.nlargest(5).index) top_max = list(max_t.nlargest(5).index) print('「暑い県」= 年平均気温の上位 5:', '・'.join(top_mean)) print('「暑い県」= 最高気温の上位 5 :', '・'.join(top_max)) print('両方に入る県:', len(set(top_mean) & set(top_max))) print(f'47 県での相関 r = {np.corrcoef(mean_t, max_t)[0, 1]:.3f}、' f'順位相関 ρ = {spearmanr(mean_t, max_t)[0]:.3f}') print(f'沖縄県: 年平均 {mean_t["沖縄県"]}℃ は 1 位、最高気温 {max_t["沖縄県"]}℃ は ' f'{int(max_t.rank(ascending=False, method="min")["沖縄県"])} 位') |
📤 実行結果:
💬 結果の読み方:年平均気温で選ぶと沖縄県・鹿児島県・福岡県・宮崎県・長崎県、最高気温で選ぶと富山県・新潟県・京都府・埼玉県・福井県で、両方に入る県は 0 でした。47 県の相関は r = −0.063、順位相関は ρ = −0.310 で、むしろ逆向きです。沖縄県は年平均 23.8℃ で 1 位ですが、最高気温 32.8℃ は 40 位です。海に囲まれて一年中暖かいが真夏の日中はそれほど上がらない県と、冬は寒いが盆地や日本海側で真夏に気温が上がる県が、どちらも「暑い県」と呼ばれうるということです。
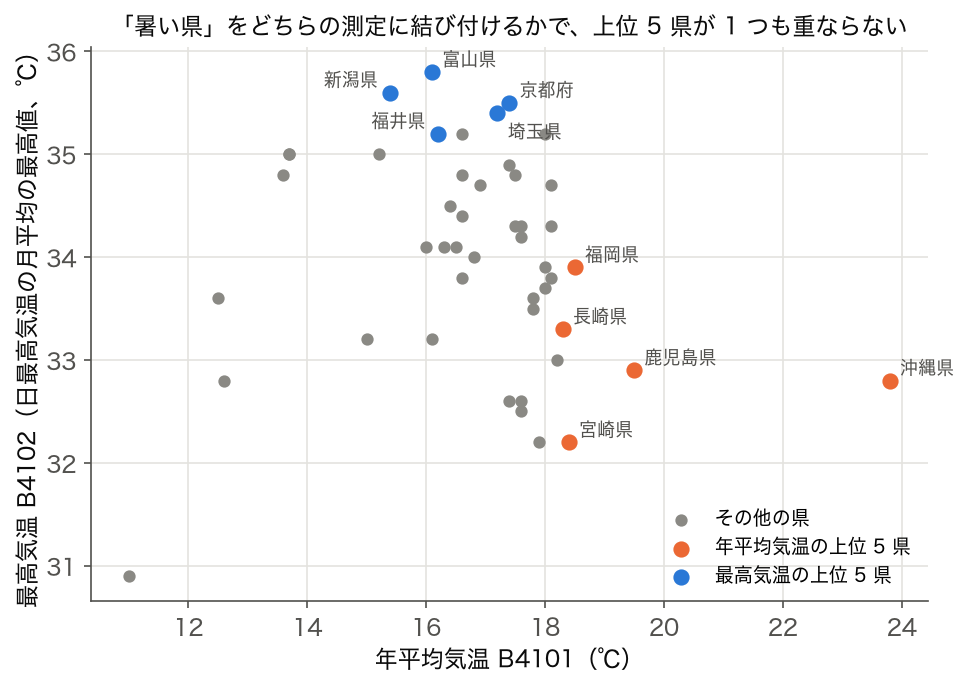
→ 「暑い県」という記号は、それをどの測定手続きに結び付けるかを決めるまで、指す県の集合すら定まりません。データ分析で言葉を使うときは、「暑い=年平均気温が高い」のように接地先の列と向きを明記するのが、記号接地を実務で果たす最小の手続きです。
🧮 実データで確かめる:「若い県」を 3 通りに接地すると、東京都は 1 位にも最下位にもなる
もう 1 つ、「若い県」を考えます。年齢構成で言うなら年少人口割合(15 歳未満人口 A1301 ÷ 総人口 A1101)が高い県、あるいは高齢化率(65 歳以上人口 A1303 ÷ 総人口)が低い県、将来の若さで言うなら合計特殊出生率 A4103 が高い県、と少なくとも 3 通りの接地先があります。
🎯 このコードでやること:2023 年度 47 都道府県を、年少人口割合(高い順)・合計特殊出生率(高い順)・高齢化率(低い順)の 3 通りで順位付けし、それぞれの上位 5 県、3 つすべてで上位 5 に入る県、東京都の順位、3 つの順位どうしのスピアマン相関を表示する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A1301(15 歳未満人口)・A1303(65 歳以上人口)・A1101(総人口)・A4103(合計特殊出生率)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') defs = { '年少人口割合': (d['A1301'] / d['A1101'] * 100, False), # 高いほど若い '合計特殊出生率': (d['A4103'], False), # 高いほど若い '高齢化率': (d['A1303'] / d['A1101'] * 100, True), # 低いほど若い } rank = pd.DataFrame({k: v.rank(ascending=asc, method='min').astype(int) for k, (v, asc) in defs.items()}) for k in rank: print(f'「若い県」= {k} の上位 5: ' + '・'.join(rank[k].nsmallest(5).index)) print('3 つすべてで上位 5 に入る県:', '・'.join(rank.index[(rank <= 5).all(axis=1)])) print('東京都の順位:', rank.loc['東京都'].to_dict()) print('順位の相関(スピアマン):') print(rank.corr(method='spearman').round(3).to_string()) |
📤 実行結果:
💬 結果の読み方:3 つすべてで上位 5 に入るのは沖縄県だけです。東京都は高齢化率が最も低いので「若さ」1 位ですが、年少人口割合では 38 位、合計特殊出生率では 47 位(最下位)です。働く世代が多く流入して高齢者の割合は低いが、子どもの割合も出生率も低い、という構成だからです。順位どうしの相関を見ると、合計特殊出生率と高齢化率(低い順)の順位は ρ = −0.273 と、同じ「若い」を名乗りながら逆向きになっています。
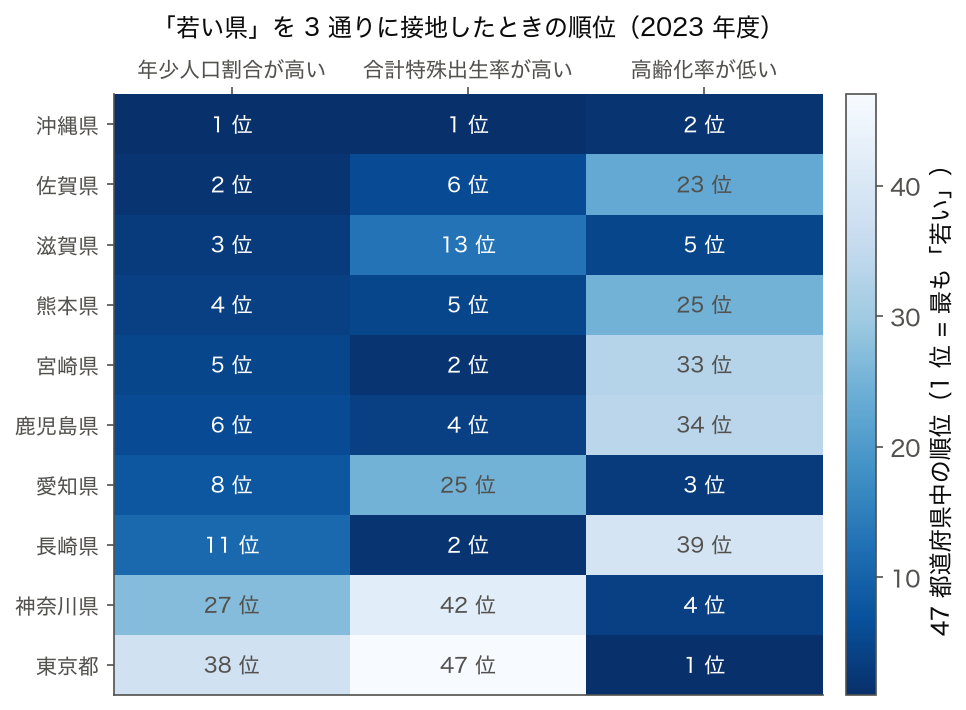
→ 記号接地問題は、記号がそれ自体では意味を持たないという主張でした。データ分析では、これが「同じ言葉が、接地先の列を変えると別の県を指す」という形で目に見えます。レポートの見出しに「若い県」と書くなら、どの列で測ったかを同じ文の中に書き、ほかの接地先で結論が変わるかを確かめておきます。
🧮 記号の形の近さと、指すものの近さ:県名の文字と県のデータ
上の犬・猫・魚の例では、埋め込みベクトルを「意味が近いものは近くなる」ように手で置きました。実際には、記号の形(文字の並び)が似ていても、指しているもの(指示対象)が似ているとは限りません。47 都道府県の名前(「都・道・府・県」を除いた部分)の文字の重なりと、各県を測定値で表したベクトル(高齢化率・年少人口割合・合計特殊出生率・年平均気温・人口千人あたり死亡数の 5 指標の z 得点)の距離を比べます。
🎯 このコードでやること:県名の文字集合のジャカード係数で「名前が近い県」を、5 指標の z 得点ベクトルのユークリッド距離で「データが近い県」を、福島県・石川県・山形県について 3 つずつ挙げる。全 1,081 ペアについて、県名に共通の文字がある組とない組のデータの距離の中央値も比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A1101・A1301・A1303・A4103・B4101・A4200 から作った 5 指標(割合・人口あたりに直したもの)と、都道府県名の文字列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # (1) 記号の形だけ: 県名(「都・道・府・県」を除く)の文字の重なり(ジャカード係数) stem = {p: set(p[:-1]) if p != '北海道' else set('北海道') for p in d.index} def name_sim(a, b): return len(stem[a] & stem[b]) / len(stem[a] | stem[b]) # (2) 測定に接地: 人口あたり・割合の 5 指標を z 得点にしたベクトルの距離 X = pd.DataFrame({ '高齢化率': d['A1303'] / d['A1101'], '年少人口割合': d['A1301'] / d['A1101'], '合計特殊出生率': d['A4103'], '年平均気温': d['B4101'], '人口千人あたり死亡数': d['A4200'] / d['A1101'] * 1000, }) Z = (X - X.mean()) / X.std() def data_dist(a, b): return float(np.linalg.norm(Z.loc[a] - Z.loc[b])) for p in ['福島県', '石川県', '山形県']: others = [q for q in d.index if q != p] by_name = [q for q in sorted(others, key=lambda q: -name_sim(p, q)) if name_sim(p, q) > 0][:3] by_data = sorted(others, key=lambda q: data_dist(p, q))[:3] print(f'{p} 名前が近い: ' + '・'.join(f'{q}({data_dist(p, q):.2f})' for q in by_name) + ' データが近い: ' + '・'.join(f'{q}({data_dist(p, q):.2f})' for q in by_data)) pairs = [(a, b) for i, a in enumerate(d.index) for b in d.index[i + 1:]] all_d = np.array([data_dist(a, b) for a, b in pairs]) share = np.array([name_sim(a, b) > 0 for a, b in pairs]) print(f'(括弧内はデータの距離。全 {len(pairs)} ペアの中央値 {np.median(all_d):.2f})') print(f'県名に共通の文字があるペア {share.sum()} 組の距離の中央値 {np.median(all_d[share]):.2f}、' f'共通の文字が無いペア {(~share).sum()} 組 {np.median(all_d[~share]):.2f}') |
📤 実行結果:
💬 結果の読み方:福島県と名前の近い福井県・島根県・広島県はデータの距離が 2.30〜2.45 で、全ペアの中央値 2.43 と変わらず、似ていません。データで最も近いのは新潟県(0.28)・山形県(1.07)で、名前の文字は共有していません。石川県と「川」を共有する香川県は 1.13 とやや近いものの、データで最も近いのは岡山県(0.46)です。県名に共通の文字がある 44 組のデータの距離の中央値は 2.20、ない 1,037 組は 2.46 で、文字の重なりは指すものの近さをほとんど教えてくれません。
→ 記号の形だけを材料にするシステムが「福島県は福井県に似ている」と結論しても、それは記号の世界の中の近さにすぎません。福島県が新潟県・山形県と似ているという知識は、各県を測定値に結び付けた(接地した)ときに初めて得られます。大規模言語モデルが学ぶのは記号どうしの共起の関係で、共起は指示対象の近さをある程度反映しますが、この例のように形の上の近さだけが先に立つこともあります。
🧮 記号「平均」は、 何を 1 単位に数えるかで指す値が変わる
🎯 このコードでやること:「日本の高齢化率」という 1 つの記号を、 47 都道府県の高齢化率の単純平均に接地した場合と、 65 歳以上人口の合計を総人口の合計で割った値に接地した場合で、 値と「平均より高い県」の数がどう変わるかを 2023 年度で確かめる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] rate = d['A1303'] / d['A1101'] * 100 # 記号「日本の高齢化率」の 2 つの接地先 print(f'47 県の高齢化率の単純平均 : {rate.mean():.2f}% (平均的な「県」)') print(f'65 歳以上の合計 ÷ 総人口の合計 : {d["A1303"].sum() / d["A1101"].sum() * 100:.2f}% (平均的な「住民」)') print(f'47 県の高齢化率の中央値 : {rate.median():.2f}%') # どちらの「平均」より高い県が何県あるか m1, m2 = rate.mean(), d['A1303'].sum() / d['A1101'].sum() * 100 print('単純平均より高い県:', int((rate > m1).sum()), ' 全体の比率より高い県:', int((rate > m2).sum())) lo = d.loc[rate.nsmallest(3).index, 'Prefecture'].tolist() print('高齢化率が低い 3 県:', lo, '→ 総人口の合計に占める割合', f"{d.loc[rate.nsmallest(3).index, 'A1101'].sum() / d['A1101'].sum() * 100:.1f}%") |
💬 同じ「日本の高齢化率」でも、 県を 1 つずつ数える単純平均は 31.59%、 人を 1 人ずつ数える全体の比率は 29.13% で、 2.46 ポイント違う。 高齢化率の低い東京都・沖縄県・愛知県だけで総人口の 18.5% を占め、 人口の多い県ほど高齢化率が低いため、 人で数えると値が下がる。 「平均より高い県」も、 単純平均を基準にすると 26 県、 全体の比率を基準にすると 38 県になる。 記号「平均」は「何を 1 単位として数えるか」を決めて初めて 1 つの値を指す。
🧮 記号「多い」は、 絶対数か人口あたりかで指す県が変わる
🎯 このコードでやること:「診療所が多い県」という記号を、 一般診療所の件数(I5102)に接地した場合と、 人口 10 万人あたりの件数に接地した場合で、 上位 5 県と東京都の順位を比べる(2023 年度)
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') per = d['I5102'] / d['A1101'] * 100000 # 人口 10 万人あたり # 記号「診療所が多い県」の 2 つの接地先 print('件数の上位 5 :', d['I5102'].nlargest(5).index.tolist()) print('人口10万人あたり上位 5:', per.nlargest(5).round(1).to_dict()) print('両方に入る県:', sorted(set(d['I5102'].nlargest(5).index) & set(per.nlargest(5).index))) print(f"東京都: 件数 {d.loc['東京都','I5102']:,} 件(1 位)/ 10 万人あたり {per['東京都']:.1f} 件({int(per.rank(ascending=False)['東京都'])} 位)") print('件数と 10 万人あたりの順位相関:', round(d['I5102'].rank().corr(per.rank()), 3)) |
💬 件数で数えると上位 5 は東京都・大阪府・神奈川県・愛知県・兵庫県と人口の多い順にほぼ並ぶが、 人口 10 万人あたりでは和歌山県 113.0・島根県 106.0・東京都 105.7・長崎県 103.9・大阪府 101.3 になり、 両方に入るのは東京都と大阪府だけ。 47 県の順位相関は −0.082 で、 2 つの「多い」はほとんど無関係な並びになる。 「多い」は絶対数か、 人口あたりか(あるいは面積あたりか)を決めるまで、 どの県を指すかが決まらない記号である。
🧮 記号「雨が多い」は、 量で測るか日数で測るかで指す県が変わる
🎯 このコードでやること:記号「雨が多い県」を、 年間降水量(B4109、 mm)に接地した場合と、 年間降水日数(B4106、 日)に接地した場合で、 上位 5 県と順位相関を比べる(2023 年度)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 記号「雨が多い県」の 2 つの接地先: 年間降水量(mm)と 年間降水日数(日) amt, days = d['B4109'], d['B4106'] print('降水量の上位 5 :', amt.nlargest(5).to_dict()) print('降水日数の上位 5:', days.nlargest(5).to_dict()) print('両方に入る県:', sorted(set(amt.nlargest(5).index) & set(days.nlargest(5).index))) print('47 県の順位相関:', round(amt.rank().corr(days.rank()), 3)) for p in ['高知県', '秋田県']: print(f'{p}: 降水量 {amt[p]:,.0f} mm({int(amt.rank(ascending=False)[p])} 位)' f' / 降水日数 {days[p]:.0f} 日({int(days.rank(ascending=False)[p])} 位)') # 1 日あたりの降り方(降水量 ÷ 降水日数) per_day = amt / days print('1 降水日あたりの降水量 上位 3:', per_day.nlargest(3).round(1).to_dict()) |
💬 降水量で選ぶと宮崎県・高知県・鹿児島県・福井県・富山県、 降水日数で選ぶと青森県・秋田県・福井県・富山県・石川県で、 両方に入るのは福井県と富山県の 2 県だけ。 47 県の順位相関は 0.573 で、 「暑い県」の 2 つの測り方(ρ = −0.310)ほど食い違わないが、 同じとも言えない。 高知県は降水量 2 位なのに降水日数は 15 位、 秋田県は降水量 9 位で降水日数 2 位と、 「一度にたくさん降る県」と「降る日が多い県」は別物である。 1 降水日あたりでは静岡県 25.6 mm・宮崎県 25.4 mm が上位に来る。
🧮 記号「東日本」は、 どこで線を引くかで差の大きさが倍になる
🎯 このコードでやること:記号「東日本」を、 都道府県番号 1〜15(北海道〜新潟県)に接地した場合と、 1〜23(北海道〜愛知県、 中部まで含める)に接地した場合で、 東西の平均高齢化率の差を比べる(2023 年度)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 code = d['Code'].str[1:3].astype(int) # 都道府県番号 1〜47 # 記号「東日本」の 2 つの接地先 east_a = code <= 15 # 北海道〜新潟(北海道・東北・関東・新潟) east_b = code <= 23 # 北海道〜愛知(中部まで含める) for name, e in [('東日本 = 1〜15 番(北海道〜新潟)', east_a), ('東日本 = 1〜23 番(北海道〜愛知)', east_b)]: m_e, m_w = d.loc[e, '高齢化率'].mean(), d.loc[~e, '高齢化率'].mean() print(f'{name}: 東 {int(e.sum())} 県 {m_e:.2f}% / 西 {int((~e).sum())} 県 {m_w:.2f}% / 差 {m_e - m_w:+.2f}') |
💬 1〜15 番で区切ると東 15 県 31.31%・西 32 県 31.71% で差は −0.40 ポイント、 1〜23 番で区切ると東 23 県 31.18%・西 24 県 31.97% で差は −0.79 ポイントと、 同じ「東西の差」が倍になる。 どちらも「西のほうが高い」向きは同じだが、 差の大きさを報告するなら、 「東日本」がどの県を指すかを本文に書かないと、 他の分析と数値を比べられない。 このサイトの検出力のページや調査データのページは 1〜23 番(23 都道県)で区切っている。
🐍 Python 実装
シンボルグラウンディング問題を実装で考えるときの中心は、 「記号(単語・文)の意味を実数ベクトルで表し、 意味の近さを距離・類似度で測る」ことです。 マルチモーダルモデル(CLIP など)はこのベクトルを画像・音とも結びつけ、 接地に一歩近づけます。 以下は文埋め込み(Sentence-BERT)で意味の近さを測る最小例です。
🐍 文埋め込みで文の近さを測る(外部モデルが必要)
シンボルグラウンディング問題を実装で考えるには、 「単語の意味」を実数ベクトルとして表現する Word Embedding(GloVe / Sentence-BERT)が直接的なアプローチです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | from sentence_transformers import SentenceTransformer from sklearn.metrics.pairwise import cosine_similarity # 多言語対応のモデルで日本語の文意ベクトルを取得 model = SentenceTransformer('paraphrase-multilingual-mpnet-base-v2') sentences = [ 'リンゴは赤い果物です', '果物の中でリンゴは甘い', '東京は日本の首都です', '私は犬を飼っています', ] emb = model.encode(sentences) print('Embedding shape:', emb.shape) # (4, 768) sim = cosine_similarity(emb) for i, s1 in enumerate(sentences): for j, s2 in enumerate(sentences): if i < j: print(f'{s1[:10]} vs {s2[:10]}: {sim[i,j]:.3f}') |
💬 s1[:10] は先頭 10 文字なので、11 文字の「果物の中でリンゴは甘い」だけ末尾が切れ、他の 3 文は全文が表示される。リンゴと果物の 2 文の類似度が他の組より高く出れば「意味の近い文が近いベクトルになった」と読めるが、この埋め込み空間は大量のテキストから「他の語との共起関係」を学習したもので、リンゴを見たり食べたりした経験とは結びついていない。真の「身体的接地」はまだ達成されておらず、マルチモーダルモデル(CLIP, Flamingo)が一歩進めている段階である。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「シンボルグラウンディング問題」を実務・試験で扱うときに頻発する典型的なミスです。 各項目を 1 度読んでおけば 9 割の事故が防げます:
3 つの立場 — 「接地していない」と言えるのはどこまでか
この問題には決着がついていません。議論を整理すると、おおむね次の 3 つに分かれます。 どれが正しいかより、自分がどの立場で話しているかを自覚することが実務では大事です。
| 立場 | 主張 | 弱いところ |
|---|---|---|
| 身体が要る | 感覚と運動を通して外界に触れないかぎり、記号は接地しない。 | 「触れている」の線引きが曖昧。カメラ入力は身体か。 |
| 関係だけで足りる | 記号どうしの関係が十分に豊かなら、意味は関係の中に現れる。 | 辞書の循環をどれだけ精密にしても、外界には出られない。 |
| 問いが悪い | 「理解しているか」は観測できない。できることで測ればよい。 | 説明責任や安全性の議論を、測定の話にすり替えてしまう。 |
データ分析の実務では、3 つめの立場が現実的です。 モデルが「理解している」かどうかは脇に置き、 どういう入力で正しく振る舞い、どういう入力で崩れるかを測る。 ただし 1 つめの視点も捨てられません。 学習データに一度も現れなかった状況で、モデルの出力が意味をなさなくなるのは、 記号の間の関係しか持っていないことの現れだからです。
実務での落としどころは、「接地していない前提で設計する」ことです。 モデルの出力に定義や単位の判断を任せない。外れ値の意味づけは人が行う。 ドメイン知識は、モデルに期待するのではなく前処理と検証のルールとして外側に書く。 シンボルグラウンディング問題を知っている分析者と知らない分析者の差は、 この設計判断にいちばんはっきり出ます。
⚠️ 実データで見る落とし穴:同じ記号「総人口」でも、年度によって指すものが違う
記号 A1101(総人口)は 12 年度すべて同じ列コード・同じ列名ですが、指している数え方は同じでしょうか。総人口は本来「年齢 3 区分(15 歳未満 A1301・15〜64 歳 A1302・65 歳以上 A1303)の合計」と一致するはずなので、その差を 564 行すべてで調べます。
🎯 このコードでやること:564 行(47 都道府県 × 12 年度)それぞれで「年齢 3 区分の合計 − 総人口」を計算し、年度ごとに差の合計・最小値・差が 0 でない県の数と、総人口が千人単位(1,000 の倍数)になっている県の数を集計する。
📥 入力データ:SSDSE-B-2026 の全 564 行の A1101(総人口)・A1301・A1302・A1303(年齢 3 区分の人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['差'] = df['A1301'] + df['A1302'] + df['A1303'] - df['A1101'] # 年齢 3 区分の合計 − 総人口 df['千の倍数'] = df['A1101'] % 1000 == 0 g = df.groupby('SSDSE-B-2026').agg(差の合計=('差', 'sum'), 差の最小=('差', 'min'), 差が0でない県=('差', lambda s: int((s != 0).sum())), 総人口が千人単位=('千の倍数', 'sum')) print(g.to_string()) k = df['差'].idxmin() r = df.loc[k] print(f"最も差が大きい行: {r['SSDSE-B-2026']} 年度 {r['Prefecture']} 総人口 {r['A1101']:,} 人、" f"年齢 3 区分の合計との差 {r['差']:,} 人({r['差'] / r['A1101']:.2%})") |
📤 実行結果:
💬 結果の読み方:2021〜2023 年度は差が ±1,000 人以内(千人単位に丸めた誤差)ですが、2015 年度と 2020 年度だけは 47 県すべてで年齢 3 区分の合計が総人口より少なく、2020 年度の東京都では 428,739 人(総人口の 3.05%)足りません。この 2 年度だけは総人口が 1 人単位で、千人単位になっている県が 0 です。国勢調査の年の値で、年齢が「不詳」の人は総人口には数えられても、年齢 3 区分のどこにも入らないためと考えられます。2016〜2019 年度も差がしだいに広がります。
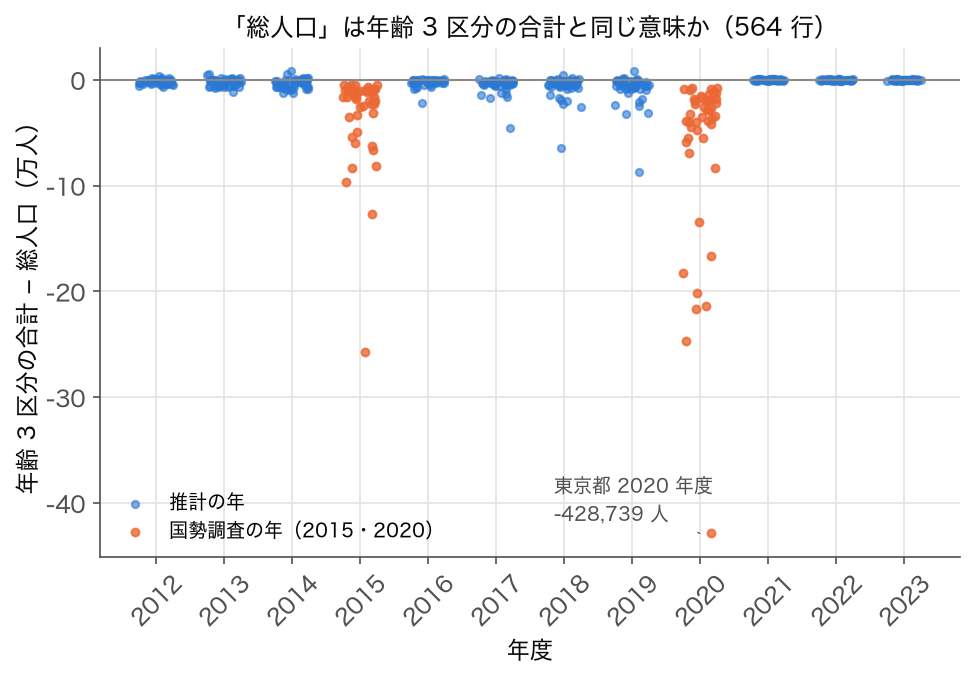
→ 同じ記号 A1101 が、国勢調査の年と推計の年とで少しずつ違う数え方の値を指しています。「2020 年度の高齢化率 = A1303 ÷ A1101」を 2019 年度と比べると、分母に年齢不詳の人が入るかどうかの違いまで変化に混ざります。記号が同じでも中身の定義が同じとは限らないので、年度をまたぐ比較の前に、SSDSE の解説資料で各年度の出典(国勢調査か人口推計か)を確かめ、このような整合性の検査を 1 回走らせておきます。
⚠️ 記号どうしの関係だけでは、ラベルの入れ替えに気づけない
列の記号(列コード)だけを頼りに動く処理は、記号と中身の対応が崩れても動き続けます。15 歳未満人口 A1301 と 65 歳以上人口 A1303 の列名だけを入れ替えたデータを作り、「記号どうしの関係」を見る検査と、「外の世界の知識」に接地した検査のどちらが気づくかを比べます。
🎯 このコードでやること:2023 年度のデータの A1301 と A1303 の列名を入れ替え、列コードで高齢化率を計算する処理・年齢 3 区分の合計の検査・「65 歳以上 > 15 歳未満」と「高齢化率と人口あたり死亡数の相関は正」という 2 つの知識による検査を、正しいデータと入れ替えたデータの両方に当てる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A1101・A1301・A1302・A1303・A4200(死亡数)。入れ替えたデータは列名を変えただけで、数値は同じ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) bad = d.rename(columns={'A1301': 'A1303', 'A1303': 'A1301'}) # 列の記号だけを入れ替えたデータ def pipeline(t): # 記号(列コード)だけを頼りに動く処理 aging = t['A1303'] / t['A1101'] * 100 return aging.mean(), t.loc[aging.idxmax(), 'Prefecture'] def check_sum(t): # 記号どうしの関係だけを見る検査: 3 区分の合計 ≈ 総人口 return bool(((t['A1301'] + t['A1302'] + t['A1303'] - t['A1101']).abs() <= 1000).all()) def check_world(t): # 外の知識に接地した検査 older = bool((t['A1303'] > t['A1301']).all()) # 2023 年の日本では 65 歳以上 > 15 歳未満 r_death = np.corrcoef(t['A1303'] / t['A1101'], t['A4200'] / t['A1101'])[0, 1] return older, r_death # 高齢者が多い県ほど人口あたり死亡数が多いはず for name, t in [('正しいデータ', d), ('記号を入れ替えたデータ', bad)]: m, top = pipeline(t) older, r = check_world(t) print(f'{name}: 高齢化率の平均 {m:.2f}%・最大 {top} / 合計の検査 {check_sum(t)} / ' f'65歳以上>15歳未満 {older} / 高齢化率と死亡率の r = {r:+.3f}') |
📤 実行結果:
💬 結果の読み方:入れ替えたデータでも処理はエラーなく動き、高齢化率の平均 11.47%・最も高いのは沖縄県、というもっともらしい答えを返しました(正しくは 31.59%・秋田県)。年齢 3 区分の合計の検査は True のままです。足し算は順番を入れ替えても変わらないので、記号どうしの関係だけでは入れ替えを検出できません。気づけたのは、「2023 年の日本では 65 歳以上の方が 15 歳未満より多い」(False になった)と、「高齢者の割合が高い県ほど人口あたりの死亡数が多い」(r が +0.972 から −0.464 に反転)という、記号の外にある世界についての知識を使った検査だけでした。
→ これはデータ分析版の記号接地問題です。記号の体系の中だけで整合性を確かめても、記号が現実の何に対応しているかは保証されません。前処理の検証には、合計や範囲の検査に加えて、「東京都の総人口は最大のはず」「高齢化率は 20〜40% 程度のはず」のように現実に接地した期待値を 2〜3 個入れておくと、このような取り違えを早い段階で止められます。
⚠️ 「東京都の総人口」はまだ 1 つの値を指していない
記号が指すものを決めるには、何を測るか(列)だけでなく、いつの値かも要ります。SSDSE-B-2026 は 47 都道府県 × 12 年度の 564 行なので、「東京都」という記号は 12 行に現れます。
🎯 このコードでやること:564 行から東京都の 12 行を取り出して年度順に並べ、総人口の候補の範囲と、年度を指定せずに先頭の 1 行を取ったときに返る値を表示する。
📥 入力データ:SSDSE-B-2026 の全 564 行の年度列 SSDSE-B-2026・Prefecture・A1101(総人口)。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') # 新しい年度が先に並ぶので並べ直す print(f'「東京都」の行数: {len(tokyo)}') print(tokyo[['SSDSE-B-2026', 'A1101']].to_string(index=False)) print(f'「東京都の総人口」の候補: {tokyo["A1101"].min():,} 〜 {tokyo["A1101"].max():,} 人' f'(差 {tokyo["A1101"].max() - tokyo["A1101"].min():,} 人)') print('年度を指定せずに引くと:', df.loc[df['Prefecture'] == '東京都', 'A1101'].iloc[0], '人(先頭行=', df.loc[df['Prefecture'] == '東京都', 'SSDSE-B-2026'].iloc[0], '年度)') |
📤 実行結果:
💬 結果の読み方:「東京都の総人口」の候補は 2012 年度の 13,234,000 人から 2023 年度の 14,086,000 人まで 12 個あり、差は 852,000 人(鳥取県の総人口 537,000 人より大きい)です。年度を指定せずに先頭の行を取ると、CSV が新しい年度から並んでいるので 2023 年度の値が返りますが、それはファイルの並び順という偶然で決まっているだけです。年度で並べ替えたあとで同じことをすれば 2012 年度の値になります。質問や見出しの「東京都の総人口」を 1 つの値に接地するには、「2023 年度の」まで言う必要があります。
⚠️ 単位「人」の後ろに隠れている精度
列名の単位は「人」でも、値がどこまで正確かは記号からは分かりません。図 3 で見たように、国勢調査の年以外の総人口は千人単位に丸められています。丸めた 2 つの年度の値の差を取ると、真の増減から最大で ±1,000 人ずれえます。
🎯 このコードでやること:564 行のうち総人口が 1,000 の倍数になっている行を数え、2022 → 2023 年度の各県の増減について、丸めによる ±1,000 人の幅が増減の何割にあたるかを計算する。
📥 入力データ:SSDSE-B-2026 の全 564 行の A1101(総人口)。増減は 2023 年度の値 − 2022 年度の値。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(f'総人口 A1101 が 1,000 の倍数の行: {(df["A1101"] % 1000 == 0).sum()} / {len(df)}') w = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A1101') chg = w[2023] - w[2022] # 1 年間の増減(人) # 千人単位に丸めた 2 つの値の差は、真の差から最大 ±1,000 人ずれうる rel = 1000 / chg.abs() print(f'2022→2023 年度の増減が ±1,000 人の丸めに対して小さい県(|増減| < 5,000 人): ' f'{(chg.abs() < 5000).sum()} 県') for p in chg.abs().nsmallest(3).index: if chg[p] == 0: print(f' {p}: 増減 {chg[p]:+,} 人 → 真の増減は -1,000〜+1,000 人のどこか(増えたか減ったかも決まらない)') else: print(f' {p}: 増減 {chg[p]:+,} 人 → 丸めによる幅 ±1,000 人は増減の ±{rel[p]:.0%}') print(f'増減の絶対値の中央値 {chg.abs().median():,.0f} 人(丸めの幅はその ±{1000 / chg.abs().median():.0%})') |
📤 実行結果:
💬 結果の読み方:564 行中 470 行(国勢調査の 2015・2020 年度以外のすべて)が 1,000 の倍数です。2022 → 2023 年度の増減の中央値は 14,000 人なので、丸めの幅 ±1,000 人は多くの県では ±7% 程度ですが、沖縄県は増減がちょうど 0 人で、実際には増えたのか減ったのかも決められません。滋賀県(−2,000 人)では ±50%、神奈川県(−3,000 人)では ±33% の幅があります。「沖縄県は人口が横ばい」「神奈川県は 3,000 人減」といった記述は、千人単位という測定の精度に接地して読むと、ここまでしか言えないということです。
まとめ:1 つの数値を「接地」させるために確かめる 4 点
| 確かめること | 省いたときに起きたこと(このページの実測) | 確かめ方 |
|---|---|---|
| どの測定か(列) | 「暑い県」の上位 5 県が、年平均気温と最高気温で 1 つも重ならない | 言葉と列コードの対応を文中に書く |
| いつの値か(年度) | 「東京都の総人口」の候補が 12 個、差は 852,000 人 | 年度で絞ってから 1 行にする |
| どう数えたか(定義) | 2020 年度の東京都は年齢 3 区分の合計が総人口より 428,739 人少ない | 合計・内訳の整合性を検査し、出典を解説資料で確かめる |
| どこまで正確か(精度) | 沖縄県の 1 年の増減 0 人は、増えたか減ったかも決まらない | 丸めの単位を確かめ、差の幅を添えて書く |
📝 理解度チェック — 実データで確かめるクイズ
| # | 問題 | 答えと考え方 |
|---|---|---|
| Q4 | 5 道県の順位の差が d = −3, −1, 2, 2, 0 のとき、スピアマンの順位相関 ρ は。 | Σd² = 18、ρ = 1 − 6 × 18 ÷(5 × 24)= 0.10。2 つの「暑さ」の順位はほとんど一致しない。 |
| Q5 | 「子どもが多い県」という記号を列に接地するとき、年少人口 A1301(人数)と年少人口割合(A1301 ÷ A1101)で上位の県はどう変わると予想できるか。 | 人数なら総人口の多い東京都・神奈川県・大阪府などが上位になり、割合なら沖縄県・佐賀県・滋賀県が上位になる(2023 年度)。「多い」が量か割合かを決めないと記号は接地しない。 |
| Q6 | 2020 年度の東京都で年齢 3 区分の合計が総人口より 428,739 人少なかった。この年度の東京都の高齢化率を A1303 ÷ A1101 と A1303 ÷(A1301 + A1302 + A1303)で計算すると、どちらが高くなるか。 | 分母が小さい後者の方が高くなる(年齢不詳の人を除いた割合)。どちらを「高齢化率」と呼ぶかを決めて明記する。 |
| Q7 | 列名を入れ替えても「年齢 3 区分の合計 = 総人口」の検査が通ってしまうのはなぜか。入れ替えに気づくにはどんな検査を足せばよいか。 | 足し算は項の順番によらないので、ラベルが入れ替わっても合計は同じだから。「65 歳以上 > 15 歳未満」や「高齢化率と死亡率は正の相関」のように、記号の外の現実に基づく非対称な期待値を検査に加える。 |
| Q8 | 2022 → 2023 年度の沖縄県の総人口の増減は 0 人だった。「沖縄県の人口は横ばい」と書いてよいか。 | 両年度とも千人単位に丸めた値なので、真の増減は −1,000〜+1,000 人のどこかで、増えたか減ったかも決められない。「千人単位の推計では増減なし」と精度を添えて書くのが正確。 |
| Q9 | 2023 年度の「日本の高齢化率」を 47 県の単純平均で出すと 31.59%、 65 歳以上人口の合計 ÷ 総人口の合計で出すと 29.13% だった。 どちらが「日本に住む人のうち高齢者の割合」か。 | 合計どうしの比 29.13%。 単純平均は人口 54 万人の鳥取県も 1,409 万人の東京都も同じ 1 票で数える「平均的な県」の値で、 高齢化率の低い大都市の重みが小さくなるぶん高く出る。 |
| Q10 | 一般診療所の件数では 1 位の東京都は、 人口 10 万人あたりでは何位か。 件数と 10 万人あたりの順位相関はいくつだったか。 | 3 位(105.7 件)。 順位相関は −0.082 で、 2 つの「多い」はほぼ無関係な並びになる。 |
| Q11 | 2022→2023 年度の東京都の人口増加は、 総人口で +48,000 人、 日本人人口で +5,000 人だった。 「東京都の人口が増えた」の中身をどう書くべきか。 | 増加の約 9 割は日本人以外の人口による。 「総人口では増えた(日本人人口の増加は 5,000 人)」のように、 どの人口かを書き分ける。 |
| Q12 | 「雨が多い県」を降水量で選ぶと宮崎県・高知県など、 降水日数で選ぶと青森県・秋田県など。 高知県が降水量 2 位なのに降水日数 15 位なのはなぜか。 | 1 回に降る量が多く、 降る日数はそれほど多くないから。 1 降水日あたりの降水量は 23.8 mm で上位 3 位に入る。 |
| Q13 | SSDSE-B-2026 に groupby('Prefecture').last() を使って「最新の総人口」を取ったら、 東京都が 13,234,000 人になった。 何が起きたか。 | 各県の行は新しい年度から並んでいるので、 最後の行は 2012 年度。 「最新」を行の順番ではなく年度の列(最大の年度)で決める。 |
⚠️ 記号「人口」は総人口か日本人人口か — 「増えた県」の数まで変わる
🎯 このコードでやること:記号「人口」を総人口(A1101)と日本人人口(A1102)のどちらに接地するかで、 日本人以外の割合と「前年より人口が増えた県」の数がどう変わるかを 2012〜2023 年度で数える
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d22 = df[df['SSDSE-B-2026'] == 2022].set_index('Prefecture') d23 = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 記号「人口」の 2 つの接地先: 総人口 A1101 と 日本人人口 A1102 gap = (d23['A1101'] - d23['A1102']) / d23['A1101'] * 100 print('総人口に占める日本人以外の割合(2023 年度)上位 5:') print(gap.nlargest(5).round(2).to_string()) print(f'47 県合計: {(d23["A1101"].sum() - d23["A1102"].sum()) / d23["A1101"].sum() * 100:.2f}%') # 「人口が増えた県」はどちらに接地するかで変わる up_total = (d23['A1101'] > d22['A1101']) up_jp = (d23['A1102'] > d22['A1102']) print('2022→2023 年度に「人口が増えた県」') print(' 総人口で数える :', up_total[up_total].index.tolist()) print(' 日本人人口で数える:', up_jp[up_jp].index.tolist()) print('東京都の増減 総人口:', f"{d23.loc['東京都','A1101'] - d22.loc['東京都','A1101']:+,}", ' 日本人人口:', f"{d23.loc['東京都','A1102'] - d22.loc['東京都','A1102']:+,}") # 年度ごとに「前年より増えた県の数」を 2 つの接地先で数える w_t = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A1101') w_j = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A1102') cnt = pd.DataFrame({'総人口で増えた県': (w_t.diff(axis=1) > 0).sum(), '日本人人口で増えた県': (w_j.diff(axis=1) > 0).sum()}).loc[2013:] print(cnt.T.to_string()) |
💬 2023 年度の総人口に占める日本人以外の割合は東京都 4.53%・愛知県 3.77%・群馬県 3.73% で、 47 県合計では 2.54%。 2022→2023 年度に人口が増えた県はどちらで数えても東京都だけだが、 東京都の増加は総人口で +48,000 人、 日本人人口で +5,000 人と、 増加の約 9 割が日本人以外の人口だった。 さらに年度ごとに数えると、 日本人人口で「増えた県」は 2016 年度に 19 県、 2021 年度に 33 県と跳ね上がる。 どちらも国勢調査の年(2015・2020 年度)の翌年で、 国勢調査の値と推計の値では数え方(国籍が分からない人の扱いなど)が違うため、 年をまたいだ差に作り方の違いが混ざっていると考えられる。 記号「人口が増えた」は、 どの人口を、 どの作り方の値どうしで比べたかまで決めて初めて意味を持つ。
⚠️ 記号「進学率」は、 どの段階の卒業者を分母にするかで別の量になる
🎯 このコードでやること:記号「進学率」を、 中学校卒業者のうち進学した人の割合(E3702 ÷ E3701)に接地した場合と、 高等学校卒業者のうち進学した人の割合(E4602 ÷ E4601)に接地した場合で、 値の範囲と上位 5 県を比べる(2023 年度)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 記号「進学率」の 2 つの接地先 hs = d['E3702'] / d['E3701'] * 100 # 中学校卒業者のうち進学者の割合 univ = d['E4602'] / d['E4601'] * 100 # 高等学校卒業者のうち進学者の割合 print(f'中学卒業後の進学率: 47 県の範囲 {hs.min():.1f}〜{hs.max():.1f}%') print(f'高校卒業後の進学率: 47 県の範囲 {univ.min():.1f}〜{univ.max():.1f}%') print('高校卒業後の進学率 上位 5:', univ.nlargest(5).round(1).to_dict()) print('中学卒業後の進学率 上位 5:', hs.nlargest(5).round(1).to_dict()) print('2 つの順位相関:', round(hs.rank().corr(univ.rank()), 3)) |
💬 中学卒業後の進学率は 47 県で 90.1〜96.7% と狭い範囲に収まり、 上位は石川県・富山県・山形県など。 高校卒業後の進学率は 46.7〜74.1% と大きく開き、 上位は東京都 74.1%・京都府 74.0%・神奈川県など大都市圏。 2 つの順位相関は −0.293 で、 片方で上位の県がもう片方でも上位とは限らない。 「進学率が高い県」と書くときは、 どの段階の進学か(分母が中学卒業者か高校卒業者か)まで書かないと、 読み手は別の県を思い浮かべる。
⚠️ 記号「最新」を行の順番に接地すると、 11 年前の値が返る
🎯 このコードでやること:記号「最新の値」を、 pandas の groupby().last()(各県の最後の行)に接地した場合と、 年度の列が最大の行に接地した場合で、 返ってくる年度と総人口を比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('ファイルの先頭 2 行の年度:', df['SSDSE-B-2026'].head(2).tolist(), ' 末尾 2 行:', df['SSDSE-B-2026'].tail(2).tolist()) # 「最新」を「各県の最後の行」に接地すると… last_row = df.groupby('Prefecture').last() # 「最新」を「年度が最大の行」に接地すると… max_year = df.loc[df.groupby('Prefecture')['SSDSE-B-2026'].idxmax()].set_index('Prefecture') print('groupby().last() が返した年度:', sorted(int(y) for y in last_row['SSDSE-B-2026'].unique())) print('年度が最大の行の年度 :', sorted(int(y) for y in max_year['SSDSE-B-2026'].unique())) print(f"東京都の「最新の総人口」 last(): {last_row.loc['東京都','A1101']:,}" f" / 年度最大: {max_year.loc['東京都','A1101']:,}") print(f"47 県合計 last(): {last_row['A1101'].sum():,}" f" / 年度最大: {max_year['A1101'].sum():,}") |
💬 各県の行は 2023 年度から 2012 年度へ新しい順に並んでいるので、 「各県の最後の行」を取る last() は 47 県すべてで 2012 年度を返す。 東京都の「最新の総人口」は last() では 13,234,000 人、 年度が最大の行では 14,086,000 人で、 85 万人違う。 47 県合計も 127,589,000 人と 124,353,000 人で 320 万人ずれる。 「最後の行=最新」という接地は、 行の並び順という記号どうしの約束に頼っていて、 年度という測定そのものを見ていない。 「最新」は年度の列で決め、 取れた年度を必ず表示して確かめる。
⚠️ 項目名だけでは接地先が決まらない — 「消費支出」はどこの誰の値か
🎯 このコードでやること:ファイルの 2 行目に書かれた項目名だけで、 列 L3221 が何を指すかが決まるかを確かめる。 項目名を取り出し、 2023 年度の上位 5 県と下位 3 県を並べる
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' head = pd.read_csv(path, encoding='cp932', header=None, nrows=2) label = dict(zip(head.iloc[0], head.iloc[1])) # 列コード → 項目名 print('L3221 の項目名:', label['L3221']) print('A1101 の項目名:', label['A1101']) df = pd.read_csv(path, encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') print('L3221 の 2023 年度 上位 5:', d['L3221'].nlargest(5).to_dict()) print('L3221 の 2023 年度 下位 3:', d['L3221'].nsmallest(3).to_dict()) |
💬 項目名は「消費支出(二人以上の世帯)」で、 どこの世帯か、 1 か月か 1 年かは書かれていない。 2023 年度の上位は埼玉県 344,092・東京都 341,320・三重県 332,663、 下位は愛媛県 223,423・沖縄県 251,222 だが、 SSDSE の解説によればこの列は家計調査の県庁所在市の、 1 か月あたりの値である。 つまり「埼玉県の消費支出」という記号が指しているのは、 埼玉県全体ではなく、 さいたま市の二人以上の世帯の月平均である。 列名と数値だけではこの接地先は分からず、 データに付属する解説(メタデータ)を読んで初めて決まる。 記号を接地させる手がかりは、 データの外にあることが多い。
🗺 概念マップ
🧠 哲学的議論の流れ
| 論者 | 主張 |
|---|---|
| Searle (1980) | 中国語の部屋。 記号操作だけでは意味理解にならない |
| Harnad (1990) | 「シンボルグラウンディング問題」の命名・定式化 |
| Brooks (1991) | 身体化 AI(Embodied AI)の提唱 |
| Dennett | 機能主義の立場で記号 AI 擁護 |
| Bender & Koller (2020) | LLM は形式のみ学習し意味は到達しないと主張 |
🛠 接地のアプローチ
- マルチモーダル学習:CLIP、 Flamingo、 GPT-4V — 言語と画像のペアで意味を結びつける
- 身体化学習:ロボット・強化学習で「経験」を通じた接地
- 分散表現:Word2Vec、 GloVe、 BERT — 文脈からの意味埋め込み
- シミュレーション:物理シミュレータ内でエージェントが世界モデルを学習
- 言語ゲーム:マルチエージェントが相互作用で語彙を発生(Wittgenstein 的)
🔭 研究の動向 — 言語モデル以後の記号接地
大規模言語モデルの登場で、記号接地問題は哲学の議論から実験で確かめる研究課題へと移ってきました。主な論点を 5 つ挙げます(年は論文の発表年)。
- 形だけから意味は学べるか:Bender と Koller(2020)は、文字列の形だけで訓練したモデルは意味(言葉と世界の対応)を学べないと論じ、海底ケーブルの会話を盗み聞きするタコのたとえ(octopus test)を示しました。これに対し、指示対象がなくても語どうしの関係(概念の役割)として意味の一部は学べる、という反論もあります(Piantadosi と Hill、2022)。
- モデルの内部に「世界の状態」はあるか:オセロの棋譜の記号列だけで訓練した言語モデルの内部から盤面の状態を読み出せた、という報告(Li ら、2023、Othello-GPT)は、記号列の学習から世界の構造が部分的に復元されうる例として議論されています。
- 画像への接地:画像と文を対照学習で同じベクトル空間に置く CLIP(Radford ら、2021)以降、言葉を知覚データに結び付けるモデルが一般的になりました。このページの 🐍 で触れたマルチモーダル埋め込みがこれにあたります。
- 行動への接地:言語モデルの提案を、ロボットがその場で実行できる行動の価値と組み合わせる SayCan(Ahn ら、2022)や、センサーの入力を直接言語モデルに入れる PaLM-E(Driess ら、2023)のように、言葉を身体の行為に結び付ける研究が進んでいます。
- 文書への接地(出典に基づく生成):外部の文書を検索して回答の根拠にする検索拡張生成(Lewis ら、2020)は、実務で「grounding」と呼ばれることが多い手法です。ただしこれは記号を別の記号(文書)に結び付けるもので、Harnad の言う感覚への接地とは意味が違う点に注意します。
これらのテーマは互いに関連しているので、 1 つに興味を持ったら隣接領域に展開していくと知識ネットワークが広がります。
概念マップ — 記号はどこで意味とつながるか
シンボルグラウンディング問題を中心に、 「記号だけの世界」と「意味が生まれる場所」を 1 枚に置きます。 中央から左は記号の側、右は意味を支える側です。
左側だけで閉じているかぎり、記号は別の記号でしか説明できません。 辞書で「犬」を引くと「イヌ科の哺乳類」と出て、「哺乳類」を引くとまた別の語が出る — この循環が問題の核心です。 右側の身体・感覚とつながって初めて、記号は外界の何かを指せるようになります。 上の分散表現は記号どうしの関係を数値にしたもので、循環を精密にはしましたが、 それ自体が外界に触れているわけではありません。 下の問い「LLM は接地したのか」は、まさにこの点が争われています。
このページの実データの例を図に置くと、 「暑い県」「雨が多い県」「診療所が多い県」「進学率」「東日本」「最新」は、 どれも左側の記号(言葉・列名)のままでは指す県や値が決まらず、 右側の「外界との対応づけ」にあたる測定手続き(どの列を、 どの単位で、 何を 1 単位に数えるか)を決めて初めて決まった例である。 一方「県名の文字の近さ」や「ラベルを入れ替えても変わらない相関」は、 左側の記号どうしの関係だけで閉じている例で、 どれだけ精密に計算しても外界の県の性質は指さない。 上の「分散表現・埋め込み」は、 この左側の関係を数値にしたものにあたる。
🔗 隣接手法への橋渡し
シンボルグラウンディング問題 (Harnad 1990) は「形式記号が現実世界の対象とどう接続するか」を問う AI 哲学の中心問題。 SSDSE-B-2026 でも、 数値「13,515,271 (東京都人口)」が本当に「東京で生活する人々」を指しているかは、 元の調査設計と定義 (国勢調査の常住人口) を介してのみ接地する。 LLM の幻覚 (hallucination) も同じ構造問題。
- 上流: 強い AI / 弱い AI、 中国語の部屋 (Searle 1980)、 記号主義 AI (古典 AI)、 コネクショニズム。
- 並列: 身体性認知 (Brooks)、 フレーム問題、 マルチモーダル接地 (画像 + 言語 + 行動)。 LLM の hallucination は接地問題の現代版。
- 下流: RAG (検索拡張生成)、 知識グラフ、 マルチモーダル AI、 ロボティクス (実世界とのループ)。
SSDSE 分析でも「列名 A1101 という記号が国勢調査の人口定義と本当に対応しているか」を README で確認することは、 実務における接地確認に他ならない。 抽象記号と現実定義の対応確認は分析の出発点。
🌳 手法選択フロー
AI システムでの記号接地 (実世界との対応) を実現するアプローチ選択フロー。
- ① 接地対象は何か? 統計データ (SSDSE) → メタデータ + 定義ドキュメント。 画像 / 音声 → センサーデータと共同学習 (CLIP / Whisper)。 行動 → 強化学習エージェントの環境ループ。
- ② 接地強度はどこまで必要か? 統計解析 → 列定義の参照で十分。 対話 AI → RAG + 知識ベース。 自律ロボット → 物理シミュレーション + 実機経験。
- ③ 接地誤りを検知する仕組みは? LLM hallucination → 出典引用必須化 + ファクトチェック層。 SSDSE 分析 → 元統計との一致確認 (数値突合)。 ロボット → 異常検出 + ヒトインザループ。
記号接地問題は完全解決されておらず、 実務では「弱い接地 (定義参照)」と「事後検証 (ファクトチェック)」の組合せで実用化する。 SSDSE 分析でも列名と実体の対応を意識的に確認する習慣が重要。
ひとつだけ持ち帰るなら、これです。 記号は、それを外界に結びつける誰かがいて初めて意味を持ちます。 データ分析では、その「誰か」は今のところ分析者自身です。 列名の意味を確かめ、単位を確かめ、定義の変更に気づく — 一見つまらないこの作業こそが、 記号を接地させる工程そのものです。自動化したくなったときほど、 この工程を誰が担っているのかを意識してください。