🔖 キーワード索引
マルウェア (malicious software) はウイルス・ワーム・ランサムウェア・スパイウェア等の総称。 データ分析の現場では「ログから既知マルウェア感染を検出」「未知の挙動を異常検知で発見」する応用が一般的。 SSDSE 系の公開データには含まれないが、 公開セキュリティログ(VirusShare 等)と組み合わせて分類器を学習するのが典型。
「分類 → 解析手法 → 検出技術」 がマルウェア対策ワークフローの核。
💡 30秒で分かる結論
🍰 まずはやさしく
悪いソフトをまとめた呼び名です。
セキュリティの分析に使います。
スマホやPCを守るために必要です。
重要なポイントを短くまとめます。
ウイルス、 ワーム、 トロイの木馬の総称
- 分野:セキュリティ — 📚 サイバーセキュリティ
- 検知は 2 クラス分類:実行ファイルや振る舞いの特徴量から「悪性 / 良性」を当てる。既知の検体はシグネチャ(ハッシュ・YARA)、未知の亜種は挙動・機械学習・異常検知で拾う多層防御が前提
- 評価は再現率と誤検知の両方:悪性は全体のごく一部なので accuracy は当てにならない。誤検知率(FPR)が小さく見えても、悪性が希少だと適合率は大きく下がる(🧮 の基準率の節)
- 相手が変わる:攻撃者はパッキングや難読化で手口を変えるので、学習時より新しい検体で測り直し、定期的に再学習する(concept drift)
📍 あなたが今見ているもの
🍰 まずはやさしく
悪いソフトを見分ける学習ページです。
特徴から正体を当てる練習をします。
部活の連絡などで使うPCを守ります。
実際に手を動かして分類を学びます。
このページは「セキュリティ」グループ内の「マルウェア(Malware)」項目です。 ウイルス・ワーム・トロイの木馬等の悪意ソフトウェアを「特徴量から確率で検知する」という分類問題として、 実際に手を動かしながら学べます。
関連: サイバーセキュリティ 分類
🎨 直感で掴む
🍰 まずはやさしく
忍者のように隠れて動くソフトです。
攻撃者が得をするために使います。
PDFを開いた瞬間に動き出します。
データから正体を見抜く方法を学びます。
マルウェアは「意図せず実行されたとたん、 攻撃者の利益のために動き出すプログラム」。 一般のアプリと違って、 (1) 感染経路(メール添付・USB・OS 脆弱性)、 (2) 常駐手段(レジストリ書き換え・サービス登録)、 (3) ペイロード(情報窃取・暗号化身代金・bot 化)の 3 段構成を持つ。 例えばランサムウェアは「PDF を開く → バックグラウンドで全ファイルを AES 暗号化 → 復号鍵と引き換えにビットコイン要求」の流れで、 マシン側から見れば「通常のファイル I/O が爆発的に増える」というシグナル。
統計分析の道具としての マルウェア検知 は、 PE ファイルの 2,381 次元の特徴量(インポート関数・セクション数・エントロピー等)から「良性 / 悪性」を分類する 2 クラス分類問題。 EMBER-2018 のような公開データセットで LightGBM が AUC ≈ 0.99 を出す一方、 packer 変化やゼロデイで concept drift が起きる点が他の分類問題と決定的に違う。
マルウェアを直感で掴むには「体重計の見えない指紋」のメタファが効く。 普通のソフトはディスクに置いてあるだけだが、 マルウェアは 起動時のシステムコール列 ・ ネットワーク先 IP ・ レジストリ書き込みパターン という見えない指紋を残す。 静的解析(実行前にバイナリを読む)と動的解析(実行して挙動を観察)の 2 軸でこの指紋を捕まえるのが現代の検知技術。
検知は 3 層で捉えると整理しやすい。 (1) シグネチャ検知(既知検体のハッシュや YARA ルールとの一致)は高速だが未知株に無力、 (2) 挙動検知(実行時の API 呼び出し列・ファイル I/O・レジストリ操作の異常)はゼロデイにも反応するが誤検知が増える、 (3) ML 検知(静的・動的特徴量から悪性確率を学習)は両者の中間で、 EMBER 等のベンチマークで高い AUC を出す。 実運用では単一手法に頼らず、 この 3 層を組み合わせた多層防御が前提になる。
📐 定義
🍰 まずはやさしく
ウイルスなどの総称(まとめ)です。
ネットの攻撃を防ぐために使います。
メールやUSBからの侵入を防ぎます。
種類や検知のルールを整理して学びます。
ウイルス、 ワーム、 トロイの木馬の総称
英語名 Malware。
🎯 いつ・どこで使うか
- エンドポイント保護・メールゲートウェイ・SOC など、 セキュリティ実務のあらゆる場面で登場する基本概念です。
- 📚 サイバーセキュリティ の中核テーマであり、 検知・防御・対応の全工程に関わります。
- 論文・脅威レポートで頻出する用語なので、 種別・侵入経路・検知方法を 1 度きちんと整理しておくと後が楽です。
📋 前提条件・適用範囲
マルウェア検知を理解・運用するときは、 次のような前提を意識してください:
- 特徴量の種類:静的解析(PE ヘッダ・エントロピー・import 関数)か動的解析(API 呼び出し列・通信)かで設計が変わる
- クラス不均衡:実トラフィックは正常が大多数。 accuracy ではなく recall / PR-AUC で評価する
- Concept Drift:攻撃者は継続的に手口を変えるため、 モデルは定期的な再学習が前提
- 敵対的環境:難読化・パッキング・回避攻撃を想定した頑健性が必要
📐 判定のルールを式で書く — 閾値はコストの比で決まる
検知器は特徴量 x から悪性である確率 p = P(悪性 | x) を出し、閾値 t と比べて「p ≥ t なら悪性と判定」する。見逃し 1 件の損失を CFN、誤警報 1 件の損失を CFP とすると、あるファイルを
$$\text{悪性と判定したときの期待損失} = (1-p)\,C_{FP}, \qquad \text{良性と判定したときの期待損失} = p\,C_{FN}$$なので、悪性と判定する方が得なのは (1 − p) CFP ≤ p CFN、つまり
$$p \;\ge\; t^{*} = \frac{C_{FP}}{C_{FP} + C_{FN}}$$のときになる。見逃しが誤警報の 10 倍痛いなら t* = 1 ÷ 11 ≈ 0.091 で、既定の 0.5 よりずっと低い。ただしこれは p が「本当の確率」になっている(較正されている)ときの話で、🧮 の実験のようにランダムフォレストの投票割合をそのまま使うと、最適な閾値は式からずれる(実験では 0.05)。また p 自体が、評価データと実運用で悪性の割合が違えば変わるので、閾値は実運用に近いデータで決め直す。
🔬 数式を言葉で読み解く
「マルウェア」の定式化:
$$P(\text{malware} \mid \mathbf{x}) = \sigma\!\left(\sum_{j=1}^{d} w_j x_j + b\right)$$
PE ファイルから抽出した d 次元静的特徴 $\mathbf{x}$ に対し、 ロジスティック回帰で悪性確率を出す。
| 記号 | 読み方 | 意味 | 例 |
|---|---|---|---|
| $\mathbf{x}$ | エックス(ベクトル) | PE ヘッダ・API 呼び出し・エントロピー等の特徴ベクトル | EMBER で 2,381 次元 |
| $x_j$ | エックス・ジェイ | j 番目の特徴値 | section_entropy = 7.8 |
| $w_j$ | ダブリュー・ジェイ | 特徴 j の重み。 学習で決まる | エントロピー高 → $w_j > 0$ |
| $b$ | ビー | バイアス項。 基準オフセット | $b = -2.3$ |
| $\sigma$ | シグマ(シグモイド) | 線形和を確率 [0,1] へ写像 | $\sigma(0)=0.5$, $\sigma(2)=0.88$ |
| $P(\text{mal} \mid \mathbf{x})$ | ピー・マル・ギブン・エックス | 悪性確率(出力) | 0.92 → 高確度で悪性 |
| 閾値 $\tau$ | タウ | 判定境界。 FN/FP の trade-off | 既定 0.5、 厳しめ 0.3 |
| $d$ | ディー | 特徴次元数 | 静的 2,381 + 動的 N-gram 数万 |
読み下し:「ある PE ファイルの特徴ベクトル $\mathbf{x}$ を入力すると、 各特徴を重み $w_j$ で線形結合し、 シグモイド $\sigma$ で 0〜1 の確率に押し込み、 これが閾値 $\tau$ を超えたら悪性 (malware) と判定する」と読む。 EMBER の 2,381 次元では PE ヘッダ (DOS/COFF/Optional)、 セクションエントロピー、 import 関数名のハッシュ等が $\mathbf{x}$ の中身。
🔬 エントロピーを実際に計算する — 圧縮・暗号化された中身は 8 ビットに近づく
静的解析の特徴量としてよく使うのが、ファイルやセクションのバイトのシャノンエントロピー H = −Σ pi log2 pi で、pi は 256 種類のバイト値それぞれの出現割合。最大は 256 種類が均等に出る 8 ビット/バイト。手で確かめると、4 バイト「A A B C」なら p(A)=0.5、p(B)=p(C)=0.25 なので H = −(0.5×log20.5 + 2×0.25×log20.25) = 0.5 + 1.0 = 1.5 ビット/バイト。パッカーで圧縮・暗号化された本体はどのバイト値もほぼ均等に現れるので 8 に近づき、これが「エントロピーが 7 を超えるセクションは疑え」という経験則の理由になる。
🎯 このコードでやること:実在のファイルとして SSDSE-B-2026.csv の先頭 20,000 バイトを使い、そのまま・zlib で圧縮・乱数バイト列・0x00 の繰り返しの 4 つのエントロピーを求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import math, zlib import numpy as np from collections import Counter def entropy(b: bytes) -> float: """バイト列のシャノンエントロピー H = −Σ p_i log2 p_i(ビット/バイト、最大 8)""" n = len(b) return sum(-c / n * math.log2(c / n) for c in Counter(b).values()) # (a) ふつうのデータ:SSDSE-B-2026.csv の先頭 20,000 バイト(数字・カンマ・cp932 の日本語) a = open('data/raw/SSDSE-B-2026.csv', 'rb').read()[:20000] # (b) 同じバイト列を zlib で圧縮(パッカーが本体を圧縮して隠すのに近い) b = zlib.compress(a, 9) # (c) 乱数バイト列(暗号化されたデータに近い)。seed 固定 c = np.random.default_rng(0).integers(0, 256, size=20000, dtype=np.uint8).tobytes() # (d) 0x00 の繰り返し(ゼロ埋めされた領域) d = bytes(20000) for name, x in [('(a) CSV そのまま', a), ('(b) CSV を zlib 圧縮', b), ('(c) 乱数バイト列', c), ('(d) 0x00 の繰り返し', d)]: print(f'{name:16} {len(x):6d} バイト 種類 {len(set(x)):3d} エントロピー = {entropy(x):.3f} ビット/バイト') |
💬 CSV そのままは 161 種類のバイト値しか使わず 4.227 ビット/バイトだが、同じ内容を zlib で圧縮すると 256 種類すべてが現れ 7.977 と、乱数(7.992)とほとんど区別がつかない。0x00 だけの領域は 0。エントロピーが高いこと自体は「圧縮または暗号化されている」ことしか示さず、正規のインストーラや画像・動画も高くなるので、単独では悪性の証拠にならない。他の特徴(インポート関数の少なさ、セクション名など)と組み合わせて使う。
🧮 マルウェア検知の実践計算
マルウェア検知は「PE ファイルや実行ログから抽出した特徴量 → 悪性 / 良性ラベル」の分類問題として定式化できる。 ここでは検知の中核となる評価指標(検知率・誤検知率)を、 AV エンジンの試行結果(合成データ)で手を動かして体感する。 人口統計のような社会統計はセキュリティ検知の題材にはならないため、 本ページではマルウェア検知固有のデータ構造で計算する。
🏭 産業界での使われ方(代表的な 6 つの場面)
- エンドポイント(EDR・アンチウイルス):端末上のファイルの静的特徴(PE ヘッダ・インポート関数・文字列)とプロセスの振る舞いを、 シグネチャと機械学習の分類器を組み合わせて判定する。
- メールゲートウェイ:添付ファイルや URL をサンドボックスで実際に動かし、 その振る舞いログから悪性かを判定する。 未知の検体(ゼロデイ)への対策の柱。
- 金融機関:ATM やオンラインバンキングを狙うマルウェアへの対策として、 端末のプロセスやネットワーク通信の異常を監視する。
- モバイルアプリ審査:アプリストアが公開前・公開後のアプリを静的解析と動的解析で審査し、 悪性アプリを取り除く。
- SOC(セキュリティ監視センター):大量のログからアラートを出し、 分析者が優先順位を付けて調査する。 下の図のとおり、 誤警報の数が運用の負担を決める。
- IoT・OT:Mirai 系のようにルーターやカメラに感染するマルウェアに対し、 ネットワークの通信パターンから感染機器を見つける。
※具体的な製品の検知率や処理件数は、 各社の公開資料で条件(対象データ・期間・評価方法)を確かめてから引用すること。 条件の違う数値どうしは比べられない。
🆚 関連手法との比較表
| 手法 | 入力 | 代表アルゴリズム | 特徴 |
|---|---|---|---|
| シグネチャ検知 | ハッシュ/正規表現 | 既知株のみ | 速いがゼロデイ無力 |
| ヒューリスティック | ルールベース | 亜種に弱い | 誤検知多め |
| 静的 ML | PE 構造 + GBDT | 実行不要 | パッカに弱い |
| 動的 ML | Sandbox 実行ログ + RNN | 評価コスト高 | パッカ突破可 |
| 深層学習 (CNN) | バイナリを画像化 → ResNet | 大量の学習データが要る | 解釈が難 |
| YARA + ML | ハイブリッド | プロのチューニング | 高精度・高運用負荷 |
🧮 数式に値を入れて手で計算する: マルウェア検知の精度指標
合成データで AV エンジンの検知精度を計算する。
Step 1: 試行結果
| 区分 | 件数 |
|---|---|
| 正常→正常 (TN) | 9,900 |
| 正常→マル (FP) | 20 |
| マル→マル (TP) | 80 |
| マル→正常 (FN) | 10 |
Step 2: 指標
🐍 Python で再現
1 2 3 4 5 6 7 | tp, fn, fp, tn = 80, 10, 20, 9900 rec = tp/(tp+fn) fpr = fp/(fp+tn) acc = (tp+tn)/(tp+fn+fp+tn) print(f"Recall: {rec:.3f}") print(f"FPR: {fpr:.4f}") print(f"Accuracy: {acc:.4f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
📉 同じ検知器でも「マルウェアの割合」で適合率が変わる
上の試行では 10,010 件中マルウェアが 90 件(0.9%)で、 警報 100 件(TP 80 + FP 20)のうち本物は 80 件、 つまり適合率は 0.80 だった。 検知率 0.889 と誤検知率 0.0020 は検知器の性質なので固定し、 検査対象に占めるマルウェアの割合 π だけを変えると、 適合率 = 検知率 × π ÷ (検知率 × π + 誤検知率 × (1 − π)) は大きく動く。
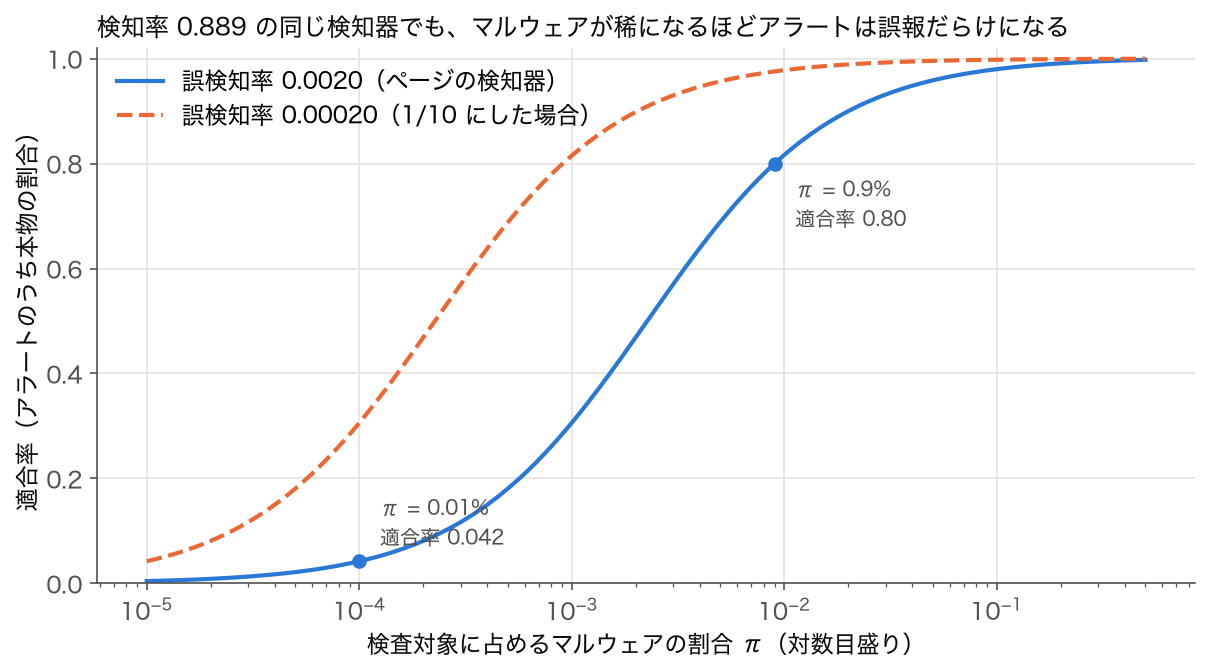
💬 実運用ではマルウェアはごく一部なので、 検知率の高さより誤検知率の低さが警報の信頼性を決める。 評価用データでマルウェアの割合を高めにしてあると適合率は実運用より良く見えるので、 報告するときは評価データでの割合も書き添える。
🧮 見逃しと誤警報のコストから閾値を決める
⚠️ のファミリ単位の実験(架空データ)で、訓練に無いファミリに対して出した悪性確率を使い、見逃し(FN)1 件の損失を誤警報(FP)1 件の 10 倍と仮定したときの期待コスト 10 × FN + 1 × FP を、閾値ごとに手で計算する。
| 閾値 | TP | FN | FP | TN | 期待コスト = 10 × FN + 1 × FP |
|---|---|---|---|---|---|
| 0.1 | 1,091 | 109 | 963 | 2,037 | 10 × 109 + 963 = 2,053 |
| 0.2 | 1,001 | 199 | 492 | 2,508 | 10 × 199 + 492 = 2,482 |
| 0.3 | 855 | 345 | 281 | 2,719 | 10 × 345 + 281 = 3,731 |
| 0.5 | 622 | 578 | 90 | 2,910 | 10 × 578 + 90 = 5,870 |
| 0.7 | 314 | 886 | 15 | 2,985 | 10 × 886 + 15 = 8,875 |
既定の閾値 0.5 は誤警報が 90 件と少ないが、見逃しが 578 件あり、期待コストは 5,870。閾値を 0.1 に下げると誤警報は 963 件に増えるが、見逃しが 109 件まで減るので、コストは 2,053 と 3 分の 1 近くになる。下のコードで同じ表を再現し、0.01 刻みで最小の閾値を探す。
🎯 このコードでやること:上の表を Python で再現し、閾値を 0.01 刻みで動かして期待コストが最小になる閾値を探す。確率が正しく較正されているときの理論上の目安 C_FP ÷ (C_FP + C_FN) とも比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import GroupKFold, cross_val_predict # mw_family.py と同じ架空(合成)データ(60 ファミリ × 20 亜種 + 良性 3,000 件) rng = np.random.default_rng(0) n_fam, per_fam, n_benign, d = 60, 20, 3000, 8 centers = rng.normal(0.8, 1.0, size=(n_fam, d)) X_mal = np.vstack([c + rng.normal(0, 0.35, size=(per_fam, d)) for c in centers]) X = np.vstack([X_mal, rng.normal(0, 1.0, size=(n_benign, d))]) y = np.r_[np.ones(n_fam * per_fam), np.zeros(n_benign)] groups = np.r_[np.repeat(np.arange(n_fam), per_fam), n_fam + np.arange(n_benign)] # 未知ファミリに対する悪性確率(ファミリ単位の 5 分割で、テスト側だけを予測) p = cross_val_predict(RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=-1), X, y, cv=GroupKFold(5), groups=groups, method='predict_proba')[:, 1] C_FN, C_FP = 10, 1 # 見逃し 1 件は誤警報 10 件分の損失、と仮定 print(' 閾値 TP FN FP TN 期待コスト = 10×FN + 1×FP') for t in [0.1, 0.2, 0.3, 0.5, 0.7]: pred = p >= t tp = int(((pred == 1) & (y == 1)).sum()); fn = int(((pred == 0) & (y == 1)).sum()) fp = int(((pred == 1) & (y == 0)).sum()); tn = int(((pred == 0) & (y == 0)).sum()) print(f' {t:.1f} {tp:5d} {fn:5d} {fp:5d} {tn:5d} {C_FN * fn + C_FP * fp:6d}') ts = np.linspace(0.01, 0.99, 99) cost = [C_FN * ((p < t) & (y == 1)).sum() + C_FP * ((p >= t) & (y == 0)).sum() for t in ts] print(f'0.01 刻みで探した期待コスト最小の閾値 = {ts[int(np.argmin(cost))]:.2f}(コスト {min(cost)})') print(f'理論上の目安 C_FP / (C_FP + C_FN) = {C_FP / (C_FP + C_FN):.3f}') |
💬 手計算の表と同じ TP・FN・FP・TN とコスト(0.1 で 2,053、0.5 で 5,870)が出た。0.01 刻みで探すと最小は閾値 0.05(コスト 1,918)で、理論上の目安 1 ÷ 11 ≈ 0.091 より低い。ランダムフォレストの確率は木の投票割合で、較正されていないため式どおりにはならない。閾値は 0.5 に固定せず、コストの比と実データでの件数から決め、評価データの悪性の割合(ここでは 29%)が実運用(ごく一部)と違うことも考えて、実運用に近い割合で決め直す。
🎮 触って理解する: シグネチャ検知 vs 異常検知
マルウェア検知は本質的に 2 クラス分類問題(良性 / 悪性)です。 ここでは架空のファイル/プロセスを 2 次元の特徴空間 に散布して、 2 つの検知戦略を切り替えながら「検出率」と「誤検知(良性を悪性と誤る)」のトレードオフを体感します。 これは防御・検知教育のための可視化であり、 攻撃手法は一切扱いません。
- 横軸=通信頻度(外部への通信要求の多さ)/縦軸=権限要求(管理者権限・機微 API 要求の強さ)。 値は 0〜100 の無次元スコア。
- シグネチャ検知:既知検体の指名手配リスト(=既知ファミリの登録済みパターン領域)に完全一致したものだけを悪性と判定。 高速・誤検知ゼロだが既知しか捕まえられない。
- 異常検知:良性の「正常範囲」(良性重心からの距離)を基準に、 そこから外れた点を悪性と判定。 未知も捕まえるが誤検知が出る。 閾値スライダーで正常範囲の広さを調整。
※ データはすべて架空(合成)です。 実在の検体・攻撃手順とは無関係で、 シード固定(seed=20260614)で決定的に生成しています。 71 点=良性 41・悪性 30(うち未知の亜種 8 は既知シグネチャの外側に配置)。
| 指標 | 値 | 意味 |
|---|---|---|
| 検出率 / 再現率 (Recall) | – | 悪性のうち捕まえた割合 TP/(TP+FN) |
| 適合率 (Precision) | – | 悪性判定のうち本当に悪性 TP/(TP+FP) |
| 誤検知率 (FPR) | – | 良性を悪性と誤る割合 FP/(FP+TN) |
| 未知の亜種 検出 | – | 未知 8 点のうち検出できた数 |
| 混同行列 (TP/FP/FN/TN) | – | 検出の内訳 |
🧭 何が起きているか(直感)
シグネチャ検知=「指名手配写真との一致」。 既に知られた顔(既知ファミリの領域)にピタリ一致した点だけを捕まえます。 誤認逮捕(誤検知)はほぼゼロですが、 写真に無い顔=未知の亜種は素通り。 上のグラフでシグネチャ方式に切り替えると、 オレンジの未知の亜種 8 点は 1 つも枠が付かないことが確認できます(検出 0/8)。 いっぽう 異常検知=「挙動の不審さ」。 良性の普段の振る舞い(中心付近の塊)から離れた点を怪しむので、 未知の亜種も距離で捕まえられます。 ただし「重い正規ソフト」のような紛らわしい良性まで巻き込んで誤検知が発生します。
⚠️ 落とし穴
- シグネチャは未知に無力:1 バイトの改変・パッキングで指紋がずれ、 既知一致から外れると検出率が急落します。 スライダーをどう動かしてもシグネチャ方式の検出率は上がりません(既知しか対象にできない)。
- 異常検知は誤検知との戦い:閾値 R を下げて検出率を上げるほど、 良性の外れ値を悪性と誤り 適合率が下がります。 実運用ではアナリストが誤検知の山に埋もれる「アラート疲れ」が最大の敵。
- 回避(evasion):攻撃側は「正常範囲の内側に見えるよう振る舞いを薄める」ことで異常検知をかいくぐろうとします。 だからこそ単一指標での評価は危険で、 適合率と再現率の両面で見る必要があります。
- クラス不均衡:実トラフィックは良性が大多数。 全体精度 (accuracy) は当てにならず、 再現率・適合率・FPR で評価します。
🚀 発展
現実の検知は 2 方式の二択ではなく多層防御です。 (1) 機械学習型検知:多数の特徴量から悪性確率を学習し、 シグネチャと異常検知の中間の柔軟さを得る(本ページ上部の 定義・Python 実装を参照)。 (2) サンドボックス:隔離環境で実際の挙動を観測し、 静的特徴では見えない振る舞いを異常検知に供給。 (3) 多層防御:シグネチャ(高速・低誤検知)で既知を捌き、 異常検知/ML で未知を拾い、 人による最終確認でトレードオフの穴を埋める。 分類の枠組みとしては 分類、 未知検出の枠組みとしては 外れ値検出が土台になります。
🚀 実際に確かめる — 訓練に無い新ファミリは、教師ありでは 0 件、異常検知なら拾える
🎮 のデモの「シグネチャ vs 異常検知」を、学習する検知器どうしで数値にする。教師あり学習は「訓練で見た悪性に似ているか」を学ぶので、既知のファミリと違う方向に外れた新ファミリは良性側に入ってしまう。良性だけで「普段の姿」を学ぶ異常検知は、方向を問わず外れたものを拾うが、その代わり良性の外れ値も拾う。
🎯 このコードでやること:架空の特徴量 8 次元で、既知の悪性ファミリ(平均 +2.5)と良性で学習したランダムフォレストと、良性だけで学習した IsolationForest(上位 1% を異常とする)を、訓練に無い新ファミリ(平均 −2.5)と新しい良性 3,000 件に当てる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np from sklearn.ensemble import RandomForestClassifier, IsolationForest # 架空(合成)データ:既知の悪性ファミリは「+方向」に、未知の新ファミリは「−方向」に外れている rng = np.random.default_rng(3) d = 8 benign_tr = rng.normal(0, 1, size=(3000, d)) known_mal = rng.normal(2.5, 0.6, size=(600, d)) # 訓練に使える既知ファミリ benign_te = rng.normal(0, 1, size=(3000, d)) new_mal = rng.normal(-2.5, 0.6, size=(100, d)) # 訓練に無い新ファミリ(別の方向に異常) X_tr = np.vstack([benign_tr, known_mal]); y_tr = np.r_[np.zeros(3000), np.ones(600)] rf = RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=-1).fit(X_tr, y_tr) iso = IsolationForest(n_estimators=300, contamination=0.01, random_state=0).fit(benign_tr) # 良性だけで学習 for name, flag in [('教師あり(RF, 閾値 0.5)', lambda X: rf.predict_proba(X)[:, 1] >= 0.5), ('異常検知(IsolationForest)', lambda X: iso.predict(X) == -1)]: print(f'{name:22} 新ファミリの検知率 = {flag(new_mal).mean():.2f} ' f'良性の誤検知率 = {flag(benign_te).mean():.3f}({int(flag(benign_te).sum())} / 3000 件)') |
💬 教師ありのランダムフォレストは良性の誤検知が 0 件だが、新ファミリを 1 件も検知できない(検知率 0.00)。良性だけで学習した IsolationForest は新ファミリを 100 件すべて拾う(1.00)代わりに、良性 3,000 件のうち 34 件(1.1%)を誤検知する。これは contamination=0.01 で「良性の上位 1% を異常」と決めた設定どおりの誤検知率で、実運用で良性が 1 日 100 万件あれば約 1 万件の誤警報になる。既知の脅威は教師あり、未知は異常検知で拾い、異常検知の警報は人やサンドボックスで確かめる、という多層防御の分担はこの性質の違いから来ている。
🐍 Python での扱い
マルウェア検知では、 まず特徴量を抽出し、 分類器で悪性確率を推定して閾値で判定する。 静的解析(PE ヘッダ・エントロピー・import 関数)と動的解析(API 呼び出し列・通信ログ)を組み合わせ、 LightGBM などの勾配ブースティングで学習するのが実務の標準パターンである。
🐍 シグネチャ(ハッシュ照合)が 1 ビットの改変で外れることを確かめる
🎯 このコードでやること:SSDSE-B-2026.csv の先頭 20,000 バイトを「既知の検体」に見立ててその SHA-256 をシグネチャ DB に登録し、最後の 1 ビットだけ反転したもの・末尾に 16 バイト足しただけのものが DB に一致するかを調べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import hashlib # 実在のファイルとして SSDSE-B-2026.csv の先頭 20,000 バイトを「既知の検体」に見立てる orig = open('data/raw/SSDSE-B-2026.csv', 'rb').read()[:20000] variant = bytearray(orig) variant[-1] ^= 0x01 # 最後の 1 バイトの最下位 1 ビットだけを反転した「亜種」 variant = bytes(variant) appended = orig + b'\x00' * 16 # 末尾に 0x00 を 16 バイト足しただけの「亜種」 known = {hashlib.sha256(orig).hexdigest()} # シグネチャ DB(既知検体のハッシュ) for name, x in [('元のファイル', orig), ('1 ビット反転', variant), ('末尾に 16 バイト追加', appended)]: h = hashlib.sha256(x).hexdigest() diff_bits = bin(int(h, 16) ^ int(hashlib.sha256(orig).hexdigest(), 16)).count('1') same = sum(p == q for p, q in zip(x, orig)) print(f'{name:10} 一致バイト {same:5d}/{len(orig)} SHA-256 先頭 16 桁 {h[:16]} ' f'元と異なるビット {diff_bits:3d}/256 シグネチャ一致: {h in known}') |
💬 中身が 20,000 バイト中 19,999 バイト一致している亜種でも、SHA-256 は 256 ビット中 114 ビットが変わり、シグネチャ DB には一致しない。末尾に 16 バイト足しただけの亜種も 149 ビットが変わる。ハッシュは「1 ビットでも違えば全く別の値になる」ように作られているので、既知の検体そのものには確実に当たる一方、1 バイト書き換えた亜種には無力になる(⚠️ の「シグネチャ検知のみに依存」)。そこで、似たファイルほど近い値になるファジーハッシュや、YARA のように特徴的な部分文字列を照合するルール、特徴量から学習する機械学習で亜種を拾う。
📅 「マルウェア」の歴史的展開
| 年 | 名前 | 何が起きたか |
|---|---|---|
| 1971 | Creeper | ARPANET 上を移動してメッセージを表示する実験的な自己複製プログラム。 これを消す Reaper も作られた。 |
| 1986 | Brain | IBM PC 互換機のフロッピーディスクのブートセクタに感染するウイルス。 PC 向けの初期の例としてよく挙げられる。 |
| 1988 | Morris ワーム | UNIX の脆弱性を突いてインターネット上で自己増殖し、 多数の計算機を停止させた。 CERT/CC 設立のきっかけになった。 |
| 1999-2000 | Melissa・ILOVEYOU | メールの添付ファイルとアドレス帳を使って大規模に拡散。 メール経由の感染が主流になる。 |
| 2001-2003 | Code Red・SQL Slammer・Blaster | サーバや Windows の脆弱性を突くワームが短時間で世界中に広がる。 パッチ適用の遅れが被害を広げた。 |
| 2010 | Stuxnet | 制御システム(PLC)を標的にしたマルウェアとして知られ、 物理的な設備への攻撃が現実の脅威になった。 |
| 2013- | ランサムウェアの本格化 | CryptoLocker など、 ファイルを暗号化して身代金を要求する手口が広がる。 |
| 2016 | Mirai | ルーターや監視カメラなどの IoT 機器を初期パスワードで乗っ取り、 大規模な DDoS 攻撃に使った。 |
| 2017 | WannaCry・NotPetya | SMB の脆弱性(EternalBlue)を使って自己増殖するランサムウェア・破壊型マルウェアが世界的な被害を出した。 |
| 2019- | Emotet など | メールで広がるマルウェアが日本でも繰り返し流行し、 JPCERT/CC などが注意喚起を出した。 |
感染経路は「フロッピーディスク → メール添付 → ネットワーク上の脆弱性 → IoT 機器」と移り、 目的も「いたずら・実験」から「金銭(ランサムウェア)」「設備の破壊」へと変わってきた。 検知の側も、 既知の検体と一致するかを見るシグネチャ方式から、 未知の検体を振る舞いや特徴量で見分ける機械学習・異常検知へ広がっている。
🎲 自己採点クイズ
- Q01: マルウェアの主要な種別(ウイルス・ワーム・トロイ・ランサム・スパイウェア)をそれぞれ一言で説明できるか?
- Q02: シグネチャ検知・挙動検知・ML 検知の長所と短所を対比できるか?
- Q03: 静的解析特徴と動的解析特徴の代表例を 3 つずつ挙げられるか?
- Q04: クラス不均衡下で accuracy を使ってはいけない理由を説明できるか?
- Q05: 混同行列から recall と誤検知率 (FPR) を手で計算できるか?
- Q06: Concept Drift とは何か、 なぜ定期的な再学習が必要かを説明できるか?
- Q07: 敵対的サンプル(回避攻撃)の脅威と対策を 1 つ挙げられるか?
- Q08: ゼロデイ検出に異常検知が有効な理由を説明できるか?
🍳 Code レシピギャラリー
#1 閾値選択
🎯 やること:precision-recall トレードオフ
📥 入力:合成スコア列(synthetic)
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np scores = np.array([0.1,0.3,0.5,0.7,0.9]) labels = np.array([0,0,1,1,1]) for th in [0.3,0.5,0.7]: pred = (scores>=th).astype(int) tp = ((pred==1) & (labels==1)).sum() fp = ((pred==1) & (labels==0)).sum() fn = ((pred==0) & (labels==1)).sum() prec = tp/(tp+fp) rec = tp/(tp+fn) print(f'th={th} TP={tp} FP={fp} FN={fn} precision={prec:.2f} recall={rec:.2f}') |
📤 実行結果:
💬 解釈:閾値 0.3 では良性のスコア 0.3 まで拾って FP=1(precision 0.75)、0.7 に上げると FP は 0 になる代わりにスコア 0.5 の悪性を見逃して recall が 0.67 に落ちる。この 5 件では 0.5 が両方 1.00 だが、実データでは良性と悪性のスコアが重なるので、見逃し(FN)を恐れるマルウェア検知では低めの閾値が好まれる。
📖 詳細解説 — マルウェア の条件・限界・誤解の整理
マルウェア (Malware) はウイルス、 ワーム、 トロイの木馬、 ランサムウェアなど、 悪意を持って設計されたソフトウェアの総称です。 検知は「特徴量 → ラベル (悪性 / 良性)」の分類問題として定式化され、 統計学・機械学習の応用先として急速に発展しています。 ここでは、 マルウェア検知の理論的基盤、 特徴量設計、 検知精度の評価、 そして実務での落とし穴を整理します。
マルウェア検知の基本的な定式化
検知器は確率モデル $P(\text{悪性} \mid \mathbf{x}) = \sigma(w^\top \mathbf{x} + b)$ で記述され、 ロジスティック回帰や深層学習でこの確率を推定します。 特徴ベクトル $\mathbf{x}$ には PE ヘッダ情報・セクションエントロピー・import 関数・API 呼び出し列などを用います。 学習の実務では、 混同行列から検知率 (recall)・誤検知率 (FPR)・PR-AUC を求め、 不均衡データ・閾値選択・偽陽性 / 偽陰性のトレードオフを体感するのが基本です。
特徴量設計が最重要
マルウェア検知の精度は、 特徴量設計に大きく左右されます。 静的解析特徴 (PE ヘッダ情報, 関数呼び出しグラフ, 文字列) と動的解析特徴 (システムコール列, ネットワーク通信) を組み合わせると検知率が大幅に上がります。 高次元の特徴空間を扱うため、 「特徴量選択 → モデルフィット → 評価」のワークフローを丁寧に回すことが重要です。
不均衡データの典型対処
実環境では悪性サンプルが全体の 1% 未満ということが普通で、 この強い不均衡が分類精度を大きく歪めます。 対処法は (1) SMOTE などのオーバーサンプリング (2) クラス重み付け (class_weight='balanced') (3) 評価指標を accuracy から F1, AUC, PR-AUC に変更、 などが定番です。
検知の評価指標を正しく選ぶ
マルウェア検知で最も致命的なのは「悪性を良性と判定する」偽陰性です。 そのため recall (再現率) を重視し、 偽陽性を多少増やしてでも見逃しを減らす運用が標準的です。 混同行列を出力してみると、 「precision と recall のトレードオフ」「閾値を下げると recall は上がるが precision は下がる」関係を視覚的に確認できます。
検知の限界と回避手法
攻撃者は検知をかわすために「難読化」「コードパッキング」「環境チェックで解析環境では実行しない」など多様な技を使います。 攻撃者と防御者のゲームを意識した分析設計が重要です。 敵対的機械学習 (adversarial ML) は、 マルウェア検知における重要研究テーマです。
ゼロデイ攻撃と異常検知
未知のマルウェア (ゼロデイ) は教師あり学習で対応が難しいため、 異常検知 (autoencoder, isolation forest) が補完手段として使われます。 正常なプロセス群からマハラノビス距離で外れ値を検出する手法は、 未知マルウェア検知の入門として教育的価値が高いです。 実マルウェア検知でも、 「正常な挙動と乖離するプロセスをアラート」する考え方が同じです。
検知システムの運用と更新
マルウェアは日々新しいバリアントが現れるため、 検知器も継続的に再学習する必要があります。 データ分布が時間とともに変わる「データドリフト」により、 過去のモデルが現在のデータに当てはまらなくなる現象が起きます。 MLOps の枠組みでモデル性能を監視し、 必要に応じて再学習する仕組みは、 マルウェア検知でも統計分析でも共通の課題です。
国際的なマルウェア検知データセット
VirusShare, MalwareBazaar, EMBER, Microsoft Malware Classification Challenge などが代表的データセットです。 教育目的で実マルウェア検体を扱うのは法的に注意が必要なため、 まずは EMBER のような「抽出済み特徴量」の公開データセットで「特徴量と分類問題」のフレームを学ぶのが安全です。 そのあと実検体解析へ段階的に進むと無理がありません。
図で見る マルウェア の世界

マルウェア 活用シナリオ比較表
| シナリオ | 具体例 | 注意点 |
|---|---|---|
| 教師あり検知 | PE 静的特徴からロジスティック回帰で悪性確率を推定 | 不均衡データの扱いが鍵 |
| 異常検知 | 正常プロセスのプロファイルからマハラノビス距離で外れ値検出 | 閾値選択が難しい |
| 深層学習検知 | 数百次元の特徴量から CNN/RNN で検知 | 解釈性と訓練データ量がトレードオフ |
| ルールベース | 既知ハッシュ / YARA など固定ルールで分類 | 未知変種に弱い |
| アンサンブル | 複数モデルを組み合わせて投票 | 計算コストが上がるが頑健 |
📝 理解度チェック (自分で解いてみよう)
- 練習問題 1: シグネチャ検知・挙動検知・ML 検知の長所と短所を、 それぞれ 1 文で述べよ。 解: シグネチャ=高速だが未知株に無力 / 挙動=ゼロデイに強いが誤検知増 / ML=中間でスケールしやすい。
- 練習問題 2: PE セクションのエントロピーが高い(例 7 超)と何が疑われるか。 解: パッキング / 暗号化された悪性コード。
- 練習問題 3: 不均衡なデータで accuracy だけを評価指標にすると何が起こるか説明せよ。 解: 多数派に偏った予測が高 accuracy を得るが実用性が低い。
- 練習問題 4: 混同行列で TP=80, TN=9900, FP=20, FN=10 のとき、 recall と誤検知率を計算せよ。 解: recall=80/90≒0.889, FPR=20/9920≒0.002。
- 練習問題 5: マルウェア検知における「偽陰性」と「偽陽性」の重大度を比較せよ。 解: 偽陰性 (悪性を見逃し) の方が一般に重大。
- 練習問題 6: ⚠️ のファミリ単位の実験で、行をシャッフルした分割の AUC は 0.981、ファミリ単位の分割では 0.908 だった。新しいファミリが毎月現れる環境で使う検知器の性能として、どちらを報告すべきか。 解: 0.908。本番で見逃しが問題になるのは訓練に無いファミリで、行シャッフルの 0.981 は同じファミリの亜種を訓練で見ていた分だけ甘い。
- 練習問題 7: 1〜6 月で学習した検知器の 12 月の検知率は 0.04、毎月再学習した検知器でも 0.17 だった。再学習さえすれば concept drift は解決すると言えるか。 解: 言えない。攻撃側が良性に似せ続けると、過去のデータで学習し直しても追いつかない。劣化の監視(月ごとの検知率)と、動的解析・人の確認を組み合わせる。
- 練習問題 8: 見逃し 1 件の損失が誤警報 1 件の 10 倍のとき、閾値 0.5 と 0.1 の期待コストを 🧮 の表から計算せよ。 解: 0.5 は 10 × 578 + 90 = 5,870、0.1 は 10 × 109 + 963 = 2,053。誤警報が 10 倍以上に増えても、見逃しの減り方の方が効くので 0.1 の方が損失は小さい。
- 練習問題 9: 🔬 の実験で、SSDSE-B-2026.csv の先頭 20,000 バイトのエントロピーは 4.227、zlib で圧縮すると 7.977 ビット/バイトだった。あるファイルのセクションのエントロピーが 7.9 だったとき、マルウェアと判定してよいか。 解: よくない。7.9 は中身が圧縮か暗号化されていることを示すだけで、正規の圧縮ファイルや画像でも同じ値になる。パッキングの疑いとして、他の特徴と組み合わせて判断する。
- 練習問題 10: ⚠️ の実験で、悪性の割合を 30% から 0.1% に下げると ROC-AUC は 0.961 → 0.967 とほぼ同じなのに、PR-AUC は 0.924 → 0.180 に下がった。理由を 1 文で説明せよ。 解: ROC の誤検知率は良性の中の割合なので良性が増えても変わらないが、適合率は誤警報の件数で決まり、良性が悪性の 999 倍もあれば誤警報が警報の大半を占めるから。
- 練習問題 11: 🐍 のハッシュの実験で、19,999/20,000 バイトが同じ亜種の SHA-256 は元と 114 ビット違った。シグネチャ DB を「似ている検体も当てられる」ように変えるには、どんな照合に切り替えればよいか。 解: ハッシュの完全一致をやめ、似た入力ほど近い値になるファジーハッシュの類似度や、特徴的なバイト列・文字列を部分一致で探すルール(YARA)、特徴量からの機械学習に切り替える。代わりに誤検知が増えるので、閾値の設定と評価が必要になる。
- 練習問題 12: 🎮 の後の実験で、IsolationForest は良性 3,000 件中 34 件を誤検知した。1 日に良性ファイルを 100 万件検査する環境では、誤警報はおよそ何件になるか。また、その件数を減らすためにできることを 1 つ挙げよ。 解: 34 ÷ 3,000 ≈ 1.1% なので約 1.1 万件。contamination(異常とみなす割合)を下げる、既知の良性(署名付きの正規ソフトなど)を先に除外する、異常検知の警報をサンドボックスで自動確認してから人に回す、など。
- 練習問題 13: 📐 の式 t* = CFP ÷ (CFP + CFN) で、見逃し 1 件の損失が誤警報 1 件の 100 倍のとき、閾値はいくらになるか。そのとき警報の件数はどうなると予想できるか。 解: t* = 1 ÷ 101 ≈ 0.0099。悪性確率が 1% を超えただけで警報を出すことになるので、警報は大きく増え、その大半は誤警報になる(🧮 の表でも閾値 0.1 で誤警報は 963 件)。警報を確認する人手が足りるかどうかも、閾値を決める条件に入れる。
- 練習問題 14: 評価データでは悪性が 29%(🧮 の実験)、実運用ではおよそ 0.1% だとする。評価データで決めた閾値をそのまま実運用に使うと、適合率はどちらの方向にずれるか。 解: 下がる。検知率と誤検知率が同じでも、良性が相対的に何百倍にも増えるので、誤警報の件数が正しい警報を大きく上回る(📉 の基準率の節、⚠️ の PR-AUC の実験)。
❓ よくある質問 (FAQ)
Q1. accuracy だけでマルウェア検知を評価できますか?
A1. できません。 不均衡データでは「全部良性と予測」しても 99% accuracy になります。 F1, AUC, PR-AUC を併用するのが標準です。
Q2. 閾値はどう決めますか?
A2. ROC 曲線上で recall を優先するなら左寄り (閾値を下げる)、 precision を優先するなら右寄り (閾値を上げる)。 業務要件で決めるのが原則です。
Q3. 不均衡データへの SMOTE の弱点は?
A3. 高次元では合成サンプルが意味を持ちにくく、 過学習しやすいです。 マルウェアでは静的解析の特徴量が高次元になりがちなので、 慎重な評価が必要です。
Q4. 異常検知と分類検知のどちらが優れていますか?
A4. 既知のマルウェアには分類検知、 未知のマルウェア (ゼロデイ) には異常検知が向きます。 実運用では両者を併用するのが標準です。
Q5. 実マルウェアを扱わずに検知の勉強はできますか?
A5. EMBER や SOREL-20M のような「抽出済み特徴量」の公開データセットを使えば、 実検体を直接扱わずに「不均衡データの分類」「閾値選択」「混同行列の読み方」など検知の基礎原理を安全に練習できます。
最終まとめ
マルウェア検知は「特徴量 → ラベル」の分類問題として定式化でき、 統計学・機械学習・データサイエンスの応用として中核的な位置を占めます。 検知の実践では、 不均衡データの扱い、 閾値選択、 混同行列の読み方、 異常検知の発想などがコアスキルになります。 実際のマルウェア検知では、 特徴量設計、 ゼロデイへの対応、 敵対的環境での運用、 MLOps による継続的再学習など、 多くの追加要件がありますが、 基礎は本ページの内容で押さえられます。
🧾 発表前の最終確認
マルウェア対策を説明する時は、 種類、侵入経路、検知方法、隔離、復旧、再発防止を分けます。 単に危険性を述べるだけでなく、 ログ、バックアップ、権限管理、更新管理を具体策として結びつけます。
⚠️ よくある落とし穴
📝 演習問題(5 問)
- 演習 1:EMBER-2018 を読み込み、 静的特徴 2,381 次元で LightGBM を学習し、 検証 AUC ≥ 0.99 を達成せよ。
- 演習 2:PE エントロピー特徴のみで決定木を学習し、 「悪性 / 良性」の判定境界エントロピーを求めよ。
- 演習 3:正常プロセスの API 呼び出しプロファイルに IsolationForest を適用し、 外れ値(未知マルウェア候補)を検出してみよ(異常検知応用)。
- 演習 4:CNN にバイナリ画像 (256×256 グレースケール) を入力し、 マルウェアファミリ 9 クラス分類器を作れ。
- 演習 5:訓練 (2018) / 検証 (2019) / 本番 (2021) で性能劣化を測定し、 Concept Drift を可視化せよ。
📖 関連用語辞典(10 語)
- ウイルス
- 宿主ファイルに感染する古典マルウェア
- ランサムウェア
- 暗号化身代金型。 LockBit 等
- トロイの木馬
- 合法アプリ偽装。 Emotet
- スパイウェア
- 情報窃取。 キーロガー含む
- ルートキット
- OS カーネルに潜伏
- EMBER
- Endgame 公開のマルウェア特徴データセット
- Sandbox
- Cuckoo 等。 動的解析環境
- PE フォーマット
- Windows 実行形式。 静的解析対象
- YARA
- パターンマッチング DSL
- Concept Drift
- 時間経過でのデータ分布変化
⚠️ 実際に確かめる — 同じファミリの亜種が訓練とテストに分かれると AUC が膨らむ
マルウェアは 1 つのファミリから少しずつ違う亜種が大量に作られる。行ごとにシャッフルして分割すると、テストに入った亜種の「兄弟」が訓練にいるので、未知のファミリに対する実力より高いスコアが出る。SSDSE にはマルウェアのデータが無いので、ファミリ構造を持つ架空(合成)の特徴量で分け方だけを変えて比べる。
🎯 このコードでやること:架空の静的特徴量 8 次元(悪性 60 ファミリ × 20 亜種 = 1,200 件、良性 3,000 件、seed 固定)にランダムフォレストを当て、行をシャッフルした 5 分割と、ファミリ単位の 5 分割(GroupKFold)の AUC を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import StratifiedKFold, GroupKFold, cross_val_score # 架空(合成)の静的特徴量:実在の検体とは無関係。seed 固定で決定的に生成 rng = np.random.default_rng(0) n_fam, per_fam, n_benign, d = 60, 20, 3000, 8 centers = rng.normal(0.8, 1.0, size=(n_fam, d)) # ファミリごとの特徴の中心 X_mal = np.vstack([c + rng.normal(0, 0.35, size=(per_fam, d)) for c in centers]) fam = np.repeat(np.arange(n_fam), per_fam) # 亜種がどのファミリか X_ben = rng.normal(0, 1.0, size=(n_benign, d)) X = np.vstack([X_mal, X_ben]) y = np.r_[np.ones(len(X_mal)), np.zeros(n_benign)] groups = np.r_[fam, n_fam + np.arange(n_benign)] # 良性は 1 件ずつ別グループ print('悪性', int(y.sum()), '件(', n_fam, 'ファミリ × ', per_fam, '亜種) / 良性', n_benign, '件') rf = RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=-1) auc_row = cross_val_score(rf, X, y, cv=StratifiedKFold(5, shuffle=True, random_state=0), scoring='roc_auc') auc_fam = cross_val_score(rf, X, y, cv=GroupKFold(5), groups=groups, scoring='roc_auc') print(f'行をシャッフルして 5 分割(同じファミリが訓練とテストに分かれる) AUC = {auc_row.mean():.3f}') print(f'ファミリ単位で 5 分割(テストのファミリは訓練に無い) AUC = {auc_fam.mean():.3f}') |
💬 行をシャッフルすると AUC 0.981、ファミリ単位に分けると 0.908 で、差の 0.073 は「同じファミリの兄弟を訓練で見ていた」ことによる水増しである。本番で問題になるのは訓練に無いファミリなので、報告すべきは 0.908 の側になる。実データでも、ハッシュが違うだけの亜種や同じパッカーで包んだ検体は、ファミリ名・類似度で束ねてから分割する(🧩 の「ファミリ単位のリーク」)。
⚠️ 実際に確かめる — 学習した時点から離れるほど検知率が落ちる(concept drift)
攻撃者は検知を逃れるように手口を変えるので、過去の検体で作った検知器は未来の検体で成績が落ちる。架空(合成)のデータで、毎月新しいファミリが現れ、月が進むほど特徴が良性に似せられていく状況を作り、学習したままのモデルと毎月再学習するモデルを比べる。
🎯 このコードでやること:1〜12 月の架空データ(毎月 悪性 10 ファミリ × 20 亜種 = 200 件と良性 500 件)で、1〜6 月だけで学習したモデルと、前月までの全データで毎月学習し直すモデルの、7〜12 月の AUC と検知率(閾値 0.5)を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import roc_auc_score, recall_score # 架空(合成)データ:毎月新しいファミリが現れ、月が進むほど特徴が良性に似せられていく rng = np.random.default_rng(1) d, months = 8, 12 rows = [] for m in range(1, months + 1): shift = 1.2 - 0.08 * m # 悪性の中心が月ごとに良性(0)へ近づく for _ in range(10): # 毎月 10 ファミリ × 20 亜種 c = rng.normal(shift, 0.6, size=d) rows += [(m, 1, c + rng.normal(0, 0.35, size=d)) for _ in range(20)] rows += [(m, 0, rng.normal(0, 1.0, size=d)) for _ in range(500)] month = np.array([r[0] for r in rows]); y = np.array([r[1] for r in rows]); X = np.array([r[2] for r in rows]) from sklearn.model_selection import StratifiedKFold, cross_val_score rf = RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=-1) in_cv = cross_val_score(rf, X[month <= 6], y[month <= 6], cv=StratifiedKFold(5, shuffle=True, random_state=0), scoring='roc_auc') print(f'1〜6 月の中で行をシャッフルした 5 分割 AUC = {in_cv.mean():.3f}(学習期間の中だけの評価)') fixed = rf.fit(X[month <= 6], y[month <= 6]) print('月 | 1〜6 月で学習したまま | 前月までの全データで毎月再学習') for m in range(7, months + 1): te = month == m p0 = fixed.predict_proba(X[te])[:, 1] upd = RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=-1).fit(X[month < m], y[month < m]) p1 = upd.predict_proba(X[te])[:, 1] print(f'{m:2d} | AUC {roc_auc_score(y[te], p0):.3f} 検知率 {recall_score(y[te], p0 >= 0.5):.2f} ' f'| AUC {roc_auc_score(y[te], p1):.3f} 検知率 {recall_score(y[te], p1 >= 0.5):.2f}') |
💬 学習期間の中で行をシャッフルした評価では AUC 0.992 と完璧に近いのに、学習したままのモデルは 7 月の 0.938 から 12 月の 0.601 まで下がり、検知率は 0.52 から 0.04 になる。毎月再学習すると 12 月でも AUC 0.791・検知率 0.17 を保つが、それでも 7 月より低い。攻撃側が良性に寄せてくる限り、再学習は劣化を遅らせるだけで止めはしないので、動的解析や人の判断を組み合わせる。評価は必ず「過去で学習して未来でテスト」の時間分割で行い、学習期間内のシャッフル評価(0.992)を性能として報告しない。
⚠️ 実際に確かめる — 悪性が希少になると ROC-AUC は変わらず PR-AUC だけが下がる
🎯 このコードでやること:良性と悪性のスコア分布を固定した架空の検知器を、悪性の割合が 30%・1%・0.1% の検査対象に当て、ROC-AUC と PR-AUC(平均適合率)を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np from sklearn.metrics import roc_auc_score, average_precision_score # 架空(合成)の検知スコア:同じ検知器(悪性と良性のスコア分布は固定)を、悪性の割合だけ変えた検査対象に当てる rng = np.random.default_rng(0) n_benign = 200_000 s_benign = rng.normal(0.0, 1.0, n_benign) # 良性のスコア for rate in [0.30, 0.01, 0.001]: n_mal = int(round(n_benign * rate / (1 - rate))) s_mal = rng.normal(2.5, 1.0, n_mal) # 悪性のスコア(良性より 2.5 高い) s = np.r_[s_mal, s_benign]; y = np.r_[np.ones(n_mal), np.zeros(n_benign)] print(f'悪性の割合 {rate:6.1%}(悪性 {n_mal:6d} 件) ROC-AUC = {roc_auc_score(y, s):.3f} ' f'PR-AUC(平均適合率)= {average_precision_score(y, s):.3f}') |
💬 同じ検知器なので ROC-AUC は 0.961〜0.967 とほとんど変わらないが、PR-AUC は 30% で 0.924、1% で 0.478、0.1% で 0.180 まで下がる。ROC 曲線の横軸の誤検知率は「良性のうち何割を誤ったか」で、良性の件数が何倍になっても変わらないのに対し、適合率は誤警報の件数そのもので決まるからである(🧮 の基準率の節と同じ仕組み)。評価用に悪性を多めに集めたデータで ROC-AUC 0.96 と報告しても、実運用で警報をどれだけ信じてよいかは分からないので、実運用に近い割合での PR-AUC か適合率を併せて示す。
🧩 深掘り追記 — 既存解説と別角度から
本セクションは既存の「直感/落とし穴/発展」を壊さず補う追記です。 上の 5 つの落とし穴(シグネチャ依存・クラス不均衡・concept drift・敵対的攻撃・人的要因)とは重複しない別角度だけを簡潔にまとめます。 数値例はすべて架空(合成)の説明用で、 実在の検体・データセットの実測値ではありません(マルウェアは SSDSE には含まれないため、 公的統計の捏造は行いません)。
🎨 直感の追記:検知は「当てるゲーム」ではなく「損失を最小化するゲーム」
上部の「直感」は検知の仕組み(3 層防御)を説明しました。 ここでは別の視点としてコストの非対称性を足します。 マルウェア検知の目的は正解率を上げることではなく、 被害の期待コストを最小化することです。 見逃し(FN)は 1 件で「全社ランサム暗号化・情報流出」という桁違いの損失を生む一方、 誤検知(FP)は「アナリストが数分かけて無害と確認する」コストで済むことが多い。 両者のコストが非対称だからこそ、 実務ではわざと誤検知寄りに閾値を倒すのが合理的です。 メタファは空港の手荷物検査で、 爆発物の見逃しコストが甚大なので、 多少の手作業検査(誤検知)を許容して検出側に倒します。 この「期待コスト最小化」の発想は 分類の閾値選択そのもので、 適合率と再現率のどちらを優先するかをビジネス上のコストで決めるという一段深い理解につながります。
⚠️ 落とし穴の追記(重要):既存 5 件と別系統の 5 つ
既存の 5 件は主に「モデルと攻撃者」の話でした。 以下は主に「評価とデータの作り方」で足をすくわれる、 見落とされがちな別系統の罠です。
- ベースレート錯誤で適合率が崩壊する:FPR が低くても、 悪性が極端に希少だと適合率(precision)は簡単に崩れます。 架空の合成例で、 基準率(悪性の割合)0.1%・再現率 90%・特異度 99.8%(=FPR 0.2%)を 100 万件に当てると、 TP=900 に対し FP=1,998 となり、 適合率=900/(900+1,998)≒31%。 「FPR 0.2% は優秀」に見えても、 悪性判定の 7 割が誤検知という現場になります。 accuracy や FPR だけでなく 適合率・PR 曲線で必ず確認します。 これは クラス不均衡の「評価が歪む」話を、 ベイズの基準率の側から捉え直した角度です。
- ラベルノイズ(正解が揺れる):教師ラベルの多くは複数 AV エンジンの多数決に由来しますが、 ベンダ間で判定が食い違い、 さらに検体は時間が経ってから悪性と判明することがあります。 収集時点で「良性」と付けたサンプルが後日「悪性」に化ける以上、 ラベルの質が精度の上限を決めます。 アノテーションの設計(複数エンジンの合意閾値・ラベル確定までの待機期間)を評価前提として明記します。
- ファミリ単位のリーク:同一マルウェアファミリの亜種をランダム分割すると、 ほぼ同じ検体が訓練とテストの両方に入り、 AUC が楽観的に膨らみます。 テストでの高スコアが本番の未知株では再現しません。 ファミリ単位・ハッシュ単位で重複排除してから分割するのが鉄則です(単なる行シャッフルとは別物)。
- 時間軸を無視した評価:攻撃は時間とともに変わるので、 過去で学習→未来で評価する時系列分割(temporal split)にしないと、 本番で必ず起きる drift を評価段階で見逃します。 未来の良性・悪性がうっかり訓練に混じる「時間リーク」は特に危険です。
- サンドボックス回避で動的特徴が空振り:解析環境を検知するマルウェア(仮想環境チェック・長時間スリープ・stalling code)は、 サンドボックス内では無害を装って本来の挙動を見せません。 動的解析の特徴量が「何も起きなかった」で埋まり、 静かに検知力が落ちます。 静的・動的・実機テレメトリを併用し、 「無挙動 = 安全」と決めつけないことが要点です。
🚀 発展の追記:特徴量・コスト・共有という 3 つの伸ばし方
- 生バイト列の end-to-end 検知:PE ヘッダやエントロピーを人手設計する代わりに、 実行ファイルの生バイト列をそのまま畳み込みネットに入れる(MalConv 系)アプローチ。 特徴量エンジニアリングの負担を消せますが、 解釈が難しくなるトレードオフがあります。 詳しくは 深層学習 を参照。
- コスト考慮学習(cost-sensitive learning):FN と FP のコスト差を損失関数やクラス重みに直接組み込み、 期待コストを最小化する閾値を学習で選ぶ。 上の「直感の追記」を実装レベルに落とした発展です。 木系なら ランダムフォレストの class_weight が入口。
- 説明可能性でトリアージ:SHAP などで「なぜ悪性と判定したか」(どの import 関数・どのセクションが効いたか)をアナリストに提示すると、 アラートの優先順位付けが速くなりアラート疲れを緩和できます。 検知の自動化と人の判断の橋渡しになります。
- 脅威インテリジェンス共有:IOC(侵害指標)を STIX/TAXII や MISP で組織横断的に共有すると、 自組織にとっての未知が「他所の既知」に変わり、 ゼロデイの窓を短くできます。 未知の新種ファミリに備えるオープンセット認識(学習時に無かったクラスを「未知」として扱う枠組み)とも相性が良い視点です。
🔗 この追記に関連するページ
🗺 概念マップ
マルウェアを中心に、 ウイルス・ワーム・トロイ・ランサムウェア・スパイウェアの分類と、 検知 (signature / behavior / ML)・防御 (EDR / WAF)・対応 (SOC / IR) の三層を整理した概念マップ。
マルウェアの分類 (ウイルス / ワーム / ランサムウェア / RAT) は、 増殖方式・ペイロード・C2 通信の有無で区分される。 検出は MITRE ATT&CK のテクニック ID に対応付けて報告する。
🔗 隣接手法への橋渡し
マルウェア対策は単一の検知器では完結しない。 上流のエンドポイント監視 (EDR) と通信ログ、 並列のシグネチャマッチ + 振る舞い分析 + ML 分類器、 下流のインシデント対応 (SOC) を多層で組み合わせる多層防御が前提となる。
- 上流 (前段処理): ハッシュ / メタデータ収集 — 検体ファイルからの特徴抽出
- 並列 (代替/比較): 脆弱性管理 / IDS — 同じ攻撃面に対する別レイヤ防御
- 下流 (後段活用): インシデント対応 / フォレンジック — 検出後の封じ込めと根本原因分析
実データではマルウェア検体特徴量 (API call 列・PE ヘッダ・エントロピー) を入力に、 ML で benign/malicious 分類して accuracy/recall を測り、 検知後は隔離 → 解析 → 再発防止策まで連動させるのが業界標準。
🌳 概念ツリー
🌳 概念ツリー
🌳 「マルウェア」の概念ツリー
├── 上位概念
│   ├── 情報セキュリティ
│   │   ├── 機密性 (Confidentiality)
│   │   ├── 完全性 (Integrity)
│   │   └── 可用性 (Availability)
│   └── サイバー攻撃 (cyber-attack)
│       ├── 受動的攻撃 (盗聴・トラフィック解析)
│       ├── 能動的攻撃 (改ざん・なりすまし)
│       └── ソーシャルエンジニアリング (フィッシング)
├── 並列概念(同レベル攻撃手法)
│   ├── DDoS (分散型サービス妨害)
│   ├── ゼロデイ攻撃 (パッチ未公開脆弱性)
│   └── サプライチェーン攻撃
├── マルウェア 本体(種別)
│   ├── 自己複製型
│   │   ├── ウイルス (宿主必要)
│   │   ├── ワーム (単独で増殖)
│   │   └── ボット (C2 サーバ制御)
│   ├── 隠蔽型
│   │   ├── トロイの木馬 (有用ソフト偽装)
│   │   ├── ルートキット (OS 深層に常駐)
│   │   └── ファイルレス (メモリ常駐)
│   └── 経済目的型
│       ├── ランサムウェア (身代金要求)
│       ├── スパイウェア / キーロガー
│       └── クリプトジャッキング (採掘乗っ取り)
└── 下位/発展概念(防御・解析)
    ├── アンチウイルス / EDR / XDR
    ├── サンドボックス動的解析 (Cuckoo)
    ├── YARA ルール / シグネチャ DB
    ├── ML ベース検知 (n-gram + Random Forest)
    └── MITRE ATT&CK フレームワーク
🌳 手法選択フロー — どの検知・防御を組み合わせるか
マルウェア対策の手法選択は、 (1) 既知/未知の判別、 (2) 検出と防御の段階、 (3) リソース制約、 で判断する。 シグネチャ・ヒューリスティック・ML 分類・サンドボックス・EDR を多層で配置するのが基本。
- Step 1: 既知の脅威か未知の脅威か?
- 既知 (ハッシュ / シグネチャ済み) → SHA-256 などのハッシュ照合 + YARA ルール
- 未知の亜種 → ヒューリスティック分析 + 機械学習分類器 (n-gram + Random Forest)
- 標的型 / APT → サンドボックス動的解析 + 振る舞いベース EDR
- Step 2: 検知・防御・対応のどの段階?
- 事前防御 → アプリケーション許可リスト (AppLocker) + パッチ管理
- 実行時検知 → AV エンジン + EDR + ネットワーク IDS (Suricata)
- 事後対応 → フォレンジック (Volatility) + IoC 共有 (MISP / STIX)
- Step 3: 環境とリソースは?
- エンドポイント (PC / サーバ) → EDR (CrowdStrike / SentinelOne / Defender ATP)
- クラウド / コンテナ → CWPP + イメージスキャン (Trivy / Snyk)
- 組込 / IoT → 軽量シグネチャ + ファームウェア署名検証
例えば製造業の社内ネットワークなら、 (1) 端末は EDR + AV、 (2) サーバはアプリ許可リスト + ファイル整合性監視 (Tripwire / OSSEC)、 (3) 境界は次世代ファイアウォール + サンドボックス、 を多層配置する。 検知ログは SIEM (Splunk / Sentinel) に集約し、 ML で異常スコアリングして SOC が対応する流れが標準。