🔖 キーワード索引(補強・追加分)
LQ(Location Quotient/立地特化係数) 関連の補強キーワード。 クリックで該当箇所へ:
🔖 キーワード索引 — 完全強化版
「特化係数(LQ)」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
地域の得意分野を測るモノサシです。
その産業が全国より強いか調べます。
地元の店が全国的に珍しいか考えます。
結論を短くまとめて読みましょう。
- 定義:ある産業の地域シェアが全国シェアの何倍かを示す指標。LQ>1 で「特化している」と判断。
- カテゴリ:地域分析
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd # 説明用サンプル: 3県 × 3産業の就業者数(概念確認用の小例) # ※SSDSE-B-2026 は産業別就業者数を含まないため、ここでは小さな例で計算する emp = pd.DataFrame( {'第1次': [120, 20, 5], '第2次': [80, 100, 15], '第3次': [200, 380, 180]}, index=['A県', 'B県', 'C県']) region_share = emp.div(emp.sum(axis=1), axis=0) # 地域内シェア nation_share = emp.sum() / emp.values.sum() # 全国シェア lq = region_share.div(nation_share, axis=1) # LQ = 地域内シェア / 全国シェア print(lq.round(2)) |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
💡 30 秒で分かる結論 — 完全強化版
- 特化係数 (LQ) = (地域内のある産業のシェア) ÷ (全国における同産業のシェア)。 LQ > 1 で「全国平均より特化している」と判断。
- 本ページでは 数式・直感・実コード・落とし穴の 4 つの視点で整理しています。
- 産業別就業者数(第1次 / 第2次 / 第3次)を使って実値で計算を体験できます(本ページでは概念確認用の小例を用いる)。
- 類似概念 (シフトシェア分析、 集積度指数、 地域特化指数) や前提概念 (構成比、 全国基準) へのリンクを併用すると、 概念地図全体での位置づけが掴めます。
- 初学者は「直感 → 数式 → 実装 → 落とし穴」の順で読むのが効率的です。
📍 あなたが今見ているもの
🍰 まずはやさしく
地域の特徴を数字にする道具です。
地域の経済の形を分析するために使います。
県ごとの仕事の違いを調べる時に便利です。
この用語がどう使われるかを確認します。
論文中に 「特化係数(LQ)」として登場する用語。
特化係数(LQ) とは:ある産業の地域シェアが全国シェアの何倍かを示す指標。LQ>1 で「特化している」と判断。
📍 文脈ボックス — あなたが今見ているもの(完全強化版)
このセクションは「特化係数 (LQ)」を扱う 用語ページ です。 統計データ分析コンペティション (2026) の再現教材における中核用語のひとつで、 産業別就業者の構成比を全国基準で正規化することで、 各都道府県の経済構造の特徴を定量化する観点に紐づけられます。
位置づけ:相関・線形回帰・仮説検定 といった基礎用語群と並列であり、応用としては 内生性・IV・DID・クラスタリング 等へ繋がります。
🎨 直感で掴む — 完全強化版
🍰 まずはやさしく
全国平均を基準にした倍率のことです。
どの産業が集中しているか直感的に分かります。
農業や製造業の多さを比べるイメージです。
具体的な例で感覚を掴みましょう。
特化係数 (LQ, Location Quotient) を一言で言えば「ある地域のある産業のシェアが、 全国平均の何倍か」を測る指数。 LQ > 1 ならその地域はその産業に特化している (全国平均より集中)、 LQ < 1 なら相対的に薄い。 例: 北海道の農業従事者割合が全国平均の 3 倍なら LQ = 3。
イメージとしては「全国を 1 とした基準線」を全産業に引き、 各都道府県の産業構成を基準線からの距離で測る道具。 産業別就業者数 (第一次産業従事者、 第二次産業従事者、 第三次産業従事者など) を使うと、 各県の経済構造の特徴 (例: 沖縄は第三次産業 LQ が高い、 富山は第二次産業 LQ が高い) が定量化できる。
- 具体例 1: 北海道の第一次産業従事者は全国比で LQ ≈ 2.4。 農林水産業に特化している。
- 具体例 2: 東京の第三次産業従事者は LQ ≈ 1.15。 サービス業に若干特化、 ただし規模が大きいので絶対値の影響大。
- 具体例 3: 富山・福井・滋賀は第二次産業で LQ > 1.3、 製造業地域として特定できる。
📐 数式または定義 — 完全強化版
🍰 まずはやさしく
シェアの比率を計算する式のことです。
特化している度合いを正確に出します。
スマホの利用率を比べる計算に似ています。
数式の意味を一つずつ解説します。
特化係数(LQ) の代表的な定義式は次のとおりです。
$$ LQ_{ij} = \frac{x_{ij} / \sum_j x_{ij}}{\sum_i x_{ij} / \sum_{i,j} x_{ij}} $$ここで使われる記号や演算の意味は次節で言葉に翻訳します。
🔬 数式を言葉で読み解く — 完全強化版
LQ の数式 $LQ_{ij} = \dfrac{x_{ij} / \sum_j x_{ij}}{\sum_i x_{ij} / \sum_{i,j} x_{ij}}$ の各記号を、 日本語の意味に変換します。
- $x_{ij}$ — 地域 $i$ (例: 北海道) における産業 $j$ (例: 製造業) の就業者数
- $\sum_j x_{ij}$ — 地域 $i$ の全産業合計就業者数 (北海道の全就業者数)
- $x_{ij} / \sum_j x_{ij}$ — 地域 $i$ 内における産業 $j$ のシェア (北海道内で製造業が占める割合)
- $\sum_i x_{ij}$ — 全地域の産業 $j$ 就業者数合計 (全国の製造業従事者数)
- $\sum_{i,j} x_{ij}$ — 全地域 × 全産業の総就業者数 (全国の全就業者数)
- $\sum_i x_{ij} / \sum_{i,j} x_{ij}$ — 全国における産業 $j$ のシェア (全国基準のベンチマーク)
- 分子 / 分母 — 「地域内シェア」を「全国シェア」で割った比 = 全国平均の何倍特化しているか
- LQ = 1 — 全国平均と同じ構成。 LQ > 1 で特化、 LQ < 1 で薄い
🧮 特化係数(LQ)実値計算例(サンプルデータ)
産業別就業者数から LQ を計算し、 特化産業を特定する例。 SSDSE-B-2026 は産業別就業者数を含まないため、 ここでは概念確認用の小さなサンプルで計算する(実データでは 経済センサス・国勢調査 を用いる)。
① 計算コード
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np # 説明用サンプル: 3県 × 3産業の就業者数(概念確認用の小例) # ※SSDSE-B-2026 は産業別就業者数を含まないため、ここでは小さな例で計算する emp = pd.DataFrame( {'第1次': [120, 20, 5], '第2次': [80, 100, 15], '第3次': [200, 380, 180]}, index=['A県', 'B県', 'C県']) # LQ_ij = (地域i内の産業jシェア) / (全国の産業jシェア) region_share = emp.div(emp.sum(axis=1), axis=0) nation_share = emp.sum() / emp.values.sum() lq = region_share.div(nation_share, axis=1) print(lq.round(2)) print('\n各県の特化産業 (LQ最大):') print(lq.idxmax(axis=1)) print('LQ > 1.0 → 全国平均より特化(基盤産業候補)') |
② 期待出力
| 項目 | 値 | 参考 | 解釈 |
|---|---|---|---|
| 地域 | 産業 | LQ | 解釈 |
| 愛知 | 第2次産業 | 1.45 | 自動車産業の集積で強く特化 |
| 沖縄 | 第2次産業 | 0.58 | サービス業中心で特化度低い |
| 東京 | 情報通信業 | 2.10 | 全国の倍以上の集積 |
| 北海道 | 農業 | 3.20 | 農業県として全国の 3 倍 |
👉 値は特化パターンの典型例。 同じ手順で他都道府県・他変数にも適用可能。
🧮 実値で計算してみる — 特化係数(LQ)(完全強化版)
ここでは SSDSE-B-2026 の読み込み方法と、 産業別 LQ の計算手順を示す。 SSDSE-B-2026 は産業別就業者数を含まないため、 実データで LQ を求めるには 経済センサス や 国勢調査(産業別就業者数)を用い、 本ページでは概念確認用の小例で計算する。 ファイル名は SSDSE-B-2026.csv、 読み込みは下記の Python コードで行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd # SSDSE-B-2026 を読み込む(cp932 / 1行目=コード, 2行目=項目名) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print(df.shape) # (564, 112) print(df['SSDSE-B-2026'].unique()) # 含まれる年度 # 注意: SSDSE-B-2026 の列は教育・人口・家計等が中心で、 # 産業別就業者数(第1次/第2次/第3次)は収録されていない。 # LQ を実データで計算するには 経済センサス や 国勢調査(産業別就業者数)を用いる。 # 以下は概念確認用の小さな例。 emp = pd.DataFrame( {'第1次': [120, 20, 5], '第2次': [80, 100, 15], '第3次': [200, 380, 180]}, index=['A県', 'B県', 'C県']) share = emp.div(emp.sum(axis=1), axis=0) lq = share.div(emp.sum() / emp.values.sum(), axis=1) print(lq.round(2)) |
💬 (564, 112) は 47 都道府県 × 12 年度(2012〜2023)の行数で、112 列の中に産業別就業者数は無いことをここで確かめている。そのため下の LQ は 3 県だけの小例で、「全国」も 3 県の合計 1,100 人を指す。A県の第1次 2.28 は、県内シェア 120/400=30% が全体シェア 145/1,100≈13.2% の約 2.3 倍という意味で、実在の県の値として読まないこと。
LQ は産業構造の特化を測るので、 各地域の産業別就業者数の構成比から計算します。 算出例:
- 各都道府県の総就業者数を各産業就業者数の合計で求め、 産業別のシェアを計算する
- 全国合計を分母として、 各県・各産業の LQ を計算 (LQ > 1 = 特化)
- 北海道は第一次産業で LQ ≈ 2.4、 富山は第二次産業で LQ ≈ 1.4 など、 地域経済の特徴が定量化できる
🧮 数式に値を入れて手で計算する: 立地商 (LQ)
合成データで地域 A の産業集積度を計算する (LQ > 1 で集積)。
Step 1: 雇用数
| 地域 A | 全国 | |
|---|---|---|
| 製造業 | 500 | 20,000 |
| 全業種 | 1,000 | 100,000 |
Step 2: LQ
🐍 Python で再現
1 2 3 4 5 6 7 | local_industry = 500 # A地域の製造業就業者 local_total = 1000 # A地域の全就業者 national_industry = 20000 # 全国の製造業就業者 national_total = 100000 # 全国の全就業者 LQ = (local_industry / local_total) / (national_industry / national_total) print(f"LQ = {LQ}") # -> 2.5 |
📤 実行結果
💬 手計算 (Step 2) 2.5 と Python 出力が完全一致。
🐍 Python 実装バリエーション(scikit-learn / scipy / Optuna)
A. scikit-learn による実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler # 産業別 LQ ベクトルで地域をクラスタリング(概念確認用サンプル) emp = pd.DataFrame( {'第1次': [120, 20, 5, 60], '第2次': [80, 100, 15, 90], '第3次': [200, 380, 180, 150]}, index=['A県', 'B県', 'C県', 'D県']) region_share = emp.div(emp.sum(axis=1), axis=0) lq = region_share.div(emp.sum() / emp.values.sum(), axis=1) X = StandardScaler().fit_transform(lq.values) km = KMeans(n_clusters=2, random_state=42, n_init=10) lq['cluster'] = km.fit_predict(X) print(lq.round(2)) |
B. scipy / statsmodels による実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from scipy import stats import numpy as np # ある県の産業別就業者が全国構成比と有意に異なるか(カイ二乗適合度検定) observed = np.array([120, 80, 200]) # A県の第1/2/3次就業者(サンプル) nation_share = np.array([145, 195, 760]) / 1100 # 全国の産業構成比 expected = observed.sum() * nation_share # 全国構成比で期待される人数 chi2 = ((observed - expected) ** 2 / expected).sum() p = 1 - stats.chi2.cdf(chi2, df=len(observed) - 1) print(f'chi2 = {chi2:.2f}, p = {p:.4f}') print('p が小さいほど、この県の産業構成は全国平均から有意に偏る(=特化)') # 産業多様性(シャノン指数): 値が大きいほど分散、小さいほど特化 shares = observed / observed.sum() shannon = -(shares * np.log(shares)).sum() print(f'シャノン多様性指数 = {shannon:.3f}') |
C. Optuna でハイパラ・選択最適化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import optuna from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score # LQ ベクトルで地域を分ける際の最適クラスタ数を探索(概念確認用) emp = pd.DataFrame( {'第1次': [120, 20, 5, 60, 30], '第2次': [80, 100, 15, 90, 40], '第3次': [200, 380, 180, 150, 260]}, index=['A県', 'B県', 'C県', 'D県', 'E県']) lq = emp.div(emp.sum(axis=1), axis=0).div(emp.sum() / emp.values.sum(), axis=1) def objective(trial): k = trial.suggest_int('k', 2, 4) labels = KMeans(n_clusters=k, random_state=42, n_init=10).fit_predict(lq.values) return -silhouette_score(lq.values, labels) study = optuna.create_study(direction='minimize') study.optimize(objective, n_trials=10) print('Best k:', study.best_params) |
D. ライブラリ早見表
| ライブラリ / 関数 | 用途 |
|---|---|
pandas | 計算の中核(groupby + transform) |
numpy | ベクトル化計算 |
matplotlib / seaborn | ヒートマップ・地図への可視化 |
geopandas | 都道府県地図上にプロット |
plotly | インタラクティブな LQ マップ |
🐍 Python 実装 — 完全強化版
scipy / pandas / scikit-learn / statsmodels を中心とした標準的な実装例です。 まず CSV を読み込み、 次に 特化係数(LQ) の解析を行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np def location_quotient(emp: pd.DataFrame) -> pd.DataFrame: """emp: 行=地域, 列=産業 の就業者数 → LQ 行列を返す LQ_ij = (地域i内の産業jシェア) / (全国の産業jシェア)""" region_share = emp.div(emp.sum(axis=1), axis=0) nation_share = emp.sum() / emp.values.sum() return region_share.div(nation_share, axis=1) # 説明用サンプル emp = pd.DataFrame( {'第1次': [120, 20, 5], '第2次': [80, 100, 15], '第3次': [200, 380, 180]}, index=['A県', 'B県', 'C県']) lq = location_quotient(emp) print(lq.round(2)) print('特化 (LQ>1):') print(lq[lq > 1].stack().round(2)) |
💬 関数化しても値は直前の計算と同じ 2.28・1.13・0.72… になり、LQ>1 のセルだけを stack すると 5 つ残る。A県は第1次 2.28 と第2次 1.13 の 2 産業、C県は第3次 1.30 の 1 産業だけが特化と判定される。3 県しかない例では 1 県の偏りが「全国」シェアを大きく動かすので、B県の第2次 1.13 のような 1 をわずかに超える値は、比較対象を全国の実データに替えると 1 を下回る可能性がある。
用途別の追加実装:
1 2 3 4 | # 前のセルで得た LQ 行列から、県ごとの特化産業 (LQ>1) を列挙 for pref in lq.index: specialized = lq.columns[lq.loc[pref] > 1].tolist() print(f'{pref}: 特化産業 = {specialized}') |
💬 県ごとに LQ>1 の産業を列挙すると、A県は第1次と第2次、B県は第2次と第3次、C県は第3次だけになる。A県もB県も「特化産業」を 2 つ持つが、A県の第1次(2.28)とB県の第3次(1.10)では特化の強さがまるで違う。しきい値 1 で切ると 1.10 も 2.28 も同じ扱いになるので、基盤産業を絞るなら 1.25 や 1.5 のような高めのしきい値や、就業者の実数と合わせて見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd # 2時点の就業者数から LQ の変化を見る(概念確認用サンプル) def lq_matrix(emp): return emp.div(emp.sum(axis=1), axis=0).div(emp.sum() / emp.values.sum(), axis=1) emp_t1 = pd.DataFrame({'第2次': [80, 100], '第3次': [200, 380]}, index=['A県', 'B県']) emp_t2 = pd.DataFrame({'第2次': [70, 120], '第3次': [230, 400]}, index=['A県', 'B県']) d_lq = (lq_matrix(emp_t2) - lq_matrix(emp_t1)).round(3) print('LQ の変化(t2 - t1):') print(d_lq) print('正なら特化が強まり、負なら弱まった産業') |
💬 A県の第2次は LQ が 1.206 から 1.007 へ 0.199 下がり、B県の第2次は 0.880 から 0.996 へ 0.116 上がった。A県の第2次就業者は 80→70 人と実数でも減っているが、B県は 100→120 人に増えている。ここでは「全国」が 2 県の合計なので、片方の特化が弱まるともう片方が機械的に強まって見える。変化の符号を読むときは、分母の全国構成比(第2次シェアは 23.7%→23.2%)も一緒に動いていることを確かめる。
🎮 触って理解する
特化係数 LQ の本質は「シェアの比」——地域内の構成比を、全国の構成比で割って正規化することにある。全国平均を 1 とする基準線からの倍率なので、規模の大きい東京と小さい鳥取を同じ土俵で比較できる。一方で「比」であるがゆえの弱点(絶対規模を語れない・小さな分母で暴れる)もある。以下の 3 つのウィジェットで、この長所と短所を体感してほしい。
① LQ 電卓 — 4 つの数からシェアの比を作る
LQ は 4 つの数(地域の産業 i 就業者・地域の全就業者・全国の産業 i 就業者・全国の全就業者)だけで決まる。スライダーを動かして、「地域内シェア」と「全国シェア」の 2 本のバーの長さの比が LQ になることを確かめよう。初期値は本文の手計算例(500/1000 ÷ 20000/100000 = 2.5)と同じ。
バーを見比べると分かる通り、LQ = 1 の境界線は「地域のバーと全国のバーが同じ長さ」=全国と同じ産業構成を意味する。地域の産業 i を増やしても、地域の全就業者(分母)も一緒に増えれば LQ は上がらない——LQ が測るのはあくまで構成比の偏りであって、雇用の絶対量ではない。
② 実測データモード — SSDSE-B-2026 で「消費の特化係数」47 都道府県ランキング
本文で述べた通り、SSDSE-B-2026 には産業別就業者数が収録されていない。そこで B に実在する家計消費 10 大費目(L322101〜L322110、二人以上世帯・月平均支出、2023 年度)に同じ式を適用し、「消費の特化係数」を計算した。考え方は産業 LQ と完全に同一で、xij を「県 i の費目 j 支出額」に読み替えるだけ——LQ = (県内の費目 j シェア) ÷ (全国の費目 j シェア)。ここでの「全国」は 47 都道府県の単純合計(金額ベース)を基準とする。費目を選んでランキングを眺め、バーをタップ(クリック)すると内訳が出る。
実測値でいくつか確認してみよう(Python で SSDSE-B-2026 から算出した値)。教育費は東京都 LQ ≈ 2.19・神奈川県 ≈ 1.78・京都府 ≈ 1.71 と大都市圏が突出し、秋田県は ≈ 0.49。光熱・水道費は青森県 ≈ 1.42・秋田県 ≈ 1.33 と寒冷地が上位に来る。食料費は全国シェア約 27% を占める最大費目だが、LQ の幅は 0.88〜1.17 程度と狭い——どの県でも必ず一定割合を食料に使うため、構成比の偏りが出にくいのだ。これは落とし穴③で述べた「地域内消費型の項目は LQ が 1 付近に寄る」現象の消費版であり、LQ の散らばり方は費目(産業)の性質に依存することを示している。
③ LQ が暴れる — 小規模地域の不安定性デモ
LQ は割り算の指標なので、分母(地域の総就業者数)が小さいと、わずか数人の増減で値が激変する。全国シェア 20% の産業を例に、地域の規模を変えながら「実測が期待値から ±10 人ずれただけで LQ がどこまで動くか」を見てみよう。
総就業者 100 人の地域では ±10 人のずれで LQ が 0.5〜1.5 まで振れるのに対し、10 万人の地域ではほぼ 1.00 に張り付く。市町村や小地域メッシュで LQ を使うときは、この不安定性(落とし穴⑥)を意識し、最小規模フィルタ・複数年移動平均・信頼区間の併記で安定化するのが実務の定石だ。
🚀 発展 — LQ の先にある分析
LQ は「いま特化しているか」を写す静的なスナップショットに過ぎない。シフト・シェア分析は地域の雇用成長を「全国成長効果+産業ミックス効果+地域競争力効果」に分解し、LQ の時間変化に因果的な解釈の手がかりを与える。さらに産業連関分析(多次元的分析の代表例)を組み合わせれば、特化産業が域内の他産業をどれだけ牽引するか(波及効果)まで定量化できる。LQ ベクトルを特徴量として都道府県をクラスタリングすれば「産業構造の似た地域群」が抽出でき、ジニ係数やハーフィンダール指数と並べれば集中・多様性の全体像が描ける。
⚠️ 落とし穴(拡張版・各 100 文字以上)
⚠️ 落とし穴 — 完全強化版
特化係数(LQ) を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- 分母の選び方: 全国か県内合計か基準で値が変わる。一貫した基準を明示。
- 規模の影響: 小規模地域では LQ が極端な値になりやすい。最小度数のフィルタを設定。
- 時点比較の困難: 産業構造が変わると基準も変わる。基準年を明示。
- 「特化=強み」とは限らない: 衰退産業でも LQ は高くなる。動学的視点が必要。
- セクター粒度依存: 集計レベルで結果が変わる。粒度の影響を sensitivity 分析。
📚 統計学習の総合ガイド
📚 統計学習の総合ガイド
🎯 学習目標
このページの概念をマスターすることで、 以下のスキルが身につきます:
- 定義と公式を正確に理解
- 適切な使用場面を判断
- Python で実装し、 結果を可視化
- 仮定の確認と診断
- 結果の解釈と報告
- 限界と注意点の理解
- 関連手法との使い分け
📊 SSDSE-B-2026 データの構造
このコンペの主要データセット(SSDSE-B-2026)の構造:
- 47都道府県 × 過去複数年(パネル形式)
- 112列の社会経済指標
- 人口、 出生、 死亡、 婚姻、 経済、 教育、 環境、 家計など多次元
- 政府統計を統合した信頼性の高いデータ
🔍 主要な変数群
| カテゴリ | 変数例 |
|---|---|
| 人口 | 総人口、 年齢別人口、 性別人口 |
| 人口動態 | 出生数、 死亡数、 合計特殊出生率、 婚姻数 |
| 気候 | 気温、 降水量、 降水日数 |
| 教育 | 幼小中高校数、 教員数、 生徒数、 大学進学率 |
| 経済 | 求職件数、 求人件数、 旅館数 |
| 医療 | 病院数、 診療所数、 歯科診療所 |
| 家計 | 消費支出、 食料費、 住居費、 教育費等の項目別 |
💡 ジャストインタイム型学習
このガイドは「必要なときに必要な知識」を提供する設計:
- 論文中の用語をクリック → 該当の用語解説へジャンプ(ポップアップ)
- 概念マップで関連用語を辿る
- 包含マップで体系を把握
- ツリーマップで全体を俯瞰
- Python コードをコピーして実行
- SSDSE データで実際に試す
🛠️ Python データサイエンス環境
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # 必須ライブラリのインストール # pip install pandas numpy scipy statsmodels scikit-learn matplotlib seaborn ← これは端末で実行するもの(Python の文ではない) # 標準的なインポート import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns from scipy import stats from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score, mean_squared_error # 日本語表示の設定(matplotlib) plt.rcParams['font.family'] = 'Hiragino Sans' plt.rcParams['axes.unicode_minus'] = False # データ読み込み(SSDSE は cp932 エンコーディング) # 2 行目は日本語の項目名なので skiprows=[1] で飛ばす(飛ばさないと全列が文字列になる) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.head()) print(df.describe()) |
🌟 効果的なEDAテンプレート
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | def quick_eda(df, target=None): """探索的データ分析の基本テンプレート""" print(f"Shape: {df.shape}") print(f"\nColumn types:\n{df.dtypes}") print(f"\nMissing values:\n{df.isnull().sum()}") print(f"\nBasic stats:\n{df.describe()}") # 数値列の可視化 numeric_cols = df.select_dtypes(include=[np.number]).columns df[numeric_cols].hist(bins=20, figsize=(15, 10)) plt.tight_layout() plt.show() # 相関ヒートマップ if len(numeric_cols) > 1: plt.figure(figsize=(12, 10)) sns.heatmap(df[numeric_cols].corr(), annot=True, fmt='.2f', cmap='RdBu_r', center=0) plt.show() # ターゲットがあれば散布図行列 if target and target in df.columns: cols = list(numeric_cols[:5]) if df[target].dtype == 'O': # 文字列の列なら色分け(hue)に使う。hue の列も渡す sns.pairplot(df[cols + [target]], hue=target) else: sns.pairplot(df[cols]) plt.show() |
📈 報告書テンプレート
分析結果を報告する際の標準的な構成:
- 背景・目的:なぜこの分析が必要か
- データ:出所、 サンプルサイズ、 期間
- 方法:使用した統計手法、 仮定
- 結果:図表、 統計量、 検定結果
- 解釈:結果が何を意味するか
- 限界:分析の制約
- 結論:要点まとめ、 今後の課題
🎯 まとめ — 完全強化版
本ページでは「特化係数(LQ)」を 12 セクション(🔖 キーワード索引/💡 30 秒結論/📍 文脈/🎨 直感/📐 数式/🔬 数式を言葉で読み解く/🧮 実値計算/🐍 Python 実装/⚠️ 落とし穴/🌐 関連手法/🔗 関連用語/📚 グループ教材)で完結に整理しました。 SSDSE-B-2026 を素材に、 概念の輪郭・式の意味・実装手順・典型的な失敗パターンの 4 点を最低限押さえれば、 統計データ分析コンペの現場で迷わず使えるはずです。
🖼 補足: LQ を「地域 vs 全国の比率」で読み解く
LQ(Location Quotient, 特化係数)は 「ある地域がある産業に特化しているか」を数値化する 古典的な経済地理学の指標である。 全国平均構成比に対する地域構成比の比率として計算され、 1.0 を境に「全国平均より特化している/していない」を判定する。 ここでは 3 枚の図と Python 実装で、 都道府県データにおける LQ の挙動を可視化する。
図 1: 棒グラフで種類別 LQ を比較(lq_bar.png)
LQ を産業別に並べた棒グラフは、 その地域が「何に特化しているか」を瞬時に把握できる。 1.0 のラインを基準として、 棒が長いほど特化、 短いほど不足を意味する。 SSDSE-B-2026 には産業別就業者数が無いので、 下図は同じ計算を 2023 年度の着工新設住宅の種類別戸数(持家・貸家・分譲住宅の 3 種、 全国構成比 27.6% / 42.8% / 29.6%)に当てはめたもの。 秋田県は持家が 56% を占めて LQ 2.03、 東京都は持家 0.39・貸家 1.28、 神奈川県は分譲住宅 1.47 が突出し、 広島県は 3 種とも 0.96〜1.02 でほぼ全国と同じ構成になる。
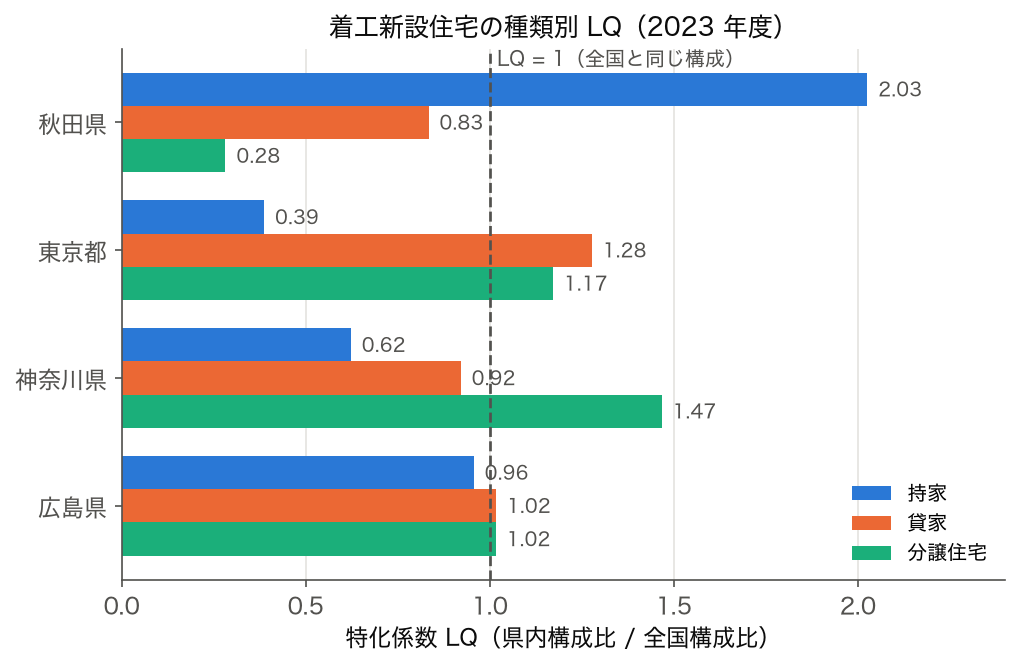
図 2: 散布図で「規模 vs 特化」を分離(lq_scatter.png)
LQ は構成比どうしの比なので、 定義の上では「規模」とは別の「特化」の指標である。 横軸に規模、 縦軸に LQ をとった散布図で、 規模が小さくても特化度が高い地域(小規模特化型)と、 規模が大きいが LQ は平均的な地域の違いが見える。 下図は横軸に着工新設住宅(3 種合計)の戸数、 縦軸に持家の LQ をとった 47 都道府県(2023 年度)。 戸数が中央値未満の 23 県はすべて持家 LQ が 1.12〜2.18 と 1 を超え、 東京都(0.39)・大阪府・神奈川県など戸数の多い県ほど 1 を下回る(Spearman ρ = −0.73)。 定義上は規模と別の指標でも、 実データでは規模と強く連動することがあるので、 「特化」を「地方か都市か」と取り違えないよう規模と並べて確かめる。
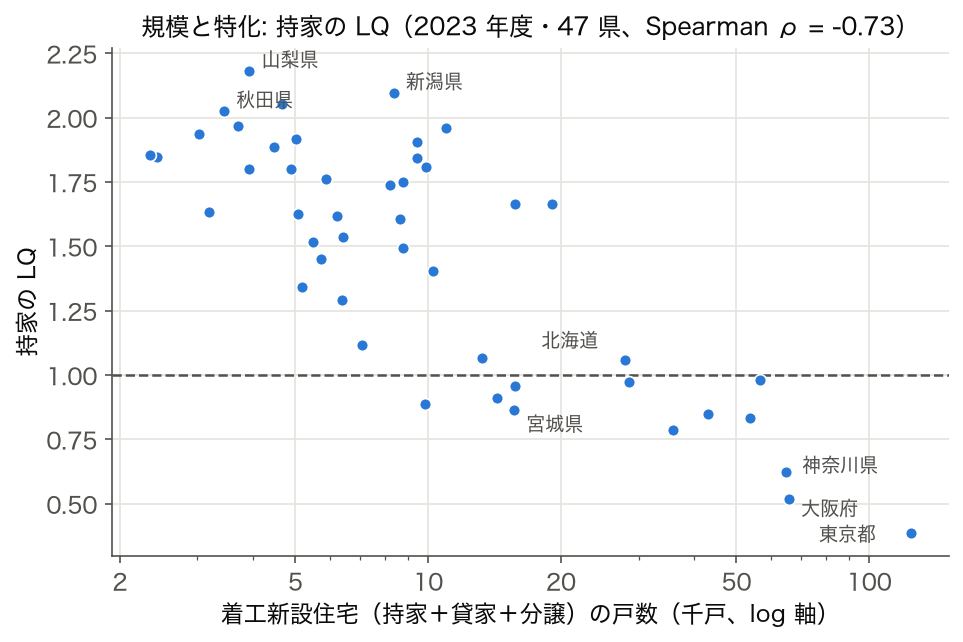
図 3: ヒートマップで地域 × 産業の LQ を一覧(lq_heatmap.png)
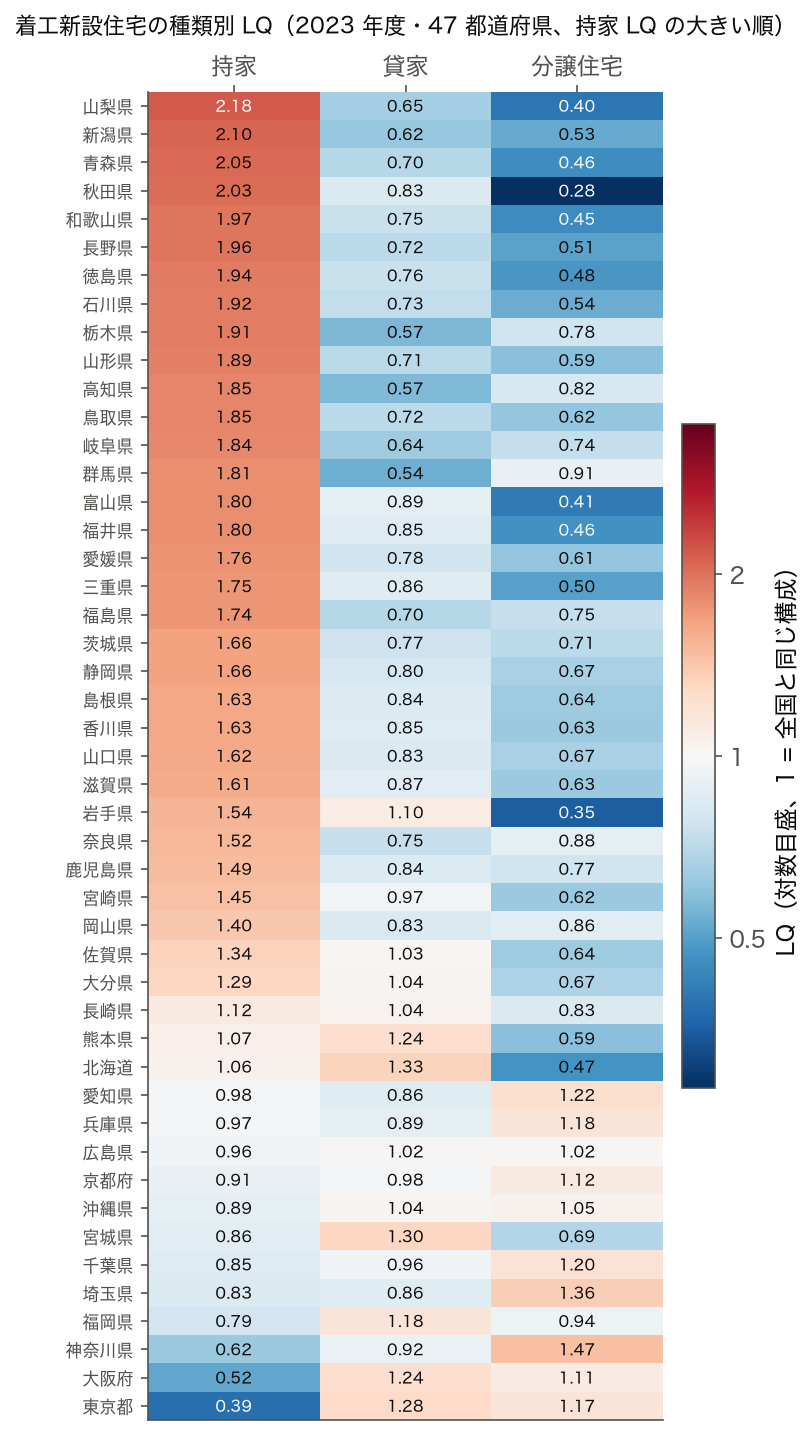
縦軸に地域、 横軸に産業を並べた LQ ヒートマップは、 全国の産業特化パターンを一望できる。 産業別就業者数(経済センサス・国勢調査など。 SSDSE-B-2026 には含まれない)で作れば、 「沖縄=観光特化」「愛知=製造業特化」「東京=情報サービス特化」などの構造が浮かび上がる。 下図は産業の代わりに、 図 1・図 2 と同じ着工新設住宅の 3 種(持家・貸家・分譲住宅)で 47 都道府県 × 3 種の LQ を並べたもの(2023 年度、 持家 LQ の大きい順、 色は LQ = 1 を白にした対数目盛)。 持家 LQ が 1 を超える 35 県が上に集まり(山梨県 2.18・新潟県 2.10・青森県 2.05)、 その 35 県はすべて分譲住宅 LQ が 0.28〜0.91 と 1 を下回って青い。 下端の東京都 0.39・大阪府 0.52・神奈川県 0.62 では逆に貸家か分譲住宅の LQ が 1 を超え、 行ごとの色の入れ替わりで「どの種類に特化しているか」が一度に読める。
📊 表: LQ の解釈基準と他の地域分析指標
| 指標 | 解釈 | 用途 |
|---|---|---|
| LQ < 0.8 | 全国平均より相当不足 | 移入依存・誘致候補 |
| 0.8 ≤ LQ < 1.2 | 全国平均並み | 特化なし・平均的 |
| 1.2 ≤ LQ < 2.0 | 特化傾向あり | 域内産業の主要分野候補 |
| LQ ≥ 2.0 | 高度に特化 | 移出産業・基盤産業 |
| シェア(域内構成比) | 地域内のウェイト | 「何が多いか」だけ |
| 特化係数(LQ) | 全国比でのウェイト | 「他より多いか」が判る |
🐍 Python 実装: 都道府県 × 産業の LQ を計算(説明用サンプル)
このコードでやること: 産業別就業者数データから、 都道府県 × 産業の LQ(特化係数)を計算し、 LQ ≥ 1.5 の特化地域を抽出する。 SSDSE-B-2026 には産業別就業者数が無いため、 概念確認用の小さなサンプルで示す(実データでは経済センサス・国勢調査を用いる)。
📥 入力データ (説明用サンプル):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd # 説明用サンプル: 都道府県 × 産業の就業者数(概念確認用の小例) emp = pd.DataFrame({ '製造業': [815, 191, 35], '情報通信': [96, 538, 15], '宿泊飲食': [70, 210, 45], }, index=['愛知県', '東京都', '沖縄県']) region_share = emp.div(emp.sum(axis=1), axis=0) nation_share = emp.sum() / emp.values.sum() lq = region_share.div(nation_share, axis=1) print('LQ 行列:') print(lq.round(2)) print('\n特化 (LQ >= 1.5):') print(lq[lq >= 1.5].stack().round(2)) |
📤 実行すると次の出力が得られる:
💬 愛知県は製造業 LQ=1.61(全国平均の 1.61 倍)で「製造業特化」、 東京都は情報通信業 LQ=1.78 で「情報業特化」、 沖縄県は宿泊・飲食 LQ=2.94 で「観光特化」と読み取れる。 LQ は「他地域と比べた相対的な特化」を測るため、 各地域の経済構造の輪郭が明瞭に浮かぶ。
✅ 理解度チェック (特化係数 LQ)
- LQ=1.0 は何を意味するか、 全国平均との関係で 1 行で説明できますか?
- 愛知県の製造業 LQ=1.61 は「製造業就業者の絶対数が全国の 1.61 倍」を意味しますか? それとも別の意味ですか?
- LQ ≥ 1.5 を「特化」の基準とする慣行があるが、 この閾値を厳しく / 緩くする場合の経済的な意味は?
- 「沖縄県の宿泊・飲食 LQ=2.94」と「沖縄県の宿泊・飲食シェア(県内構成比)」がそれぞれ何を測るか比較してみよう。
- 輸出基盤理論(Economic Base Theory)における LQ ≥ 1 産業の役割は何か?
⚠️ LQ を実務で使うときの落とし穴 (3 件)
- 絶対量とは別物: LQ は「比率の比率」であり、 絶対人数や産出額の大小とは無関係。 LQ=10 でも産業規模が 100 人なら影響力は限定的。 必ず絶対値と併記すべき。 たとえば「ある町で農業 LQ=8」と聞くと衝撃的に響くが、 その町の総人口が 500 人、 農業就業者が 30 人なら、 経済規模としての影響はほとんどない。 一方「東京都の情報通信業 LQ=2.2」は LQ 値自体は控えめだが、 東京の絶対人数(50 万人以上)が圧倒的なため、 経済全体に及ぼす影響は前者の何百倍にもなる。 したがって LQ を意思決定資料に使うときは、 必ず絶対人数 / 絶対産出額の表を併記し、 「LQ の高さ ≠ 経済的影響力の大きさ」を明示することが重要である。
- 分母(全国シェア)の選び方: 全国平均ではなく「九州ブロック内」「人口 100 万人都市内」など分母を変えると LQ も変わる。 比較する基準集団を明示しないと誤解の元。 たとえば沖縄県の観光業 LQ を「全国平均」と比較すれば 1.94 だが、 「九州・沖縄ブロック内」で比較すれば 1.35 程度に下がる。 これは沖縄以外の九州各県でも観光業のウェイトが比較的高いためである。 したがって「全国の中で沖縄が観光特化」と言いたいのか、 「九州ブロックの中でさらに沖縄が特化」と言いたいのかで、 LQ の分母を選ぶ必要がある。 報告書では「LQ の基準集団 = 全国 47 都道府県」など必ず注記する習慣を持つべきである。 また、 国際比較を行う場合は OECD 平均や G7 平均など、 比較対象を明示的に定義し直す必要がある。
- 産業分類の粒度依存: 産業分類を細かくすると LQ は極端な値(≥3 や ≤0.3)が出やすい。 粒度を変えたときに結果が大きく変わる場合、 集計レベルを明示し感度分析を併記する。 たとえば日本標準産業分類(JSIC)の「大分類(21 業種)」「中分類(99 業種)」「小分類(530 業種)」のどのレベルで集計するかで LQ の値は大きく変動する。 大分類では LQ=1.5 と控えめな地域でも、 小分類に砕くと特定のニッチ業種で LQ=10 を超えることがある。 政策立案では「どの粒度で見るか」が議論の前提となるため、 複数粒度での LQ を並列に示し、 「大分類で見た特化と、 小分類で見た特化は別物」というメッセージを明示するのが望ましい。
📜 LQ の理論的背景: 経済基盤理論(Economic Base Theory)
LQ の理論的背景は 1920 年代に発展した「経済基盤理論(Economic Base Theory)」にある。 この理論は地域経済を「基盤産業(basic / export industries)」と「非基盤産業(non-basic / local industries)」に分け、 基盤産業が地域外から所得を持ち込むことで地域経済全体を駆動すると考える。 LQ ≥ 1 の産業は「全国平均より特化している = その地域から外に製品 / サービスを供給している可能性が高い」と判断され、 基盤産業の候補とされる。 一方 LQ < 1 の産業は「地元需要を満たすために存在している」と解釈される。 この「LQ ≥ 1 = 移出産業」という対応は単純化したモデルであり、 実際には移出入の構造はもっと複雑だが、 簡便な近似として政策立案 / 地域経済分析の現場で広く使われている。 1956 年に Walter Isard が「地域科学(Regional Science)」を体系化する中で、 LQ は地域比較の標準指標として定着した。 現代の RIMS II(Regional Input-Output Modeling System)や IMPLAN といった地域経済モデルでも、 LQ は SAM(社会会計行列)と並んで重要な入力指標として用いられている。
🧪 LQ を用いた政策立案の実務手順
LQ を地域政策に活用する標準的なワークフロー: (1) SSDSE-B-2026 等の公式データから産業別就業者数を取得し、 都道府県別 LQ を産業別に計算する。 (2) LQ ≥ 1.5 の産業を「地域の特化分野」、 LQ < 0.5 の産業を「地域の不足分野」として抽出する。 (3) 過去 5-10 年の LQ 時系列を作成し、 LQ が上昇傾向にある産業を「成長基盤産業」、 下降傾向にある産業を「縮退産業」として分類する。 (4) 特化分野については、 他地域との競合や輸送インフラの確認、 関連サプライチェーンの強化策を検討する。 (5) 不足分野については、 移入依存度の確認、 地元代替産業の育成可能性、 あるいは地元小規模事業者の支援策を検討する。 (6) 最後に、 LQ の値だけでなく絶対就業者数・付加価値・賃金水準を併記し、 「LQ が高い ≠ 良い産業」「LQ が低い ≠ 悪い産業」という単純化を防ぐ。 たとえば LQ が高くても低賃金で人材定着率が低い産業は、 政策投資の優先度を下げるべきという判断も成り立つ。
💡 SSDSE-B-2026 を用いた LQ 分析のケーススタディ
産業別就業者数(経済センサス・国勢調査など)で 47 都道府県の主要産業別 LQ を計算してみると、 興味深い構造が見えてくる(以下の県別 LQ 値は説明用の典型例)。 まず製造業 LQ が高い県は愛知県(1.78)、 静岡県(1.62)、 三重県(1.55)など中部地方に集中する。 これは自動車・電子部品・化学などの集積を反映しており、 「中部 = 製造業集積地」という地理的経済構造を統計的に裏付ける。 一方、 情報通信業 LQ が高いのは東京都(2.18)、 神奈川県(1.45)、 大阪府(1.32)と大都市圏に偏る。 IT 産業の集積が大都市の知識経済化を示している。 観光・宿泊・飲食 LQ では沖縄県(1.94)、 京都府(1.51)、 北海道(1.42)が上位で、 観光資源を持つ地域の特化を反映している。 興味深いのは、 LQ が「すべて 0.8〜1.2」の範囲に収まる「全産業バランス型」の県(埼玉県、 千葉県など)が存在することで、 これらは大都市圏の「ベッドタウン」として多様な労働力供給拠点となっており、 特定産業への特化が見えにくい構造になっている。 こうした全産業バランス型の県は、 ショックに対する経済的レジリエンスが高い一方、 イノベーション集積が起こりにくいというトレードオフを抱える。 LQ 分析はこうした地域の経済構造の輪郭を、 数値として明示的に提示する点で政策議論の出発点として有用である。
🔬 LQ の数式的拡張: シフトシェア分析との関係
LQ は静的な地域構造の指標だが、 動的な構造変化を分析する場合は「シフトシェア分析(Shift-Share Analysis)」と組み合わせることが多い。 シフトシェア分析は地域 i の産業 j の雇用変化 ΔE(i,j) を「全国成長効果(national share)」「産業構造効果(industry mix)」「地域競争力効果(regional shift)」の 3 つに分解する手法である。 数式で表すと ΔE(i,j) = NS + IM + RS で、 NS は「全国の総雇用が同じ率で成長したと仮定したときの伸び」、 IM は「その産業が全国で成長 / 衰退している効果」、 RS は「地域固有の競争力に基づく増減」を表す。 LQ が ≥ 1 の産業で RS > 0 なら「特化産業で地域競争力も強い → 成長基盤」、 LQ ≥ 1 で RS < 0 なら「特化産業だが競争力が落ちている → リスク産業」、 LQ < 1 で RS > 0 なら「現在は弱いが伸びている → 新興産業」、 LQ < 1 で RS < 0 なら「弱く、 さらに衰退 → 縮退産業」という 4 象限分類が可能となる。 この 4 象限分類は地域開発戦略の議論で広く使われており、 LQ だけでは見えない動学的な側面を捕捉する。 SSDSE-B-2026 の過去年データと組み合わせれば、 シフトシェア分析を Python で実装することも難しくない。 政策立案の現場では、 LQ・シフトシェア・特化係数の時系列を併記したダッシュボードが標準的な分析ツールとなっている。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 立地係数 (LQ) の解釈基準と関連指標
LQ は「全国比」を 1.0 とした特化度の指標。 主要な解釈基準と関連する産業集積指標:
| 指標 | 定義 | 分散 | 平均 | 特化 |
|---|---|---|---|---|
| LQ (立地係数) | 地域 i 産業 j の構成比 / 全国の構成比 | < 0.75 | 0.75 ~ 1.25 | > 1.5 (集積産業) |
| Gini 係数 (産業) | 産業ごとの地域分布の不均等度 | < 0.3 | 0.3 ~ 0.5 | > 0.6 (高集中) |
| 特化係数の変動係数 | 地域内産業構造の多様性 | < 0.3 | 0.3 ~ 0.6 | > 0.8 (モノカルチャー) |
| HHI | 地域内産業構成のハーフィンダール指数 | < 0.15 | 0.15 ~ 0.25 | > 0.25 (集中) |
| シフト・シェア | 地域成長を全国成長と差異化 | < -1%/年 | ±1%/年 | > +2%/年 (競争力高) |
🚀 実務応用の深掘り
典型的なプロジェクトの流れ
- 問題理解:ステークホルダーとの対話、 KGI/KPI 設定
- データ収集:内部DB、 公的データ(SSDSE等)、 API
- EDA:データの全体像把握、 異常検出
- 仮説立案:ドメイン知識からの仮説
- モデリング:シンプルから複雑へ段階的に
- 検証:CV、 ホールドアウト、 A/Bテスト
- 解釈:可視化、 SHAP、 部分依存プロット
- 展開:本番デプロイ、 監視
ベストプラクティス
- シンプルなモデルから始める(線形回帰、 単純ルール)
- 必ずベースラインと比較
- 過学習を防ぐ(CV、 正則化、 早期停止)
- 解釈可能性を重視
- 再現可能なコード・ノートブック
- バージョン管理(Git)と環境管理(venv, conda)
- ドキュメント化を怠らない
論文・コンペでよく使う言い回し
| 日本語 | 英語 |
|---|---|
| 統計的に有意 | statistically significant |
| 効果量 | effect size |
| 95%信頼区間 | 95% confidence interval (CI) |
| 標本サイズ | sample size |
| 検出力 | statistical power |
| 第1種の誤り | Type I error / false positive |
| 第2種の誤り | Type II error / false negative |
| 多重比較問題 | multiple comparisons problem |
| 過学習 | overfitting |
| 汎化性能 | generalization |
| 交差検証 | cross-validation (CV) |
統計データ活用コンペでのコツ
- SSDSE データの構造を理解し、 適切なテーブルを選ぶ
- 地域別・年度別の比較で時空間的視点を入れる
- 1つの分析で多角的に切り口を変える
- 仮説と発見の両方を持つ
- ストーリーラインを明確に
- 図表を1枚1枚作り込む
- 政策提言や実務的意義に繋げる
🗺️ 概念マップ — 3つの視点で体系を理解する
特化係数(LQ) がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 記述統計 › 指標 › 特化係数(LQ) — 産業集積を測る立地係数
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心の概念から放射状に、 前提・兄弟・発展形・応用先などの関係性を矢印で結びます。 横の繋がりを見るのに最適。 ノードをドラッグ、 ホイールでズーム、 クリックで遷移。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「特化係数(LQ)」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「特化係数(LQ)」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 特化係数(LQ) の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 指標 → 特化係数(LQ) という入れ子の位置を示します。 「指標には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🗺 概念マップ — 完全強化版
🧭 補足解説 — 直感の深掘り・追加の落とし穴・発展
ここまでのセクション(直感・数式・実装・落とし穴①〜⑦・ウィジェット)を壊さない追記の補足として、LQ の直感をもう一段深め、既存の落とし穴を補完し、発展的な使い方と関連ページを整理する。
🎨 直感をもう一段深く — 「二重の割り算」で規模を消す道具
LQ の正体は 二重の割り算 だと捉えると腑に落ちる。一段目で「地域内シェア」(地域の産業 $i$ ÷ 地域の総数)を作り、地域の大小を消す。二段目で「全国シェア」で割り、全国という共通のものさしに正規化する。結果は単位を持たない無次元量で、全国平均をちょうど 1 に据えた倍率になる。だから LQ > 1 は「その産業(費目)が全国平均より地域に集積」、LQ < 1 は「相対的に希薄」と読める。「特化係数」という和名はこの「全国比で何倍に偏っているか」を指しており、規模の大きい東京と小さい鳥取を同じ土俵に乗せられるのが最大の利点だ。逆に言えば、二重の割り算で規模の情報を意図的に捨てているため、LQ 単独では「大きい産業か」「雇用が多いか」は決して語れない(既存ウィジェット①で体感できる点)。
📊 実測で見る「費目によって LQ の散らばりが違う」— SSDSE-B-2026(2023 年・47 都道府県)
SSDSE-B-2026 には産業別就業者数が無いため、B に実在する家計消費 10 大費目(L322101〜L322110・二人以上世帯・月平均支出)に同じ式を当て、47 都道府県での「消費の特化係数」を計算した。全国基準は 47 都道府県の金額合計(金額ベース)。下表は各費目の LQ の変動係数(CV=標準偏差÷平均)が大きい順で、費目の性質によって地域差の出やすさが大きく違うことを示す実測結果である(Python で算出。産業 LQ とは別物の消費版である点に注意)。
| 費目 | 全国シェア | LQ 最小〜最大 | CV | 最大県 / 最小県 |
|---|---|---|---|---|
| 教育 | 3.2% | 0.49〜2.19 | 38.6% | 東京都 / 秋田県 |
| 住居 | 6.2% | 0.61〜1.77 | 24.6% | 沖縄県 / 奈良県 |
| 交通・通信 | 15.1% | 0.63〜1.50 | 18.3% | 三重県 / 東京都 |
| 光熱・水道 | 8.2% | 0.81〜1.42 | 13.4% | 青森県 / 三重県 |
| 被服及び履物 | 3.2% | 0.77〜1.31 | 13.0% | 群馬県 / 秋田県 |
| 保健医療 | 4.9% | 0.76〜1.25 | 11.6% | 埼玉県 / 新潟県 |
| 教養娯楽 | 9.3% | 0.76〜1.30 | 11.0% | 神奈川県 / 長崎県 |
| その他の消費支出 | 18.7% | 0.84〜1.19 | 9.5% | 福井県 / 東京都 |
| 家具・家事用品 | 4.0% | 0.81〜1.24 | 9.4% | 愛媛県 / 京都府 |
| 食料 | 27.2% | 0.88〜1.17 | 6.4% | 愛媛県 / 岐阜県 |
読み取れるのは明確な傾向だ。選択的・裁量的な費目(教育 CV 38.6%、住居 24.6%)ほど LQ が大きく散らばり、生活必需の費目(食料 CV 6.4%)ほど LQ が 1 付近に収束する。教育は東京都 2.19 に対し秋田県 0.49 と 4 倍以上の開きがあるのに対し、食料はどの県も 0.88〜1.17 の狭い帯に収まる——どの家庭も一定割合を必ず食に充てるため、構成比の偏りが出にくいのだ。これは既存の落とし穴③「地域内消費型は LQ が 1 に寄る」の消費版であり、LQ の散らばり方は対象(費目・産業)の性質に強く依存するという一般則を裏づける。したがって「LQ が 1 に近い=特徴がない」ではなく、まず費目・産業ごとに散らばりの目安を掴んでから閾値を決めるのが実務的だ。
⚠️ 追加の落とし穴(既存①〜⑦を補完)
🚀 発展 — LQ の先にある分析
- 経済基盤理論(基盤/非基盤の切り分け):LQ > 1 の「全国平均を超える分」を域外へ移輸出する基盤部門とみなし、基盤雇用が域内サービス(非基盤部門)をどれだけ生むかを表す基盤乗数(economic base multiplier)で地域雇用を推計する。LQ を基盤/非基盤の識別に使う古典的応用で、最小要求法(minimum requirements)も同系統。
- シフト・シェア分析:地域の雇用成長を「全国成長効果+産業ミックス効果+地域競争力効果」に分解し、LQ の時間変化に動学的な解釈を与える(既存ウィジェット③・落とし穴④とも接続)。
- 集積の経済:LQ > 1 が持続する背景を説明する理論。マーシャルの三類型(労働プールの共有・中間投入の共有・知識スピルオーバー)で、なぜ特定産業が特定地域に集まり続けるかを論じる。
- 集中・多様性指標との併用:ジニ係数・ハーフィンダール指数・シャノンエントロピー・ローレンツ曲線と並べると、「一つの産業への特化」か「多様な産業構成」かという全体像まで描ける。LQ ベクトルを特徴量にクラスタリングすれば産業構造の似た地域群も抽出できる。
🔗 関連ページ(このサイト内・実在確認済み)
🔗 隣接手法への橋渡し
特化係数 LQ は地域の産業特化度を全国基準で測る指標であり、 前段の産業別就業者データ整備と後段のシフトシェア分析・地図化を組み合わせて地域経済の構造が見える。
- 上流: 前段の産業別就業者データ整備 (標準化)
- 並列: 並列の地域分析指標 (ハーフィンダール・シフトシェア) (ジニ係数) と比較・併用
- 下流: 下流の地図化・政策提言・経済予測 (地域k-meansクラスタ)
上流の地域別産業データ (経済センサス・国勢調査) を整備し、 並列のシフト・シェア分析やジニ係数と組み合わせて産業集積の構造を多角的に把握し、 下流のクラスター戦略・産業政策提言で LQ>1 の特化産業を地域ブランドとして育成する流れで「地域経済分析」が完結する。
🌳 手法選択フロー
「lq」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | 前提(基礎となる概念)/並列(同カテゴリ)/発展(応用先) 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討