🔖 キーワード索引
「harmful content(有害コンテンツ)」は AI 倫理・コンテンツガバナンスの中核概念のひとつ。 本ページでは「harmful content」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「harmful content の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
ネット上の「毒」のようなものです。
安全にAIを使うために考えます。
SNSのひどい書き込みなどが例です。
対策の方法について学びます。
有害コンテンツ ── 差別・暴力等を含む不適切コンテンツ
- 差別、 暴力、 ヘイト、 詐欺、 違法情報など社会的・法的に不適切な内容
- 生成AIではプロンプトとして/出力として、 両面で対策が必要
- 検出技術:キーワードフィルタ、 分類モデル、 マルチモーダル検出、 人間レビュー
- 対策レイヤー:(1) データ段階、 (2) 学習段階(RLHF)、 (3) 推論時フィルタ、 (4) 監視・通報
- 完全防御は不可能。 多層防御と透明な対処方針がベストプラクティス
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
AIが嘘をつかないためのルールです。
社会のトラブルを防ぐために使います。
スマホアプリの審査などで出会います。
この言葉がどこで使われるか読みます。
生成AIの普及で「AIが有害コンテンツを生成しないか」「AIで偽情報を量産させないか」が社会課題に。 技術者はこの問題を避けて通れません。
本ページでは「harmful content(有害コンテンツ)」を扱う。 SNS やプラットフォームの投稿審査、 生成 AI の入出力フィルタ、 EU DSA・プロバイダ責任制限法などの法規制の現場で必ず出会う概念である。
「harmful content」は AI 倫理・コンテンツガバナンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
危ない内容を分ける「色分け」です。
何がダメな内容か判断するために使います。
暴力的な言葉を禁止する設定が例です。
有害な内容の種類について読みます。
「有害」のカテゴリ例(OpenAI Moderation API のラベル):
- hate(人種・宗教等への憎悪)
- harassment(嫌がらせ)
- self-harm(自傷)
- sexual(性的、 とくに未成年)
- violence(暴力)
- illicit(違法行為)
各カテゴリでスコアを出し、 閾値超えはブロック/警告という運用。
📐 定義/数式
🍰 まずはやさしく
有害さを数字で測る「ものさし」です。
消すか残すかを決めるために使います。
NGワードの判定基準のようなものです。
判定する仕組みと数式について読みます。
多層防御の枠組み:
検出の中核は「コンテンツ $x$ の有害度スコア $s(x) \in [0,1]$ を出し、 閾値 $\tau$ で判定する」という形で書ける。
$$\hat{y}(x) = \begin{cases} 1\ (\text{有害} / \text{ブロック}) & s(x) \ge \tau \\ 0\ (\text{許容}) & s(x) < \tau \end{cases}$$
ここで $s(x)$ は分類器 (キーワード一致・機械学習・LLM 判定) が返すスコア、 $\tau$ は運用側が決める閾値。 $\tau$ を上げれば見逃し (false negative) が増え、 下げれば過剰検閲 (false positive) が増える ── この一点にコンテンツモデレーションの本質的なトレードオフが集約されている。 スコアはカテゴリ (hate / violence / sexual …) ごとに複数持つのが一般的で、 実値での計算例は後続セクションを参照。
🔬 数式を言葉で読み解く
- 事前フィルタ
- 入力プロンプトを分類器で判定
- RLHF
- 有害な応答を学習で抑制
- 事後フィルタ
- 出力テキストを別モデルで再検査
- Red Teaming
- 意図的に攻撃して脆弱性を発見する評価
- 通報機構
- 利用者が問題を報告する経路
4 層フィルタの各段は、 それぞれ別の失敗モードを想定して置かれている。 どこか 1 段が破られても次の段で止める「多層防御 (defense in depth)」の考え方である。
- 事前フィルタ — 入力プロンプト側での攻撃 (脱獄・有害依頼) を止める。 ここを抜けても後段で救える前提で、 過剰ブロックは避ける。
- RLHF / 学習時制約 — モデル自体が有害な応答を出しにくくなるよう学習で挙動を矯正する。
- 事後フィルタ — 生成された出力を別モデルで再検査し、 学習で抑えきれなかった有害出力を捕捉する。
- ユーザー画面警告・通報 — 自動判定の見逃しを利用者からのフィードバックで補い、 学習データへ還流させる。
単一のフィルタで有害コンテンツを完全に防ぐことはできない。 各段の precision / recall のバランスを取りながら、 段を重ねて全体の見逃し (false negative) と過剰検閲 (false positive) を同時に抑えるのが設計の要点である。
🧮 実値で計算してみる
OpenAI Moderation API での例:
{
  "hate":           0.001,
  "harassment":     0.002,
  "self-harm":      0.000,
  "sexual":         0.000,
  "sexual/minors":  0.000,
  "violence":       0.012,
  "violence/graphic": 0.000
}
各カテゴリ 0-1 のスコア。 通常0.5以上でブロック判定。
🧮 計算 ①: 有害な投稿が少ないほど「ブロックしたものの大半が誤検知」になる
上の JSON のようなスコアに閾値を引いて判定する分類器を、「有害な投稿の 95% を捕まえ(再現率 0.95)、無害な投稿の 2% を誤って捕まえる(偽陽性率 0.02)」性能だとします。数字だけ見ると優秀ですが、実際にブロックされた投稿のうち本当に有害なものの割合(適合率 precision)は、全投稿に占める有害な投稿の割合(有病率、prevalence)で大きく変わります。有害コンテンツは多くのサービスで全体のごく一部なので、この効き方を知らないと「ブロックの大半が誤検知」という事態を見落とします。ここで使う数字(再現率・偽陽性率・有病率・投稿数)はすべて説明のための仮定で、特定のサービスの実測ではありません。
数式: 投稿数 $N$、有病率 $\pi$、再現率 $r$、偽陽性率 $f$ のとき
$$\text{precision} = \frac{TP}{TP + FP} = \frac{r\,\pi N}{r\,\pi N + f\,(1-\pi) N} = \frac{r\,\pi}{r\,\pi + f\,(1-\pi)}$$| Step | 内容($N$ = 1,000,000 件、$\pi$ = 1%、$r$ = 0.95、$f$ = 0.02) | 値 |
|---|---|---|
| 1 | 有害な投稿の数 $\pi N$ = 0.01 × 1,000,000 | 10,000 件 |
| 2 | そのうち捕まる数 $TP = r \pi N$ = 0.95 × 10,000 | 9,500 件 |
| 3 | 無害な投稿の数 $(1-\pi) N$ = 990,000、誤って捕まる数 $FP$ = 0.02 × 990,000 | 19,800 件 |
| 4 | ブロック総数 $TP + FP$ = 9,500 + 19,800 | 29,300 件 |
| 5 | precision = 9,500 ÷ 29,300 | 0.324 |
ブロックした 29,300 件のうち本当に有害なのは約 3 分の 1 で、残りの 19,800 件(3 件に 2 件)は無害な投稿の誤削除です。同じ計算を有病率を変えて Python で繰り返します。
🎯 このコードでやること:再現率 0.95・偽陽性率 0.02 の分類器を 100 万件の投稿に当てたとき、有病率 0.1〜10% のそれぞれで、捕まる有害投稿(TP)・誤って捕まる無害投稿(FP)・ブロック総数・precision を計算する(上の手計算の Step 1〜5 を有病率ごとに繰り返す)。
1 2 3 4 5 6 7 8 9 | recall, fpr = 0.95, 0.02 # 分類器の性能(仮定) N = 1_000_000 # 投稿数(仮定) print(' 有病率 有害件数 TP FP ブロック総数 precision') for prev in [0.001, 0.005, 0.01, 0.02, 0.05, 0.10]: harmful = N * prev # Step 1 tp = recall * harmful # Step 2 fp = fpr * (N - harmful) # Step 3 blocked = tp + fp # Step 4 print(f'{prev:6.1%} {harmful:10,.0f} {tp:8,.0f} {fp:8,.0f} {blocked:12,.0f} {tp / blocked:9.3f}') # Step 5 |
💬 有病率 1% の行は手計算と同じ TP 9,500・FP 19,800・precision 0.324 で一致します。有病率 0.1% では precision は 0.045 まで落ち、ブロックした 20,930 件のうち有害なのは 950 件だけ(22 件に 1 件)です。逆に有病率 10% なら 0.841 になります。分類器の性能(0.95 と 0.02)はどの行も同じなので、「precision が低い」ことは分類器が悪いことの証拠にはならず、まず有病率を確かめる必要があります。有病率 0.1% の世界で precision を 0.5 以上にするには、偽陽性率を約 0.095% 以下(0.02 の 21 分の 1)まで下げなければなりません($0.95 \times 0.001 \ge f \times 0.999$ を解く)。
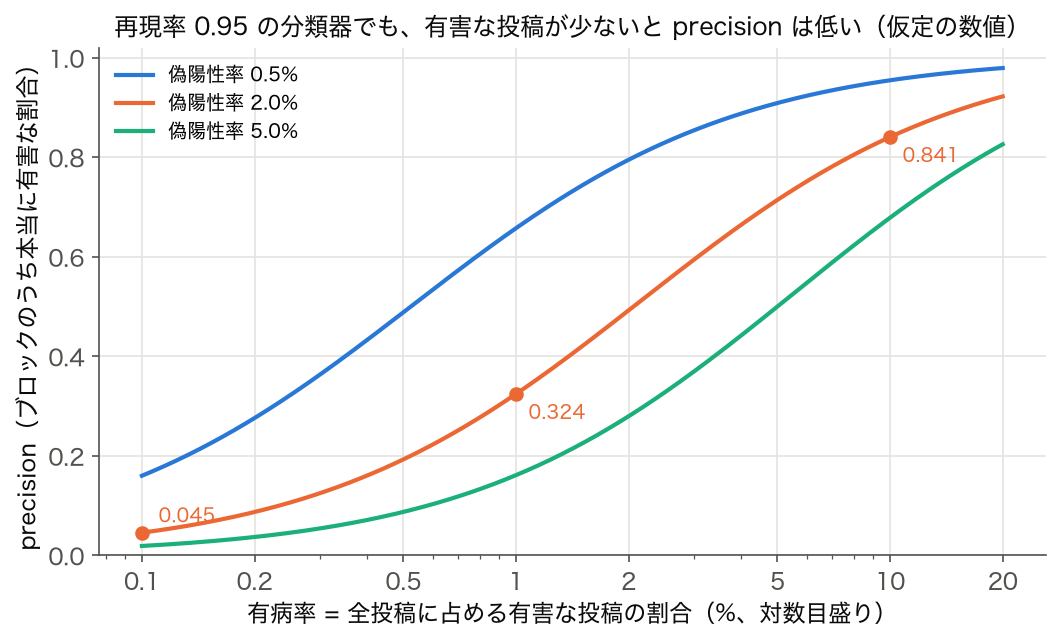
図の読み方: 3 本の曲線は偽陽性率だけが違う分類器です(再現率はどれも 0.95、すべて仮定の値)。どの曲線も左(有害な投稿が少ない)ほど急に落ち、偽陽性率 2%(橙)は有病率 0.1% で 0.045、1% で 0.324、10% で 0.841 を通ります。偽陽性率を 2% から 0.5% に 4 分の 1 にすると、有病率 1% での precision は 0.324 から 0.657 に上がります。有害コンテンツ対策で「偽陽性率を 1 桁下げる」ことに大きな工夫が払われるのは、この左側の領域で運用しているからです。図の作成スクリプトは code/glossary_figs/harmful-content.py。
🧮 計算 ②: 閾値 τ を動かすと、見逃しと誤削除が入れ替わる
📐 の式 $\hat y = 1\,(s(x) \ge \tau)$ の τ を実際に動かしてみます。10 万件の投稿のうち 2% が有害で、有害な投稿のスコアは高めに(Beta(6, 2) 分布、平均 0.75)、無害な投稿のスコアは低めに(Beta(1.5, 8) 分布、平均 0.16)出る分類器を乱数で模擬します(分布の形・有病率は説明のための仮定)。τ ごとにブロック数・見逃し(FN)・誤削除(FP)・precision・recall を数え、さらに「スコアが 0.4〜0.8 の判断の難しい投稿だけを人手の確認に回す」運用の件数も出します。
🎯 このコードでやること:有病率 2%・10 万件の投稿のスコアを Beta 分布で模擬し(seed 0)、τ = 0.3〜0.9 でブロック数・TP・FP・FN・precision・recall を数える。スコア 0.4〜0.8 を人手の確認に回す場合の件数と、そのうち本当に有害な件数も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np rng = np.random.default_rng(0) N, prev = 100_000, 0.02 y = rng.random(N) < prev # True = 有害 s = np.where(y, rng.beta(6, 2, N), rng.beta(1.5, 8, N)) # 分類器のスコア print(f'有害な投稿 {y.sum():,} 件 / 全 {N:,} 件') print(' τ ブロック TP FP FN precision recall') for tau in [0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9]: b = s >= tau tp, fp, fn = (b & y).sum(), (b & ~y).sum(), (~b & y).sum() print(f'{tau:.1f} {b.sum():8,} {tp:6,} {fp:6,} {fn:6,} {tp / b.sum():9.3f} {tp / y.sum():7.3f}') gray = (s >= 0.4) & (s < 0.8) # 人手で確認する帯 auto = s >= 0.8 # 自動でブロックする帯 print(f'人手確認 {gray.sum():,} 件(うち有害 {(gray & y).sum():,} 件), ' f'自動ブロック {auto.sum():,} 件(うち誤り {(auto & ~y).sum():,} 件), ' f'0.4 未満で見逃す有害 {((s < 0.4) & y).sum():,} 件') print(f'1 件 60 秒・1 人 1 日 6 時間で確認すると {gray.sum() * 60 / (6 * 3600):.1f} 人日') |
💬 有害な投稿は 1,947 件(1.9%)です。τ = 0.5 では 2,859 件をブロックし、そのうち 1,008 件が誤削除(precision 0.647)、見逃しは 96 件(recall 0.951)です。τ を 0.7 に上げると誤削除は 26 件まで減る代わりに見逃しが 610 件に増え、0.3 に下げると見逃しは 5 件まで減る代わりに誤削除が 11,505 件に膨らみます。どの τ も「正解」ではなく、見逃し 1 件と誤削除 1 件のどちらをどれだけ重く見るかで決まります。0.8 以上を自動ブロック・0.4〜0.8 を人手確認にすると、自動ブロック 849 件の誤りは 2 件に抑えられ、人手は 4,818 件(うち有害 1,073 件)を見ることになり、1 件 60 秒なら 13.4 人日の作業です。0.4 未満で見逃す有害投稿は 27 件で、ここは通報の仕組みで拾う設計になります。
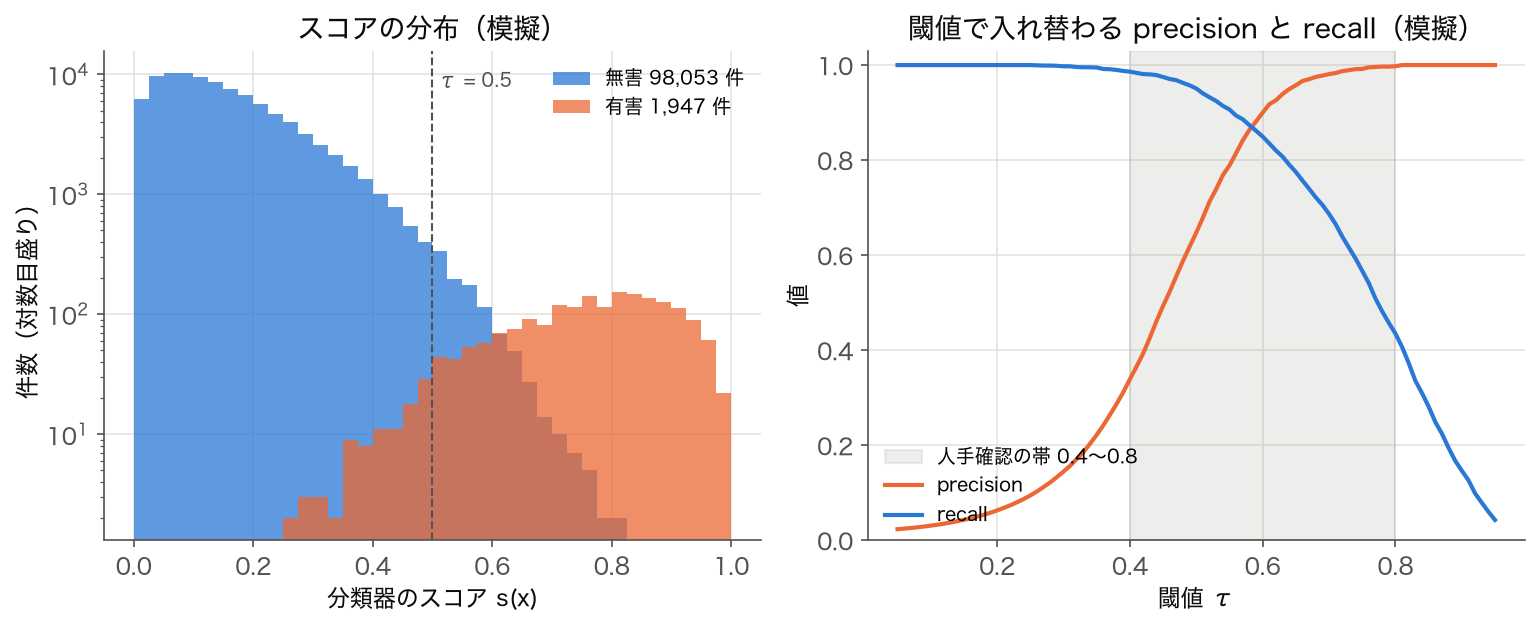
図の読み方: 左は有害(橙)と無害(青)のスコアの分布で、縦軸は件数の対数です。無害な投稿は数が 50 倍もあるので、分布の右の裾(0.5 を超える部分)が薄くても、件数にすると 1,008 件と有害側の見逃し 96 件の 10 倍になります。右は τ を動かしたときの precision(橙)と recall(青)で、τ が 0.4〜0.8 の網かけの範囲で precision が 0.34 から 1.00 近くまで、recall が 0.99 から 0.44 まで大きく動きます。この「両方が急に変わる帯」が、人手の判断を入れる価値の最も高い範囲です。
🧮 計算 ③: 同じ閾値でも、言語によって見逃し率が違う
⚠️ 落とし穴 3「多言語対応の不備」を数字にします。英語の有害投稿にはスコアが高く出る(Beta(6, 2))一方、学習データの少ない日本語の有害投稿にはスコアが低めにしか出ない(Beta(3.5, 2.5)、平均 0.58)分類器を模擬し(仮定)、同じ τ = 0.5 を両方に使った場合と、日本語だけ τ を下げた場合を比べます。
🎯 このコードでやること:英語 7 万件・日本語 3 万件(有病率はどちらも 2%)の投稿を模擬し(seed 1)、τ = 0.5・0.4・0.35・0.3 のそれぞれで言語ごとの recall(有害を捕まえる率)と偽陽性率・誤削除件数を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np rng = np.random.default_rng(1) langs = {'英語': (70_000, 6, 2), '日本語': (30_000, 3.5, 2.5)} print('言語 τ recall 偽陽性率 誤削除件数') for name, (n, a, b) in langs.items(): y = rng.random(n) < 0.02 s = np.where(y, rng.beta(a, b, n), rng.beta(1.5, 8, n)) for tau in [0.5, 0.4, 0.35, 0.3]: blk = s >= tau print(f'{name:<5} {tau:.2f} {(blk & y).sum() / y.sum():7.3f} ' f'{(blk & ~y).sum() / (~y).sum():9.4f} {(blk & ~y).sum():9,}') |
💬 同じ τ = 0.5 で、英語の有害投稿は 93.0% 捕まるのに、日本語は 65.9% しか捕まらず、3 件に 1 件が素通りします。偽陽性率はどちらも約 0.9% で同じなので、全体の誤削除率だけを見ていてもこの差には気づけません。日本語の recall を英語並み(0.9 以上)にするには τ を 0.3 まで下げる必要があり(0.915)、そのとき日本語の誤削除は 282 件から 3,433 件へ 12 倍に増えます。閾値を言語ごとに変えるのは「見逃しを誤削除に付け替える」だけなので、根本的には日本語の学習データを足して有害投稿のスコアを上げる(分布を右に動かす)必要があります。いずれにしても、評価指標は言語(や利用者の属性)ごとに分けて報告しないと、弱い層の見逃しが全体の平均に埋もれます。
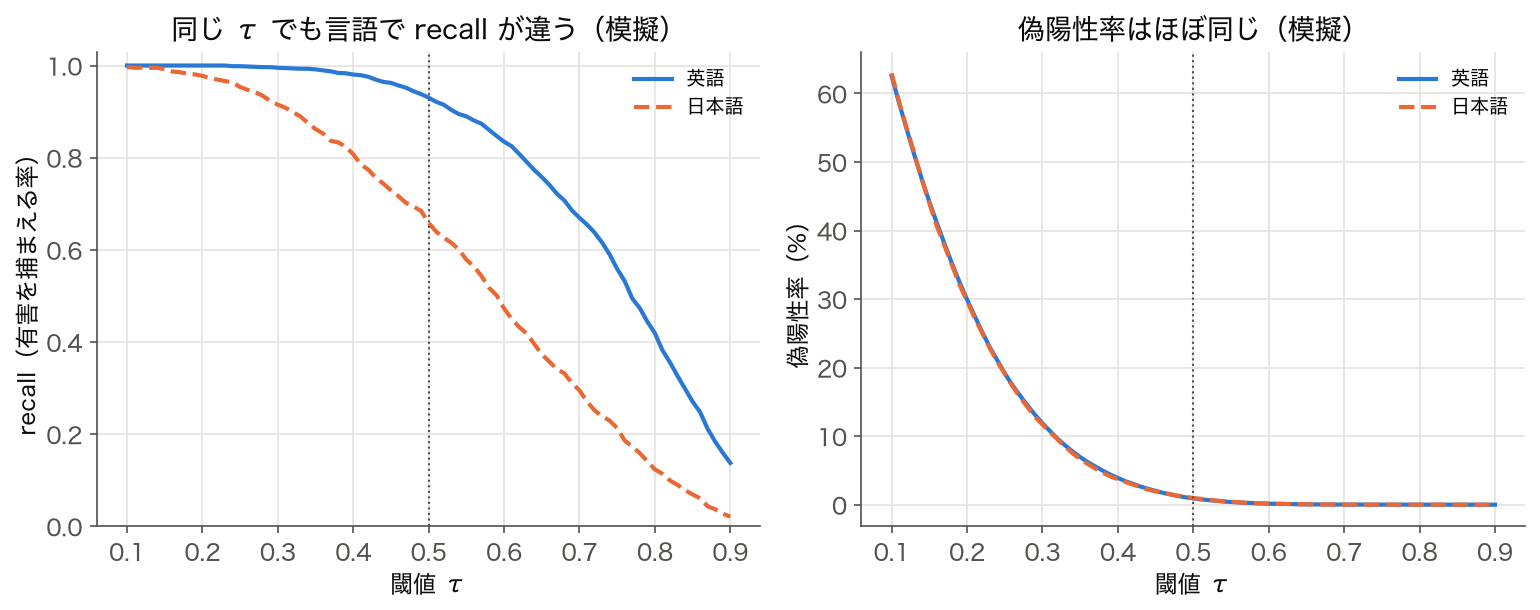
図の読み方: 左は recall、右は偽陽性率で、実線が英語、破線が日本語です(どちらも模擬データ)。右の偽陽性率の 2 本はほとんど重なっていて、無害な投稿の扱いに言語の差はありません。差があるのは左の recall だけで、τ = 0.5 の縦線の位置で英語 0.93 に対して日本語 0.66 と 0.27 も開いています。日本語の破線が 0.9 を超えるのは τ ≈ 0.3 まで下げたときで(τ = 0.3 で 0.915)、そこでは右の偽陽性率が 0.9% から約 12% に跳ね上がります。「多言語対応の不備」は、このように 1 つの閾値の下で、ある言語の利用者だけが守られていないという形で現れます。
🧮 計算 ④: 多層防御の見逃しは「掛け算」になるか — 失敗が重なるとき
🔬 の 4 層フィルタは「どこか 1 段が破られても次の段で止める」考え方でした。事前フィルタの recall が 0.80、事後フィルタが 0.70、利用者の通報で拾える割合が 0.50 だとすると(いずれも仮定)、3 段を独立にすり抜ける確率は $0.20 \times 0.30 \times 0.50 = 0.03$ で、見逃しは 3% になるはずです。しかし実際には、どの段にとっても見抜きにくい投稿(遠回しな表現、画像に焼き込んだ文字など)があり、失敗は同じ投稿に重なりがちです。各段の recall は同じまま、「投稿の見抜きにくさ」を 3 段で共有させると、全体の見逃しがどう変わるかを模擬します。
🎯 このコードでやること:有害な投稿 10 万件に「見抜きにくさ」z(標準正規分布)を割り当て、3 段のフィルタが z と各段固有の乱れの両方で失敗する模型を作る(seed 2)。共有の度合い ρ を 0・0.5・0.8 と変え、各段の recall が 0.80・0.70・0.50 のまま、3 段すべてをすり抜ける割合がどう変わるかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np from scipy.stats import norm rng = np.random.default_rng(2) n = 100_000 recalls = [0.80, 0.70, 0.50] print(f'独立なら見逃し = {np.prod([1 - r for r in recalls]):.4f}') for rho in [0.0, 0.5, 0.8]: z = rng.standard_normal(n) # 投稿ごとの見抜きにくさ(全段で共通) missed = np.ones(n, dtype=bool) got = [] for r in recalls: e = rng.standard_normal(n) # 段ごとの乱れ latent = np.sqrt(rho) * z + np.sqrt(1 - rho) * e fail = latent > norm.ppf(r) # 失敗する割合がちょうど 1 - r になる線 missed &= fail got.append(1 - fail.mean()) print(f'ρ={rho}: 各段の recall ' + ' / '.join(f'{g:.3f}' for g in got) + f' → 3 段すべてをすり抜ける割合 {missed.mean():.4f}') |
💬 3 段が独立(ρ = 0)なら見逃しは 0.0303 で、掛け算の計算(0.0300)どおりです。各段の recall を 0.80・0.70・0.50 に保ったまま(出力の各段の recall はどの ρ でもほぼ同じ)、失敗の原因を共有させる(ρ = 0.5)と見逃しは約 3.3 倍の 0.0996、ρ = 0.8 では約 5.2 倍の 0.1572 になります。段を足すたびに見逃しが掛け算で小さくなるのは「段ごとに違う理由で失敗する」ときだけで、同じ種類の分類器(同じ学習データで作ったモデル)を重ねても期待ほどは効きません。多層防御の各段を、キーワード・機械学習・人手・利用者通報のように失敗の仕方が違う仕組みで組むのはこのためです。
🧮 計算 ⑤: 自動ブロックの誤り率を、抜き取り確認で見積もる
計算 ② の自動ブロック帯(スコア 0.8 以上)の誤り率は、模擬なら全件の正解が分かっていますが、実際の運用では分かりません。そこで、自動ブロックした投稿から無作為に n 件を抜き出して人が確認し、誤り(本当は無害だった投稿)の件数 k から誤り率を推定します。誤り件数は二項分布 $k \sim \mathrm{Bin}(n, p)$ に従うので、推定値 $\hat p = k/n$ に信頼区間を付けて報告します。ここでは Wilson の 95% 信頼区間を使います。
$$\hat p_{\pm} = \frac{\hat p + \frac{z^2}{2n} \pm z\sqrt{\frac{\hat p(1-\hat p)}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}}, \quad z = 1.96$$| Step | 内容(n = 200 件を確認して k = 12 件が誤り、という仮定の例) | 値 |
|---|---|---|
| 1 | $\hat p = 12 / 200$ | 0.0600 |
| 2 | $z^2 / n = 3.8416 / 200$、$z^2/(2n)$ | 0.019208、0.009604 |
| 3 | $\sqrt{0.06 \times 0.94 / 200 + 3.8416 / 160000}$ = $\sqrt{0.000282 + 0.0000240}$ | 0.017493 |
| 4 | 中心 = (0.06 + 0.009604) ÷ 1.019208、幅 = 1.96 × 0.017533 ÷ 1.019208 | 0.06829、0.03364 |
| 5 | 区間 = 0.06829 ± 0.03364 | [0.0347, 0.1019] |
200 件を確認して誤りが 6.0% に見えても、本当の誤り率は 3.5〜10.2% のどこかにある、という幅つきで報告することになります。同じ計算と、「幅を ±2 ポイントに収めるには何件確認すればよいか」を Python で確かめます。
🎯 このコードでやること:上の手計算(n = 200, k = 12)の Wilson 95% 信頼区間を statsmodels で再現し、誤り率 6% のときに区間の半幅を ±2 ポイント・±1 ポイントにするための確認件数を、n を増やしながら探す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from statsmodels.stats.proportion import proportion_confint lo, hi = proportion_confint(count=12, nobs=200, alpha=0.05, method='wilson') print(f'n=200, k=12: p̂ = {12 / 200:.4f}, 95% 区間 [{lo:.4f}, {hi:.4f}]') for target in [0.02, 0.01]: n = 50 while True: k = round(0.06 * n) # 誤り率 6% を想定 lo, hi = proportion_confint(k, n, alpha=0.05, method='wilson') if (hi - lo) / 2 <= target: break n += 10 print(f'半幅 ±{target:.0%} 以内: n = {n} 件(区間 [{lo:.4f}, {hi:.4f}])') |
💬 手計算と同じ [0.0347, 0.1019] が出て一致します。誤り率が 6% 前後のとき、区間の半幅を ±2 ポイントに収めるには約 560 件、±1 ポイントにするには約 2,180 件の確認が必要です(幅は $1/\sqrt{n}$ で縮むので、精度を 2 倍にするには件数が 4 倍要る)。計算 ② の自動ブロックは 1 日 849 件なので、±2 ポイントの精度なら 1 日分の 3 分の 2 近くを人が見ることになります。確認件数を減らしたいなら、1 週間分からまとめて抜き取る、カテゴリ別に分けて誤りの多そうな層を多めに抜く(層別抽出)などの設計をします。
🧮 計算 ⑥: 通報の多い順に確認すると、何が起きるか
4 層目の「通報」は、人手の確認をどの投稿から始めるかの優先順位にも使われます。ところが通報の件数は「有害かどうか」だけでなく「何人に見られたか」にも比例します。よく見られる無害な投稿には、勘違いや嫌がらせの通報もそれなりに集まります。2 万件の投稿(うち 2% が有害)について、閲覧数を対数正規分布で、1 閲覧あたりの通報確率を有害 0.3%・無害 0.03% として通報数を模擬し(すべて仮定)、確認の優先順位の付け方を 3 通り比べます。
🎯 このコードでやること:2 万件の投稿の閲覧数と通報数を模擬し(seed 3)、①通報数の多い順、②通報率(通報数 ÷ 閲覧数)の高い順、③全体の通報率を事前分布にした平滑化通報率 (通報数 + 1) ÷ (閲覧数 + 1/全体の通報率) の高い順、の上位 200 件に含まれる有害投稿の割合と、上位 200 件の閲覧数の中央値を比べる。一度も通報されない有害投稿の数も数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np rng = np.random.default_rng(3) n = 20_000 views = np.round(np.exp(rng.normal(6, 1.5, n))).astype(int) + 1 y = rng.random(n) < 0.02 # True = 有害 reports = rng.binomial(views, np.where(y, 0.003, 0.0003)) print(f'有害 {y.sum()} 件, 閲覧数の中央値 {np.median(views):.0f}, 通報の総数 {reports.sum():,}') base = reports.sum() / views.sum() # 全体の通報率 orders = { '① 通報数': reports, '② 通報率': reports / views, '③ 平滑化通報率': (reports + 1) / (views + 1 / base), } for name, score in orders.items(): top = np.argsort(-score, kind='stable')[:200] print(f'{name:<8} 上位 200 件の有害割合 {y[top].mean():.3f} 閲覧数の中央値 {np.median(views[top]):,.0f}') print(f'一度も通報されない有害投稿 {(reports[y] == 0).sum()} 件 / {y.sum()} 件') |
💬 通報数の多い順(①)では、上位 200 件のうち有害は 38.0% だけで、閲覧数の中央値は 13,116 と全体(408)の 30 倍以上です。よく見られる無害な投稿が「通報数」で上位を占めてしまいます。単純な通報率(②)は逆に、閲覧数が 100 前後の投稿に 1〜2 件の通報が付いただけで率が跳ね上がり、有害割合は 25.5% とさらに悪くなります。全体の通報率を「事前の見込み」として足し込んだ平滑化通報率(③)は、閲覧数の少ない投稿の率を全体の値へ引き寄せるので偶然の通報に振り回されず、上位 200 件の 80.0% が有害になりました。一方で、有害な 420 件のうち 150 件(36%)は一度も通報されていません。閲覧の少ない有害投稿は通報では見つからないので、通報は分類器や能動的な巡回の「代わり」ではなく「補い」として使います。
ポイント: ③ の平滑化は「件数の少ない県の率が極端な値になる」問題と同じ構造で、統計ではベイズ推定・経験ベイズ(縮小推定)と呼ばれる考え方です。通報に限らず、「いいね率」「クリック率」「苦情率」など、分母(閲覧数)の大きさがばらばらな率で順位を付けるときに必ず出てくる問題です。
🧮 計算 ⑦: 「正解」そのものが揺れる — 2 人の判定者の一致度(Cohen の κ)
計算 ①〜⑥ はすべて「どの投稿が有害かの正解は決まっている」前提でした。しかし 🎨 のカテゴリ(hate・harassment など)の境界は人によって判断が分かれ、評価用データのラベル自体が揺れます。2 人の判定者が同じ 500 件の投稿を独立に判定し、両方とも有害 40 件・A だけ有害 15 件・B だけ有害 25 件・両方とも無害 420 件だった(仮定の例)とします。一致率 92% は高く見えますが、ほとんどの投稿は「明らかに無害」なので、でたらめに判定しても一致率は高くなります。偶然の一致を差し引いた Cohen の κ で評価します。
$$\kappa = \frac{p_o - p_e}{1 - p_e}, \quad p_e = p_A\,p_B + (1-p_A)(1-p_B)$$| Step | 内容 | 値 |
|---|---|---|
| 1 | 一致率 $p_o$ = (40 + 420) ÷ 500 | 0.920 |
| 2 | A が有害と判定した割合 $p_A$ = (40 + 15) ÷ 500、B は $p_B$ = (40 + 25) ÷ 500 | 0.110、0.130 |
| 3 | 偶然の一致 $p_e$ = 0.110 × 0.130 + 0.890 × 0.870 = 0.0143 + 0.7743 | 0.7886 |
| 4 | $\kappa$ = (0.920 − 0.7886) ÷ (1 − 0.7886) = 0.1314 ÷ 0.2114 | 0.622 |
🎯 このコードでやること:上の 2×2 の判定結果(500 件)を 2 人分のラベルの配列に展開し、scikit-learn の cohen_kappa_score で κ を計算して手計算と比べる。有害と判定された投稿に限った一致の割合も出す。
1 2 3 4 5 6 7 8 9 | import numpy as np from sklearn.metrics import cohen_kappa_score cells = {(1, 1): 40, (1, 0): 15, (0, 1): 25, (0, 0): 420} # (A の判定, B の判定): 件数 a = np.concatenate([[i] * k for (i, j), k in cells.items()]) b = np.concatenate([[j] * k for (i, j), k in cells.items()]) print(f'件数 {len(a)}, 一致率 {np.mean(a == b):.3f}, κ = {cohen_kappa_score(a, b):.3f}') either = (a == 1) | (b == 1) print(f'どちらかが有害とした {either.sum()} 件のうち、2 人とも有害 {np.mean(a[either] & b[either]):.3f}') |
💬 κ = 0.622 で手計算と一致します。一致率 0.920 のうち大部分は「両方とも無害」の 420 件によるもので、どちらかが有害とした 80 件に限ると 2 人の意見がそろったのは半分(0.500)です。この評価データで分類器の recall を測ると、A と B のどちらのラベルを正解にするかで値が変わります。有害コンテンツの評価では、判定基準(ガイドライン)の文書化・複数人の判定・不一致の協議を行い、κ を評価データの品質として一緒に報告します。κ が低いカテゴリでは、分類器の性能よりも先に「何を有害と呼ぶか」の定義を詰める必要があります。
✏️ 理解度チェック(計算 ①〜⑦ の数字で)
- 再現率 0.95・偽陽性率 0.02 の分類器を、有害な投稿が 0.5% のサービスに入れた。ブロックした投稿のうち本当に有害なのは何 % か。
答え: 4,750 ÷ (4,750 + 19,900) = 0.193 で約 19%。5 件ブロックすると 4 件は誤削除。 - 計算 ② で τ = 0.5 から 0.6 に上げると、誤削除と見逃しはそれぞれ何件変わるか。
答え: 誤削除は 1,008 → 184 件で 824 件減り、見逃しは 96 → 293 件で 197 件増える。誤削除 1 件より見逃し 1 件を 4.2 倍以上重く見るなら、τ = 0.5 のほうが損失は小さい。 - 計算 ③ で「全体の偽陽性率は英語・日本語とも約 0.9%、全体の recall は約 0.85」と報告された。この報告の問題点は何か。
答え: 言語別の recall(英語 0.93、日本語 0.66)が平均に埋もれている。有害コンテンツ対策の評価は、言語・カテゴリ・利用者層ごとに分けて示す必要がある。 - 計算 ④ で、同じ会社の同じ学習データから作った分類器を 3 段重ねた。各段の recall が 0.8 なら、全体の見逃しは 0.2³ = 0.008 と見積もってよいか。
答え: よくない。同じデータ・同じ仕組みの分類器は同じ投稿で失敗しやすく(失敗の共有 ρ が大きい)、見逃しは掛け算よりずっと大きくなる。計算 ④ では ρ = 0.8 で独立の場合の約 5 倍になった。 - 自動ブロックから 100 件を抜き取って確認したら誤りは 6 件だった。「誤り率は 6%」とだけ報告するのは適切か。
答え: 不十分。n = 100 では Wilson の 95% 区間はおよそ 2.8〜12.5% と広い。区間を付けて報告し、判断に必要な精度から確認件数を決める(±2 ポイントなら約 560 件)。 - 計算 ⑥ で、通報数の多い順に確認すると上位 200 件の有害割合が 38% にとどまった理由を 1 文で述べよ。
答え: 通報数は閲覧数に比例するので、よく見られる無害な投稿が誤った通報を多く集めて上位に入るため。 - 計算 ⑦ の 2 人が 500 件すべてを「無害」と判定していたら、一致率と κ はどうなるか。
答え: 一致率は 1.000 だが、$p_A = p_B = 0$ で $p_e = 1$ となり κ は定義できない(0 ÷ 0)。有害な例が 1 件も含まれない評価データでは判定者の一致度も分類器の recall も測れないので、評価用データには有害な例を意図的に多めに含める(層別に集める)。
| 計算 | 分かったこと(仮定の数値での結果) | 運用での判断 |
|---|---|---|
| ① 有病率と precision | 有病率 1% なら precision 0.324、0.1% なら 0.045 | precision を見る前に有病率を測る。偽陽性率を下げる努力は有病率の低いサービスほど効く |
| ② 閾値 τ | τ 0.5 → 0.6 で誤削除 −824 件、見逃し +197 件 | 見逃しと誤削除の重みを先に決めて τ を選ぶ。判断の難しい帯は人手へ |
| ③ 言語差 | τ = 0.5 で recall 英語 0.93・日本語 0.66 | 指標は言語・カテゴリ別に報告。閾値の付け替えより学習データの補強 |
| ④ 多層防御 | 失敗の共有 ρ = 0.8 で見逃しは独立時の約 5 倍 | 段ごとに失敗の仕方が違う仕組み(キーワード・モデル・人・通報)を組み合わせる |
| ⑤ 抜き取り確認 | 200 件中 12 件の誤りで 95% 区間 3.5〜10.2% | 誤り率は区間つきで報告。必要な精度から確認件数を逆算する |
| ⑥ 通報の順位付け | 通報数順 38%、平滑化通報率順 80%、有害の 36% は通報ゼロ | 通報は閲覧数で割り、少数の偶然を平滑化する。通報だけに頼らない |
| ⑦ 判定者の一致度 | 一致率 0.920 でも κ = 0.622、有害側に限ると一致は半分 | 評価データのラベルの揺れを κ で測り、低いカテゴリは定義から見直す |
注: 計算 ①〜③ の分類器の性能・スコア分布・有病率はすべて説明のために置いた仮定で、特定のサービスやモデルの実測値ではありません。実際の運用では、人手でラベルを付けた評価用データでこれらの値を推定してから同じ計算をします。
🐍 Python 実装
最小限のスニペットで動作確認できる例。 ユーザ投稿テキストのモデレーションを想定しています。
🎯 このコードでやること: OpenAI Moderation API に投稿テキストを 1 件送り、 flagged(どれかのカテゴリで閾値超え)なら BLOCKED と該当カテゴリ名を、 そうでなければ OK を表示する
1 2 3 4 5 6 7 8 9 10 11 12 13 | from openai import OpenAI # OpenAI Moderation API(無料。環境変数 OPENAI_API_KEY が必要) client = OpenAI() resp = client.moderations.create(model="omni-moderation-latest", input="user-supplied text here") result = resp.results[0] if result.flagged: hits = [k for k, v in result.categories.model_dump().items() if v] print("BLOCKED:", hits) else: print("OK") # カテゴリスコア(result.category_scores)で詳細制御も可能 |
💬 読み方: flagged は API 側の閾値で決まる真偽値なので、 上の JSON 例のように violence が 0.012 しかない投稿は OK になる。 自社の基準で線を引きたいときは flagged ではなく result.category_scores の数値を見て、 カテゴリごとに閾値を決める。 openai 1.0 以降は openai.Moderation.create が廃止されており、 古い書き方のままでは APIRemovedInV1 で止まる。
⚠️ よくある落とし穴
📚 関連グループ教材
この用語の全体像を学ぶには、 横断的な教材で文脈を掴むのが効率的です。
harmful content を学ぶ際に併読すると理解が深まる関連グループ教材を以下にまとめる。
- 📚 用語集トップ — 全 514 用語のインデックス
- 🌐 関連手法・派生 — harmful content と関連する具体的な手法群
- 🔗 隣接手法への橋渡し — harmful content と組み合わせる前段・後段手法
- 🌳 手法選択フロー — harmful content を含む手法の使い分け判断
- 🗺 全体概念マップ — 用語集全体の関係図
これらを順に参照することで、 harmful content を中核とした分析の体系的理解が得られる。
🔎 深掘り解説
有害コンテンツの分類体系
| カテゴリ | 例 | 対策難度 |
|---|---|---|
| 違法 | 児童ポルノ、 違法薬物販売 | 明確、 ゼロ容認 |
| 有害(合法) | ヘイト、 誤情報、 自殺方法 | 文脈依存 |
| 知財侵害 | 無断複製、 ディープフェイク | 判定難 |
| プライバシー侵害 | 晒し、 ストーキング | 個別判定 |
| 未成年保護 | 過度な暴力、 性的 | 年齢確認要 |
Red Teaming の実例
- 禁止語を直接禁止 → ロールプレイで回避(「悪役を演じて」)
- 暗号化(「ROT13で」「base64で」)で出力させる
- 多言語間で安全策の差を突く
- 「学術的に説明してください」「歴史教育として」と文脈装飾
- 長文プロンプトで初期指示を埋もれさせる
これらに対する防御として、 多層フィルタ・継続的Red Team・通報機構が必須。
✅ 使う前のチェックリスト
- ☐ 有害コンテンツ が今のタスクに本当に適切か再確認した
- ☐ 分類器の前提(対象言語・モダリティ・想定文脈)が実際の投稿に合っているか確認した
- ☐ 学習データの言語・地域・文脈の偏り(バイアス)を確認した
- ☐ 二値判定ではなくスコアと閾値で扱い、 その閾値での false positive / false negative のコストを検討した
- ☐ 解釈と限界を区別して文書化した
- ☐ 関連する別の手法と比較したうえで本手法を選んだ
- ☐ 落とし穴(このページの ⚠️ セクション)に該当しないか確認した
- ☐ 関連グループ教材で全体像と位置付けを把握した
📖 さらに学ぶには
本サイト内
- 論文一覧に戻る — 有害コンテンツ を実際に使った再現論文をハンズオン形式で読む
- このページ上部の「🔗 関連用語」から派生概念へ
- 「📚 関連グループ教材」で横断的な学習教材へ
外部リソース
- OpenAI Moderation API ドキュメント — 無料の汎用有害度分類
- Perspective API (Google Jigsaw) — 毒性スコアラ(日本語対応)
- EU Digital Services Act (DSA) 本文・解説 — 削除理由通知・透明性レポートの法的枠組み
- Trust & Safety Professional Association (TSPA) — モデレーション実務者向け教材
困ったときは
- 誤検出・見逃しの具体例を集め、 どのカテゴリ・言語で失敗しているかを分類
- 閾値を動かして precision / recall のトレードオフを確認
- キーワード一致か文脈依存かを切り分け(引用・教育目的の言及の誤検出に注意)
- 人手レビューの判定と突き合わせて一致率(Cohen's κ 等)を測る
- 異議申立て・通報のログを学習データへ還流させて再学習
🔎 有害コンテンツ ── 深掘り解説
有害コンテンツ は、 ヘイト、 違法行為の煽動、 誤情報、 ハラスメント、 自傷誘発、 児童に有害な情報など、 オンライン空間で他者・社会に害をもたらす情報の総称です。 EU DSA、 日本のプロバイダ責任制限法等の規制対象。
🔖 キーワード索引(拡張)
💡 もう少し詳しく
- 分類:違法(criminal)/違反(policy violating)/微妙(gray-zone)
- 対応階層:警告 → 編集要求 → 投稿削除 → アカウント停止
- 技術と人:自動分類 → 人的レビュー → 異議申立 の三層
- 誤検出コスト:表現の自由侵害(false positive)と被害放置(false negative)の両方を見る
📐 評価指標
🧮 モデレーション結果の評価例
| 指標 | 値 | 解釈 |
|---|---|---|
| Precision | 0.85 | 削除した投稿の 85% は本当に有害 |
| Recall | 0.62 | 有害投稿のうち 62% を捕捉 |
| F1 | 0.72 | 平衡指標 |
🐍 Python : キーワードフィルタ
🎯 このコードでやること: 禁止語リスト(hate / attack / threat)のどれかを含む英文を NG、 含まない英文を OK と判定する、 最も単純なキーワードフィルタ
1 2 3 4 5 6 | # シンプルなキーワードフィルタ
bad_words = ['hate','attack','threat']
texts = ['hello world', 'I will attack you', 'have a nice day']
for t in texts:
flagged = any(w in t.lower() for w in bad_words)
print(f'{t} → {"NG" if flagged else "OK"}') |
💬 読み方: 3 文のうち attack を含む「I will attack you」だけが NG になった。 判定は部分文字列の一致なので、 「heart attack(心臓発作)」のような無害な文も NG になり、 逆に「I will k1ll you」のような伏字は素通りする。 語の有無だけで決めず、 後段の分類器や人手レビューに回す前段として使う。
🐍 Python : 通報集計
🎯 このコードでやること: カテゴリ別の通報件数(仮想値)から、 各カテゴリが全通報に占める割合(%)を計算する
1 2 3 4 5 6 7 8 | # 通報統計の集計(仮想例)
import pandas as pd
reports = pd.DataFrame({
'category': ['hate','harassment','spam','misinfo','other'],
'count': [120, 80, 200, 45, 30],
})
reports['ratio'] = reports['count'] / reports['count'].sum() * 100
print(reports) |
💬 読み方: 475 件のうち spam が 200 件で 42.1% を占め、 hate 25.3%・harassment 16.8% が続く。 件数の多さと害の大きさは別なので、 9.5% しかない misinfo のほうが確認に時間がかかり優先度が高い、 ということもある。 割合は件数の配分を見るためのもので、 人員配置は重大度と処理時間も合わせて決める。
🐍 Python : スコア分布
🎯 このコードでやること: 機械分類器が 7 件の投稿に付けた有害度スコア(仮想値)の平均と、 閾値 0.5 以上になる割合を計算する
1 2 3 4 5 | # 機械分類スコアの分布
import pandas as pd
scores = pd.Series([0.05, 0.12, 0.55, 0.78, 0.91, 0.02, 0.33])
print('平均:', scores.mean())
print('閾値 0.5 以上の割合:', (scores >= 0.5).mean() * 100, '%') |
💬 読み方: 平均は 0.394 と閾値 0.5 を下回るが、 0.5 以上は 7 件中 3 件(0.55・0.78・0.91)で 42.9% がブロック対象になる。 スコアは 0.02〜0.91 と両端に散っているので、 平均だけ見て「全体に安全」とは言えない。 0.55 のように閾値すれすれの投稿は、 閾値を 0.6 に上げるだけで結論が変わる。
🐍 Python : 措置可視化
🎯 このコードでやること: 適用した措置(warning / removal / ban)の件数(仮想値)を棒グラフにして mod_action.png に保存する
1 2 3 4 5 6 | # 適用ポリシーの可視化
import matplotlib.pyplot as plt
labels = ['warning','removal','ban']
counts = [60, 25, 15]
plt.bar(labels, counts, color=['#FFB300','#E64A19','#B71C1C'])
plt.tight_layout(); plt.savefig('mod_action.png', dpi=150) |
💬 読み方: 100 件の措置のうち warning が 60 件と過半で、 removal 25 件、 ban 15 件と重い措置ほど少ない形の棒になる。 警告 → 削除 → 停止の段階的対応が機能していれば、 このように軽い措置に件数が寄る。 ban の比率が急に増えたら、 基準の変更か誤判定の増加を疑う。
⚠️ 落とし穴
🔗 関連用語(拡張)
📚 補足資料 — FAQ/追加コード/背景
❓ よくある質問 (FAQ)
有害コンテンツの基準は?
AI 自動モデレーションは万能?
プラットフォーム責任は?
通報受信から対応の SLA は?
ユーザの誤通報対応は?
🧪 カテゴリ別 通報・削除統計の例(仮想値)
| カテゴリ | 年間通報数(仮) | 削除率 | 再申立 |
|---|---|---|---|
| ヘイト | 12,000 | 75% | 8% |
| ハラスメント | 8,000 | 60% | 12% |
| スパム | 30,000 | 98% | 1% |
| 誤情報 | 4,500 | 40% | 20% |
| その他 | 3,000 | 30% | 15% |
🐍 さらにコードを書く
通報→分類→アクションのパイプライン
🎯 このコードでやること: 各通報に有害度スコアを付与し、 閾値で remove / review / keep の 3 アクションに振り分ける
1 2 3 4 5 6 7 8 9 | import pandas as pd
reports = pd.DataFrame({
'id':[1,2,3,4],
'category':['hate','spam','misinfo','harassment'],
'score':[0.92, 0.99, 0.55, 0.78],
})
reports['action'] = reports['score'].apply(
lambda s: 'remove' if s > 0.85 else 'review' if s > 0.5 else 'keep')
print(reports) |
💬 読み方: 有害判定は二値 (削除/放置) ではなく、 スコアに応じた段階的アクションにするのが実務的。 remove 閾値 (0.85) と review 閾値 (0.5) の 2 段構えにすることで、 グレーゾーンを人手レビューに回し、 過剰削除 (false positive) と見逃し (false negative) を同時に抑える。
検索ベース簡易フィルタ
🎯 このコードでやること: 禁止語リストによる最も単純な検索ベース (キーワードマッチング) フィルタを実装する
1 2 3 4 5 6 | blacklist = ['terror', 'kill', 'weapon']
def filter_text(t):
return any(w in t.lower() for w in blacklist)
tests = ['hello world', 'how to make a weapon', 'happy day']
for t in tests:
print(t, '→', filter_text(t)) |
💬 読み方: キーワード一致は実装が簡単だが、 文脈を見ない (引用・教育目的の言及や、 表記ゆらし・伏字による回避に弱い) という限界がある。 ML ベース分類器の前段フィルタとして使い、 グレーゾーンは後段の分類器や人手レビューに委ねる構成が現実的。
Precision / Recall を算出する
🎯 このコードでやること: モデレーション分類器の予測と正解ラベルから、 precision と recall を算出する
1 2 3 4 5 | from sklearn.metrics import precision_score, recall_score
y_true = [1,0,1,1,0,1]
y_pred = [1,0,0,1,1,1]
print('Precision:', precision_score(y_true, y_pred))
print('Recall:', recall_score(y_true, y_pred)) |
💬 読み方: precision は「削除したうち本当に有害だった割合」、 recall は「有害投稿のうち捕捉できた割合」。 モデレーションでは両者がトレードオフになるため、 見逃しの害 (recall 重視) と過剰検閲の害 (precision 重視) のどちらを優先するかをカテゴリごとに決める。 削除理由の通知は EU DSA (Digital Services Act) で法的義務であり、 透明性と不服申立ての導線も併せて設計する。
💡 実務的アドバイス
- AI 分類の 信頼区間を必ず出力。 黒白判定よりリスクスコアを。
- 人間レビュアのケア(メンタルヘルス、 ローテーション)が必要。
- 異議申立て率を継続的にモニタし、 学習データへフィードバック。
- 地域・言語別の判定方針を分割し、 文化差に対応。
🕰 歴史的背景・発展経緯
プロバイダ責任制限法(日本)は 2002 年に施行。 「通知+削除+責任制限」のモデルを提供。
EU は 2022 年に Digital Services Act(DSA)を採択、 2024 年から本格適用。 大規模プラットフォームに違法コンテンツ対応の年次レポート義務。
日本は 2023 年改正プロ責法で「発信者情報開示の迅速化」を実現。 名誉毀損や中傷への対応プロセスが明確化。