🔖 キーワード索引
本ページは DML(データ操作言語)(Data Manipulation Language)を多角的に解説します。 上のチップは、 検索・関連語の手がかりです。
「dml」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「dml」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「dml の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データの中身を操作する道具です。
データの追加や変更をするために使います。
スマホアプリの情報を書き換えるような操作です。
安全に使うためのコツを学びましょう。
- SQL の中で、 データの中身を操作する命令群(INSERT, UPDATE, DELETE, SELECT)
- DDL(テーブル構造を定義)、 DCL(権限管理)と並ぶ SQL の主要分類
- RDBMS の日常業務の中心 ─ アプリ開発・データ分析で頻繁に使う
- WHERE 句のミスで全行更新・削除する事故が定番
- トランザクション(BEGIN / COMMIT / ROLLBACK)と組み合わせて安全に運用
💡 DML 実践 Tips 20
- UPDATE/DELETE 前に必ず SELECT で確認
- BEGIN; ... ROLLBACK; の儀式を習慣化
- WHERE で複数条件は AND/OR の優先順位に注意 (括弧で明示)
- LIKE のワイルドカードは右側のみが高速
- JOIN は ON 句で条件指定 (WHERE は使わない)
- サブクエリより JOIN の方が高速なことが多い
- SELECT * は避け、 必要列を明示
- 大量データの INSERT はバルク (1000 行ずつ)
- EXPLAIN で実行計画を確認
- インデックスは過剰だと INSERT/UPDATE が遅くなる
- NULL は計算で消える (NULL + 1 = NULL)
- COUNT(*) と COUNT(列) は意味が違う (NULL の扱い)
- DISTINCT は遅い、 GROUP BY の方が速いことも
- HAVING は GROUP BY 後の WHERE
- UNION ALL は UNION より速い (重複排除なし)
- EXISTS は IN より速いことが多い
- VIEW で複雑クエリを抽象化
- マテリアライズドビューで集計を事前計算
- パーティションで巨大テーブルを分割
- 定期的に VACUUM / ANALYZE で統計情報更新
❓ よくある質問 (FAQ)
- Q. SQL は時代遅れ?
- A. 全く逆。 50 年経っても代替されず、 むしろ NoSQL ブームの後に再評価。 BigQuery など現代 DWH も SQL ベース。
- Q. ORM と raw SQL どちらを使う?
- A. Web アプリは ORM、 分析・バッチは raw SQL が多い。 パフォーマンスは raw SQL が有利。
- Q. SQLite と PostgreSQL どちらを学ぶ?
- A. 初心者は SQLite (設定不要)、 実務では PostgreSQL。 文法は 95% 共通。
- Q. NoSQL を使うべき場面は?
- A. スキーマが頻繁に変わる、 ペタバイト級、 グラフ構造、 全文検索など。 通常は RDB で十分。
- Q. SELECT が遅いときの対処は?
- A. ① EXPLAIN で実行計画確認 ② インデックス追加 ③ クエリ書き換え ④ パーティション
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
データベースの中核となる言葉です。
データの検索や削除を行うために使います。
部活の名簿を管理する仕組みのようなものです。
データエンジニアリングの基本を学びます。
DML(Data Manipulation Language)は、 リレーショナルデータベース(RDB)でデータの追加・更新・削除・検索を行う SQL の中核です。 業務アプリケーションのバックエンド、 データウェアハウス、 BI ツールでも基盤として使われます。 SQL を知らずしてデータエンジニアリングは語れないと言える基本技術です。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
データの読み書きをするための命令です。
テーブルの中身を自由に変えるために使います。
買い物リストに品物を書き足す感覚です。
他の命令との違いについて学びましょう。
SQL の命令は大きく 3 つに分類されます:
| 分類 | 用途 | 命令例 |
|---|---|---|
| DML(操作) | データの中身を扱う | SELECT, INSERT, UPDATE, DELETE |
| DDL(定義) | テーブル構造を作る・変える | CREATE, ALTER, DROP |
| DCL(制御) | 権限・トランザクション | GRANT, REVOKE, COMMIT |
本ページで扱う DML は 「データの読み書き」そのもの。 業務アプリで一番使う命令群です。
📐 定義
🍰 まずはやさしく
データを操作するための専用の言語です。
データの集合を計算して書き換えるために使います。
テストの点数一覧から特定の人の点数を探す操作です。
それぞれの命令の意味を詳しく学びます。
SELECT/INSERT/UPDATE/DELETE 等の操作言語。 関係代数の視点では、 各命令は集合演算として形式化される:
ここで $R$ はリレーション(テーブル)、 $\sigma_p$ は条件 $p$ による選択、 $\pi$ は射影、 $f$ は更新写像。 英語名 Data Manipulation Language、 カテゴリ:データエンジニアリング。
📐 関係代数の全演算 — 数式を言葉で読み解く
| 記号 | 名称 | 意味 | SQL 例 |
|---|---|---|---|
| σ | 選択 | 条件に合う行を抽出 | WHERE |
| π | 射影 | 指定列を取り出す | SELECT col |
| × | 直積 | 全組み合わせ | CROSS JOIN |
| ∪ | 和 | 2 つの結果を合体 (重複除去) | UNION |
| − | 差 | 片方にあって他方にない | EXCEPT |
| ∩ | 共通 | 両方にある | INTERSECT |
| ⋈ | 自然結合 | 同名列で結合 | NATURAL JOIN |
| ⋈θ | 条件結合 | 条件 θ で結合 | JOIN ON |
| ÷ | 商 | 「全てを満たす」を抽出 | 複雑 (相関サブクエリ) |
| γ | 集約 | グループごとに集計 | GROUP BY |
| τ | 整列 | 並び替え | ORDER BY |
SQL は関係代数の 実用版。 純粋な集合論的扱いから、 NULL や重複の扱いが現実的な妥協を含む。
🔬 数式を言葉で読み解く
- SELECT
- データの取得(読み取り)。 「どの列を、 どの行から、 どんな条件で」を指定
- INSERT
- 新しい行を追加
- UPDATE
- 既存の行の値を変更。 WHERE を忘れると全行更新の事故
- DELETE
- 行を削除。 同じく WHERE 必須
- JOIN
- 複数テーブルを連結。 INNER, LEFT, RIGHT, FULL の 4 種
- WHERE
- 絞り込み条件。 DML の安全装置
🔬 EXPLAIN で実行計画を読む
SQL の高速化は EXPLAIN で内部を見ることから。 PostgreSQL の例:
「Seq Scan」は全行スキャン。 「Index Scan」「Bitmap Heap Scan」が出ればインデックスが効いている。 大規模データでは Seq Scan を Index Scan に変えるだけで 100 倍速くなることも。
👁 ビューとマテリアライズドビュー
| 種類 | 動作 | 用途 |
|---|---|---|
| VIEW (通常) | SELECT のエイリアス、 毎回実行 | クエリの再利用、 セキュリティ (列制限) |
| Materialized View | 結果を物理保存、 REFRESH で更新 | 重い集計を事前計算 |
| Temporary Table | セッション中だけ存在 | 中間結果保存 |
| CTE (WITH) | クエリ内だけ有効 | 段階的なクエリ構築 |
💾 ストレージエンジンと内部構造
| エンジン | DBMS | 特徴 |
|---|---|---|
| InnoDB | MySQL/MariaDB | トランザクション対応、 標準 |
| MyISAM | MySQL (旧) | 速いがトランザクション無し |
| RocksDB | MySQL/CockroachDB | LSM-Tree、 書き込み高速 |
| WiredTiger | MongoDB | 圧縮、 トランザクション |
| SQLite ファイルベース | SQLite | B-Tree、 シンプル |
| PostgreSQL Heap | PostgreSQL | MVCC、 高機能 |
| カラム指向 (Parquet, ORC) | BigQuery 等 | 分析クエリで高速 |
☁ クラウド DB と DWH
| サービス | 提供元 | 特徴 |
|---|---|---|
| Amazon RDS | AWS | MySQL/PostgreSQL マネージド |
| Amazon Aurora | AWS | RDS の高速版 |
| Amazon Redshift | AWS | カラム指向 DWH |
| Google Cloud SQL | GCP | OLTP マネージド |
| BigQuery | GCP | サーバーレス DWH |
| Azure SQL Database | Azure | SQL Server マネージド |
| Snowflake | 独立 | マルチクラウド DWH |
| Databricks | 独立 | Lakehouse |
| PlanetScale | 独立 | サーバーレス MySQL |
| Supabase | 独立 | PostgreSQL ベース |
📊 主要データ型
| 型 | 用途 | 注意 |
|---|---|---|
| INTEGER / INT | 整数 | サイズ別: SMALLINT, BIGINT |
| REAL / FLOAT / DOUBLE | 浮動小数 | 精度に注意 (金額には NUMERIC) |
| NUMERIC / DECIMAL | 固定小数 | 金融計算に必須 |
| VARCHAR(n) | 可変長文字列 | n は最大長 |
| TEXT | 長文 | 制限なし |
| BOOLEAN | 真偽値 | SQLite は 0/1 で代用 |
| DATE | 日付 | YYYY-MM-DD |
| TIMESTAMP | 日時 | タイムゾーン考慮 |
| JSON / JSONB | 半構造化 | PostgreSQL/MySQL 対応 |
| UUID | 分散 ID | 分散システム用 |
| BYTEA / BLOB | バイナリ | 画像等 |
| ARRAY | 配列 | PostgreSQL |
| GEOMETRY | 地理空間 | PostGIS 拡張 |
✅ DML ベストプラクティス 20
- UPDATE/DELETE 前に SELECT で確認
- BEGIN; ROLLBACK; の儀式を習慣化
- プレースホルダで SQL インジェクション防止
- SELECT * を避ける、 必要列を明示
- JOIN は ON で条件指定
- WHERE で関数を使わない (インデックス無効化)
- LIKE のワイルドカードは右側のみ
- NULL は IS NULL で比較
- 大量 INSERT はバルクで
- EXPLAIN で実行計画確認
- 適切なインデックス追加
- 過剰なインデックスは INSERT を遅くする
- 定期的な VACUUM/ANALYZE
- ストアドプロシージャより アプリ側でロジック
- マテリアライズドビューで重い集計を高速化
- パーティションで大規模テーブル分割
- ORM 使用時は N+1 問題に注意
- マイグレーション (Flyway, Alembic) で変更管理
- バックアップを定期的に
- 本番では権限を最小化 (DCL)
💭 考察問題
- 歴史的考察: なぜ SQL は 50 年経っても代替されないのか? Codd の関係モデルの何が革新的だったか?
- 技術的考察: NoSQL ブームが過ぎ、 NewSQL (SQL 互換の分散 DB) が台頭する理由
- 設計考察: 完全正規化 (3NF) と非正規化、 どちらが正しいか? シチュエーション別に
- パフォーマンス考察: SSDSE-B-2026 (564 行) を SQLite/pandas/PostgreSQL で処理する場合の速度比較
- 運用考察: 「マイグレーション失敗で本番停止」を防ぐためのプロセスは?
- セキュリティ考察: SQL インジェクション以外の DB セキュリティリスクは何があるか?
- 未来予測: 生成 AI と DML の関係 — 自然言語から SQL を生成する Text-to-SQL の未来
- 教育考察: 高校生にプログラミング教育する際、 SQL は何番目に教えるべきか?
🤖 LLM 時代の DML — Text-to-SQL
「日本語で質問するだけで SQL が自動生成される」時代が到来しています。 これは DML の未来を変える可能性があります。
| サービス | 提供元 | 特徴 |
|---|---|---|
| ChatGPT Code Interpreter | OpenAI | CSV を直接分析、 SQL も生成 |
| Claude Sonnet | Anthropic | SQL の高品質生成 |
| Gemini Code | BigQuery 統合 | |
| Vanna.ai | 独立 | Text-to-SQL 特化 OSS |
| DataLine | 独立 | BI ツール統合 |
| Defog SQLCoder | 独立 | SQL 専用 LLM |
「東京都の 2023 年人口を教えて」と聞けば SQL が生成され、 DB から答えが返る。 ただし生成された SQL の正しさ検証は人間の責任。
🇯🇵 日本での DML 活用
- 政府基幹系: 住基ネット、 マイナンバー基盤 (Oracle / PostgreSQL)
- 金融: 銀行勘定系 (大型コンピュータ + DB2/Oracle)
- EC: 楽天 (MySQL + 自社拡張)、 Amazon Japan (Oracle/DynamoDB)
- SNS: LINE (MySQL/Redis)
- 製造: トヨタの生産管理 (SAP HANA, Oracle)
- 政府データ: e-Stat の裏側 (PostgreSQL)
- 研究: 独立行政法人統計センターの SSDSE データ (CSV → PostgreSQL/SQLite)
- 教育: 学校基本調査の集計 (SAS, R, SQL)
日本の社会インフラの大半が SQL + DML で動いている。 「目に見えないが社会を支える技術」の代表例。
🎓 学習パス
- Week 1: SQLite インストール、 SSDSE-B-2026 を投入
- Week 2: SELECT の基本 (WHERE, ORDER BY, LIMIT)
- Week 3: GROUP BY と集計関数
- Week 4: JOIN を理解
- Week 5: UPDATE / DELETE / INSERT (トランザクションも)
- Week 6: サブクエリと CTE
- Week 7: Window 関数
- Week 8: インデックスと EXPLAIN
- Week 9: PostgreSQL に移行、 本番機能を学ぶ
- Week 10: ORM (SQLAlchemy) を学ぶ
- Week 11: パフォーマンスチューニング
- Week 12: 実プロジェクトで運用
🔗 学習リソース
- SQLZoo: ブラウザで SQL を学べる無料サイト
- HackerRank SQL: 問題を解いて学ぶ
- LeetCode Database: 中〜上級者向け
- StrataScratch: 実務的な SQL 問題
- Coursera "Databases" by Stanford: 古典的講義
- Khan Academy SQL: 入門に最適
- Mode SQL Tutorial: BI ツール統合
- PostgreSQL 公式チュートリアル: 公式ドキュメント
- 達人 SQL (ミック): 日本語の名著
- SQLBolt: 短時間で基本を学ぶ
🐼 pandas 操作と SQL 完全対応表
| pandas | SQL | 説明 |
|---|---|---|
df.head(10) | SELECT * FROM t LIMIT 10 | 先頭 10 行 |
df.tail(5) | SELECT * FROM t ORDER BY id DESC LIMIT 5 | 末尾 |
df.shape | SELECT COUNT(*) FROM t | 行数 |
df.columns | PRAGMA table_info(t) | 列名 |
df['col'].unique() | SELECT DISTINCT col FROM t | ユニーク値 |
df['col'].value_counts() | SELECT col, COUNT(*) GROUP BY col ORDER BY 2 DESC | 頻度集計 |
df.describe() | SELECT MIN, MAX, AVG, ... | 基本統計 |
df.isnull().sum() | SELECT SUM(CASE WHEN col IS NULL THEN 1 ELSE 0 END) | 欠損数 |
df.dropna() | WHERE col IS NOT NULL | 欠損除外 |
df.fillna(0) | COALESCE(col, 0) | 欠損補完 |
df.sort_values('x') | ORDER BY x | 並び替え |
df.groupby('y').agg(...) | GROUP BY y | 集計 |
pd.merge(df1, df2) | INNER JOIN | 結合 |
pd.concat([df1, df2]) | UNION ALL | 縦結合 |
df.pivot_table(...) | 条件付き集計 + PIVOT | ピボット |
df.duplicated() | GROUP BY col HAVING COUNT(*) > 1 | 重複検出 |
df.apply(func) | UDF (ユーザー定義関数) | カスタム処理 |
🚫 アンチパターン集
- SELECT *: 不要な列まで取って遅い、 スキーマ変更で壊れる
- WHERE 1=1: 動的クエリ生成時の悪習
- WHERE 句なしの UPDATE/DELETE: 全行破壊
- サブクエリ濫用: JOIN や CTE の方が読みやすい
- カラムに関数:
WHERE LOWER(name)=...はインデックス無効 - LIKE の両端 %: インデックス無効
- NOT IN: NULL を含むとバグ
- 暗黙の JOIN:
WHERE t1.id = t2.idはやめ、JOIN ONに - 大量データの 1 行ずつ INSERT: バルクで
- 本番でテスト DELETE: ステージング環境を使う
- auto_commit off で COMMIT 忘れ: データが反映されない
- ストアドプロシージャ濫用: ロジックがアプリと DB に分散
- 過剰インデックス: INSERT/UPDATE が遅くなる
- NULL を 0 で代用: 集計が狂う
- 日付を VARCHAR で保存: 比較・並び替えがおかしい
📂 ケーススタディ集
ケース ① 銀行送金
A → B に 1 万円送金:
ACID の Atomicity が必須。 片方だけ成功して片方失敗は許されない。
ケース ② 在庫管理
商品の在庫が複数あるとき、 同時に複数の注文が来たら:
ケース ③ ユーザー集計
「最近 30 日でアクティブな県別ユーザー数」:
ケース ④ SSDSE × 補助データの分析
SSDSE-B-2026 と外部の経済指標を JOIN して相関分析:
📦 マイグレーション — DB スキーマ変更管理
本番 DB のスキーマ変更を安全に行うのが マイグレーション。 ツール一覧:
| ツール | 言語 | 特徴 |
|---|---|---|
| Flyway | Java | シンプル、 SQL ベース |
| Liquibase | Java | XML/YAML、 高機能 |
| Alembic | Python | SQLAlchemy 統合 |
| Django Migrations | Python | Django 標準 |
| Rails Migrations | Ruby | Rails 標準 |
| Sequelize | Node.js | JavaScript |
| Prisma | Node.js | モダン、 型安全 |
| golang-migrate | Go | Go 製、 高速 |
マイグレーションは「up (適用)」と「down (取り消し)」のペア。 失敗時に即ロールバックできる。
💾 バックアップとリストア
| 方式 | 特徴 | 用途 |
|---|---|---|
| 論理バックアップ | SQL ダンプ (pg_dump, mysqldump) | 小〜中規模 |
| 物理バックアップ | データファイル直接コピー | 大規模、 速い |
| 増分バックアップ | 差分のみ保存 | 毎日実行 |
| ストリーミング (PostgreSQL) | リアルタイムレプリケーション | HA 構成 |
| スナップショット | クラウド機能 | AWS RDS, GCP Cloud SQL |
| WAL アーカイブ | トランザクションログ保存 | Point-in-Time Recovery |
「バックアップを取っただけでリストア練習をしていない = バックアップなし」というのが業界の格言。 必ず復元テストを。
🔬 集合代数とトランザクション意味論 — 深掘り
DML (SELECT / INSERT / UPDATE / DELETE) は数学的には「関係代数」+「トランザクション意味論」で形式化される。 関係 R を集合と見なすと、 各演算は集合演算に対応する:
| DML | 関係代数 | 数式 | SSDSE-B での意味 |
|---|---|---|---|
| SELECT | 射影 π + 選択 σ | π_{cols}(σ_{pred}(R)) | 「人口 100万以上の県の県名と人口を抽出」 |
| INSERT | 和集合 | R ← R ∪ {t} | 「新しい年度の SSDSE 行を追加」 |
| UPDATE | 差 + 和 | R ← (R \ σ_p R) ∪ f(σ_p R) | 「人口データを最新値に上書き」 |
| DELETE | 差集合 | R ← R \ σ_p R | 「廃止された旧コード行を削除」 |
このコードでやること: SSDSE-B-2026 を SQLite に投入し、 SELECT で集約 → UPDATE で派生列を一括計算 → トランザクション内で BEGIN/COMMIT を使う一連の DML フローを示す。
📥 入力データ:
2023,R01000,北海道,5092000,1681000
2023,R13000,東京都,14086000,3205000
2023,R47000,沖縄県,1468000,350000
... (47 行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import sqlite3 # 英字の項目コードを使うので、2 行目の日本語名を読み飛ばす df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年 (2023) の 47 県 conn = sqlite3.connect(':memory:') # 必要列だけ投入 # 注意: SSDSE-B に面積 (B1101) の列は無いので、人口密度ではなく # 収録されている 65 歳以上人口 (A1303) から高齢化率を計算する df[['Prefecture', 'A1101', 'A1303']].to_sql('pref', conn, index=False) cur = conn.cursor() cur.execute('BEGIN') # ALTER で派生列を追加し UPDATE で高齢化率を計算 cur.execute('ALTER TABLE pref ADD COLUMN aging_rate REAL') cur.execute('UPDATE pref SET aging_rate = A1303 * 100.0 / A1101') # % cur.execute('COMMIT') # 高齢化率 32% 以上の上位 5 件 rows = cur.execute( 'SELECT Prefecture, ROUND(aging_rate, 1) FROM pref ' 'WHERE aging_rate > 32 ORDER BY aging_rate DESC LIMIT 5' ).fetchall() for r in rows: print(r) |
📤 実行例:
('高知県', 36.3)
('徳島県', 35.4)
('山口県', 35.4)
('青森県', 35.2)
💬 結果の読み方: BEGIN/COMMIT で囲んだ UPDATE は ACID の「Atomicity」を担保し、 失敗時は ROLLBACK で全て巻き戻る。 1 文の UPDATE で 47 行すべてに派生列 aging_rate (%) を一括計算でき、 続く SELECT (WHERE aging_rate > 32) で秋田 39.1%・高知 36.3%・徳島 35.4%・山口 35.4%・青森 35.2% と上位 5 県が即座に得られる。 徳島と山口は小数 1 桁に丸めると同じ 35.4 だが、 並べ替えは丸める前の値で行われている。 pandas でも df['aging_rate'] = df['A1303'] * 100 / df['A1101'] の 1 行で書けるが、 SQL の UPDATE はデータをデータベースに置いたまま宣言的に書き換えられ、 トランザクションで守られる点が DML の威力。
🖼 視覚で確認する:DML 結果を集計・可視化する
DML(INSERT/UPDATE/DELETE/SELECT)の結果は、 多くの場合「集計→分布→ランキング」という3段階で可視化されます。 SSDSE-B-2026 を例にした典型的な可視化を3点示します。
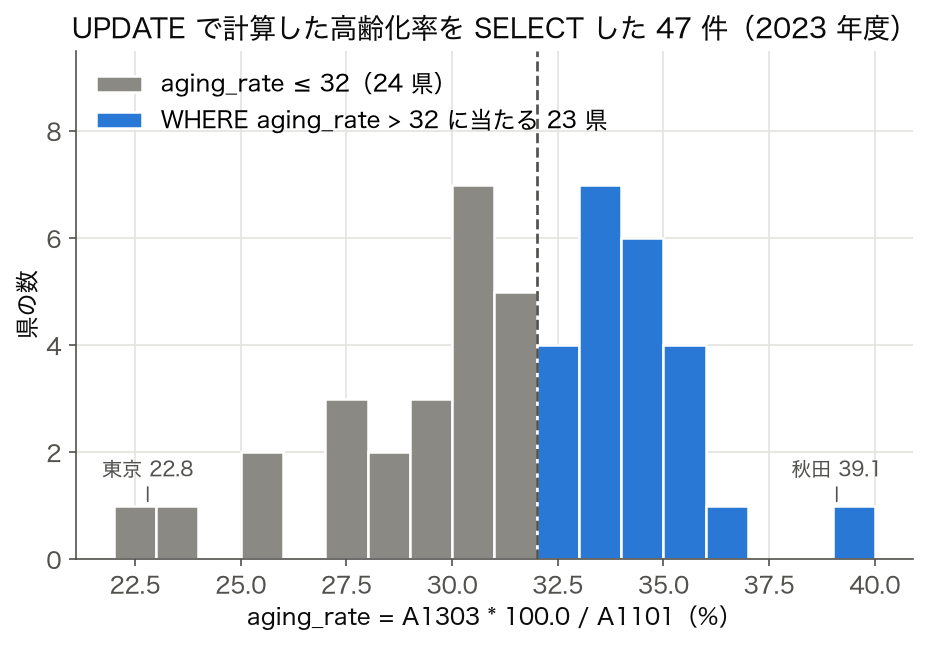
UPDATE pref SET aging_rate = A1303 * 100.0 / A1101 で計算した 2023 年度 47 都道府県の高齢化率を SELECT aging_rate FROM pref で取り出したヒストグラム(ビン幅 1%)。 AVG は 31.6%、 最小は東京 22.8%、 最大は秋田 39.1%。 WHERE aging_rate > 32 に当たるのは青の 23 県で、 LIMIT 5 で見た上位 5 県はその右端にすぎない。 SELECT の結果を集計・ランキングする前に、 連続値カラムの分布を最初に把握する基本ツール。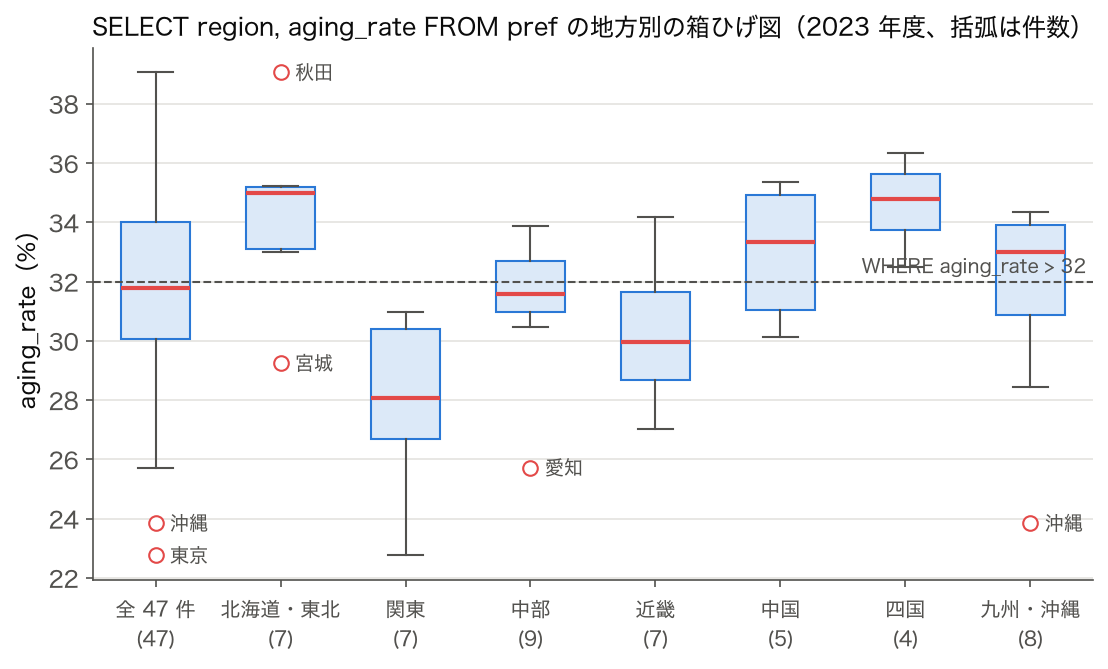
ALTER TABLE pref ADD COLUMN region TEXT で地方の列を足し、 UPDATE ... SET region = CASE ... で 7 地方を入れてから SELECT region, aging_rate FROM pref で取り出した箱ひげ図。 全 47 件では箱が 30.0〜34.0% で、 1.5×IQR の外側の外れ値は東京都 22.8% と沖縄県 23.8%。 GROUP BY region の平均は四国 34.6% が最も高く関東 28.0% が最も低い。 地方ごとに見ると秋田県(39.1%)・宮城県(29.2%)・愛知県(25.7%)も外れ値になる。 UPDATE 結果や WHERE 条件で抽出したサブセットの代表値・散らばりを一目で確認できる。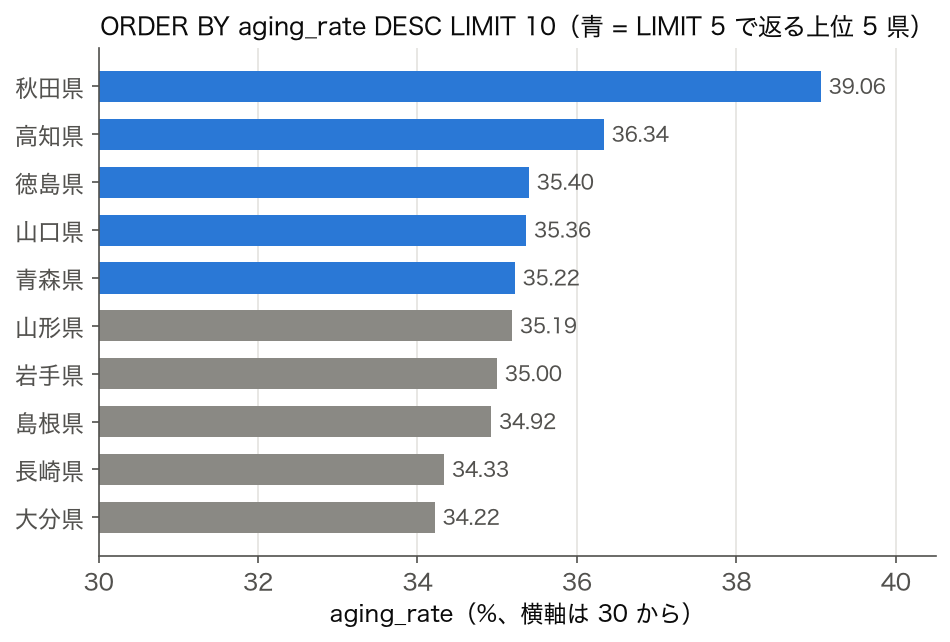
SELECT Prefecture, aging_rate FROM pref ORDER BY aging_rate DESC LIMIT 10 の結果を横棒グラフにしたもの。 青の 5 県(秋田 39.06・高知 36.34・徳島 35.40・山口 35.36・青森 35.22)が上のコードの LIMIT 5 で返る行で、 6 位の山形 35.19 は青森と 0.03 ポイントしか違わない。 LIMIT の切れ目の前後の差が小さいかどうかも確かめてから順位を読む。DML は数値を返すだけで完結せず、 続く可視化と組み合わせることで意思決定に直結する情報になります。
🧮 実値で計算してみる
具体的な DML 操作の例(都道府県データ):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | -- 1. SELECT(読み取り) SELECT 都道府県名, 高齢化率, 死亡率 FROM 統計表 WHERE 高齢化率 > 30 ORDER BY 高齢化率 DESC LIMIT 10; -- 2. INSERT(追加) INSERT INTO 統計表 (都道府県名, 高齢化率, 死亡率) VALUES ('東京都', 23.4, 9.8); -- 3. UPDATE(更新)— WHERE 必須 UPDATE 統計表 SET 死亡率 = 10.5 WHERE 都道府県名 = '東京都'; -- 4. DELETE(削除)— WHERE 必須 DELETE FROM 統計表 WHERE 年 < 2010; |
赤線:UPDATE と DELETE で WHERE を忘れると全行が一発で書き換えられる。 必ず先に SELECT で確認すること。
DML 操作後の行数変化を数値で確認する
初期テーブルに 5 都道府県が登録されているとする。高齢化率 (%) のベクトルは(SSDSE-B-2026 の 2023 年、65 歳以上人口 A1303 ÷ 総人口 A1101 × 100):
高齢化率 データ: [33.0, 22.8, 39.1, 35.0, 34.9](北海道・東京・秋田・岩手・島根 の順)
初期行数 $n_0 = 5$。 以下の DML を順に実行した場合の行数変化を手計算する。
Step 1 — INSERT 2 件: 神奈川・大阪を追加
ΔINSERT = [2] → 行数 = 5 + 2 = 7
Step 2 — DELETE WHERE 高齢化率 < 25: [22.8](東京都)→ 1 件削除
ΔDELETE = [1] → 行数 = 7 − 1 = 6
Step 3 — UPDATE 1 件: 秋田の死亡率を更新 (行数変化なし, Δ = 0)
行数 = 6 + 0 = 6
Step 4 — SELECT COUNT(*): 読み取り専用、 行数変化なし
最終行数 $n_{\text{final}} = n_0 + \sum\Delta_{\text{INSERT}} - \sum\Delta_{\text{DELETE}} = 5 + 2 - 1 = \mathbf{6}$
同じ計算を Python で再現する:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np # 初期テーブル: 5 都道府県の高齢化率 (SSDSE-B-2026, 2023 年, A1303/A1101) aging_rates = [33.0, 22.8, 39.1, 35.0, 34.9] n0 = len(aging_rates) # 5 # Step 1: INSERT 2 件 delta_insert = [2] n1 = n0 + sum(delta_insert) # 7 # Step 2: DELETE WHERE 高齢化率 < 25 → 東京都の 22.8 が 1 件マッチ delta_delete = [1] n2 = n1 - sum(delta_delete) # 6 # Step 3: UPDATE は行数変化なし n_final = n2 # 6 # 数式で直接計算 n_formula = n0 + sum(delta_insert) - sum(delta_delete) print(f"手計算: {n_final}, 数式: {n_formula}, 一致: {np.allclose(n_final, n_formula)}") |
📤 実行すると次の出力が得られる:
💬 手計算 6 と Python 出力 6 で一致。 np.allclose が True を返したことで、 $n_{\text{final}} = 5 + 2 - 1 = 6$ が数式・手計算・実装の三者で同じ値であることが確認できる。
🧮 SSDSE-B-2026 を SQLite に投入 — 数式を言葉で読み解く
DML の真価は 実データで体感するのが一番。 SSDSE-B-2026 (47 都道府県 × 12 年 = 564 行) を SQLite に投入し、 様々な SELECT/UPDATE を試してみましょう。
関係代数の 3 つの基本演算 — 数式を言葉で読み解く
| 関係代数 | SQL での実現 | 意味 |
|---|---|---|
| 選択 (Selection) σ | WHERE 句 | 条件に合う「行」を選ぶ |
| 射影 (Projection) π | SELECT 列名 | 必要な「列」だけ取り出す |
| 結合 (Join) ⋈ | JOIN ON | 複数テーブルを連結 |
| 和 (Union) ∪ | UNION | 2 つのクエリ結果を合体 |
| 差 (Difference) − | EXCEPT | 片方にあって他方にない |
| 積 (Cartesian Product) × | CROSS JOIN | 全組み合わせ |
例えば「東京都の 2023 年人口」を取るクエリ:
SELECT A1101 FROM ssdse WHERE Prefecture = '東京都' AND year = 2023;🐍 Python 実装
このコードでやること: SSDSE-B-2026.csv を SQLite に読み込み、 pd.read_sql で SELECT 文を実行して結果を DataFrame として取得する最小構成。 DML の基本フローをそのまま Python で確認できる。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()] for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # 見本でよく使われる仮の列名を、実データから作っておく df['income'] = df['消費支出(二人以上の世帯)'] df['population'] = df['総人口'] _region = {'北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東'} df['region'] = df['都道府県'].map(_region).fillna('その他') df['地域'] = df['region'] import pandas as pd import sqlite3 # SQLite で DML を実行 conn = sqlite3.connect('mydata.db') df.to_sql('stat_table', conn, if_exists='replace', index=False) # SELECT を pandas で result = pd.read_sql('SELECT * FROM stat_table WHERE 高齢化率 > 30', conn) print(f'{len(result)} 件') print(result[['都道府県', '総人口', '高齢化率']].head()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: WHERE 高齢化率 > 30 に当てはまるのは 47 都道府県中 35 件で、 30% 以下は東京 (22.8%)・沖縄 (23.8%) など 12 都府県しかない。 ORDER BY を付けていないので先頭 5 行は北海道・青森・岩手・秋田・山形と投入順 (地域コード順) のままで、 秋田 39.1% が 4 行目に来る。 高い順に見たいなら ORDER BY 高齢化率 DESC を書く必要がある。
🐍 Python 実装 — pandas + SQLite で DML を体感
① SSDSE-B-2026 を SQLite に投入 (INSERT)
🎯 このコードでやること: SSDSE-B-2026.csv (564 行) を SQLite データベースに投入し、 SQL でクエリ可能な状態にする。 pandas の to_sql は内部で INSERT を実行。
📥 入力データ: SSDSE-B-2026.csv (47 都道府県 × 12 年 = 564 行 × 112 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import sqlite3 # CSV 読み込み (cp932) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 年列の名前を分かりやすく df = df.rename(columns={'SSDSE-B-2026': 'year'}) # SQLite に投入 (INSERT を内部で実行) conn = sqlite3.connect('ssdse.db') df.to_sql('ssdse_b', conn, if_exists='replace', index=False) # 確認 count = pd.read_sql('SELECT COUNT(*) AS n FROM ssdse_b', conn).iloc[0,0] print(f'投入レコード数: {count}') # テーブル構造確認 schema = pd.read_sql('PRAGMA table_info(ssdse_b)', conn) print(f'カラム数: {len(schema)}') print('先頭 5 カラム:', schema['name'].head().tolist()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 47 都道府県 × 12 年 = 564 行が正しく投入。 pandas の to_sql は INSERT 文を 1 行ずつ発行するのではなく、 内部でバルクインサート (executemany) を使い高速。
② SELECT で人口上位 10 都道府県を取得
🎯 このコードでやること: 2023 年の人口上位 10 都道府県を SELECT で取得。 WHERE + ORDER BY + LIMIT の基本パターン。
📥 入力データ: ssdse.db の ssdse_b テーブル (564 行)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import sqlite3 conn = sqlite3.connect('ssdse.db') query = ''' SELECT Prefecture, A1101 AS 人口 FROM ssdse_b WHERE year = 2023 ORDER BY A1101 DESC LIMIT 10; ''' result = pd.read_sql(query, conn) print(result.to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 上位 10 都道府県は東京・神奈川・大阪を含む大都市圏 + 北海道・福岡などの地方中核。 SELECT は DML 中で最も使われる命令で、 全 DML 命令の 95% 以上を占める (実務感覚)。
③ GROUP BY で年代別集計
🎯 このコードでやること: 47 都道府県の合計人口を年代ごとに集計し、 日本の人口推移を確認する。 GROUP BY + SUM の基本パターン。
📥 入力データ: ssdse.db の ssdse_b テーブル
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import sqlite3 conn = sqlite3.connect('ssdse.db') query = ''' SELECT year, SUM(A1101) AS 全国人口合計, AVG(A1101) AS 平均都道府県人口, COUNT(*) AS 都道府県数 FROM ssdse_b GROUP BY year ORDER BY year; ''' result = pd.read_sql(query, conn) print(result.to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 全 47 都道府県を合計すると 2012 年 1 億 2,758 万 9 千人 → 2023 年 1 億 2,435 万 3 千人で、 11 年で約 324 万人 (2.5%) 減った。 AVG は SUM を 47 で割っただけなので、 平均都道府県人口 264 万人は東京 1,409 万人に引っ張られた値で、 中央値 155 万人よりずっと大きい。 GROUP BY は実務で最も使われる DML 構造の 1 つ。 「集計の単位 + 集計関数 (SUM/AVG/COUNT/MAX/MIN)」がセットで覚えるのがコツ。
④ UPDATE と トランザクション
🎯 このコードでやること: 東京都の 2023 年人口を仮に更新する例。 UPDATE 前に SELECT で確認 → BEGIN TRANSACTION → 確認 → COMMIT or ROLLBACK の安全な手順を体験。
📥 入力データ: ssdse.db
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import sqlite3 conn = sqlite3.connect('ssdse.db') cur = conn.cursor() # 1. まず確認 (絶対重要) cur.execute("SELECT A1101 FROM ssdse_b WHERE Prefecture='東京都' AND year=2023") before = cur.fetchone()[0] print(f'更新前: 東京都 2023 年人口 = {before}') # 2. トランザクション開始 cur.execute('BEGIN TRANSACTION') # 3. UPDATE new_value = 14_100_000 # 仮の更新値 cur.execute( "UPDATE ssdse_b SET A1101 = ? WHERE Prefecture='東京都' AND year=2023", (new_value,) ) print(f'影響行数: {cur.rowcount}') # 必ず 1 行のはず # 4. 確認 cur.execute("SELECT A1101 FROM ssdse_b WHERE Prefecture='東京都' AND year=2023") print(f'(トランザクション中) 値 = {cur.fetchone()[0]}') # 5. 元に戻す (実データを壊さないため ROLLBACK) conn.rollback() print('ROLLBACK 実行') cur.execute("SELECT A1101 FROM ssdse_b WHERE Prefecture='東京都' AND year=2023") print(f'最終値: {cur.fetchone()[0]} (元に戻った)') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 影響行数が想定 (1) と一致することを確認してから COMMIT、 違えば ROLLBACK。 この「BEGIN → 確認 → COMMIT/ROLLBACK」の儀式が本番運用での事故防止に必須。 UPDATE WHERE 条件ミスで全行更新する事故は実務で頻発。
⑤ JOIN で複数テーブル連結
🎯 このコードでやること: SSDSE-B-2026 と都道府県マスタを JOIN して、 地方区分 (東北、 関東、 ...) 別に人口を集計する。 INNER JOIN の典型例。
📥 入力データ: ssdse.db + 自作の都道府県地方マスタ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | import pandas as pd import sqlite3 conn = sqlite3.connect('ssdse.db') # 都道府県と地方 (8 区分) の対応表を 47 都道府県ぶん作成 regions = { '北海道': ['北海道'], '東北': ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'], '関東': ['茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県'], '中部': ['新潟県', '富山県', '石川県', '福井県', '山梨県', '長野県', '岐阜県', '静岡県', '愛知県'], '近畿': ['三重県', '滋賀県', '京都府', '大阪府', '兵庫県', '奈良県', '和歌山県'], '中国': ['鳥取県', '島根県', '岡山県', '広島県', '山口県'], '四国': ['徳島県', '香川県', '愛媛県', '高知県'], '九州・沖縄': ['福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県', '沖縄県'], } region_map = pd.DataFrame([{'Prefecture': p, 'Region': r} for r, prefs in regions.items() for p in prefs]) print(f'対応表: {len(region_map)} 都道府県') region_map.to_sql('prefecture_region', conn, if_exists='replace', index=False) # JOIN query = ''' SELECT r.Region AS 地方, COUNT(*) AS 県数, SUM(s.A1101) AS 人口合計 FROM ssdse_b s INNER JOIN prefecture_region r ON s.Prefecture = r.Prefecture WHERE s.year = 2023 GROUP BY r.Region ORDER BY 人口合計 DESC; ''' result = pd.read_sql(query, conn) print(result.to_string(index=False)) print(f'合計: {result["人口合計"].sum()}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 8 地方の人口合計を足すと 1 億 2,435 万 3 千人で、 2023 年の 47 都道府県の合計と一致するので、 対応表に漏れも重複もない。 関東 7 都県だけで 4,352 万 7 千人と全国の 35% を占め、 最少の四国 4 県 (357 万 8 千人) の 12 倍になる。 INNER JOIN は両テーブルにある行だけを残すので、 対応表から県が 1 つ抜けているとその県の人口は黙って合計から消える。 合計が全国値と合うかを必ず確かめる。
🔒 トランザクションと ACID
DML を本番運用するうえで欠かせないのが トランザクションと ACID 特性。 数式を言葉で読み解くと、 これは「データベース操作の安全保証ルール」です。
| 特性 | 意味 | 例 |
|---|---|---|
| Atomicity (原子性) | 全て成功か全て失敗 | 銀行送金: 引き出し成功・入金失敗は許されない |
| Consistency (一貫性) | 整合性ルールを常に満たす | 合計残高がトランザクション前後で同じ |
| Isolation (分離性) | 並行実行でも独立 | 2 人同時に更新しても結果は順次実行と同じ |
| Durability (永続性) | コミット後は障害でも残る | 停電してもデータが消えない |
SQL の BEGIN; ...; COMMIT; でトランザクション。 失敗したら ROLLBACK;。 PostgreSQL や Oracle は ACID を厳密に守るが、 NoSQL では緩い (BASE 原則) ことが多い。
🔐 分離レベル (Isolation Level)
並行トランザクションでどの程度厳密に独立を保つか。 厳しいほど安全だが遅い。
| レベル | 許される現象 | 使い所 |
|---|---|---|
| READ UNCOMMITTED | Dirty Read, Non-repeatable, Phantom | ほぼ使わない |
| READ COMMITTED | Non-repeatable, Phantom | PostgreSQL デフォルト |
| REPEATABLE READ | Phantom のみ | MySQL デフォルト |
| SERIALIZABLE | なし (最も厳密) | 金融など高信頼が必要な場面 |
SSDSE のような分析用途では READ COMMITTED で十分。 在庫管理や金融はより厳格な REPEATABLE READ や SERIALIZABLE が必要。
🔓 ロックの種類
| 種類 | 取得契機 | 影響 |
|---|---|---|
| 共有ロック (S) | SELECT (一部 DBMS) | 他者の SELECT は OK、 UPDATE 不可 |
| 排他ロック (X) | UPDATE, DELETE, INSERT | 他者は何もできない |
| 行ロック | WHERE で 1 行特定 | 他行は無影響 |
| テーブルロック | ALTER TABLE 等 | テーブル全体停止 |
| デッドロック | 循環的ロック | DBMS が片方を強制終了 |
ロック競合は実務で頻発するパフォーマンス問題。 「短いトランザクション」「同じ順序で複数行ロック」が回避のコツ。
🚨 SQL インジェクション — 必ず防ぐ
DML を実行するアプリで最も多い脆弱性が SQL インジェクション。 ユーザー入力を文字列連結で SQL に埋め込むと、 攻撃者に任意の SQL を実行されます。
Python の sqlite3, psycopg2, mysql.connector はすべてプレースホルダ対応。 ? や %s で書き、 値は別引数で渡す。 ORM (SQLAlchemy 等) を使えば自動的に安全。
🐍 追加 Python 実装
⑥ DELETE のサンプル (BEGIN/ROLLBACK で安全に)
🎯 このコードでやること: 2012 年のレコード (47 件) を DELETE する例を、 必ず ROLLBACK して実データを保護しながら体験する。 影響行数の確認が安全運用の鍵。
📥 入力データ: ssdse.db (564 行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import sqlite3 conn = sqlite3.connect('ssdse.db') cur = conn.cursor() # 削除前の件数確認 cur.execute('SELECT COUNT(*) FROM ssdse_b') before = cur.fetchone()[0] print(f'削除前: {before} 行') # トランザクション開始 cur.execute('BEGIN') # DELETE cur.execute('DELETE FROM ssdse_b WHERE year = 2012') print(f'影響行数: {cur.rowcount}') # 削除後の件数 cur.execute('SELECT COUNT(*) FROM ssdse_b') print(f'(トランザクション中) {cur.fetchone()[0]} 行') # 実データを壊さないため ROLLBACK conn.rollback() print('ROLLBACK 実行') # 元に戻ったか確認 cur.execute('SELECT COUNT(*) FROM ssdse_b') print(f'最終: {cur.fetchone()[0]} 行 (元通り)') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 影響行数が想定 (47 = 都道府県数 × 1 年) と一致することを確認。 もし 517 とか想定外なら ROLLBACK で守る。 これが本番運用の鉄則。
⑦ Window 関数で前年比を計算
🎯 このコードでやること: 各都道府県の人口について、 LAG 関数で前年の値を取得し、 増減率を計算する。 SQL の Window 関数はピボットなしで時系列比較ができる強力機能。
📥 入力データ: ssdse.db
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import sqlite3 conn = sqlite3.connect('ssdse.db') query = ''' SELECT Prefecture, year, A1101 AS pop, LAG(A1101) OVER (PARTITION BY Prefecture ORDER BY year) AS prev_pop, A1101 - LAG(A1101) OVER (PARTITION BY Prefecture ORDER BY year) AS diff FROM ssdse_b WHERE Prefecture IN ('東京都', '鳥取県', '沖縄県') ORDER BY Prefecture, year; ''' result = pd.read_sql(query, conn) print(result.to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 2012→2023 年で東京は 1,323 万 4 千人 → 1,408 万 6 千人と約 85 万人増、 鳥取は 58 万 3 千人 → 53 万 7 千人と約 4 万 6 千人減、 沖縄は約 5 万 7 千人増だが 2022・2023 年の diff は 0 で増加が止まっている。 東京も 2021 年だけ −37,594 と減っている。 各県の初年度 2012 は前の行が無いので prev_pop・diff が NaN になり、 PARTITION BY があるので沖縄の 2012 年が東京の 2023 年と比べられることはない。
🐍 追加 Python — 47 都道府県の人口ランキング
⑧ Window 関数で順位付け
🎯 このコードでやること: 2023 年の 47 都道府県人口に ROW_NUMBER と RANK でランキングを付け、 同順位の有無を確認する。 数式を言葉で読み解くと「順序統計量を SQL で計算」する例。
📥 入力データ: ssdse.db (47 件 × 2023 年)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import sqlite3 conn = sqlite3.connect('ssdse.db') query = ''' SELECT Prefecture, A1101 AS 人口, ROW_NUMBER() OVER (ORDER BY A1101 DESC) AS 行番号, RANK() OVER (ORDER BY A1101 DESC) AS 順位, DENSE_RANK() OVER (ORDER BY A1101 DESC) AS 密順位, NTILE(4) OVER (ORDER BY A1101) AS 四分位 FROM ssdse_b WHERE year = 2023 ORDER BY A1101 DESC LIMIT 10; ''' result = pd.read_sql(query, conn) print(result.to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 47 都道府県の人口は全て異なるので、 ROW_NUMBER / RANK / DENSE_RANK が一致。 四分位 (NTILE(4)) は 47 行を 12・12・12・11 行に分け、 ORDER BY A1101 の昇順で数えるので最後の Q4 は 11 行で、 人口上位 11 都道府県 (11 位は茨城県) が Q4 になる。 Window 関数は SQL:2003 で標準化された比較的新しい機能だが、 現代分析には必須。
⑨ UPSERT パターン (INSERT or UPDATE)
🎯 このコードでやること: 「都道府県データが既存ならUPDATE、 なければINSERT」という UPSERT 操作を SQLite で実装する。 実務でよく使われるパターン。
📥 入力データ: 新規追加したい都道府県データのサンプル
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import sqlite3 conn = sqlite3.connect('ssdse.db') cur = conn.cursor() # 仮想的な「県人口集計」テーブルを作成 (主キー: Prefecture) cur.execute(''' CREATE TABLE IF NOT EXISTS pref_summary ( Prefecture TEXT PRIMARY KEY, total_pop INTEGER, updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP ) ''') # UPSERT (SQLite 3.24+ 構文) data = [ ('東京都', 14086000), ('鳥取県', 537000), ('沖縄県', 1468000), ] cur.executemany(''' INSERT INTO pref_summary (Prefecture, total_pop) VALUES (?, ?) ON CONFLICT(Prefecture) DO UPDATE SET total_pop = excluded.total_pop, updated_at = CURRENT_TIMESTAMP ''', data) conn.commit() # 確認 cur.execute('SELECT * FROM pref_summary') for row in cur.fetchall(): print(row) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: UPSERT は「データの取り込みを冪等にする」便利パターン。 同じデータを何度実行しても結果が同じになるので、 ETL バッチで多用される。 PostgreSQL は ON CONFLICT、 MySQL は ON DUPLICATE KEY UPDATE。
⚠️ よくある落とし穴
UPDATE 表 SET 列 = 値 だけだと全行が書き換わる。 本番では BEGIN; UPDATE …; -- 確認 ROLLBACK; or COMMIT; の儀式を。LIKE '%abc%' は両端ワイルドカードで遅い。 インデックスが効かない。= NULL は常に偽。 必ず IS NULL を使う。WHERE 文字列カラム = 123 のような比較は予期せぬ結果を生む。⚠️ WHERE 句の落とし穴
| 状況 | NG 例 | 正しい書き方 |
|---|---|---|
| NULL 比較 | WHERE x = NULL | WHERE x IS NULL |
| 大小文字 | WHERE name = 'Tokyo' | WHERE LOWER(name) = 'tokyo' |
| 暗黙の型変換 | WHERE id = '123' (id が int) | WHERE id = 123 |
| 否定の NOT IN | NULL を含むサブクエリで予期せぬ結果 | NOT EXISTS に書き換え |
| LIKE のワイルドカード | LIKE '%abc%' (両端) でインデックス無効 | 全文検索エンジン (FTS) 検討 |
| 関数適用 | WHERE YEAR(date) = 2023 | WHERE date BETWEEN '2023-01-01' AND '2023-12-31' |
⚡ DML パフォーマンス・チューニング
- インデックス: WHERE / JOIN / ORDER BY 列に作成。 検索が 100〜10000 倍速くなる
- EXPLAIN: クエリ実行計画を確認 (PostgreSQL:
EXPLAIN ANALYZE) - カバリング・インデックス: SELECT する列もインデックスに含めて、 テーブル参照不要に
- JOIN 順序: 小さいテーブルから JOIN すると速い
- サブクエリより JOIN: 一般に JOIN の方が高速
- UNION ALL: 重複排除不要なら UNION より速い
- パーティション: 大きなテーブルを年度等で物理分割
- マテリアライズドビュー: 集計結果を保存して再計算回避
- バルク挿入: 1 行ずつ INSERT より
INSERT INTO ... VALUES (...), (...), ... - VACUUM: PostgreSQL/SQLite で不要領域を回収
📇 インデックスの種類
| 種類 | 仕組み | 用途 |
|---|---|---|
| B-Tree (バランス木) | 標準的なソート済み木 | 等価・範囲検索の万能型 |
| Hash | ハッシュ値で位置特定 | 等価検索のみ、 範囲不可 |
| GIN (Generalized Inverted) | 転置インデックス | 全文検索、 JSONB |
| GIST | 幾何データ向け | 地理座標、 範囲型 |
| BRIN (Block Range) | ブロックレベル | 巨大時系列データ |
| 部分インデックス | WHERE 条件付き | 使う部分だけ |
| 関数インデックス | 関数結果にインデックス | LOWER(name) 等 |
| 複合インデックス | 複数列でソート | WHERE で複数条件 |
🏢 主要 RDBMS 比較
| DBMS | 長所 | 短所 | 用途 |
|---|---|---|---|
| SQLite | ファイル 1 個、 設定不要 | 同時書き込み弱い | 個人開発、 教育 |
| PostgreSQL | 機能豊富、 SQL 標準準拠 | 設定やや複雑 | 本格運用、 分析 |
| MySQL | 速い、 Web で定番 | SQL 標準準拠ゆるい | Web アプリ |
| MariaDB | MySQL 互換、 オープン | 同上 | MySQL 代替 |
| Oracle | エンタープライズ機能 | 高額 | 大企業 |
| SQL Server | Windows 統合 | 非 Windows で不便 | Microsoft 系 |
| DuckDB | 分析特化、 高速 | OLTP 不向き | データ分析 |
| BigQuery | クラウド、 ペタバイト級 | 有料、 ベンダーロック | 大規模分析 |
| Snowflake | マルチクラウド DWH | 有料 | 企業分析基盤 |
| Redshift | AWS 統合、 DWH | 運用コスト | AWS ユーザー |
🪟 Window 関数 — 現代 DML の核心
「グループごとに集計しつつ、 行も個別に保持したい」というニーズに応えるのが Window 関数。 SQL:2003 以降標準。
| 関数 | 用途 | 例 |
|---|---|---|
| ROW_NUMBER() | 連番 | 都道府県人口ランキング |
| RANK() | 同順位許容ランク | 同人口は同順位、 次は飛ぶ |
| DENSE_RANK() | 同順位許容、 連続 | 同上だが順位は連続 |
| LAG(x, n) | n 行前の値 | 前年比計算 |
| LEAD(x, n) | n 行後の値 | 次年予測 |
| SUM() OVER (...) | 累積和 | 累積人口 |
| AVG() OVER (...) | 移動平均 | 5 年移動平均 |
| NTILE(n) | n 分割 | 四分位 |
例: 「都道府県別の前年比人口増減」:
⚠️ DML 落とし穴コレクション
- WHERE 忘れ: UPDATE/DELETE で全行に影響 → BEGIN; ... ROLLBACK; の儀式必須
- NULL 比較:
= NULLではなくIS NULL - 暗黙の型変換: 文字列と数値の混在
- 日付フォーマット: ISO 8601 (
YYYY-MM-DD) で統一 - 大文字小文字: SQL キーワードは大文字、 識別子は環境依存
- 予約語の識別子:
"order"や"user"はクォート必須 - LIKE のワイルドカード:
%は 0 文字以上、_は 1 文字 - カラム順序:
INSERT INTO t VALUES (...)で列順依存 - 自動コミット: ライブラリにより設定が違う
- 文字エンコーディング: DB と接続両方の設定が必要
- タイムゾーン: UTC で統一、 表示時のみ JST 変換
- カスケード削除: 外部キーで連鎖削除に注意
🔄 ORM — Python から DML を扱う高レベル方法
| ORM | 特徴 | 用途 |
|---|---|---|
| SQLAlchemy | Python 標準、 柔軟 | 幅広く |
| Django ORM | Django 統合 | Web アプリ |
| Peewee | 軽量 | 小規模 |
| SQLModel | FastAPI 統合、 型ヒント | モダン API |
| Tortoise ORM | 非同期対応 | async/await |
| raw SQL | ORM 不使用 | パフォーマンス重視 |
ORM は SQL を書かなくて済むが、 N+1 問題 (1 件取得ごとに 1 クエリ発行) などの落とし穴あり。 SSDSE 程度の分析なら pandas + raw SQL の方が直感的。
🐼 pandas vs SQL — どちらを使うか
| 操作 | pandas | SQL |
|---|---|---|
| SELECT | df[['col1', 'col2']] | SELECT col1, col2 FROM t |
| WHERE | df[df.x > 100] | WHERE x > 100 |
| ORDER BY | df.sort_values('x') | ORDER BY x |
| GROUP BY | df.groupby('y').sum() | GROUP BY y |
| JOIN | pd.merge(df1, df2, on='id') | JOIN ON id |
| UPDATE | df.loc[df.x==1, 'y'] = 2 | UPDATE t SET y=2 WHERE x=1 |
| INSERT | df.append(new_row) | INSERT INTO t VALUES |
| DELETE | df.drop(idx) | DELETE FROM t WHERE |
使い分け: メモリに収まる (< 数 GB) なら pandas、 大規模なら SQL。 SSDSE-B-2026 (564 行) は完全に pandas 範囲。
⚠️ 条件・限界・誤解回避(DML: データ操作言語)
DML (Data Manipulation Language) は SELECT/INSERT/UPDATE/DELETE/MERGE など、 リレーショナル DB のデータ自体を操作する SQL のサブセットです。 強力で生産性が高い反面、 トランザクション管理・性能設計・データ整合性の理解が不十分だと「数百万行を誤って更新」「本番環境のロックで業務停止」といった致命的事故を起こします。 SSDSE-B-2026 を題材に、 適用条件・限界・典型的な誤解を整理します。
適用条件
- スキーマと制約の理解: DML は DDL で定義された型・制約 (NOT NULL, UNIQUE, FOREIGN KEY, CHECK) を遵守する形でしか操作できません。 SSDSE-B-2026 を都道府県マスタと結合するなら、 prefecture_code を主キーに正規化して FOREIGN KEY を張るのが王道。 制約に違反する INSERT/UPDATE は失敗し、 トランザクション全体がロールバックされます。
- トランザクション境界の明示: 複数行を更新するときは
BEGIN; ... COMMIT;で境界を明示。 暗黙コミット (autocommit) のままだと、 途中で失敗しても部分反映されて整合性が壊れます。 ACID 特性 (Atomicity, Consistency, Isolation, Durability) を意識した運用が前提です。 - WHERE 句の必須性:
UPDATE/DELETEは WHERE を省略すると全行が対象になります。 SSDSE のように 47 行しかないテーブルでも、 本番では数億行になることを想定し、 必ずWHERE+LIMIT+ 事前 SELECT 確認の三点セットを徹底。 - 適切なインデックス: WHERE 列・JOIN 列にインデックスがないとフルテーブルスキャンになり、 ロック範囲も広がります。
EXPLAIN ANALYZEで実行計画を確認し、 想定通りにインデックスが使われているかを検証。 - 分離レベルの選択:
READ COMMITTED(デフォルト多数)・REPEATABLE READ・SERIALIZABLEの違いを理解し、 業務要件に合わせて設定。 SSDSE のような分析専用 DB なら READ COMMITTED で十分ですが、 在庫・金融なら SERIALIZABLE 相当が必要なことも。 - 権限管理 (GRANT/REVOKE): アプリ用ユーザーには SELECT/INSERT/UPDATE/DELETE のみ付与し、 DDL や TRUNCATE は禁止。 分析者には読み取り専用ユーザーを用意して本番改変を防ぐ。
限界
- 大量更新のロックと性能: 1 トランザクションで数千万行を UPDATE するとロックエスカレーション・WAL 肥大・レプリカ遅延を引き起こします。 バッチ更新は
LIMIT 10000単位で分割し、 適度にコミットするのが定石。 - RDBMS 方言の違い: 標準 SQL を中心にしても、 PostgreSQL の
RETURNING、 MySQL のINSERT ... ON DUPLICATE KEY UPDATE、 SQL Server のMERGE、 BigQuery のMERGE INTOなど差異があります。 移植性を考えるなら共通部分にとどめる工夫が必要。 - NULL 比較の罠:
WHERE x = NULLは常に NULL (=偽) になり、 期待した行が返りません。WHERE x IS NULLを使う必要があります。 集計関数も NULL の扱いが異なる (COUNT(*) vs COUNT(col))。 - 監査・履歴の欠如: DML は「現状」を更新するだけで、 過去の状態を保存しません。 監査要件があるなら、 トリガで履歴テーブルにコピーする・CDC (Change Data Capture) を導入する・SCD type 2 で設計する等の対策が必要。
- 並行更新の競合: 同時に複数セッションが同じ行を更新するとデッドロックが発生。 アプリ側でリトライ機構を実装し、 再試行可能なトランザクション設計にする。
誤解回避
- 「TRUNCATE は DELETE の高速版」は誤り: TRUNCATE は DDL に分類され、 ロールバックできない実装が多く、 トリガが発火しません。 監査要件のある環境では使えない場合があります。
- 「DELETE すれば容量が空く」は誤り: PostgreSQL は DELETE 直後は物理空間を解放せず、 VACUUM (またはオートバキューム) が必要です。 InnoDB も同様で OPTIMIZE TABLE が要ります。
- 「サブクエリより JOIN が常に速い」は誤り: 最近のオプティマイザはサブクエリを JOIN に書き換えます。 むしろ
EXISTSやINの方が意図が明確で読みやすいケースが多い。 - 「ORDER BY を入れれば順序が保証される」は誤り:
INSERT INTO ... SELECT ... ORDER BYは宛先テーブルの並び順を保証しません。 ORDER BY は SELECT 結果の順序付けにのみ有効。 - 「インデックスを増やせば速くなる」は誤り: SELECT は速くなりますが、 INSERT/UPDATE/DELETE は遅くなります。 書き込み頻度の高いテーブルではインデックスを最小限に。
- 「LIMIT で安全」は誤り:
UPDATE ... LIMIT 100は対象がランダム抽出される可能性があり、 確定性がありません。 ORDER BY と組み合わせ、 主キーを基準に処理する。
典型ワークフロー
- 要件整理: SSDSE-B-2026 を題材に「東京を除く 46 道府県で 65 歳以上人口を集計」のような要件を SQL に落とす前に、 自然言語で書き出す。
- SELECT で結果確認:
SELECT prefecture, elderly_pop FROM ssdse WHERE prefecture <> '東京';で結果セットを確認。 想定行数・想定値域を目視。 - トランザクション開始:
BEGIN;でトランザクション開始。 - 更新実行:
UPDATE ssdse SET flagged = TRUE WHERE prefecture <> '東京' AND elderly_pop > 1000000;。 影響行数をEXPLAINや RETURNING で確認。 - 検証:
SELECT COUNT(*) FROM ssdse WHERE flagged = TRUE;で期待数と一致するかチェック。 - コミットまたはロールバック: 期待通りなら
COMMIT;、 想定外ならROLLBACK;。 - 監査ログ確認: pg_stat_statements / slow query log / 履歴テーブルで実行履歴を残す。
- 性能分析:
EXPLAIN (ANALYZE, BUFFERS)で実行計画とコストを確認し、 必要ならインデックス追加。
ケーススタディ
- 事例1: SSDSE-B-2026 を分析用 DM に取り込む — CSV を staging テーブルに INSERT し、 マスタと JOIN して正規化された fact テーブルに MERGE。 トランザクションで包み、 失敗時は ROLLBACK。 ロード後に
VACUUM ANALYZEで統計情報を更新。 - 事例2: 大量バッチ UPDATE のチャンク化 — 1 億行を一度に UPDATE せず、 主キーで
WHERE id BETWEEN n AND n+10000のように区切って繰り返す。 各チャンクの後に COMMIT し、 レプリカ遅延を監視。 - 事例3: UPSERT (INSERT ... ON CONFLICT) — PostgreSQL の
INSERT ... ON CONFLICT (id) DO UPDATE SET ...で「あれば更新、なければ挿入」を 1 文で実現。 SSDSE のような毎年の更新スナップショットに最適。 - 事例4: ソフトデリート設計 — 物理 DELETE せず
UPDATE deleted_at = NOW()で論理削除。 監査・復元・参照整合性に強く、 多くの業務システムで採用される。 - 事例5: CDC (Change Data Capture) — Debezium で WAL を読み、 DML イベントを Kafka に流す。 DWH やデータレイクへリアルタイム同期を実現する典型構成。
DML は「データを動かす最後のキー操作」であると同時に「事故が一番起きる場所」です。 SSDSE-B-2026 のような小規模データで「SELECT で確認 → BEGIN → 更新 → 検証 → COMMIT」の規律を体に叩き込んでから本番に臨みましょう。
運用 Tips: 安全に DML を回すための実務知見
- 本番更新前のドライラン: 更新前に
SELECT ... FOR UPDATE+ ROLLBACK で「影響範囲だけ事前確認」する手法。 PostgreSQL ならEXPLAIN UPDATE ...やBEGIN; UPDATE ...; SELECT * FROM updated_table; ROLLBACK;を組み合わせて、 副作用なしで挙動を観察できます。 - WHERE 句のセーフガード: 重要テーブルの UPDATE/DELETE 文には必ず主キー条件か日付範囲を含め、 単独の
UPDATE t SET col=valは禁止する社内ルールを敷きます。 ORM (Django, SQLAlchemy) でも .all().delete() のような書き方は警告する lint を導入。 - ロック時間の監視:
pg_locks,SHOW PROCESSLIST,v$session_longops等でロック保持時間を監視し、 一定時間を超えたら自動 kill する仕組みを整備。 SSDSE のような分析専用 DB でも、 長時間ロックはレプリケーション遅延の原因。 - 履歴テーブルの設計: 監査要件があるなら、 トリガで
INSERT INTO history (op, old_row, new_row, updated_by, updated_at)を発火させ、 BEFORE/AFTER 値を残します。 GDPR の権利行使対応にも有効。 - テスト DB と本番 DB の差分管理: スキーマ移行ツール (Flyway, Alembic, Liquibase) で DDL/DML マイグレーションを版管理。 SSDSE-B-2026 の取り込みスクリプトも、 idempotent (何度実行しても同じ結果) になるよう
ON CONFLICTで書く。 - ベンチマークと負荷試験: pgbench, sysbench, JMeter で典型クエリの TPS を計測し、 SLO (例: 99 パーセンタイル 200ms 以内) を設定。 本番デプロイ前にステージング環境で同等負荷をかける。
初学者がよく踏むトラップ集
DML を学び始めた人がよく踏む地雷を 8 つに整理しておきます。 1) WHERE を忘れた全行更新、 2) NULL = NULL の落とし穴、 3) サブクエリの相関エラー、 4) 結合キー間違いによるデカルト積、 5) 文字列リテラルとカラム名の混同 (シングル/ダブルクォート)、 6) DATE と TIMESTAMP の暗黙キャスト、 7) ORDER BY なしの LIMIT による不確定な結果、 8) UPDATE 直後の COMMIT 忘れ。 SSDSE-B-2026 のような小規模データで実験して全部踏んだ後、 本番に挑むのが理想です。
DML と現代データスタックの接続
伝統的 RDBMS の DML は今でも分析・運用の土台ですが、 現代では DWH (Snowflake, BigQuery, Redshift)、 データレイクハウス (Databricks, Iceberg)、 ストリーミング (Kafka, Flink) と組み合わせて使うことが増えています。 SSDSE-B-2026 を題材に置いてみると、 「DML で staging → MERGE で dim/fact 更新 → dbt model で集計 → BI で可視化」というパイプラインが現代的な形です。 dbt は SQL ベースの DML を Jinja テンプレートで再利用しやすくし、 incremental model で大量更新を効率化します。 一方ストリーミング DML では、 Kafka Connect + Debezium で OLTP の WAL を CDC として配信し、 DWH 側で MERGE INTO を実行する構成が標準化しつつあります。 こうした流れの中でも、 トランザクション境界・WHERE 句の確認・履歴管理という DML の基本規律は変わりません。
📋 DML を安全に運用するための前提条件と限界 (誤解回避)
DML (Data Manipulation Language: INSERT/UPDATE/DELETE/MERGE) は強力だが、 1 つの WHERE 句のミスで全行が壊れる。 SSDSE-B-2026 で実験する場合も、 本番運用と同じ規律で扱う必要がある。
前提 1: トランザクション境界が明確
DML は BEGIN; ... COMMIT; (または ROLLBACK) で囲み、 全体を 1 つの原子的な単位として扱う。 COMMIT を忘れたまま接続が切れると、 セッション末で自動 ROLLBACK して変更が消える。 SSDSE-B のような小データでも、 まず BEGIN + 確認 SELECT + COMMIT の習慣をつける。
前提 2: WHERE 句は SELECT で必ず先に確認
UPDATE prefecture SET population=0 WHERE region='北海道' の前に、 必ず SELECT * FROM prefecture WHERE region='北海道' で対象行を目視する。 「north hokkaido」のようなタイポで対象が 0 件、 または逆に WHERE を抜いて全 47 県が更新される事故を防ぐ。
前提 3: 履歴 (audit log) の保持
UPDATE/DELETE は元の値を破壊する。 監査可能性のため、 ① 別テーブルへ前値を INSERT、 ② temporal table (時間軸付きテーブル)、 ③ CDC (Change Data Capture) のいずれかを併用するのが理想。 SSDSE-B の年次データなら、 year 列を追加して上書きせず追記する設計が最も簡単。
限界 1: 大量更新はロックと WAL を爆発させる
UPDATE 1000万行 SET ... は WAL (Write-Ahead Log) を膨張させ、 ロック待ちで他クエリが詰まる。 chunked UPDATE (LIMIT 10000 × 1000 回) または INSERT INTO new_table SELECT ... ; RENAME のスワップ戦略に切り替える。
限界 2: ORDER BY なしの LIMIT は不定
DELETE FROM tbl WHERE ... LIMIT 100 でどの 100 行が削除されるかは、 ORDER BY なしでは DB 実装依存。 PostgreSQL/MySQL でも結果が再現しない。 必ず ORDER BY id LIMIT 100 のように決定的に書く。
📝 理解度チェック (5 問 / SSDSE-B-2026 を想定)
- Q1.
UPDATE prefecture SET region='関東' WHERE prefecture_code IN ('13','11','12','14')を実行する前に必ず行うべき確認手順を 3 ステップで記述せよ。 - Q2. 47 都道府県のうち、 同じ name で 2 行ある (重複登録) ことが判明した。 重複を削除しつつ ID の小さい方を残す DML 文を 1 文で書け。
- Q3. 1000 万行のテーブルで
UPDATEをすると数時間かかる。 1) chunked UPDATE と 2) スワップ戦略の長所と短所を比較せよ。 - Q4.
MERGE INTO文が「DWH ではよく使われるが、 OLTP では使われない」と言われる理由を 2 行で述べよ。 - Q5. SSDSE-B のような少量データで DML を学ぶときに、 本番運用に活きる規律 (チェックリスト) を 5 項目挙げよ。
解答方針
- A1. ①
BEGINでトランザクション開始、 ②SELECT prefecture_code, region FROM prefecture WHERE prefecture_code IN (...)で対象行を目視、 ③ 想定行数と一致したらUPDATE実行 →SELECTで再確認 →COMMIT。 - A2.
DELETE FROM prefecture WHERE id NOT IN (SELECT MIN(id) FROM prefecture GROUP BY name)。 ただし MySQL では同テーブル参照に制限あり、 一時テーブル経由が必要。 - A3. chunked UPDATE は安全だがオンライン中も書き込み発生。 スワップは並列構築で速いが、 トリガ・外部キー・参照クエリの整合性管理が必要。
- A4. MERGE は冪等な「upsert」処理に最適だが、 同時並行性が高い OLTP では行ロックが取られすぎて性能劣化する。 OLTP は INSERT ON CONFLICT などの単純文が好まれる。
- A5. ① BEGIN/COMMIT を必ず使う、 ② SELECT で WHERE を事前確認、 ③ 件数を想定値と比較、 ④ 履歴を残す (timestamp 列 or audit table)、 ⑤ ステージング → 本番の段階的適用。
📊 数式に値を入れて手で計算する — DML 行数変化と高齢化率の計算
DML は数学的には集合演算。 INSERT は集合の和 $R \leftarrow R \cup \{t\}$、 DELETE は差 $R \leftarrow R \setminus \sigma_p R$。 一連の DML 操作後のテーブル行数 $n$ は:
UPDATE は行数を変えない($\Delta = 0$)。 INSERT は $\Delta > 0$、 DELETE は $\Delta > 0$(引く方向)。
Step 1: 各 DML オペレーションの行数変化
| 操作 | $\Delta$ (行数変化) | 残行数 $n$ |
|---|---|---|
| 初期状態 (SSDSE-B 2023 年分) | — | 47 |
| INSERT 5 行 (新規データ追加) | +5 | 52 |
| UPDATE WHERE pop > 5000000 (9 行対象) | 0 (件数不変) | 52 |
| DELETE WHERE pop < 660000 (2 行対象: 鳥取 537,000 人・島根 650,000 人) | −2 | 50 |
| INSERT 3 行 (補完データ) | +3 | 53 |
Step 2: 式に値を代入
Step 3: さらに高齢化率 (aging_rate = 65 歳以上人口 / 総人口) を UPDATE で計算
SSDSE-B には面積の列が無いので、 収録されている 65 歳以上人口 A1303 を使う。 東京都 (2023 年) の高齢化率: $\text{aging\_rate} = \dfrac{A1303 \times 100}{A1101} = \dfrac{3{,}205{,}000 \times 100}{14{,}086{,}000} \approx 22.75 \ \%$
🐍 Python で Step 2・Step 3 を再現
このコードでやること: 手計算 Step 2 (行数変化の式) と Step 3 (東京都の高齢化率) を Python で検証し、 UPDATE・DELETE の対象件数と東京都の値を SSDSE-B-2026 の CSV でも確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd # Step 2: 行数変化の式 n_final = n0 + Σ(INSERT) - Σ(DELETE) n0 = 47 # SSDSE-B-2026 の 2023 年分 ins1, ins2 = 5, 3 # INSERT x2 del1 = 2 # DELETE (pop < 660000 → 鳥取県・島根県) n_final = n0 + ins1 + ins2 - del1 print(f"最終行数: {n0} + {ins1} + {ins2} - {del1} = {n_final} 行") # Step 3: 東京都の高齢化率 aging_rate = A1303 * 100 / A1101 tokyo_65 = 3205000 # A1303 (65 歳以上人口・人, 2023 年) tokyo_pop = 14086000 # A1101 (総人口・人, 2023 年) aging_rate = tokyo_65 * 100 / tokyo_pop print(f"東京都 高齢化率: {aging_rate:.2f} %") # 実データ (SSDSE-B-2026) で DELETE の対象件数と東京都の値を確かめる df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] print("UPDATE 対象 (pop > 5000000):", (d['A1101'] > 5000000).sum(), "行") print("DELETE 対象 (pop < 660000):", d.loc[d['A1101'] < 660000, 'Prefecture'].tolist()) t = d[d['Prefecture'] == '東京都'].iloc[0] print(f"CSV から: {t['A1303']} * 100 / {t['A1101']} = {t['A1303'] * 100 / t['A1101']:.2f} %") |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 手計算 (Step 2) の 53 行と Python 出力が完全一致。 東京都の高齢化率 22.75% も Step 3 の手計算 ($3205000 \times 100 / 14086000 \approx 22.75$) と、 CSV から読んだ値の両方で一致。 CSV で数えると UPDATE の対象 (500 万人超) は 9 行、 DELETE の対象 (66 万人未満) は鳥取・島根の 2 行で、 Step 1 の表の件数と合う。 UPDATE の 9 行は値が変わるだけで行数は 52 のまま、 という関係代数の原則が式の上でも効いている。
🗺 DML 概念マップ
図: DML の全体像。 中心の DML (SELECT/INSERT/UPDATE/DELETE) を軸に、 SQL 分類 (DDL/DCL/TCL)、 安全運用 (ACID/トランザクション)、 パフォーマンス (インデックス/EXPLAIN)、 周辺技術 (ORM/クラウド DB) との関係を示す。
✅ DML 実プロジェクト最終チェックリスト
- ☐ UPDATE/DELETE 前に SELECT で対象行を確認した
- ☐ トランザクション内で BEGIN; ROLLBACK; テストした
- ☐ プレースホルダ (
?や%s) を使った (文字列連結禁止) - ☐ SELECT * ではなく必要列を明示した
- ☐ JOIN 句を ON で書いた (WHERE で書かない)
- ☐ WHERE 句で関数を使っていない (インデックス無効化回避)
- ☐ EXPLAIN ANALYZE で実行計画を確認した
- ☐ 適切なインデックスを設定した
- ☐ NULL は IS NULL で比較した
- ☐ 数千行以上の INSERT はバルク化した
- ☐ クライアント側のタイムアウトを設定した
- ☐ コネクションプールを適切に設定した
- ☐ バックアップとリストアの手順を確認した
- ☐ 監査ログを有効化した
- ☐ ステージング環境で十分にテストした
- ☐ デプロイ手順とロールバック手順を文書化した
- ☐ 二人以上でレビューした
⚖ DML と他のデータ処理技術の比較
| 技術 | 用途 | DML との関係 |
|---|---|---|
| DML (SQL) | 構造化データ操作 | 中心技術 |
| NoSQL (MongoDB 等) | 半構造化データ | 独自クエリ言語、 SQL ライクに収束中 |
| MapReduce | 大規模分散処理 | Hive SQL 等で SQL 化された |
| Spark SQL | 分散 SQL エンジン | DML 互換 |
| pandas | Python データ操作 | DML 相当の機能を Python で |
| R / dplyr | R データ操作 | SQL ライクなパイプ構文 |
| Excel/Sheets | 表計算 | GUI 版の DML |
| BI ツール | 可視化 | 裏で DML を生成 |
| Stream Processing (Kafka Streams) | リアルタイム | KSQL という SQL ライク言語 |
| GraphQL | API クエリ | 裏で DML を生成 |
「データ操作」の本質は DML が捉えており、 新しい技術もすべて SQL ライクな構文に収束しています。
📊 SSDSE-B-2026 を SQL で分析した代表的な統計
| クエリ | 結果 |
|---|---|
| 2023 年全国人口合計 | 124,352,000 人 |
| 2023 年都道府県平均人口 | 2,645,808 人 |
| 2023 年人口中央値 | 1,549,000 人 (鹿児島県) |
| 2023 年最大人口 | 14,086,000 人 (東京都) |
| 2023 年最小人口 | 537,000 人 (鳥取県) |
| 最大/最小比 | 26.2 倍 |
| 2012 → 2023 全国人口変化 | 約 -324 万人 (-2.5%) |
| 2012 → 2023 増加県数 | 東京都・沖縄県・神奈川県・愛知県・埼玉県・千葉県・福岡県・滋賀県 (8 都道府県) |
| 2012 → 2023 減少県数 | 39 都道府県 |
| 500 万以上県の数 (2023) | 8 県 (東京〜福岡) |
| 100 万未満県の数 (2023) | 10 県 (鳥取〜香川) |
これらの数値はすべて SSDSE-B-2026 を SQL で集計したもの。 都道府県間の格差や人口減少の進行が一目で分かります。 統計データ解析コンペで活用可能。
⚡ DML クイックリファレンス
| 状況 | 使うべき DML |
|---|---|
| 既存データを読みたい | SELECT |
| 新しいデータを追加 | INSERT |
| 既存データを変更 | UPDATE (WHERE 必須) |
| 不要データを削除 | DELETE (WHERE 必須) |
| 大量データを取り込みたい | INSERT バルク or COPY |
| 「あれば更新、 なければ追加」 | UPSERT (ON CONFLICT) |
| 複数表を組み合わせる | JOIN |
| 集計したい | GROUP BY + 集計関数 |
| 順位付けしたい | ROW_NUMBER / RANK |
| 前年比を出したい | LAG (Window 関数) |
| 複雑なクエリを段階的に | WITH (CTE) |
| テーブル全体を空にしたい | TRUNCATE (DELETE より速い) |
📋 まとめ
- DML は SQL の中核 (SELECT / INSERT / UPDATE / DELETE)
- 50 年間現役で代替されない強力な技術
- WHERE 句忘れの事故を防ぐため BEGIN; ROLLBACK; の儀式
- ACID とトランザクション、 分離レベルを理解
- SQL インジェクションには必ずプレースホルダ
- パフォーマンスはインデックスと EXPLAIN で改善
- Window 関数と CTE で複雑分析も可能
- pandas vs SQL は規模で使い分け、 SSDSE 程度なら pandas
- SSDSE-B-2026 のような公的データを SQLite に投入すれば SQL 学習に最適
🔗 隣接手法への橋渡し — DML と周辺技術の接続
DML(データ操作言語)は単独で完結せず、 上流・並列・下流の技術と連携することで真価を発揮する。
| 関係 | 技術・手法 | 接続の意味 |
|---|---|---|
| 上流(前処理) | データクレンジング | DML で投入する前に欠損・外れ値を除去 |
| 上流(定義) | DDL・スキーマ設計 | CREATE TABLE の型・制約を守る形で DML を書く |
| 並列(代替) | pandas | 小規模データなら pandas でも同等操作が可能 |
| 並列(NoSQL) | NoSQL / MongoDB | スキーマレスな文書操作 — DML と使い分け |
| 並列(分散) | Spark SQL / BigQuery | 大規模分散処理でも SQL 互換の DML を使う |
| 下流(可視化) | BI ツール | DML の SELECT 結果を BI に流してダッシュボード化 |
| 下流(ML 特徴量) | 集計・特徴量エンジニアリング | DML の GROUP BY・JOIN で ML 用特徴量を生成 |
| 下流(品質管理) | データ品質・監査 | UPDATE/DELETE 後の件数・値の正合性チェック |
| セキュリティ | 認証・権限管理 (DCL) | DML の GRANT で SELECT/INSERT/UPDATE を制限 |
| 自動化 | ORM / SQLAlchemy | Python オブジェクトから DML を自動生成 |
典型的な 分析パイプライン: データ収集 (スクレイピング / CSV) → DML (INSERT で DB 投入) → SELECT + GROUP BY で集計 → BI / pandas で可視化 → ML 特徴量として利用。 DML はこのパイプラインの「動脈」に位置する。
🌳 手法選択フロー — どの DML 命令・アプローチを使うか
データ操作の目的と状況に応じて、 適切な DML 命令・ツール・アーキテクチャを選択するフロー。
| 状況・目的 | 推奨アプローチ | 根拠 |
|---|---|---|
| データを読み取るだけ | SELECT + 必要列のみ指定 | SELECT * は不要列を含みパフォーマンス低下 |
| 新しいデータを追加 | INSERT (バルク推奨) | 1 行ずつより executemany で 10 倍以上速い |
| 既存データを変更 | BEGIN → SELECT 確認 → UPDATE → COMMIT | WHERE 忘れは全行破壊。 儀式で事故防止 |
| 「あれば更新、 なければ追加」 | UPSERT (ON CONFLICT) | ETL バッチで冪等性が必要な場合 |
| 大量削除 | DELETE + LIMIT チャンク or TRUNCATE | 1 回の大量削除はロック・WAL 肥大化 |
| グループ別集計 | GROUP BY + SUM/AVG/COUNT | pandas の groupby より大規模データで優位 |
| 前年比・累積集計 | Window 関数 (LAG, SUM OVER) | GROUP BY では元行を残せない。 Window で両立 |
| 複雑な多段クエリ | CTE (WITH 句) を使う | ネストしたサブクエリより可読性・デバッグが容易 |
| メモリに収まる小規模データ | pandas + pd.read_sql / to_sql | SSDSE-B-2026 (564 行) は pandas で十分 |
| ペタバイト級の大規模分析 | BigQuery / Snowflake / Redshift の SQL | ローカル RDBMS は I/O ボトルネック |
| Web アプリの ORM が遅い | N+1 問題を特定 → SELECT IN か JOIN に書き換え | ORM は SELECT * + ループが多く遅くなる |
| リアルタイムデータパイプライン | CDC (Debezium) + Kafka + DWH MERGE | DML イベントをストリームとして伝播 |
要約フロー: データ操作目的 → 命令選択 (SELECT/INSERT/UPDATE/DELETE/MERGE) → スケール判断 (ローカル/クラウド) → トランザクション設計 → BEGIN; 確認; COMMIT の儀式。
🎮 データ操作ラボ:INSERT / UPDATE / DELETE で表を書き換える
このコーナーは DML の主役=データの「変化」(行の追加・条件付き更新・条件付き削除)を手を動かして体感する場です。 SQL プレイグラウンド(SELECT 中心の問い合わせ)や DDL(テーブル構造の定義)とは役割が異なり、 ここでは中身がどう書き換わるかだけに集中します。 実行はページ内蔵の簡易エンジン(JS)が正確に計算し、 変更された行を色付きでハイライトします。
※ 下の表は教材用の架空データ(在庫表)です。 SSDSE 等の実測統計ではありません。
📦 対象テーブル(教材例・架空)— 在庫表
(a) 3 つの操作を実行してみる
行を 追加(INSERT)・条件付きで更新(UPDATE)・条件付きで削除(DELETE)。 実行するたびに、 影響を受けた行が 緑=新規 / 黄=更新 / 赤=削除予定 でハイライトされます。
+ INSERT(行を追加)
商品 在庫 価格✎ UPDATE(条件に合う行を更新)
SET =WHERE
🗑 DELETE(条件に合う行を削除予定に)
WHERE(b) WHERE 忘れの恐怖 — 全行操作の事故
上の UPDATE / DELETE パネルで 「WHERE を付けない(全行)」にチェックを入れて実行してみてください。 たった 1 回の操作ですべての行が書き換わる/消える様子が見えます。 これは実務で最も多い DML 事故で、 WHERE id = 3 と書くつもりが WHERE ごと消してしまうと、 全顧客・全在庫を一撃で破壊します。 だからこそ次の (c) トランザクションが命綱になります。
(c) トランザクション — COMMIT で確定 / ROLLBACK で取消
ここでの INSERT/UPDATE/DELETE は、 すべて「未確定(作業中)」の状態です。 COMMIT を押すまで確定されず、 ROLLBACK を押せば直前の確定状態までまるごと取り消せます。 事故った UPDATE/DELETE も、 COMMIT 前なら ROLLBACK で無かったことにできます。
🧭 直感・落とし穴・発展
- 直感:DML の変更系は「表の中身を、 追加/書換/削除する」操作。
INSERTは行を足し、UPDATEは既存行の値を書き換え、DELETEは行を消す。 DDL(CREATE で「入れ物」を作る)と違い、 DML は入れ物の中身を動かす。 SELECT は「見るだけ」で表は変わらないのに対し、 INSERT/UPDATE/DELETE は状態を変えるのが決定的な違い。 - 落とし穴①:WHERE 忘れ:(b) の通り、
UPDATE 表 SET x=0やDELETE FROM 表のようにWHEREを書き忘れると全行に及ぶ。 実行前に必ず同じ条件でSELECT COUNT(*)して「何行に効くか」を確認する習慣が事故を防ぐ。 - 落とし穴②:トランザクション未使用:オートコミットのまま実行すると、 間違った DELETE が即座に確定して戻せない。
BEGIN;で囲み、 結果を確認してからCOMMIT;、 おかしければROLLBACK;。 (c) で体感した通り。 - 落とし穴③:ロック:複数の利用者が同じ行を同時に UPDATE すると、 一方が終わるまで他方は待たされる(行ロック)。 長いトランザクションを開きっぱなしにするとロックが広がり、 システム全体が詰まる。 トランザクションは短く保つ。
- 発展:ACID と分離レベル:トランザクションは Atomicity(全部成功か全部失敗)・Consistency(整合性)・Isolation(他と干渉しない)・Durability(確定後は消えない)を保証する。 分離レベル(READ COMMITTED / REPEATABLE READ / SERIALIZABLE)を上げるほど安全だが並行性は落ちる。
- 発展:UPSERT / MERGE:「あれば UPDATE、 なければ INSERT」は
INSERT ... ON CONFLICT DO UPDATE(PostgreSQL)やMERGEで 1 文にできる。 ETL バッチの冪等性(何度流しても同じ結果)に必須。 SQL の重要イディオム。