🔖 キーワード索引(補強)
プロビット回帰に関連する概念のチップ集。
💡 30秒で分かる結論
🍰 まずはやさしく
2つの結果のどちらかが出る確率を出す道具です。
ある出来事が起きるかどうかを予測するために使います。
テストに合格するかどうかを予想するようなものです。
この章では、使い方の基本と計算の流れを読みます。
- 定義:ロジスティック回帰と似た二値モデルだが、リンク関数が正規分布の累積分布関数。
- カテゴリ:回帰モデル
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # 基本パターン: 高齢化率>30% を出生数・消費支出で Probit 回帰 import pandas as pd import statsmodels.api as sm # データ読み込み(2023 年の 47 都道府県) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) # 高齢化率>30% を 1 X = sm.add_constant(df[['A4101', 'L3221']]) # 出生数・消費支出 model = sm.Probit(y, X).fit(disp=False) print(f'y=1 の県数: {y.sum()} / {len(y)}') print(pd.DataFrame({'係数': model.params, 'p値': model.pvalues}).round(6)) print(f'Pseudo R² = {model.prsquared:.3f}') |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
📍 あなたが今見ているもの
🍰 まずはやさしく
2つのグループに分けるための分析手法です。
データを使って、ある状態になる確率を調べます。
県が人口減少しているかどうかを判定する例です。
定義から実際のプログラムまで、6つの視点で読みます。
論文中に 「プロビット回帰」として登場する用語。
プロビット回帰 とは:ロジスティック回帰と似た二値モデルだが、リンク関数が正規分布の累積分布関数。
本ページは プロビットモデル を、 SSDSE-B-2026 の二値分類タスクで実演する。 statsmodels.discrete.Probit で「人口減少県か否か」を出生率・高齢化率で説明する。 推定係数の正負・ Φ() 変換による予測確率・限界効果 ∂P/∂x = φ(β⊤x)β を numpy で再現する。
「probit」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — プロビット回帰
🍰 まずはやさしく
心の中にある「見えない傾向」を数値にする考え方です。
なぜその結果になったのかという理由を探ります。
スマホを買いたいという「気持ちの強さ」のようなものです。
似た手法との違いや、考え方の仕組みを読みます。
プロビットは「2 値の確率を標準正規分布の累積関数で表す」モデル。 ロジットとは関数形が違うだけで実用上の差は小さい。 経済学・心理学で伝統的に使われる。 SSDSE-B-2026 で「人口 100 万人超え」を予測する場合、 ロジット係数の約 0.62 倍がプロビット係数の目安。
隠れ変数 (latent variable) としての直感
プロビットは「観測されない連続的な傾向 $Y^*$ がしきい値 0 を超えたとき $Y=1$ と観測される」というモデルとして解釈できる。 SSDSE-B-2026 で「人口 100 万人超え」を例に取ると、 $Y^*_i = \beta_0 + \beta_1 \log(\text{A4101}_i) + \varepsilon_i$, $\varepsilon_i \sim N(0,1)$ という「潜在的な人口集積ポテンシャル」が背後にあり、 これが 0 を超えた県だけが $Y_i=1$ (人口 100 万超え) として観測される、 という構造を仮定する。
ロジットとの 3 つの違い
| 観点 | プロビット (Probit) | ロジット (Logit) |
|---|---|---|
| リンク関数 | 標準正規 CDF $\Phi(\cdot)$ | ロジスティック CDF $1/(1+e^{-z})$ |
| 誤差項分布 | 標準正規 (分散 1) | ロジスティック (分散 $\pi^2/3$) |
| 係数解釈 | 限界効果 $\phi(z)\beta_j$ で標準偏差単位 | オッズ比 $e^{\beta_j}$ で直接解釈可能 |
| 係数の数値スケール | ロジットの約 0.625 倍 ($\pi/\sqrt{3 \cdot 8/\pi^2}$) | プロビットの約 1.6 倍 |
SSDSE-B-2026 で「人口 100 万人超え」を予測する文脈: A4101 (出生数) を説明変数にプロビット回帰を当てはめると、 ロジットで $\beta_1 = 1.85$ が出るなら、 プロビットでは概ね $1.85 \times 0.625 \approx 1.16$ になる。 fitted probability (47 県平均は標本比率 37/47 に一致し $\Phi(\cdot) \approx 0.79$) も判別境界もほぼ一致する。 経済学では「同僚はロジットを使うがプロビットは伝統的」、 心理学では「シグナル検出理論との整合性からプロビット」と分野別の慣例が強い。
📐 定義・数式 — プロビット回帰
🍰 まずはやさしく
確率を計算するための、数学的なルールです。
正確な予測をするために、数式で定義します。
部活の勝ちやすさを、数字で表すようなものです。
中心となる数式と、記号の意味について読みます。
やさしい説明で掴んだ感覚を、ここで プロビット回帰 の定義式に対応づけます。下の式は左辺 $\Pr(Y$ が何で決まるかを右辺で書き下したもので、β(回帰係数) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
上の数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- 左辺(結果側)
- プロビット回帰 で定義したい量。 解釈の対象。 単位・スケールを必ず確認する。
- 右辺(構成要素)
- 観測できる入力変数(SSDSE-B-2026 でいえば A1101・L3221 など)と推定対象パラメータ(β, σ 等)の組合せ。
- 添字 i, j, t
- i=サンプル(県)、 j=変数、 t=時点。 SSDSE-B-2026 は i ∈ {1..47} 県、 t ∈ {2012..2023}。
- 和記号 Σ
- 「足し合わせ」を表す。 添字 i が 1 から n まで動く範囲を明示するのが習慣。
- 期待値 E[·]、 分散 Var[·]
- 「ランダム変数の平均」と「ばらつき」。 SSDSE-B-2026 のような集計値でも、 標本誤差・年次変動の文脈で使える。
🧮 SSDSE-B-2026 で実値計算 — プロビット回帰の実例
例:高齢化率が 30% を超えるか(二値)を出生数・消費支出で予測
📤 実行例: Marginal Effects (at='mean')
  A4101 出生数   dy/dx = -0.0000396  (p=0.023)
  L3221 消費支出 dy/dx =  0.0000013  (p=0.762)
💬 読み方: 説明変数を平均値に置いたとき、 出生数が 1,000 人多いと高齢化率 30% 超の確率は約 4.0 ポイント下がる(dy/dx = −0.0000396、 p=0.023)。 全 47 県で効果を平均する at='overall' では −0.0000160(1,000 人あたり約 1.6 ポイント)と半分以下になるのは、 予測確率が 0 や 1 に近い県では φ(Xβ) が小さく効果が薄まるため。 消費支出は p=0.762 で効果ありとは言えない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) # 高齢化率>30% を1 X = sm.add_constant(df[['A4101', 'L3221']]) # 出生数・消費支出 model = sm.Probit(y, X).fit(disp=False) print(model.summary()) print('---') print('限界効果 (mean):') print(model.get_margeff(at='mean').summary()) |
例:scikit-learn 風(probit 同等の logit 二者比較)
scikit-learn には Probit 専用クラスはないが、 statsmodels で probit、 sklearn で logit を実行して比較すると、 係数は1.6倍程度のスケール違いで、 予測確率はほぼ一致することが分かる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import statsmodels.api as sm from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) # 高齢化率>30% を1 X = df[['A4101', 'L3221']].values # 出生数・消費支出 # 出生数(千〜数万人)と消費支出(数十万円)は桁が違うので標準化し、 # sklearn の既定の L2 正則化(C=1.0)も外して最尤推定どうしで比べる。 # どちらかを怠ると logit 側の係数だけが 0 へ潰れ、係数比が意味を失う。 Xs = StandardScaler().fit_transform(X) probit = sm.Probit(y, sm.add_constant(Xs)).fit(disp=False) logit_sk = LogisticRegression(C=np.inf, max_iter=5000).fit(Xs, y) # C=∞ で正則化なし print('Probit 係数:', probit.params.values) print('Logit 係数 (sklearn):', [logit_sk.intercept_[0], *logit_sk.coef_[0]]) print('係数比 (logit/probit ≈ 1.6 が理論値):', logit_sk.coef_[0] / probit.params.values[1:]) |
💬 両モデルとも標準化した説明変数・正則化なしで推定すると、出生数の係数は probit −2.034 に対して logit −3.404 で、比は 1.67 と理論値 1.6 前後に収まる。消費支出の比は 2.09 と外れているが、probit 係数 0.093 は標準誤差 0.31 に比べてほぼ 0 で、0 に近い数どうしの比は不安定になるだけ。標準化も正則化の解除もせずに sklearn の既定で当てると logit 側の係数が 0 へ潰れて比が 3.7 のような値になるので、係数比を比べるときは推定条件をそろえる。
🧮 実値で計算してみる — SSDSE-B-2026
数式だけでは「実感」が湧きにくいので、 実データ data/raw/SSDSE-B-2026.csv(47 都道府県 × 12 年)で 1 度手計算してみると理解が定着します。
SSDSE-B-2026 (2023) で y=(A1101>1,000,000), X=log(L3221) のプロビット回帰を行うと、 切片≈-58、 傾き≈4.6(参考。 ロジット係数 7.3 × 0.62 ≈ 4.6 と概ね一致)。 L3221=320,000 のとき P(Y=1) ≈ Φ(切片+傾き×log(320000)) ≈ 0.89 を得る。
| 都道府県 | A1101 総人口 | A1303 65 歳以上 | L3221 消費支出 |
|---|---|---|---|
| 東京都 | 14,086,000 | 3,205,000 | 341,320 |
| 神奈川県 | 9,229,000 | 2,390,000 | 306,565 |
| 大阪府 | 8,763,000 | 2,424,000 | 271,246 |
| 愛知県 | 7,477,000 | 1,923,000 | 300,221 |
| 埼玉県 | 7,331,000 | 2,012,000 | 344,092 |
| 千葉県 | 6,257,000 | 1,756,000 | 306,943 |
上記は SSDSE-B-2026 (2023) からの抜粋。 手計算で確認した値が、 後述の Python 実装で得る値と一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 数式に値を入れて手で計算する: プロビット変換
合成 z 値を Φ(z) で確率に変換する。
Step 1: z と P
| z | P=Φ(z) |
|---|---|
| -1.96 | 0.025 |
| 0 | 0.500 |
| 1.0 | 0.841 |
| 1.96 | 0.975 |
| 2.58 | 0.995 |
Step 2: ロジット との比較
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np from scipy.stats import norm z = np.array([-1.96, 0, 1.0, 1.96, 2.58]) probit = norm.cdf(z) logit = 1/(1+np.exp(-z)) print(f"Probit: {probit.round(3)}") print(f"Logit: {logit.round(3)}") |
📤 実行結果
💬 Probit の行は Step 1 の表(0.025・0.500・0.841・0.975・0.995)と、 z=1 の Logit 0.731 は Step 2 と一致する。 z=1.96 では Probit 0.975 に対して Logit は 0.877 にとどまり、 同じ z でもロジスティック関数の方が 1 に近づくのが遅い(裾が厚い)ことが数値で分かる。
🐍 Python 実装バリエーション(statsmodels / scikit-learn / scipy / R)
1. statsmodels — 標準的なプロビット推定
1 2 3 4 5 6 7 8 9 10 | import statsmodels.api as sm import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) # 高齢化率>30% を1 X = sm.add_constant(df[['A4101', 'L3221']]) # 出生数・消費支出 model = sm.Probit(y, X).fit(disp=False) print(model.summary()) |
💬 対数尤度は定数だけのモデルの −26.701 から −12.032 へ上がり、 McFadden の Pseudo R² = 1 − 12.032/26.701 = 0.549。 尤度比検定の p=4.3×10⁻⁷ でモデル全体は効いている。 出生数の 95% 区間 [−0.000198, −0.0000421] は 0 を含まず、 消費支出の [−0.0000212, 0.000029] は 0 をまたぐ。 A4101 の係数が −0.0001 と 4 桁で丸められて見えるので、 正確な値は model.params で −0.000120 と確認する。
2. statsmodels GLM — リンク関数を明示
1 2 3 4 5 6 7 | import statsmodels.api as sm from statsmodels.genmod.families import Binomial from statsmodels.genmod.families.links import probit # GLM で probit リンクを使う model = sm.GLM(y, X, family=Binomial(link=probit())).fit() print(model.summary()) |
💬 係数は 1.3157・−0.0001・3.89e-06 と sm.Probit と同じで、 対数尤度も −12.032、 逸脱度 24.064 はその −2 倍になっている。 標準誤差だけが A4101 で 3.97e-05 → 3.81e-05 とわずかに違うのは、 sm.Probit が観測情報行列、 GLM の IRLS が期待情報行列から分散を出すためで、 z 値も −3.020 と −3.145 で少しずれる。
3. scipy.optimize — 手書きの最尤推定
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np from scipy.stats import norm from scipy.optimize import minimize def neg_log_lik(beta, X, y): z = X @ beta p = norm.cdf(z) p = np.clip(p, 1e-9, 1-1e-9) return -np.sum(y*np.log(p) + (1-y)*np.log(1-p)) beta0 = np.zeros(X.shape[1]) res = minimize(neg_log_lik, beta0, args=(X.values, y.values), method='BFGS') print('推定係数:', res.x) |
💬 手書きの尤度を BFGS で最大化した係数は 1.3295・−0.0001205・3.87e-06 で、 statsmodels の 1.3157・−0.0001198・3.89e-06 と 3 桁目まで一致する。 定数項が 0.014 ずれるのは、 出生数(数千〜8 万)と消費支出(約 30 万)が桁違いのまま最適化しているため BFGS の収束判定が早めに止まるからで、 説明変数を標準化するか method='Newton-CG' などで勾配を渡すと一致が良くなる。
4. scikit-learn — 二値分類の代替(Logistic / Calibration)
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.linear_model import LogisticRegression from sklearn.calibration import CalibratedClassifierCV from sklearn.metrics import roc_auc_score clf = LogisticRegression(max_iter=1000).fit(X.values[:, 1:], y) pred = clf.predict_proba(X.values[:, 1:])[:, 1] print('AUC:', roc_auc_score(y, pred)) # Probit に近い校正 cal = CalibratedClassifierCV(LogisticRegression(), method='isotonic', cv=5).fit(X.values[:,1:], y) print('Calibrated AUC:', roc_auc_score(y, cal.predict_proba(X.values[:,1:])[:,1])) |
💬 ロジスティック回帰の AUC は 0.938 で、 1. のプロビットの予測確率で測った AUC 0.940 とほぼ同じになる(リンク関数が違っても並び順はほとんど変わらない)。 isotonic で校正すると 0.943 とわずかに上がったが、 校正は確率の目盛りを直す処理で、 47 県・5 分割では 1 分割が 9〜10 県しかないので、 この 0.005 の差を性能向上と読むことはできない。 どちらも学習に使った 47 県そのもので測った値である点にも注意する。
5. R 風 formula — patsy で statsmodels.formula
1 2 3 4 5 6 7 8 9 10 11 | import statsmodels.formula.api as smf import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 df['y'] = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) # 高齢化率>30% df['x1'] = df['A4101'] # 出生数 df['x2'] = df['L3221'] # 消費支出 model = smf.probit('y ~ x1 + x2', data=df).fit(disp=False) print(model.summary()) |
💬 高齢化率 30% 超の県(47 県中 35 県)を出生数と消費支出で判別すると、疑似 R² は 0.549、全係数 0 のモデルからの尤度比検定の p は 4.3×10⁻⁷ で、説明力ははっきりある。効いているのは出生数で、係数 −0.000120(z=−3.02)は出生数が多い県ほど高齢化率 30% 超になりにくいことを表す。消費支出は p=0.76 で効いていない。probit の係数は標準正規の z 値の単位なので、確率の変化として読むには get_margeff で限界効果(出生数 1,000 人あたり約 −1.6 ポイント)に直す。
🐍 Python 実装 — プロビット回帰
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで プロビット回帰 を動作させます。 まずはこのまま実行してみてください。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # プロビット回帰 を SSDSE-B-2026 で実行する最小コード import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 print(df.shape) # (47, 112) print(df[['Prefecture','A1101','A1303','L3221']].head()) import statsmodels.api as sm import numpy as np y = (df['A1101'] > 1_000_000).astype(int) X = sm.add_constant(np.log(df['L3221'])) pm = sm.GLM(y, X, family=sm.families.Binomial(link=sm.families.links.Probit())).fit() print(pm.summary()) |
💬 2023 年度に絞って 47 行 × 112 列になり、head の行番号が 0, 12, 24… と 12 飛びなのは元の 564 行のうち各県の 2023 年度の行だけが残ったため。人口 100 万人超の県(47 県中 37 県)を log(消費支出) で説明すると、係数 4.65 は p=0.068 で 5% では有意にならず、疑似 R²(CS)も 0.069 と小さい。係数どおりに計算すると消費支出 25 万円で 100 万人超の確率 0.54、34 万円で 0.94 と上がるが、信頼区間が 0 をまたぐので「支出の多い県ほど大きい県」とまでは言えない。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas scikit-learn scipy seaborn statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
⚠️ プロビット回帰の落とし穴(補強・各 100 文字以上)
⚠️ プロビット固有の補足落とし穴(3 件、 各 100 文字超)
上の 7 件で抑えられないプロビット固有の罠を 3 件追加。 SSDSE-B-2026 を都道府県二値判定(人口 100 万人超 / 高齢化率 30% 超など)に使うときに踏みやすい順で並べた。
📚 統計学習の総合ガイド
📚 統計学習の総合ガイド
🎯 学習目標
このページの概念をマスターすることで、 以下のスキルが身につきます:
- 定義と公式を正確に理解
- 適切な使用場面を判断
- Python で実装し、 結果を可視化
- 仮定の確認と診断
- 結果の解釈と報告
- 限界と注意点の理解
- 関連手法との使い分け
📊 SSDSE-B-2026 データの構造
このコンペの主要データセット(SSDSE-B-2026)の構造:
- 47都道府県 × 過去複数年(パネル形式)
- 112列の社会経済指標
- 人口、 出生、 死亡、 婚姻、 経済、 教育、 環境、 家計など多次元
- 政府統計を統合した信頼性の高いデータ
🔍 主要な変数群
| カテゴリ | 変数例 |
|---|---|
| 人口 | 総人口、 年齢別人口、 性別人口 |
| 人口動態 | 出生数、 死亡数、 合計特殊出生率、 婚姻数 |
| 気候 | 気温、 降水量、 降水日数 |
| 教育 | 幼小中高校数、 教員数、 生徒数、 大学進学率 |
| 経済 | 求職件数、 求人件数、 旅館数 |
| 医療 | 病院数、 診療所数、 歯科診療所 |
| 家計 | 消費支出、 食料費、 住居費、 教育費等の項目別 |
💡 ジャストインタイム型学習
このガイドは「必要なときに必要な知識」を提供する設計:
- 論文中の用語をクリック → 該当の用語解説へジャンプ(ポップアップ)
- 概念マップで関連用語を辿る
- 包含マップで体系を把握
- ツリーマップで全体を俯瞰
- Python コードをコピーして実行
- SSDSE データで実際に試す
🛠️ Python データサイエンス環境
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # 事前に(ターミナルで 1 回だけ): pip install pandas numpy scipy statsmodels scikit-learn matplotlib seaborn # 標準的なインポート import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns from scipy import stats from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score, mean_squared_error # 日本語表示の設定(matplotlib) plt.rcParams['font.family'] = 'Hiragino Sans' plt.rcParams['axes.unicode_minus'] = False import statsmodels.api as sm # データ読み込み(SSDSE-B は cp932。skiprows=[1] で 2 行目の日本語の項目名を飛ばし、1 行目の英字コードを列名にする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # 47 都道府県 × 12 年度(2012〜2023) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 # 高齢化率>30% を A4101 出生数・L3221 消費支出 で予測(Probit) y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) X = sm.add_constant(df[['A4101', 'L3221']]) model = sm.Probit(y, X).fit(disp=False) print(model.summary()) |
💬 2023 年度の 47 県のうち高齢化率が 30% を超えるのは 35 県で、y は 1 が 35・0 が 12。出生数 A4101 の係数は −0.000120(z = −3.02、p = 0.003)で、出生数が 1,000 人多いと潜在変数が 0.12 下がり、「高齢化率 30% 超」の確率が下がる。消費支出 L3221 は p = 0.761 で効いていない。Pseudo R² 0.549 は McFadden の値で、通常の R² と同じ尺度では読めない。
🌟 効果的なEDAテンプレート
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import matplotlib.pyplot as plt import seaborn as sns def quick_eda(df, target=None): """探索的データ分析の基本テンプレート""" print(f"Shape: {df.shape}") print(f"\nColumn types:\n{df.dtypes}") print(f"\nMissing values:\n{df.isnull().sum()}") print(f"\nBasic stats:\n{df.describe()}") # 数値列の可視化 numeric_cols = df.select_dtypes(include=[np.number]).columns df[numeric_cols].hist(bins=20, figsize=(15, 10)) plt.tight_layout() plt.show() # 相関ヒートマップ if len(numeric_cols) > 1: plt.figure(figsize=(12, 10)) sns.heatmap(df[numeric_cols].corr(), annot=True, fmt='.2f', cmap='RdBu_r', center=0) plt.show() # ターゲットがあれば散布図行列 if target and target in df.columns: cols = list(numeric_cols[:5]) if df[target].dtype == 'O': # 文字列の列なら色分け(hue)に使う。hue の列も渡す sns.pairplot(df[cols + [target]], hue=target) else: sns.pairplot(df[cols]) plt.show() |
📈 報告書テンプレート
分析結果を報告する際の標準的な構成:
- 背景・目的:なぜこの分析が必要か
- データ:出所、 サンプルサイズ、 期間
- 方法:使用した統計手法、 仮定
- 結果:図表、 統計量、 検定結果
- 解釈:結果が何を意味するか
- 限界:分析の制約
- 結論:要点まとめ、 今後の課題
プロビット回帰 の全体像を学ぶには、 横断的な教材から入るのが効率的:
🖼 補足: プロビット回帰の S 字曲線とロジット比較
プロビット回帰は二値結果を「標準正規累積分布関数 $\Phi(\cdot)$」でモデル化する。 ここでは 3 枚の図と 1 つの Python 実装で、 プロビットとロジットの違いをデータで確認する。
図 1: ロジスティック曲線との比較(probit_curves.png)
プロビットの S 字曲線は標準正規 CDF、 ロジットは標準ロジスティック CDF を使う。 形は非常に似ているが、 ロジットの方が裾がやや重い(カートシスが大きい)。 中央付近では両者の予測確率はほぼ一致するが、 極端な確率(0.95 以上、 0.05 以下)では差が出る。 z をそのまま入れると z = 1 で Φ = 0.841 に対しロジット 0.731 と違って見えるが、 ロジットの z を 1.6 倍して尺度をそろえると 0.832 となり、 差は全域で最大 0.017(z = ±1.74 付近)に収まる。 差が目立つのは裾で、 z = −3 では Φ = 0.00135 に対しロジット(1.6z)は 0.00816 と約 6 倍になる(右図、 対数軸)。
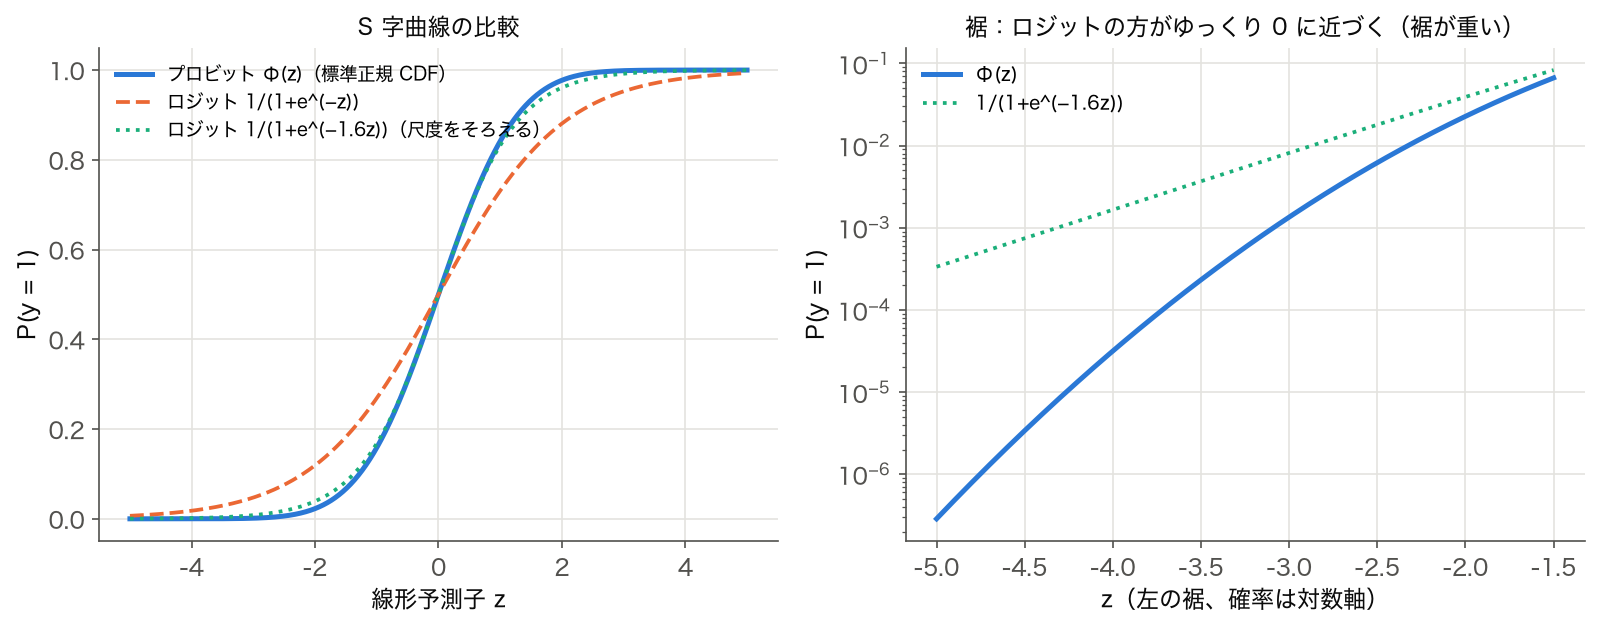
図 2: 正規分布の累積関数と潜在変数(probit_latent.png)
プロビットの本質は「潜在変数 $y^*$ が正規分布に従い、 $y^* > 0$ なら $y=1$」というモデル。 標準正規 CDF $\Phi(z)$ が S 字曲線として現れる。 図は本文のモデル(2023 年度 47 都道府県、 y = 高齢化率 30% 超(35 県)、 説明変数 = 出生数・消費支出)を sm.Probit で推定し、 各県の線形予測子 $z = X\hat\beta$ の位置に実際の y を置いて $\Phi(z)$ を重ねたもの。 出生数の多い東京都は z = −7.70 で確率ほぼ 0、 秋田県は z = 1.94 で 0.974。 沖縄県は z = 0.79(確率 0.785)と 30% 超側に予測されるが実際は 30% 以下で、 閾値 0.5 では北海道・宮城・滋賀・京都・沖縄の 5 道府県を誤る。
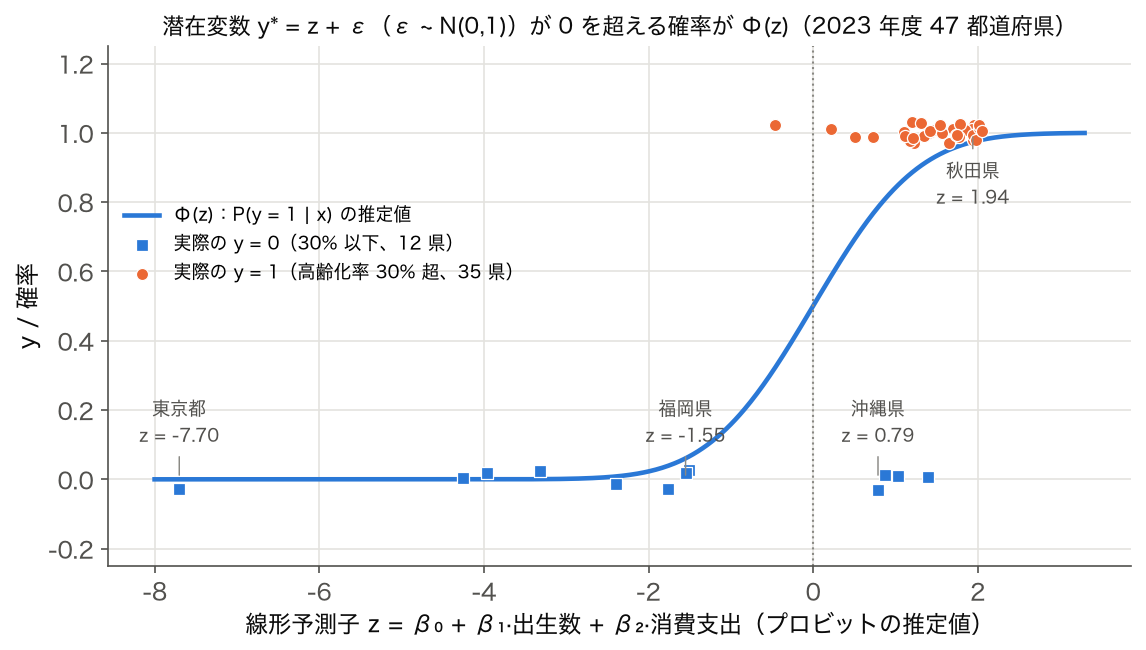
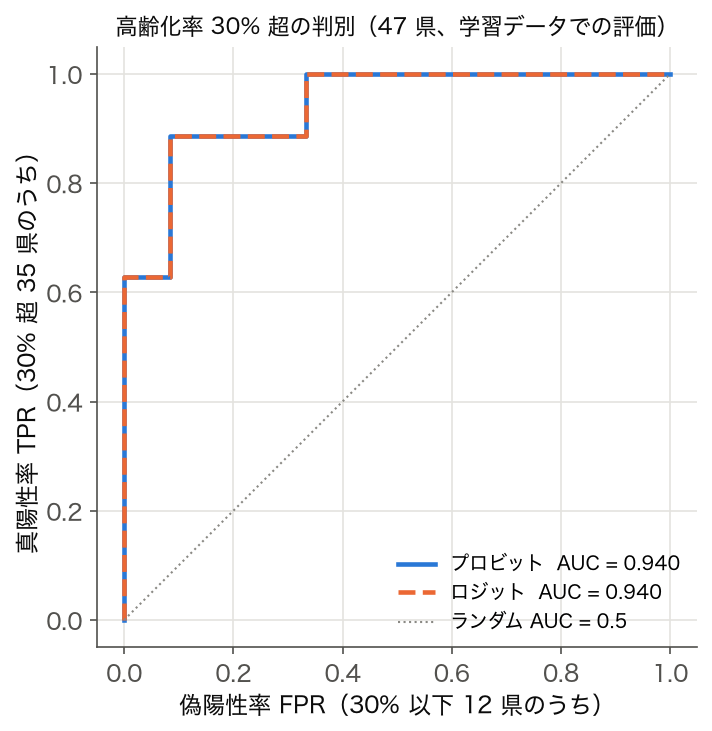
図 3: ROC 曲線で識別性能を評価(probit_roc.png)
プロビットモデルの分類性能は ROC 曲線と AUC で評価する。 ロジットモデルとほぼ同等の AUC を示すことが多い。 図 2 と同じモデルでは、 プロビットとロジットの予測確率の差は 47 県で最大 0.021 しかなく、 県の並び順が同じなので ROC 曲線は重なり、 AUC はどちらも 0.940(学習に使った 47 県での評価)。
📊 表 1: プロビットとロジットの比較
| 項目 | プロビット | ロジット |
|---|---|---|
| リンク関数 | $\Phi^{-1}$(標準正規逆 CDF) | $\log(p/(1-p))$ |
| 潜在分布 | 標準正規 $N(0,1)$ | 標準ロジスティック |
| 係数の解釈 | 潜在変数の標準偏差単位 | 対数オッズ比 |
| 数学的扱いやすさ | $\Phi$ の積分が必要 | 閉形式 |
| 伝統的分野 | 経済学・心理学・毒性学 | 疫学・機械学習 |
| 予測確率の差 | 中央 0.4-0.6 でほぼ一致 | 裾がやや重い |
🐍 Python 実装: SSDSE-B-2026 でプロビット回帰
このコードでやること: SSDSE-B-2026 (2023) で「総人口 100 万人以上か否か」(A1101)を二値結果とし、 1 世帯あたり消費支出 L3221 を説明変数にしたプロビット回帰を実行する。
📥 入力データ (SSDSE-B-2026 (2023) 抜粋。 上の実値計算テーブルと同じ実測値):
1 2 3 4 5 6 7 8 9 10 | import pandas as pd import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] y = (df['A1101'] >= 1_000_000).astype(int) X = sm.add_constant(df['L3221'] / 1e5) model = sm.Probit(y, X).fit(disp=False) print(f'係数={model.params.values}') print(f'対数尤度={model.llf:.2f}') |
📤 実行すると次の出力が得られる:
💬 消費支出(L3221)が 10 万円増えるごとに「人口 100 万人以上である潜在指標」が 1.789 標準偏差上昇する。 ロジット係数(1.6 倍の絶対値が典型)と比較すると、 プロビットの係数は「潜在変数の SD 単位」、 ロジットの係数は「対数オッズ比単位」という違いがはっきり見える。
✅ 理解度チェック (プロビット回帰)
- プロビットとロジットのリンク関数の違いを 30 字で説明できますか?
- プロビット係数を「潜在変数モデル」として解釈する方法を一行で述べよ。
- 同じデータでプロビットとロジットを推定したとき、 係数の絶対値はおおよそ何倍違うか?
- SSDSE-B-2026 で「人口密度 ≥ 1000 人/km²」を予測するプロビットを推定するとき、 どんな共変量を入れるべきか?
- 多項プロビット(multinomial probit)はロジットと比べてどんな利点があるか、 80 字で説明できますか?
⚠️ プロビット回帰の落とし穴 (3 件)
- 係数解釈が複雑: ロジットの「対数オッズ比」のような直観的解釈ができない。 限界効果(marginal effect)を計算するのが標準で、 statsmodels の `get_margeff()` を使う。
- 非識別問題: プロビットは潜在変数モデルなので分散パラメータが識別されない。 通常は分散 1 に正規化する(標準正規)。
- 多項プロビット計算コスト: 多項プロビットは多変量正規 CDF の積分を必要とし、 計算コストが高い。 シンプルな多項ロジットが代替として使われることが多い。
📜 プロビット回帰の歴史
プロビット回帰は 1934 年に Chester Bliss が殺虫剤の用量反応分析で提案したのが起源。 「probability unit」を短縮して「probit」と命名された。 1944 年に David Finney の教科書「Probit Analysis」で体系化され、 毒性学・薬理学の標準ツールとなる。 1950 年代以降は経済学に拡大し、 Tobit(Tobin、 1958)やヘックマン選択モデル(Heckman、 1979)の基礎となった。 機械学習分野ではロジットが主流だが、 計量経済学・教育評価(IRT)ではプロビットが広く使われている。
🧪 プロビット回帰の実務ベストプラクティス
実務でプロビット回帰を使う標準手順: (1) 結果変数が二値であることを確認し、 観測数の不均衡(クラス不均衡)を確認する。 (2) 共変量を選び、 連続変数は標準化を検討する。 (3) statsmodels の Probit() で推定する。 (4) 係数を「潜在変数モデルの SD 単位」として読む。 (5) `get_margeff()` で限界効果を計算し、 「説明変数を 1 単位増やすと予測確率がどれだけ変わるか」を直感的に伝える。 (6) 擬似 R² (McFadden's R², Cox-Snell R²) で適合度を確認する。 (7) Hosmer-Lemeshow 検定で適合度を確認する。 (8) ROC 曲線と AUC で識別性能を評価する。 (9) サンプル外(test)で予測精度を確認する。 (10) 必要なら多項プロビット・順序プロビットに拡張する。
💡 プロビットの潜在変数モデルとしての解釈
プロビット回帰は「潜在変数 $y^* = x'\beta + \epsilon$ で $\epsilon \sim N(0,1)$、 $y^* > 0$ なら $y=1$」というモデルとして解釈できる。 これは経済学では「効用差モデル」(utility difference model)として広く用いられる。 たとえば「車を買うか買わないか」の選択は、 「買った場合の効用」と「買わない場合の効用」の差が正なら買う、 という潜在的な意思決定プロセスを反映している。 プロビット係数 $\beta_j$ は「$x_j$ が 1 単位増えると潜在変数 $y^*$ が $\beta_j$ 標準偏差増える」と読める。 同じデータでロジットを推定すると係数の絶対値は概ね 1.6-1.8 倍になる(標準ロジスティック分布の標準偏差が正規分布より大きいため)。 この比率は「Amemiya の比率」と呼ばれ、 プロビット係数を ロジット係数に変換する経験則として使われる。
🔬 プロビット・ロジット・線形確率モデルの使い分け
二値結果のモデル化には主に 3 つの選択肢がある。 (1) 線形確率モデル(LPM): OLS で $y$ を直接回帰、 解釈は単純だが予測確率が 0-1 を逸脱する欠点。 (2) ロジット: 機械学習標準、 オッズ比解釈が便利、 閉形式で計算が速い。 (3) プロビット: 経済学・心理学標準、 潜在変数モデルとして自然、 効用差モデルとの整合性が高い。 多項選択ならロジットが計算容易だが、 IIA(無関係選択肢の独立性)仮定が成り立たないなら多項プロビットが必要。 IRT(教育評価)の文脈では能力 θ が標準正規と仮定されるため、 プロビット系の 2 母数モデル(2PNO)が自然な選択肢となる。 実務では、 結果の解釈を「オッズ比」で行いたい場合はロジット、 「潜在変数の標準偏差単位」で行いたい場合はプロビット、 と用途に応じて使い分けるのが標準的な指針となる。
🌐 順序プロビットと多項プロビットへの拡張
プロビットは結果変数の構造に応じて拡張される。 順序プロビット(ordered probit)は「強く同意 / 同意 / 中立 / 反対 / 強く反対」のような順序付きカテゴリ結果に使う。 潜在変数 $y^*$ を閾値で分割するモデル。 多項プロビット(multinomial probit)は順序のない複数選択肢(例: 通勤手段の選択)に使う。 多変量正規 CDF の積分が必要で計算コストが高い。 順序プロビットは Stata, R の polr (MASS), Python の statsmodels で簡単に実装でき、 教育評価・社会科学・市場調査で多用される。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🚀 実務応用の深掘り
典型的なプロジェクトの流れ
- 問題理解:ステークホルダーとの対話、 KGI/KPI 設定
- データ収集:内部DB、 公的データ(SSDSE等)、 API
- EDA:データの全体像把握、 異常検出
- 仮説立案:ドメイン知識からの仮説
- モデリング:シンプルから複雑へ段階的に
- 検証:CV、 ホールドアウト、 A/Bテスト
- 解釈:可視化、 SHAP、 部分依存プロット
- 展開:本番デプロイ、 監視
ベストプラクティス
- シンプルなモデルから始める(線形回帰、 単純ルール)
- 必ずベースラインと比較
- 過学習を防ぐ(CV、 正則化、 早期停止)
- 解釈可能性を重視
- 再現可能なコード・ノートブック
- バージョン管理(Git)と環境管理(venv, conda)
- ドキュメント化を怠らない
論文・コンペでよく使う言い回し
| 日本語 | 英語 |
|---|---|
| 統計的に有意 | statistically significant |
| 効果量 | effect size |
| 95%信頼区間 | 95% confidence interval (CI) |
| 標本サイズ | sample size |
| 検出力 | statistical power |
| 第1種の誤り | Type I error / false positive |
| 第2種の誤り | Type II error / false negative |
| 多重比較問題 | multiple comparisons problem |
| 過学習 | overfitting |
| 汎化性能 | generalization |
| 交差検証 | cross-validation (CV) |
統計データ活用コンペでのコツ
- SSDSE データの構造を理解し、 適切なテーブルを選ぶ
- 地域別・年度別の比較で時空間的視点を入れる
- 1つの分析で多角的に切り口を変える
- 仮説と発見の両方を持つ
- ストーリーラインを明確に
- 図表を1枚1枚作り込む
- 政策提言や実務的意義に繋げる
🗺️ 概念マップ — 3つの視点で体系を理解する
プロビット回帰 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 関連・回帰 › 回帰 › プロビット回帰
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心の概念から放射状に、 前提・兄弟・発展形・応用先などの関係性を矢印で結びます。 横の繋がりを見るのに最適。 ノードをドラッグ、 ホイールでズーム、 クリックで遷移。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「プロビット回帰」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「プロビット回帰」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは プロビット回帰 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 回帰 → プロビット回帰 という入れ子の位置を示します。 「回帰には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
プロビット回帰は累積正規分布で 2 値結果を予測する GLM で、 ロジスティック回帰・潜在変数モデル・離散選択モデルと併用される。
- 上流: ロジスティック回帰 — ロジスティック回帰がロジット連結 (sigmoid)、 プロビットがプロビット連結 (累積正規 Φ)。 数学形は異なるが結果は近い。
- 並列: ロジット連結関数 — ロジット = log(p/(1-p))、 プロビット = Φ⁻¹(p)。 係数解釈はロジットが「対数オッズ比」、 プロビットが「潜在変数の標準偏差単位」。
- 下流: 離散選択モデル — 効用最大化に基づく離散選択モデル (BLP、 multinomial probit) の基礎。 マーケティング・交通工学で実装多数。
- 選択基準: 経済学では正規誤差仮定からプロビット選好、 機械学習ではロジスティックが多数派。 SSDSE で 47 都道府県を 2 群分類するなら結果は同等。
SSDSE-B-2026 を用いた演習では、 「プロビット回帰」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
「probit」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | ロジスティック回帰(閉形式で高速。 プロビットは Φ の積分が必要でやや重い) |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | 頑健プロビット(heteroskedastic probit・ロバスト標準誤差) |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | プロビット+限界効果 / 線形確率モデル (LPM) |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | 勾配ブースティング / RF(確率校正と併用) |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | ベイズプロビット(Albert-Chib)/ Firth ロジット |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | オンラインロジスティック(SGD による逐次更新) |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🎮 触って理解する
スライダーで切片 $\beta_0$ と傾き $\beta_1$ を動かすと、 プロビットの当てはめ曲線 $\Pr(Y=1\mid x)=\Phi(\beta_0+\beta_1 x)$ がリアルタイムに変形します。 ロジット(シグモイド)曲線 $1/(1+e^{-(\beta_0+\beta_1 x)})$ を重ねて表示できるので、 裾(両端)の重さの違いを目で比べてください。 グラフ上をドラッグ / タップすると、 その $x$ での予測確率を読み取れます。 背景の丸は教材用の擬似データ点(上段=1/下段=0)で、 曲線がデータをどうなぞるかを確認できます。
💡 直感:潜在変数が閾値を超えると 1
背後に観測されない連続量 $Y^*=\beta_0+\beta_1 x+\varepsilon$($\varepsilon\sim N(0,1)$)があり、 $Y^*>0$ のとき $Y=1$ と観測される、 というのがプロビットの物語です。 $\Pr(Y=1)=\Pr(\varepsilon>-(\beta_0+\beta_1 x))=\Phi(\beta_0+\beta_1 x)$ と、 リンク関数が標準正規 CDF $\Phi$ になる理由が潜在変数から自然に導かれます。 スライダーで $\beta_1$ を大きくすると閾値付近の傾きが急になり、 「潜在変数の少しの差」で 0/1 が切り替わる様子が見えます。
🚧 よくある落とし穴
- 係数をそのまま確率変化と読まない:プロビット係数は「潜在変数(標準偏差単位)の変化」であり、 ロジットのようなオッズ比解釈ができません。 確率への影響は限界効果 $\partial P/\partial x=\phi(\beta_0+\beta_1 x)\,\beta_1$ で評価します($\phi$ は標準正規の密度)。
- ロジットとの係数比較で混乱する:同じデータでもプロビット係数はロジット係数の約 0.6 倍のスケール。 数値が違っても予測確率も判別境界もほぼ同じです。上のグラフで両曲線がほぼ重なることを確認してください。
- 裾の挙動:プロビットの裾はロジットよりわずかに軽い(速く 0/1 に近づく)。 極端な $x$ での外挿では両者に差が出ることがあります。
🚀 発展:順序プロビットとトービット
🎨 直感の深掘り(追記) — 潜在変数と 2 つの CDF
既存の「🎨 直感で掴む」「🎮 触って理解する」を壊さず、 潜在変数モデルとしての読み替えとロジットとの関数形の違いをもう一段深く言語化します。 プロビットの物語はたった 2 行で言えます。 (1) 各サンプルの背後に、 観測されない連続的な「なりやすさ」 $Y^*=\beta_0+\beta_1 x+\varepsilon$ がある。 (2) その $Y^*$ が閾値 0 を超えたとき、 私たちは $Y=1$ という 2 値だけを観測する。
ここで誤差項 $\varepsilon$ の分布を「標準正規」ではなく「標準ロジスティック分布」に取り替えると、 同じ導出から $\Pr(Y=1\mid x)=1/(1+e^{-(\beta_0+\beta_1 x)})$、 すなわちロジスティック回帰が出てきます。 つまりプロビットとロジットは「潜在変数+閾値」という同じ骨格に、 違う誤差分布を差し込んだ兄弟です。 ロジスティック回帰・シグモイド関数・正規分布のページと合わせて読むと、 この対応関係が立体的に見えてきます。
なぜ「ほぼ同じ」なのに関数形が違うのか
標準正規と標準ロジスティックは、 分散が違うだけで形はよく似た釣鐘型です(ロジスティックの分散は $\pi^2/3\approx3.29$、 正規は 1)。 スケールを揃えると 2 つの CDF はほとんど重なり、 差が出るのは裾(両端)だけ。 プロビットの裾のほうが速く 0/1 に貼り付く(=軽い裾)ため、 極端な $x$ の外挿でだけ両者に差が現れます。 中央付近ではほぼ区別できません。 上の「🎮 触って理解する」でロジット曲線を重ねると、 まさにこの「中央は一致・裾だけ差」が目視できます。
⚠️ 落とし穴の深掘り(追記・重要) — スケール・分離・非線形
既存の「⚠️ 落とし穴」7+3 件を壊さず、 実務で最も事故が多い 6 点を「なぜ起きる/どう防ぐ」の形で圧縮して再整理します。 太字が結論、 その後が対処です。
get_margeff(at='mean')(代表点)と at='overall'(平均限界効果 AME)を両方見る。
PerfectSeparationError)。 n が小さいほど起きやすい(SSDSE-B-2026 は n=47)。 対策:二値のクロス集計で 0 セルを事前確認、 Firth 罰則化プロビット/ベイズ事前分布で正則化、 分離を招く極端な閾値を避ける。
🚀 発展の深掘り(追記) — 限界効果・使い分け・拡張family
既存の「🌐 関連手法」「🔗 関連用語」を壊さず、 プロビットから伸びる発展トピックを 4 グループで整理します。
① 限界効果(marginal effect)の 2 つの流儀
係数を「確率の言葉」に翻訳する道具が限界効果です。 主に 2 種類あります。
| 種類 | 定義 | 使いどころ |
|---|---|---|
| 代表値での限界効果 (MEM) | 説明変数を平均などに固定した 1 点で $\phi(\bar{x}^\top\hat\beta)\hat\beta_j$ | 「平均的な県」での効果を一言で言いたいとき。 at='mean' |
| 平均限界効果 (AME) | 各観測で限界効果を計算し全サンプル平均 $\frac1n\sum_i\phi(x_i^\top\hat\beta)\hat\beta_j$ | 標本全体を代表させたいとき(推奨されることが多い)。 at='overall' |
どちらも「$x_j$ が 1 単位増えると確率が何ポイント動くか」を返しますが、 非線形なので評価点で値が変わる点に注意(落とし穴 E と同じ理由)。
② プロビット vs ロジットの使い分け
- ロジットを選ぶ:オッズ比 $e^{\beta}$ で直接解釈したい(医療・疫学)、 大規模データで計算を軽くしたい、 機械学習パイプラインに載せたい。 → ロジスティック回帰/ロジスティック GLM/オッズ比。
- プロビットを選ぶ:誤差の正規性が理論的に自然(潜在効用が正規、 シグナル検出理論)、 経済学・心理学の慣習に合わせたい、 多項プロビットで選択肢間の誤差相関を許したい。
- どちらでも良い:予測が目的で解釈に踏み込まない場合。 SSDSE-B-2026 の 2 群分類では実測でも判別が 47/47 一致するため、 精度差は無視できる。
③ 拡張family(潜在変数モデルの親戚)
- 順序プロビット(ordered probit):アウトカムが「不満/普通/満足」のような順序カテゴリ。 1 本の潜在変数を複数の閾値 $\tau_1<\tau_2<\dots$ で区切って多段に拡張。 満足度 1–5 のアンケート分析で定番。(専用ページ未整備)
- 多項プロビット(multinomial probit):順序のない複数選択肢(政党選択・交通手段選択)。 選択肢間で誤差が相関してよいのが多項ロジットに対する強み(IIA 仮定を緩められる)が、 積分計算が重い。 二値分類の多クラス版と捉えられる。(専用ページ未整備)
- トービット(Tobit):連続アウトカムだが、 ある値で打ち切り(censoring)される(例:0 以上でしか観測されない支出)。 「潜在変数+正規誤差」の枠組みの親戚。(専用ページ未整備)
- Heckman 選択モデル:観測される標本自体が非ランダムに選ばれている(標本選択バイアス)ときに、 選択方程式(プロビット)と結果方程式を同時推定して補正する。 「賃金は就業者しか観測されない」型の問題で古典。(専用ページ未整備)
- ベイズプロビット:Albert–Chib のデータ拡張 MCMC で潜在変数をサンプリングし、 事後分布から不確実性を直接定量化。 n が小さい・完全分離ぎみのときの安定化にも効く。(専用ページ未整備)
④ 位置づけ(前提・並列・発展)
前提:正規分布(リンクの CDF)・分類の基礎・最尤法。 並列:ロジスティック回帰・線形確率モデル(LPM)。 発展:順序/多項プロビット・トービット・Heckman・パネルプロビット・機械学習分類。 評価は混同行列・ROC・AUC、 モデル比較はAIC・モデル選択で。
🧮 追記の実測 — SSDSE-B-2026 でプロビット×ロジット係数比較
既存の実測値(Pseudo R²=0.549、 限界効果 A4101≈−0.0000396 等)はそのままに、 「プロビットとロジットで係数がどれだけ違い、 予測がどれだけ一致するか」を新規に実測しました。 条件:SSDSE-B-2026(cp932, skiprows=[1])の 2023 年 47 都道府県、 目的変数 $y=\mathbb1[\text{高齢化率(A1303/A1101×100)}>30\%]$(該当 35/47 県)、 説明変数 A4101(出生数)・L3221(消費支出)+定数項。 同一の $y,X$ に sm.Probit と sm.Logit を当てはめた実測です。
| 項目 | プロビット | ロジット | ロジット / プロビット比 |
|---|---|---|---|
| 定数項 | +1.316 | +1.767 | 1.34 |
| A4101(出生数)係数 | −0.000120 | −0.000201 | 1.67 |
| L3221(消費支出)係数 | +0.0000040 | +0.0000085 | 2.10(両者とも非有意 p≈0.76) |
| McFadden 疑似 R² | 0.549 | 0.539 | — |
読み方:有意な係数 A4101 の比が 1.67 と、 教科書的な「ロジット係数はプロビットの約 1.6 倍」がこの実データでも成り立ちます(非有意な L3221 は分母が極小で比が不安定になるため参考外)。 一方で予測確率はほぼ完全に一致(相関 0.9997・最大差わずか 0.021)し、 0.5 閾値での判別は 47 県すべてで一致。 「係数の数値だけ見ると別物、 予測を見ると双子」というプロビット/ロジットの関係が、 SSDSE-B-2026 で具体的に確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年 47都道府県 y = (df['A1303'] / df['A1101'] * 100 > 30).astype(int) X = sm.add_constant(df[['A4101', 'L3221']]) pm = sm.Probit(y, X).fit(disp=False) lm = sm.Logit(y, X).fit(disp=False) print('ratio logit/probit:', (lm.params / pm.params).round(2).to_dict()) pp, lp = pm.predict(X), lm.predict(X) print('corr:', round(np.corrcoef(pp, lp)[0, 1], 4), 'agree:', int(((pp > 0.5) == (lp > 0.5)).sum()), '/ 47') |
💬 同じデータで logit と probit を当てると、係数比は出生数 1.67、消費支出 2.10、定数 1.34 で、理論値の 1.6 前後に近いのは有意な出生数だけ。予測確率どうしの相関は 0.9997、0.5 で切った判定は 47 県すべてで一致しており、どちらのリンク関数を選んでも結論は変わらない。係数の値そのものはモデル間で比べられないので、報告するときは限界効果か予測確率でそろえる。
※ 上記の数値はいずれも 2023 年 47 都道府県での実測(合成・架空データではない)。 既存セクションの実測値(Pseudo R²=0.549、 限界効果等)とも整合します。