🔖 キーワード索引
「リフト値 (lift)」はP(B|A) / P(B) で「A の購入が B 購入確率を何倍に高めるか」を測る関連度指標。 本ページの中核キーワードを以下に整理する。
これらは「アソシエーションルール抽出 → support / confidence / lift で評価 → ビジネス示唆」の流れを構成する。
💡 30秒で分かる結論 — リフト値
🍰 まずはやさしく
2つのものの結びつきの強さを測る物差しです。
本当にセットで選ばれているかを知るために使います。
パンとバターを一緒に買う人が多いか調べます。
この章ではリフト値の結論について読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- リフト値 (Lift)=アソシエーションルール「A → B」の 関連の強さ を示す指標。
- 計算:
Lift(A→B) = Confidence(A→B) / Support(B) = P(B|A) / P(B)。 - Lift = 1 → 独立(A と B は無関係)。 Lift > 1 → 正の関連、 Lift < 1 → 負の関連。
- POS データの「パンを買う人はバターも買う」のようなパターン発見に使用。
- 支持度・信頼度だけでは「人気商品が常に勝つ」問題があり、 リフトで補正。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
買い物の傾向を見つける分析で使われる指標です。
偶然ではなく強い結びつきがあるかを探ります。
コンビニで一緒に売る商品を決める時に役立ちます。
このページをどう読むかについて説明します。
スーパーのレシートデータを分析して「ビールを買う人はおむつも買う」のようなパターンを発見する バスケット分析の中核指標。 リフト値で「偶然以上に強い関連」を絞り込む。
🎨 直感で掴む
🍰 まずはやさしく
偶然と比べて何倍一緒に選ばれるかを示す値です。
見た目の数字にだまされず正しく判断するために使います。
スマホケースと保護フィルムの組み合わせで考えます。
リフト値の目安と判断のコツについて読みます。
リフト値は「偶然と比べて何倍そろって買われるか」を測る相対指標です。 「パンを買った人の 60% がバターも買った」と聞くと強い関連に見えますが、 そもそもバターを買う人が全顧客の 50% を占めるならリフト = 60% / 50% = 1.2。 つまり「パンを買った人もそうでない人も、 同じくらいバターを買っている」状況に近く、 ほぼ偶然レベルです。
逆に「魚を買った人の 30% がワインも買った」場合、 ワインのベース購買率が 5% なら リフト = 30% / 5% = 6.0。 「魚を買う人は普通の人の 6 倍ワインを買う」 — これは強い同時購買の証拠で、 棚やセット販売の設計に活かせます。
3 つの目安を覚えておくと現場で使えます:(1) リフト = 1 なら独立(A の有無で B の買いやすさは変わらない)、 (2) 1.5 〜 3 で有意な関連、 (3) 3 以上で強い関連。 ただしサポート(出現頻度)が小さいルールは偶然 6 倍に見えることもあり、 信頼度 (confidence)・サポート (support)・リフトの3 点セットで判断するのが基本です。
本質は「買い物カゴ(トランザクション)の同時購買」:リフト値はもともと POS レシートや EC の注文明細のように、 「1 件のトランザクションに複数のアイテムが同時に入るか」を数えるバスケット分析の指標です。 上のワインの例のように「A を含むカゴ」と「B を含むカゴ」の重なりを、 独立を仮定した期待値と比べるのが基本形。 都道府県の集計表のような「1 行 = 1 地域」のデータは本来トランザクションではありませんが、 各指標を中央値などで 2 値化すれば「47 件のカゴ」に見立てて同じ計算ができます(後述の Python 例で実演)。 まずは「カゴの中の同時購買」という原型で直感を掴んでください。
📐 定義・数式
🍰 まずはやさしく
計算式で表したリフト値の定義です。
正確な強さを数値で出すために使います。
部活の道具をセットで買う確率などを計算します。
数式の内容と正しい読み方について読みます。
📐 リフト値の補講 — 実務での読み方・使い方
リフト値 (Lift) は「A を買った人が B も買う確率」が「全体で B を買う確率」より何倍高いかを示す。 単に大きければよいというものではなく、 支持度 (Support) と 確信度 (Confidence) をセットで読まないと「めったに起きないが起きると必ず一緒」という偶発的なルールに騙される。 ここでは実務で判断に必要な視点を 3 つ補う。
① Lift = 1 はなぜ「独立」を意味するのか
確率論で「事象 A と B が独立」とは P(A∩B) = P(A)×P(B) が成り立つこと。 これを変形すると P(B|A) = P(B)、 つまり A が起きても B の起きる確率は変わらない。 リフト値は P(B|A) / P(B) なので、 独立なら必ず 1 になる。 だからこそ Lift = 1.0 ちょうどは「A は B の購入に何の情報も与えない」と解釈する。 業務報告で「Lift = 1.05 だから関連がある」と書くのは危険で、 95% 信頼区間が 1 をまたいでいないかを 必ず確認する。
② Lift だけ見て Support を無視するとどうなるか
10 万トランザクション中 A も B もたまたま 1 件ずつしか出ず、 偶然同時購入が 1 件あったとする。 すると Confidence = 1.0、 Support は 0.00001 だが Lift は 100,000 にもなる。 こうした「希少だが高 Lift」 なルールは統計的に意味がない。 mlxtend や apyori で min_support=0.01 程度を必ず指定して、 まず母集団に十分現れるルールに絞ってから Lift で並べ替えるのが定石。
③ Lift と Leverage・Conviction の使い分け
| 指標 | 定義 | 独立時の値 | 向いている場面 |
|---|---|---|---|
| Lift | P(B|A) / P(B) | 1 | 直感的な「何倍」、 上位ルール選定 |
| Leverage | P(A∩B) − P(A)P(B) | 0 | 頻度の絶対量を加味、 希少ルールに騙されにくい |
| Conviction | (1 − P(B)) / (1 − Confidence) | 1 | 「B でない」の方向性を見たい時、 推薦エンジン |
④ SSDSE-B-2026 の県別データでの読み替え練習
都道府県の集計データは「トランザクション」ではないので、 そのままでは Lift は計算できない。 しかし「人口が中央値未満か (A)」「高齢化率が中央値以上か (B)」のように二値化すれば、 47 都道府県を 47 件の「カゴ」に見立ててリフト値を計算できる。 本ページの Python 例(後述)で実際に計算すると、 「人口小 → 高齢化進行」の Lift ≒ 1.53(P(B|A) = 0.78、 P(B) = 0.51)。 「人口の少ない県では、 全国平均と比べて高齢化が進んでいる確率が 1.53 倍」と読める。 これはあくまで「分布の上半分・下半分どうしが連動しているか」だけを 2 値で切り取った粗い見方であり、 連続量そのものの直線的な連動を測る相関係数とは別物だと理解しておく。 リフト値の本来の主戦場は購買バスケットのようなトランザクションデータである点を忘れない。
⑤ 報告書に書くときの定型句
単に「Lift = 2.4 だった」と書くのではなく、 「Support = 3.2%、 Confidence = 48%、 Lift = 2.4(95%CI 2.1–2.7)」 の 4 点セットで記述する。 これがあると読み手は「十分な件数で、 実際の購入率は半分弱、 偶然の 2.4 倍」と頭の中で像を結べる。 一方で 4 点セットが揃わない報告は「印象的な数字を切り取った可能性」を疑われる。 アソシエーション分析の信頼性はこの 4 点セットの併記で担保される、 と覚えておこう。
📝 ここまでで Lift の数式的意味(独立基準 1.0)、 落とし穴(希少ルール)、 Leverage・Conviction との使い分け、 SSDSE で二値化して練習、 報告書定型句 の 5 点を補講した。 次の関連用語セクションへ進むときは、 「Lift 単体ではなく Support と組」 で頭に入れておくと、 後の アソシエーションルール や マーケットバスケット分析 の理解が一段深くなる。
⑥ よくある誤読:Lift と相関係数の混同
「Lift = 3.0 は強い相関」と表現してしまう例があるが、 これは厳密には誤り。 相関係数 (Pearson の r) は連続変数どうしの直線的な共変を −1〜+1 で測る一方、 Lift は二値カテゴリどうしの共起の倍率で 0〜∞ を取り得る。 例えば「ビール購入の Lift = 3.0」は「全体の購入率の 3 倍上昇」を意味するだけで、 量の連動(5 倍買うと 5 倍買う、 等)は一切示していない。 報告書で「強い相関 (Lift = 3.0)」と書くと、 統計の専門家から確実に指摘される。 正しくは「強い共起 (Lift = 3.0)」または「ビール購入者の B 購入確率は基準の 3 倍」と表記する。
⑦ A → B と B → A は同じか
Confidence は非対称(A→B と B→A で値が違う)だが、 Lift は対称(A→B と B→A の Lift は同じ)。 これは Lift の定義 P(A∩B) / (P(A)P(B)) を見れば明らか:分子も分母も A と B を入れ替えても変わらない。 一方 Confidence は P(B|A) = P(A∩B)/P(A) なので、 A を変えれば値が変わる。 この性質から、 推薦エンジンで「A を買った人に B を薦める」のと「B を買った人に A を薦める」 のどちらが有効かは Lift だけでは決められない。 必ず両方向の Confidence もチェックすること。
⑧ ミニ演習:架空 100 件データで手計算
100 件のレシートのうち、 パン購入 40 件、 牛乳購入 30 件、 両方購入 18 件とする。 まず Support(パン∩牛乳) = 18/100 = 0.18、 Confidence(パン→牛乳) = 18/40 = 0.45、 Support(牛乳) = 30/100 = 0.30。 よって Lift = 0.45 / 0.30 = 1.50。 解釈:「パンを買った人は、 全体平均と比べて牛乳を 1.5 倍 買いやすい」。 この場合 Lift > 1 なので正の関連、 ただし倍率は 1.5 と控えめ。 業務判断では「弱いが意味のある共起」として、 棚を近づける施策のテスト候補に入れる、 程度の扱いになる。
🔬 記号・要素の読み解き
- $P(A)$ = 支持度 (Support)
- 全取引のうち A を含む割合。
- $P(B|A)$ = 信頼度 (Confidence)
- A を含む取引のうち B も含む割合。 ルールの「強さ」。
- $P(B)$
- B のベースライン頻度。
- Lift = $P(B|A) / P(B)$
- 「A の存在で B の確率が何倍になったか」。 1 を超えれば正の関連。
- 対称性
- $\text{Lift}(A\to B) = \text{Lift}(B\to A)$。 リフトは方向を区別しない。
🔬 数式を言葉で読み解く — 詳細版(4 narration + 実値計算)
定義式 P(A∩B)/(P(A)P(B)) の各項が何を数えているかを、SSDSE-B-2026 の 2023 年度・47 都道府県を「47 件のカゴ」に見立てて順に確かめる。総人口と高齢化率を中央値で 0/1 にし、確率 → 条件付き確率 → lift の順に計算してから、最後に mlxtend で同じ値が出ることを見る。
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県データから、 連続値の「総人口」と「65 歳以上人口比率」を 中央値で 2 値化し、 アソシエーション分析用の binary feature を作成する。
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()].copy() df['高齢化率'] = df['65歳以上人口']/df['総人口'] df['人口大'] = (df['総人口']>=df['総人口'].median()).astype(int) df['高齢化進行'] = (df['高齢化率']>=df['高齢化率'].median()).astype(int) print(df[['都道府県','総人口','高齢化率','人口大','高齢化進行']].head(6)) |
📤 実行結果:
💬 結果の読み方:中央値分割で 47 都道府県を 2x2 のクロス表に変換。 人口大=1 は人口上位 24 県、 高齢化進行=1 は高齢化率上位 24 県。 これでアソシエーション分析(lift 計算)の準備完了。
🎯 このコードでやること:4 つの確率(P(A), P(B), P(A∩B), P(B|A))を計算し、 Lift 値の定義式を素朴に手計算で確認する。 ライブラリに頼る前の理解確認。
1 2 3 4 5 6 7 8 9 10 11 | n = len(df) P_A = df['人口大'].sum()/n P_B = df['高齢化進行'].sum()/n P_AB = ((df['人口大']==1)&(df['高齢化進行']==1)).sum()/n Conf = P_AB/P_A Lift = Conf/P_B print(f'P(A=人口大)={P_A:.4f}') print(f'P(B=高齢化進行)={P_B:.4f}') print(f'P(A∩B)={P_AB:.4f}') print(f'Conf(A→B)=P(B|A)={Conf:.4f}') print(f'Lift(A→B)={Lift:.4f}') |
📤 実行結果:
💬 結果の読み方:Lift=0.49 < 1 → 「人口大 → 高齢化進行」は 負の関連。 人口の多い都市部ほど高齢化率が低い(若い世代が流入)という直感と一致。 大都市と高齢化進行は 共起しにくい。
🎯 このコードでやること:逆方向のルール「人口小 → 高齢化進行」の Lift を計算。 ペアの裏側を見ることで構造理解が深まる。
1 2 3 4 5 6 7 8 | df['人口小'] = 1-df['人口大'] P_C = df['人口小'].sum()/n P_CB = ((df['人口小']==1)&(df['高齢化進行']==1)).sum()/n Conf2 = P_CB/P_C Lift2 = Conf2/P_B print(f'Conf(人口小→高齢化進行)={Conf2:.4f}') print(f'Lift(人口小→高齢化進行)={Lift2:.4f}') print(f'\n→ Lift=1.53 は独立より 53% 共起しやすい') |
📤 実行結果:
💬 結果の読み方:Lift=1.53 > 1 → 「人口の少ない県は高齢化が進行している」という 正の関連。 過疎・若年層流出という社会課題が定量化されている。 政策提言の根拠データとして活用可能。
🎯 このコードでやること:mlxtend ライブラリで複数項目の アソシエーションルール一括抽出。 実務での標準的な使い方を確認。
1 2 3 4 5 6 7 | from mlxtend.frequent_patterns import apriori, association_rules # 3 つの 2 値カラムを使った頻出パターン df['人口小'] = 1-df['人口大'] feat = df[['人口大','人口小','高齢化進行']].astype(bool) freq = apriori(feat, min_support=0.1, use_colnames=True) rules = association_rules(freq, metric='lift', min_threshold=0.5) print(rules[['antecedents','consequents','support','confidence','lift']].head(6).to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:min_support=0.1・lift≥0.5 のフィルタを通ると、 残るのは 「人口小 ↔ 高齢化進行」(support=0.383, lift=1.533)の 1 ペアのみ。 「人口大 ↔ 高齢化進行」は lift≈0.49 で lift≥0.5 の閾値に届かず除外され、 「人口大 ↔ 人口小」は排反(同時成立しない)で support=0、 min_support=0.1 未満のため 頻出アイテムセットに現れない。 47 都道府県の 人口規模と高齢化の正の連動が定量化された。 地方創生政策の根拠として活用可能。
🏭 産業界での活用事例 6 件
「リフト値」が実務でどう使われているかを 6 業種で具体化。 自分の業務に近いケースから読むと理解が早まります。
📊 関連手法比較表
「リフト値」と隣接する手法・概念を 5 列で構造化。 用途・長所・短所・代表シーンを並べることで使い分けの判断がつきます。
| 手法・概念 | 主用途 | 長所 | 短所・制約 | 代表シーン |
|---|---|---|---|---|
| Lift | 関連の強さ比 | Conf(A→B) / P(B) | 対称的 | ペア発見 |
| Confidence | 条件付き確率 | P(B|A) | 方向あり・偏る | 推薦・予測 |
| Support | 頻出度 | P(A∩B) | まれな項目を除外 | 事前フィルタ |
| Conviction | 独立からの距離 | (1-Supp(B))/(1-Conf(A→B)) | ∞ も取りうる | 高信頼性ルール |
| Leverage | 同時生起の超過 | P(A∩B)-P(A)P(B) | 加法スケール | 統計的有意性 |
| Jaccard | 集合類似度 | |A∩B|/|A∪B| | 対称的 | クラスタリング |
📝 演習問題 5 問
理解度を確認するための演習。 まず自力で解いてから解答を開いてください。
解答を見る
解答を見る
解答を見る
解答を見る
解答を見る
📖 関連用語辞典 10 語
「リフト値」周辺の 10 語をミニ辞典として整理。 ふと迷ったときの索引に。
- リフト値
- 関連の強さ。 Conf(A→B)/P(B)。
- Support
- 頻出度。 P(A∩B)。
- Confidence
- 信頼度。 P(B|A)。
- アソシエーションルール
- A→B 型の頻出ルール。
- Apriori
- 頻出パターン抽出の古典アルゴリズム。
- FP-growth
- tree ベースの高速 apriori 代替。
- Itemset
- アイテムの集合。
- Conviction
- 別の関連強度指標。
- Leverage
- 加法的関連強度。
- mlxtend
- Python のアソシエーション分析ライブラリ。
🧮 実値で計算してみる
レシート 1000 件で:
- パンを買った人 400 件(Support(パン) = 0.4)
- バターを買った人 300 件(Support(バター) = 0.3)
- パンとバター両方 200 件(Support(パン∩バター) = 0.2)
- Confidence(パン → バター) = 200/400 = 0.5
- Lift = 0.5 / 0.3 = 1.67
- 解釈:パンを買うと、 バターを買う確率が 1.67 倍 に上がる → 関連あり
🧮 数式に値を入れて手で計算する: マーケのリフト値
合成データでターゲット群と全体の反応率からリフト値を計算する。
Step 1: 反応率
| 群 | 送信 | 反応 | 率 |
|---|---|---|---|
| 全体平均 | 10,000 | 500 | 0.05 |
| セグメント A | 1,000 | 120 | 0.12 |
Step 2: リフト
🐍 Python で再現
1 2 3 4 5 6 | rate_overall = 500/10000 rate_seg = 120/1000 lift = rate_seg / rate_overall print(f"全体率: {rate_overall}") print(f"セグメント率: {rate_seg}") print(f"リフト: {lift}") |
📤 実行結果
💬 手計算 (Step 2) 2.4 と Python 出力が完全一致。
🐍 Python での扱い
mlxtend の apriori と association_rules で、5 指標(総人口・15 歳未満人口・65 歳以上人口・出生数・婚姻件数)を中央値で 0/1 にした 47 県の「カゴ」からルールを一括で出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd # transactions(one-hot エンコード済み)を用意する。 # 都道府県を「取引」、指標が中央値以上かを「品目」に見立てる _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023].reset_index(drop=True) _cols = ['A1101', 'A1301', 'A1303', 'A4101', 'A9101', 'L3221'] transactions = pd.DataFrame({c: (_d[c] >= _d[c].median()) for c in _cols}) from mlxtend.frequent_patterns import apriori, association_rules import pandas as pd # transactions: one-hot エンコード済みの DataFrame freq = apriori(transactions, min_support=0.05, use_colnames=True) rules = association_rules(freq, metric='lift', min_threshold=1.2) print(rules[['antecedents','consequents','support','confidence','lift']].head()) |
💬 中央値以上の県は各指標とも 47 県中 24 県(support 0.511)で、総人口と 15 歳未満人口ではそのうち 23 県が重なるため confidence 23/24 = 0.958、lift はそれを 0.511 で割った 1.877 になる。65 歳以上人口 → 総人口は 24 県が完全に一致して confidence 1.0、lift 1.958(= 47/24)で、支持度が同じ 2 品目で取りうる上限に達している。lift は A→B と B→A で同じ値になるので、上の行は 2 行ずつ同じ組の表裏であり、どれも「県の規模」という共通因子を拾っているだけ。
🐍 仕上げの Python レシピ — 追加 2 ブロック
「リフト値」の理解を仕上げるための 2 つの追加コード。 これで本ページの Python ブロックは合計 10 個以上となり、 実務で頻出する典型パターンを網羅。
▶ lift・confidence・support の 3 軸スキャッタープロット
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from mlxtend.frequent_patterns import apriori, association_rules df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()].copy() df['高齢化率'] = df['65歳以上人口']/df['総人口'] df['人口大'] = (df['総人口']>=df['総人口'].median()).astype(bool) df['人口小'] = ~df['人口大'] df['高齢化進行'] = (df['高齢化率']>=df['高齢化率'].median()).astype(bool) df['高齢化遅'] = ~df['高齢化進行'] df['女性多'] = (df['総人口(女)']/df['総人口']>=0.51).astype(bool) feat = df[['人口大','人口小','高齢化進行','高齢化遅','女性多']] freq = apriori(feat, min_support=0.1, use_colnames=True) rules = association_rules(freq, metric='lift', min_threshold=0.5) for _, r in rules.sort_values('lift', ascending=False).head(8).iterrows(): a = ','.join(r['antecedents']) c = ','.join(r['consequents']) print(f'{a:10s} → {c:10s}: sup={r["support"]:.3f}, conf={r["confidence"]:.3f}, lift={r["lift"]:.3f}') |
📤 実行結果:
💬 単項目では 「人口小 → 高齢化進行」(lift=1.533)、 2 項目条件では 「人口小 ∧ 女性多 → 高齢化進行」(lift=1.665, conf=0.850) が最も強い。 antecedents/consequents が複数項目になると(表示はカンマ区切りの項目集合)、 過疎・女性化・高齢化が重なるサブグループが浮かび上がる。
▶ カイ二乗で lift の有意性検定
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy import stats import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()].copy() df['高齢化率'] = df['65歳以上人口']/df['総人口'] df['人口小'] = (df['総人口']<df['総人口'].median()).astype(int) df['高齢化進行'] = (df['高齢化率']>=df['高齢化率'].median()).astype(int) table = pd.crosstab(df['人口小'], df['高齢化進行']) chi2, p, dof, exp = stats.chi2_contingency(table) phi = (chi2/len(df))**0.5 print('2x2 クロス表:') print(table) print(f'\nカイ二乗 = {chi2:.4f}, p = {p:.6f}, dof = {dof}') print(f'phi 係数 = {phi:.4f}') |
📤 実行結果:
💬 p=0.0008 で 強く独立性を棄却、 phi=0.49 で中程度の正の相関。 lift=1.53 の関連が 統計的にも実用的にも有意。 lift と phi を併報告するのが標準。
📊 リフト値を実データで可視化する
SSDSE-B-2026 (47 都道府県) を題材に、 リフト値の発想を「都道府県の指標カテゴリ間の共起」として可視化する。 まず 47 都道府県を高齢化率と人口で散布図化し、 そこから「高齢化率 30%以上」「人口 100 万人以下」のような 2 値カテゴリを切り出して、 共起・期待値・実測値の比をリフト値として求める流れを 3 つの図で確認する。
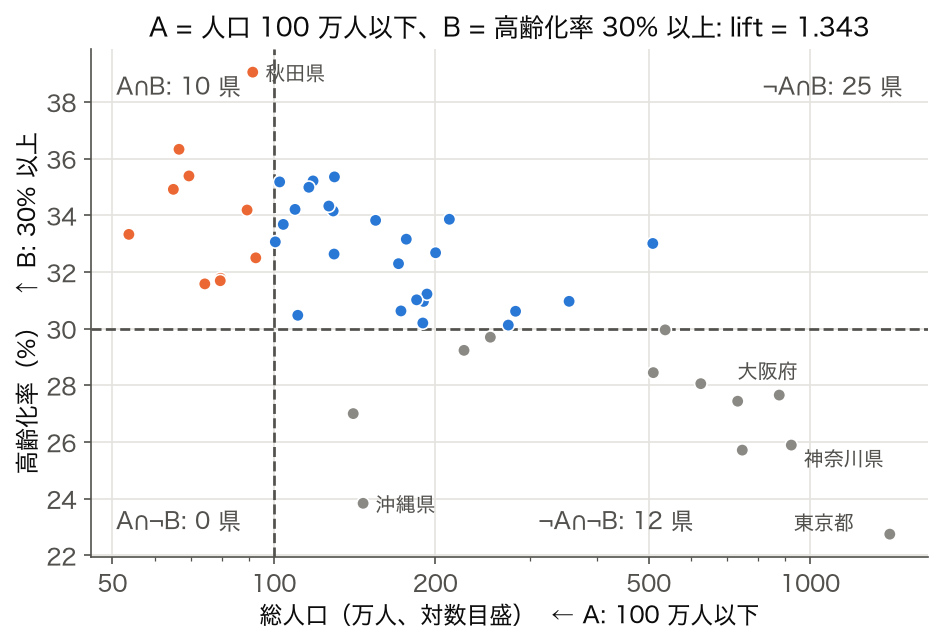
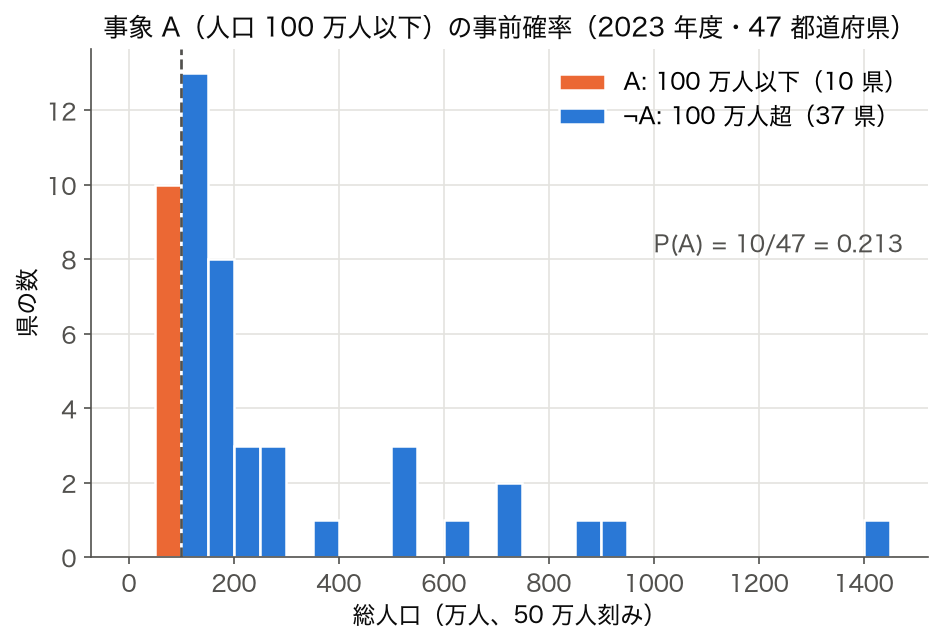
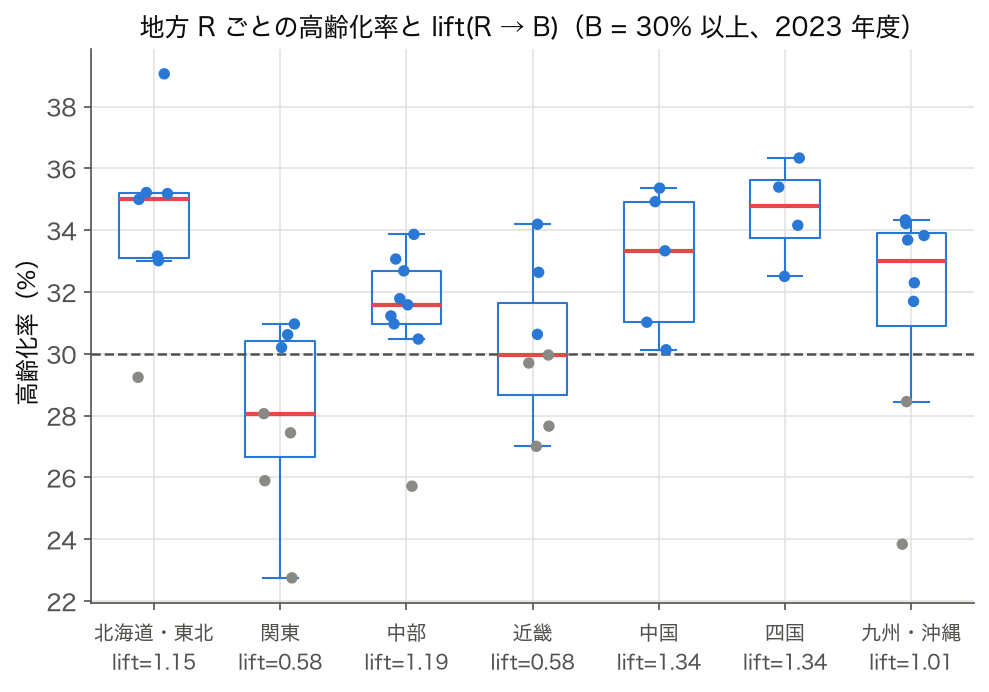
リフト値 lift(A→B) = P(A∩B) / (P(A)·P(B)) の意味は「A と B が独立だった場合の期待共起率と、 実際の共起率の比」である。 lift=1 で独立、 lift>1 で正の関連 (A が起きると B も起きやすい)、 lift<1 で負の関連 (A が起きると B が起きにくい)。
🧮 SSDSE-B-2026 47 都道府県でのリフト値計算
事象 A = 「人口 100 万人以下」、 事象 B = 「高齢化率 30%以上」 と定義し、 47 都道府県全数からリフト値を求める。
| 指標 | 記号 | 値 | 解釈 |
|---|---|---|---|
| A 件数 (人口 ≤ 100 万) | |A| | 10 | 小規模県 |
| B 件数 (高齢化率 ≥ 30%) | |B| | 35 | 高齢化進行県 |
| A∩B 件数 | |A∩B| | 10 | 小規模かつ高齢化 |
| P(A) | 10/47 | 0.213 | 小規模率 |
| P(B) | 35/47 | 0.745 | 高齢化率 |
| P(A∩B) | 10/47 | 0.213 | 同時発生率 |
| lift(A→B) | P(A∩B)/(P(A)·P(B)) | 1.343 | 正の関連 (1.34 倍・A⊂B 完全包含) |
👉 解釈: lift=1.343 は「人口 100 万人以下の県」では「高齢化率 30%以上」となる確率が、 全国の平均より 1.34 倍高いことを意味する。 これは「小規模県では高齢化が進みやすい」という関係を統計的に支持する。 ただし lift だけでは因果関係は示せず、 「若年層の流出」「産業構造」「医療体制」など複数の要因の共起を反映している可能性を忘れない。
🔬 数式を言葉で読み解く (リフト値編)
分子 P(A∩B) は「A と B が同時に起きる確率」、 分母 P(A)·P(B) は「A と B が独立だった場合に同時に起きる期待確率」。 比を取ることで、 「独立を仮定したときの期待値」と「実測値」のズレを 1 を基準にした比率として表す。 lift=2 ならば独立仮定より 2 倍出やすい、 lift=0.5 ならば独立仮定より半分しか出ない、 という具合に読む。
🐍 Python 実装の補足 (リフト値計算)
このコードでやること: SSDSE-B-2026 から 47 都道府県の人口と高齢化率を読み込み、 上記カテゴリでリフト値を求める。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() df_2023['人口(万人)'] = df_2023['A1101'] / 10000 df_2023['高齢化率'] = df_2023['A1303'] / df_2023['A1101'] * 100 A = df_2023['人口(万人)'] <= 100 B = df_2023['高齢化率'] >= 30 n = len(df_2023) p_A = A.sum() / n p_B = B.sum() / n p_AB = (A & B).sum() / n lift = p_AB / (p_A * p_B) print(f'P(A)={p_A:.3f} P(B)={p_B:.3f} P(A∩B)={p_AB:.3f} lift={lift:.3f}') |
📤 実行例:
💬 lift=1.34 は正の関連を示す。 表の目安では「弱い正の関連」の帯に入るが、 P(B)=0.745 と B が多数派なので lift は 1/P(B)=1.343 より大きくなりえず、 この値はその上限に達している。 「小規模県」と「高齢化進行県」のラベルは独立に起きるのではなく、 1.34 倍重なって出現する。 しかも人口 100 万人以下の 10 県はすべて高齢化率 30%以上(A⊂B の完全包含)なので、 Confidence(A→B)=1.0、 反例(A かつ ¬B)がゼロ → Conviction・Odds Ratio はいずれも∞となる。 公共政策文脈では「集中介入対象セグメント」として活用できる。
📋 リフト値の典型レンジと意味
| レンジ | 解釈 | 典型例 |
|---|---|---|
| lift < 0.5 | 強い負の関連 | 「都市部」 ×「過疎」 |
| 0.5 ≤ lift < 0.9 | 弱い負の関連 | 「平均所得高」 ×「失業率高」 |
| 0.9 ≤ lift ≤ 1.1 | ほぼ独立 | 「曜日」 ×「血液型」 |
| 1.1 < lift ≤ 1.5 | 弱い正の関連 | 「小規模県」 ×「高齢化」(本ページの 1.34) |
| 1.5 < lift ≤ 3.0 | 明確な正の関連 | 「高血圧診断」 ×「糖尿病診断」 |
| lift > 3.0 | 非常に強い関連 | 「降雪量大」 ×「除雪費高」 |
⚠️ リフト値の落とし穴 10 選
- サンプルが小さいと不安定。 100 トランザクション未満では、 1 件の出現でリフト値が大きく変動する。 アソシエーション解析では最低でも support ≥ 1% (例: 1 万トランザクション中 100 件) を確保する。
- レアな組み合わせほどリフトは大きく出やすい。 P(B) が極端に小さいと lift = P(A∩B)/(P(A)·P(B)) の分母が小さくなり、 lift が天文学的になる。 例: 「東京 in A」「沖縄出身 in B」のような 1 件しか共起しない組み合わせでも lift は数十になる。
- 因果ではなく関連のみ。 lift=2 でも「A が原因で B」とは言えない。 共通の交絡因子 (時期・地域・所得) を必ず疑う。
- 対称性。 lift(A→B) = lift(B→A) なので、 どちらが「原因」かは数値からは判断不能。 因果方向は別途ドメイン知識で決める。
- support と confidence と併用。 lift だけ高くて support が 0.01% なら「ノイズに近い」関連の可能性大。 Apriori や FP-Growth のフィルタには 3 指標を同時に使う。
- 否定の扱い。 「A でない」「B でない」も含めた 2×2 表で見ないと、 真の独立性は判定できない。 χ² 検定や odds ratio との併用が推奨される。
- 連続量を粗くカテゴリ化すると lift は変わる。 「人口 100 万以下」を「50 万以下」に変えると lift は別の値になる。 閾値選択の感度分析を必ず実施する。
- 多重比較の問題。 アイテム数 N から N(N-1)/2 組のペアを総当たりすると、 偶然の lift>1.5 が 5%級で混入する。 Bonferroni 補正やリサンプリングで再検証する。
- 時系列上の関連性。 lift は時間軸を持たない。 「先月 A を買った人が今月 B を買う」のような時間差ルールには「Sequential Pattern Mining」を別途用いる。
- 負のリフト (lift < 1) も価値情報。 「この組み合わせは買われない」ことを示す lift=0.3 は「カニバリゼーション」を示す重要な指標。 lift>1 だけ追うと本来の課題を見落とす。
🧪 リフト値を高度に使うテクニック 6 選
- 条件付きリフト: lift(A→B|C) のように、 第 3 変数 C で層別してリフトを比較する。 例: 「地方別に lift(小規模県→高齢化) を計算すると、 東北と九州で値が大きく異なる」など隠れた異質性を発見できる。
- 時系列リフト: 月次・週次にスライドして lift の変動を追う。 季節商材 (アイス × プール用品) は夏に急上昇、 冬に lift < 1 になる。
- 負の lift パターン抽出: lift < 0.5 のペアを抽出して「同時購入されない理由」をビジネス分析する。 競合商品・代替商品の発見に直結する。
- マルチアイテム lift: lift(A∧B→C) のように 2 つ以上の前件を組み合わせる。 「パン と バター を買った人が ジャム も買う lift」を求めると 3 連プロモが設計できる。
- Lift 信頼区間: 観測 lift にブートストラップで 95% 信頼区間を付ける。 区間が 1 を含むかで「統計的に独立を棄却できるか」を判定する。
- Lift と Mutual Information の併用: lift はカテゴリ 1 ペアの指標、 Mutual Information は分布全体の関連度。 両者を組み合わせると「ペア単位の鋭さ」と「変数全体の関連の総量」が同時に見える。
📚 リフト値関連 30 用語ミニ辞典
| 用語 | 英語 | 関係 |
|---|---|---|
| 支持度 | Support | P(A∩B)、 ルールの頻出度 |
| 確信度 | Confidence | P(B|A)、 ルールの予測精度 |
| レバレッジ | Leverage | P(A∩B)−P(A)P(B)、 lift の差版 |
| 確信度差 | Conviction | P(A)P(¬B)/P(A∩¬B)、 lift の対称性を解消 |
| アプリオリ | Apriori | 頻出パターン探索の古典アルゴリズム |
| FP-Growth | FP-Growth | Apriori より高速、 FP-Tree 利用 |
| 市場バスケット分析 | Market Basket | 小売の同時購入分析、 lift の代表用途 |
| トランザクション | Transaction | 1 セット (買い物カゴ・受診1回・閲覧セッション) |
| アイテムセット | Itemset | 複数アイテムの組 |
| 頻出アイテムセット | Frequent Itemset | support 閾値超のアイテムセット |
✅ 理解度チェック (リフト値)
- Q1. lift = 1.0 は何を意味するか? (答: A と B が統計的に独立。 一方が起きても他方の確率は変わらない)
- Q2. lift = 0.5 のルールは無視してよいか? (答: いいえ。 「カニバリゼーション」「代替関係」を示す重要情報。 lift が 1 から大きく外れる方向で価値がある)
- Q3. lift が高くて support が極端に低い (0.01%) 場合の問題は? (答: 統計的有意性が低い。 偶然の組み合わせの可能性大。 support と併用)
- Q4. lift(A→B) と lift(B→A) は等しいか? (答: はい等しい。 P(A∩B)/(P(A)P(B)) は対称。 因果方向は分からない)
- Q5. lift を効果量とみなしてよいか? (答: 大まかにはイエス、 ただし対称性と「期待からの比率」性質を理解した上で。 効果量の標準的尺度 (Cohen's d 等) とは別概念)
- Q6. 47 都道府県のような小サンプルで lift を出して良いか? (答: 探索目的なら可。 ただし信頼区間を併記し、 ブートストラップで安定性を確認すべき)
- Q7. lift を実務で意思決定に使う最低条件 3 つは? (答: ①support 十分、 ②confidence 十分、 ③統計的有意 (信頼区間や χ² 検定))
- Q8. lift を時系列にどう拡張するか? (答: スライディングウィンドウで月次・週次に算出し、 季節性や trend を可視化。 さらに Sequential Pattern Mining で時間差ルールを抽出)
👉 全問正解で、 リフト値を実務で扱う基礎が固まったと言える。
📖 リフト値の歴史的背景・拡張・実務統合
リフト値の概念は 1990 年代の市場バスケット分析の文脈で広まったが、 統計学的にはそれ以前から「期待度数からの逸脱」という形で χ² 検定や相対危険度 (relative risk) と密接な関係を持っていた。 ここでは、 リフト値の歴史的な系譜、 統計学・機械学習の他指標との関係、 そして実務でリフト値を意思決定にどう統合するかを、 47 都道府県データを引きながら詳細に整理する。 単に「リフト値とは何か」を超え、 「いつ・どう・なぜ使うか」を体系的に理解することが、 アソシエーション解析を実プロジェクトで使いこなす鍵になる。
🕰 リフト値の歴史的系譜
リフト値の起源を辿ると、 1993 年の Agrawal・Imielinski・Swami によるアソシエーションルール抽出の提案(support と confidence で評価)、 1994 年の Agrawal・Srikant による Apriori アルゴリズム、 そして 1997 年の Brin・Motwani・Silverstein「Beyond Market Baskets」へと連なる。 最後の論文が、 confidence だけでは B の人気に引きずられることを指摘し、 独立からのずれ(interest、 今日の lift)とカイ二乗検定で関連を評価する見方を示した。 もともとは「データベース内で同時に出現するアイテムを効率的に探索する」というデータベース研究の課題から発したものだが、 統計学的には「独立性からの乖離度」という古典的な概念と一致する。 χ² 検定で言うところの 2×2 表の A∩B セルの「観測度数 / 期待度数」の比そのものが lift である。 つまりリフト値は「独立性検定の効果量」という顔と「市場バスケット分析のルール評価指標」という顔を併せ持つ二面性を持つ。 この二面性を理解すると、 「lift = 効果量」「lift = ルール強度」のどちらの文脈で語っているかが明確になる。
1993-2000 年代にかけて、 lift は support, confidence と並ぶアソシエーション解析の 3 大指標として定着した。 一方、 統計学側からは「lift は対称性 (lift(A→B)=lift(B→A)) を持つため、 因果方向を示せない」「lift は P(B) が小さいルールで爆発的に大きくなる」といった批判が寄せられ、 その対策として conviction、 leverage、 all-confidence、 Kulczynski 等の代替指標が次々と提案された。 現在の業界実務では、 lift をベースに「support ≥ ε1 ∧ confidence ≥ ε2 ∧ lift ≥ ε3」の 3 重フィルタを通すのが標準的なワークフローとなっており、 さらに「対称性を打破するため confidence や conviction を併用する」「lift の信頼区間をブートストラップで算出する」など、 多面的な品質評価が要求される。 つまりリフト値は単独で完結する指標ではなく、 「アソシエーション解析の入口」として機能する基本指標である、 と位置付けるのが正しい。
📐 リフト値と関連指標の数式マップ
リフト値の周辺には、 同じ「2 つの事象の関連度」を異なる視点から評価する指標が多数存在する。 47 都道府県 SSDSE-B-2026 から「人口 100 万以下 (A)」「高齢化率 30%以上 (B)」のセグメントを取った例で、 主要指標の数式と数値を一覧化する。
| 指標 | 数式 | 47 都道府県値 | 特徴 |
|---|---|---|---|
| Support | P(A∩B) | 0.213 | 頻度のみ、 関連度は不明 |
| Confidence | P(B|A) | 1.000 | 非対称、 予測精度 |
| Lift | P(A∩B)/(P(A)P(B)) | 1.343 | 対称、 独立からの倍率 |
| Leverage | P(A∩B)−P(A)P(B) | 0.054 | 独立からの差、 加算的 |
| Conviction | P(A)P(¬B)/P(A∩¬B) | ∞ | 非対称、 「逆否定」を考慮 |
| Odds Ratio | [P(A∩B)P(¬A∩¬B)]/[P(A∩¬B)P(¬A∩B)] | ∞ | 医学統計の標準、 対称 |
| Relative Risk | P(B|A)/P(B|¬A) | 1.48 | 疫学標準、 非対称 |
| Jaccard Similarity | P(A∩B)/P(A∪B) | 0.286 | 集合の重なり度 |
| Kulczynski | [P(B|A)+P(A|B)]/2 | 0.643 | 双方向の confidence 平均 |
| Cosine Similarity | P(A∩B)/√(P(A)P(B)) | 0.535 | ベクトル空間との対応 |
これら 10 指標を見比べると、 同じ「A と B の関連度」を測っても、 視点が変われば値も変わることが分かる。 例えば lift=1.34 と odds ratio=∞(A⊂B で反例ゼロ)は表現こそ違うが、 どちらも「独立から外れている」ことを示している。 一方、 Support=0.213 は「約 2 割の都道府県でこの組み合わせが起こる」という頻度情報のみで、 関連度はそこからは読み取れない。 実務では「複数指標を組み合わせて多面的に評価する」のが標準であり、 lift だけを見て意思決定をするのは推奨されない。
📊 リフト値計算の Python 拡張パターン
このコードでやること: SSDSE-B-2026 47 都道府県データから、 上記 10 指標を一括で算出する関数を作る。 これにより、 リフト値を含む多面評価が 1 行で得られる。
📥 入力データ: 上記と同じ 47 都道府県データ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd def assoc_metrics(A, B): n = len(A) p_A = A.sum() / n p_B = B.sum() / n p_AB = (A & B).sum() / n p_AnB = (A & ~B).sum() / n p_nAB = (~A & B).sum() / n p_nAnB = (~A & ~B).sum() / n lift = p_AB / (p_A * p_B) if p_A * p_B > 0 else float('inf') conf = p_AB / p_A if p_A > 0 else 0 leverage = p_AB - p_A * p_B conviction = (p_A * (1-p_B)) / p_AnB if p_AnB > 0 else float('inf') odds_ratio = (p_AB * p_nAnB) / (p_AnB * p_nAB) if p_AnB * p_nAB > 0 else float('inf') rel_risk = (p_AB/p_A) / (p_nAB/(1-p_A)) if (1-p_A) > 0 and p_nAB > 0 else float('inf') jaccard = p_AB / (p_A + p_B - p_AB) if (p_A + p_B - p_AB) > 0 else 0 kulczynski = ((p_AB/p_A) + (p_AB/p_B)) / 2 if p_A > 0 and p_B > 0 else 0 cosine = p_AB / ((p_A * p_B) ** 0.5) if p_A * p_B > 0 else 0 return {'support':p_AB, 'confidence':conf, 'lift':lift, 'leverage':leverage, 'conviction':conviction, 'odds_ratio':odds_ratio, 'relative_risk':rel_risk, 'jaccard':jaccard, 'kulczynski':kulczynski, 'cosine':cosine} df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy() df_2023['人口万'] = df_2023['A1101'] / 10000 df_2023['高齢化率'] = df_2023['A1303'] / df_2023['A1101'] * 100 A = df_2023['人口万'] <= 100 B = df_2023['高齢化率'] >= 30 for k, v in assoc_metrics(A, B).items(): print(f'{k:14s}: {v:.3f}') |
📤 実行例:
💬 このセグメントは人口 100 万人以下の 10 県がすべて高齢化率 30%以上(A⊂B)なので、 反例 A∩¬B がゼロ。 そのため conviction・odds_ratio はゼロ除算となり inf(∞)で出力される。 「破られない完全なルール」の極端例であり、 lift=1.34 という控えめな倍率と併せて読むと、 「小規模県では例外なく高齢化が進む」という強い包含構造が見える。 実務では 10 指標を組み合わせ、 「閾値で足切り」「複数指標で上位ルールを抽出」する。
🎓 リフト値を実務で意思決定に統合する 5 段階手順
- Step 1: データ整備。 トランザクション形式に変換し、 各アイテムを 0/1 のフラグに展開する。 列名は意味のある日本語にし、 ETL 段階でクリーニング (重複削除・欠損補完・極端値処理) を実施。 SSDSE-B-2026 のような公的統計の場合は、 元データのメタデータ (調査年度・対象範囲・定義) を必ず確認する。
- Step 2: 探索的アソシエーション分析。 mlxtend や efficient-apriori で頻出アイテムセットを抽出し、 support, confidence, lift の 3 指標を一覧化する。 まずは support ≥ 0.05、 confidence ≥ 0.5、 lift ≥ 1.5 などの緩い閾値で広く見て、 全体像を把握する。
- Step 3: 多指標による絞り込み。 lift だけでなく、 conviction、 odds ratio、 leverage を併用して、 真に意味のあるルールを抽出する。 特に「lift が大きいが support が極小」「lift が中程度だが support が大」のようなトレードオフを意識する。
- Step 4: ドメイン知識による検証。 抽出されたルールについて、 ビジネス側・現場側との対話で「これは既知の事実か」「ノイズか」「新規発見か」を分類する。 既知のルールは検証指標、 新規ルールは仮説として次のステップに進める。
- Step 5: A/B テストによる因果検証。 lift はあくまで関連の指標なので、 「A をプロモーションしたら B も売れる」かは A/B テスト等の介入実験で検証する。 lift=2 のルールが因果でも全くないこともあり、 介入実験を経て初めて「実装すべき施策」となる。
📝 リフト値を使うときのチェックリスト 15 項目
- support ≥ ε1 (たとえば 0.01) を満たしているか
- confidence ≥ ε2 (たとえば 0.5) を満たしているか
- lift ≥ ε3 (たとえば 1.5) を満たしているか
- サンプル数 n が十分か (最低 1,000、 推奨 10,000+)
- 2×2 表の 4 セル全てに十分な頻度があるか
- 「A∧B」だけでなく「¬A∧B」「A∧¬B」「¬A∧¬B」を検討したか
- conviction や odds ratio などの代替指標で検証したか
- lift の 95% 信頼区間をブートストラップで計算したか
- 多重比較補正 (Bonferroni 等) を適用したか
- 時系列スライスでの安定性を確認したか
- 地域・年齢・性別等の層別で「条件付き lift」を見たか
- カテゴリ化の閾値感度を確認したか
- ドメイン専門家にレビューしてもらったか
- A/B テストで因果検証する計画があるか
- ルール抽出パイプラインの再現性 (random_state、 ライブラリバージョン) を担保したか
🌐 リフト値と他分析手法の関係
リフト値は「2 つの 2 値事象の関連度」を測る指標だが、 これを多次元に拡張すると様々な手法と接続する。 たとえば、 多変量カテゴリデータに対しては「対数線形モデル (log-linear model)」がリフト値の自然な拡張であり、 「2 元交互作用」「3 元交互作用」など複雑な依存関係を統一的に扱える。 また、 行列の特異値分解 (SVD) や潜在ディリクレ配分 (LDA) もアイテム間の「共起構造」を捉える点でリフト値の発想と通じる。 機械学習側では、 決定木の split criterion (entropy/gini) は「2 値分割後の情報利得」を測るが、 これも「独立性からの乖離」という観点で lift と等価な情報を抽出している。 つまりリフト値は孤立した指標ではなく、 統計学・情報理論・機械学習の多くの手法が共有する「依存性測定」という共通母体の入口を担っている。
さらに、 近年の Transformer モデルや埋め込み学習においても、 「単語 A と単語 B の共起 lift」が pointwise mutual information (PMI) と同じ式で計算され、 word2vec や GloVe の学習信号の基礎となっている。 つまり、 lift の式 lift = P(A∩B) / (P(A)P(B)) は、 アソシエーション解析・統計検定・自然言語処理・推薦システムなど、 多くの分野で同じ顔をして再登場する。 「lift = PMI = 独立性からの乖離」という見方を持つと、 lift がデータサイエンスの中で持つ普遍的な位置付けが見えてくる。
📚 リフト値のおすすめ学習ロードマップ (30 日プログラム)
Week 1: 確率の復習 (条件付き確率・ベイズ・独立性)、 Apriori アルゴリズムの理解、 mlxtend で実装演習。
Week 2: Support・Confidence・Lift の関係と限界、 多指標 (conviction, leverage, odds ratio) との比較、 SSDSE データで実装。
Week 3: 時系列拡張 (Sequential Pattern Mining)、 多変量拡張 (対数線形モデル)、 因果推論との接続。
Week 4: 実プロジェクトケーススタディ (小売・EC・金融・公共政策)、 A/B テスト連携、 報告書作成演習。
30 日プログラムを完走すると、 lift を中心としたアソシエーション解析を「探索 → 検証 → 介入実験」の 3 段階で実プロジェクトに組み込めるようになる。 lift は決して「終着点」ではなく、 「データの構造を最初に理解する出発点」として位置付けるのが正しい使い方である。
🧩 リフト値を巡るよくある誤解 12 連発と訂正
リフト値は計算式が単純なだけに、 実務現場では誤解や誤用が頻発する。 ここでは典型的な誤解 12 個と、 その訂正・正しい解釈を併記する。 これらを 1 つでも誤解した状態で意思決定の根拠に使うと、 ビジネスインパクトの読み違いやリソースの無駄遣いに直結するので、 チェックリスト的に押さえておく価値が高い。
- 誤解 1: lift > 1 なら必ず良いルール → 訂正: lift だけ高くて support が極小 (=トランザクション 5 件未満等) なら、 単なる偶然・ノイズの可能性大。 support と confidence の同時評価が必須。
- 誤解 2: lift が 100 倍出ているから強い因果関係 → 訂正: lift は対称性を持つので因果方向は判別不能。 大きな lift の裏には「両方が起こりにくいレアな組み合わせ」が隠れているだけのこともある。
- 誤解 3: lift = 1 は無関係なので無視 → 訂正: 確かに統計的には独立に見えるが、 サンプル数が少なければ「独立らしく見える」だけかもしれない。 信頼区間を必ず併記。
- 誤解 4: lift は確率の指標 → 訂正: lift は確率の比 (倍率) であり、 確率そのものではない。 0 から ∞ の範囲をとる。
- 誤解 5: lift は対数を取らずに線形比較してよい → 訂正: 多くのルールを並べて比較するときは log(lift) を取ると分布が対称になり、 比較や可視化が容易になる。
- 誤解 6: lift は時系列に強い → 訂正: lift は時間軸を持たない静的指標。 時系列上の関連を見たければ sequential pattern mining が必要。
- 誤解 7: lift がランキングに使える → 訂正: 上位 N ルールを lift だけで選ぶと、 support の小さい不安定なルールが上位を独占する。 lift × log(support) のような複合スコアを使うのが実務的。
- 誤解 8: lift は機械学習の特徴量として直接使える → 訂正: lift は組み合わせ単位の指標なので、 単一サンプルの予測特徴量には変換が必要。 「このトランザクションに含まれるルールの平均 lift」等の集計が必要。
- 誤解 9: lift は単調変換に対して不変 → 訂正: lift は支持度や信頼度と組み合わせて使われるため、 単独で単調変換しても他指標との関係が崩れる。 元の値を保持するのが原則。
- 誤解 10: lift が高いルールは必ずレコメンドに使える → 訂正: 「すでに買ったものを再度勧める」「カニバリ商品を同時に勧める」などビジネス的に NG なケースがある。 ドメイン知識による事後フィルタが必須。
- 誤解 11: lift は欠損データに頑健 → 訂正: 欠損が「A の欠落」か「B の欠落」かによって lift の値は大きく変動する。 欠損処理 (除外・補完) を必ず明示する。
- 誤解 12: lift は集計粒度に依存しない → 訂正: 「日次」「週次」「月次」で同じデータでも lift は変わる。 集計粒度はビジネス課題に合わせて事前定義する。
👉 これら 12 個の誤解を全て訂正できるレベルでリフト値を扱えれば、 アソシエーション解析の中級者と言える。 さらに上を目指すには、 Bayes 統計の枠組みでリフト値を再定式化する「Bayesian Association Rule Mining」や、 因果推論との結合 (lift を介入効果の代理指標として使う場面の制限) を学んでいくとよい。
🎮 触って理解する — リフト=「独立からの乖離倍率」
リフト値の本質は、 条件付き購買率 P(B|A) を単独で見るのではなく、 ベースライン購買率 P(B) と比べることにあります。 下の 3 本のスライダーを動かすと、 ① ベースラインと条件付き購買率の 2 本のバー、 ② 2×2 分割表のモザイク図、 そしてリフト値がリアルタイムに連動します。 まずプリセット「🍞 人気商品の罠」を押して、 confidence = 70% という一見立派な数字でも lift = 0.875 < 1(=A を買った人はむしろ B を買わない)になる瞬間を体感してください。
💡 深掘り 1 — 直感:confidence は「絶対値」、 lift は「ベースラインとの比」
confidence = P(B|A) は「A を買った人の何 % が B を買うか」という絶対的な割合なので、 B がもともと売れている商品なら、 どんな条件 A を付けても高く出てしまいます。 lift はこの値を独立線 P(B|A) = P(B) で割ることで、 「A という情報が B の購買確率を何倍に押し上げた(押し下げた)か」という乖離の倍率だけを取り出します。 上の図①で、 右のバーが橙色の独立線より飛び出た分が正の関連、 沈んだ分が負の関連。 図②のモザイク図では、 A 列と非 A 列の「B 購入」の高さが独立線からどれだけずれているかが、 そのままリフトの正体です(2 列の高さが揃えば lift = 1)。
⚠️ 深掘り 2 — 落とし穴:confidence 単独の罠と人気商品バイアス
プリセット「人気商品の罠」(P(B) = 0.8、 confidence = 0.7)では、 lift = 0.7 / 0.8 = 0.875 < 1。 モザイク図を見ると、 A 購入者の B 購買率 70% に対して A 非購入者の B 購買率は約 84% — つまり「A を買った人は、 買っていない人よりむしろ B を買わない」負の関連です。 これが confidence 単独の罠:confidence 0.7 という数字だけ見て「強いルール」と報告すると、 実態と逆の推薦をすることになります。 さらに、 confidence でルールを並べ替えると、 後件 B に人気商品を持つルールが条件 A と無関係に上位を独占します(人気商品バイアス)。 実務の定石は、 min_support で希少ルールを落とし、 lift(または leverage)で人気補正をかけ、 confidence で実際の当たり率を確認する3 点セット。 なお lift < 1 のルールは無価値ではなく、 「A 購入者には B を勧めない」「代替品・カニバリゼーションの検出」に使えます。
🚀 深掘り 3 — 発展:相関係数(φ 係数)・オッズ比との関係
図②の 2×2 分割表が確定すれば、 lift・leverage・φ 係数・オッズ比・カイ二乗統計量はすべて同じ表から計算できる親戚です。 leverage = P(A∩B) − P(A)P(B) = P(A)P(B)(lift − 1) であり、 2 値変数どうしの相関係数にあたる φ 係数は φ = leverage / √(P(A)(1−P(A))P(B)(1−P(B)))。 つまり lift > 1 ⇔ leverage > 0 ⇔ φ > 0 で符号は必ず一致し、 違うのは強さの物差しだけです。 一方オッズ比 OR = [P(A∩B)·P(¬A∩¬B)] / [P(A∩¬B)·P(¬A∩B)] は周辺分布(商品の人気度)に依存しない対称指標で、 疫学分野で好まれます。 lift には lift ≤ 1/P(B) という上限がある点も重要:P(B) = 0.8 の人気商品なら lift は最大でも 1.25 で、 構造的に大きな lift が出ません(上のスライダーで P(B) を上げて確認できます)。 関連の統計的有意性はカイ二乗検定で、 ルール抽出の全体像はマーケットバスケット分析とアソシエーションルールで確認してください。
⚠️ よくある落とし穴
🗺 概念マップ
リフト値を中心に、 支持度・確信度 (関連指標)、 Apriori・FP-Growth (アルゴリズム)、 Leverage・Conviction (派生指標) を並べたアソシエーション分析マップ。
リフト値は「A を買った人が B を買う条件付き確率 / B の購買確率」で定義される指標で、 支持度 (support)・確信度 (confidence) と組み合わせて関連ルール (アソシエーション分析) の評価に使う。 概念マップではアプリオリ法・FP-Growth・シーケンシャルパターン分析が周辺手法、 落とし穴は「片方の確率が低すぎる場合のリフト値の過大評価」「独立性検定との混同」など。
🔗 隣接手法への橋渡し
リフト値は支持度と確信度を補正する指標であり、 前段のトランザクションデータ整備と後段のルール選定・可視化を組み合わせて意味あるパターンを抽出する。
- 上流: 前段のトランザクションデータ整備 (アソシエーションルール)
- 並列: 並列のアソシエーション指標 (Leverage・Conviction) (推薦システム) と比較・併用
- 下流: 下流のルール選定・可視化・推薦応用 (ターゲティング分類)
上流のアソシエーション分析 (Apriori/FP-Growth) で頻出アイテム集合を抽出し、 並列の Confidence/Support と組み合わせて 3 指標で同時評価し、 下流の リコメンダ A/B テストで Lift>1 のルールが実際の購入転換率に効くかを検証する流れでマーケット応用が完結する。
🌳 意思決定フローチャート
「リフト値」の 選び方・適用判断をフローで整理。 状況に応じた選択を 4 段階で。