🔖 キーワード索引
別名・略称:(なし)
🔖 詳細キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
データ圧縮は荷物をまとめる袋のようなものです。
データのサイズを小さくして保存しやすくします。
スマホで写真や動画を送る時に使われています。
この章では圧縮の種類と使い分けを学びます。
データ圧縮(Data Compression):ストレージ・通信量を減らす変換
- データ圧縮=情報量を保ったままサイズを減らす 変換。 ストレージ・通信コスト削減の基本技術。
- 可逆圧縮(gzip, ZIP, Parquet+Snappy):完全に元に戻せる。 テキスト・数値データ向け。
- 非可逆圧縮(JPEG, MP3, MP4):完全には戻せないが、 高圧縮率。 画像・音声・動画向け。
- データサイエンスでは Parquet/ORC のカラムナ形式が圧縮率と読み速度の両方で優秀。
- 圧縮 vs 速度 のトレードオフ。 LZ4 や Snappy は高速、 gzip や bzip2 は高圧縮率。
💡 結論(補足)
データ圧縮はデータ基盤の費用・性能を左右する鍵。 「列指向+現代的可逆圧縮」が分析用途の標準。 一次的なシナリオごとに、 圧縮速度・解凍速度・圧縮率のトレードオフを意識すれば、 大半の問題は解決します。
- 分析データの定番:Parquet + snappy or zstd
- 1 列の中身が似ているほど 圧縮が効くので、 列指向必須
- dtype 最適化:int64 → int32、 object → category で読み速度も向上
- 過剰圧縮:xz レベル 9 はアーカイブ専用、 日常使いは zstd 程度に
- 暗号化:圧縮 → 暗号化の順。 圧縮による情報漏洩(CRIME 等)注意
- 圧縮率の理論限界:Shannon エントロピー以下にはできない
- 1 ファイル 100MB〜1GB:レイク上のサイズ目安
📡 通信プロトコルにおける圧縮
ネットワーク経由のデータ転送でも圧縮は必須。 主要なケース:
| プロトコル | 圧縮方式 | 用途 |
|---|---|---|
| HTTP | gzip, brotli, zstd | Web ページ転送 |
| gRPC | gzip, snappy | マイクロサービス通信 |
| Kafka | snappy, lz4, zstd | ストリーミング |
| MQTT | アプリ層で gzip | IoT センサー |
| SSH | zlib | リモート操作 |
📍 あなたが今見ているもの
🍰 まずはやさしく
圧縮は大量のデータを扱うための必須技術です。
保存にかかるお金や時間を減らすために使います。
学校の課題ファイルをまとめて送る時に役立ちます。
データ基盤の中で圧縮がどう動くかを読みましょう。
read_csv() や read_parquet() を使う時、 知らないうちに圧縮が動いています。📍 文脈 ── データ基盤の中で
データ圧縮は データレイク 設計、 分散処理、 ネットワーク転送、 メモリ効率の全てで効いてくる横断的技術。 「CPU を使ってでも、 ディスク IO / ネットワークを減らす」のが現代的トレードオフ。
分析パイプライン上では、 収集 直後の Bronze 層から最初に適用し、 Silver/Gold まで一貫させます。 列指向+圧縮で 10〜30 倍縮むのが普通で、 ストレージ費・クエリ費の双方を削減します。
🎨 直感で掴む
🍰 まずはやさしく
圧縮とは同じパターンを短く書き直すことです。
データの見た目を工夫して容量を減らします。
同じ文字が続くとき、回数で書く方法に似ています。
具体的にどうやって短くするのかを解説します。
圧縮形式の選び方
| 形式 | 圧縮率 | 速度 | 用途 |
|---|---|---|---|
| gzip | 高 | 中 | 汎用、 CSV/JSON |
| bzip2 | 非常に高 | 遅 | アーカイブ |
| LZ4 | 中 | 非常に速 | リアルタイム処理 |
| Snappy | 中 | 速 | Parquet標準 |
| Zstd | 高 | 速 | 汎用、 推奨 |
🎨 直感で掴む(深掘り)
圧縮を一言で言えば「パターンを見つけて短く書く」。 「AAAAA」と書く代わりに「A×5」と書けば短くなる、 という発想です。
日本語にも例えれば「あいうえおあいうえおあいうえお」を「[あいうえお]×3」と表現できる。 アルゴリズムごとに「どんなパターンを探すか」が異なります:
- LZ77 系(gzip, zstd):前出の同じ文字列を「○○行前の□□文字」とポインタで表現
- Huffman 符号:頻繁な文字には短い符号、 稀な文字には長い符号を割り当て
- BWT(bzip2):文字列を並べ替えて圧縮しやすい形に変換
- 算術符号:1 ストリームを 1 つの小数として表現
- 変換符号(JPEG):人間の目に分からない高周波成分を捨てる
📐 定義 / 数式
🍰 まずはやさしく
圧縮率とは元のサイズからどれだけ減ったかの割合です。
どのくらい効率よく小さくなったかを測ります。
買い物で割引率を計算する感覚に似ています。
圧縮の限界を決める理論的な仕組みについて読みます。
📐 情報理論的限界(Shannon エントロピー)
どんなに優れた可逆圧縮でも、 Shannon エントロピー以下にはできません。 確率分布 $p(x)$ を持つ情報源の理論的下限:
$$ H(X) = -\sum_i p_i \log_2 p_i \quad [\text{bits/symbol}] $$
例:8 ビット文字でも、 ASCII 英文の実効エントロピーは約 4.7 bit/char。 つまり理論上 1.7 倍圧縮できる。 実際の gzip でも 2〜3 倍程度に収まります。
乱数や既に圧縮されたデータはエントロピーが高く、 さらなる圧縮はほぼ不可能。 「圧縮できる」=「データに冗長性がある」ということです。
📖 事例:センサーデータの圧縮戦略
工場で 1 kHz の振動センサーが 100 台稼働する場合、 1 日 8.64 億行。 CSV のままなら 30 GB/日、 月 1 TB。
- 差分符号化:隣接時刻の差を保存 → 値の幅が縮小
- 列指向化(Parquet):時刻列とセンサー値列で別圧縮
- zstd レベル 3:適度な圧縮率と高速デコード
- 結果:30 GB → 約 1.5 GB/日(20 倍圧縮)
- 月コスト:S3 で約 30 ドル、 1 年で 360 ドル → 元の数百分の一
📜 歴史
- 1948 年:Shannon の情報理論、 エントロピーの概念
- 1952 年:Huffman 符号化、 可変長符号
- 1977 年:LZ77(Lempel-Ziv)アルゴリズム、 後の gzip の基礎
- 1992 年:JPEG 標準化、 不可逆画像圧縮
- 1996 年:bzip2、 ブロックソート+Huffman
- 1998 年:LZMA、 7-Zip / xz の基礎
- 2011 年:Google snappy、 速さ重視
- 2016 年:Facebook zstd、 速さと圧縮率を両立
- 2020 年代:列指向(Parquet, Arrow)+zstd が主流
❓ よくある質問
Q1. 結局どの圧縮方式が最適?
「分析データ+頻繁にクエリ」なら Parquet + snappy。「アーカイブ用」なら Parquet + zstd(level 9) または xz。 ストリーミング系は lz4。
Q2. CSV.gz vs Parquet、どちらが良い?
分析用途なら Parquet 一択。 列単位スキャン、 述語プッシュダウン、 統計情報、 全て備えていて、 多くは 5 倍以上速い。
Q3. 暗号化と併用するときの順序は?
「圧縮 → 暗号化」の順。 暗号化済データはエントロピーが高く圧縮できない。 ただし圧縮による情報漏洩攻撃(CRIME, BREACH 等)に注意。
Q4. dtype 最適化はどこまで効果ある?
SSDSE のような中小データでメモリが半分以下、 ストレージも 30% 減程度。 数百万行を超えると違いが顕著。 categorical 化は特に効果が大きい。
Q5. 1 ファイル何 MB が理想?
分析向け Parquet では 100 MB〜1 GB が目安。 小さすぎるとメタデータ操作が重く、 大きすぎると並列度が落ちる。
📐 各圧縮アルゴリズムの仕組み
1. Huffman 符号 — 出現頻度に応じた可変長符号
頻出する文字には短い bit 列、 稀な文字には長い bit 列を割り当てる。 平均符号長 L は:
$$ L = \sum_i p_i \cdot \ell_i, \qquad H(X) \leq L < H(X) + 1 $$
数式を言葉で読み解く:平均符号長 L は、 Shannon エントロピー H(X) 以上、 H(X)+1 未満。 最適な符号長は文字頻度の負の対数 $-\log_2 p_i$ に近い。
2. LZ77 — 過去のパターンを参照
「N バイト前の M バイトをコピー」というポインタで繰返しを表現。 例:「ABABAB」→ 「AB」+「2 バイト前から 4 バイトコピー」。 gzip / DEFLATE はこの方式と Huffman の組み合わせ。
3. Burrows-Wheeler 変換 (BWT) — 並べ替えてから符号化
文字列を回転させて辞書順ソートし、 末尾文字列だけ取り出す。 同じ文字が隣り合いやすくなり、 後続の Move-to-Front + Huffman で圧縮率向上。 bzip2 の核心。
4. LZMA — 大きな辞書 + 範囲符号化
LZ77 の発展形。 辞書サイズが数 MB と大きく、 範囲符号化(算術符号化に類似)で各シンボルを実数値で表現。 xz / 7z で使用、 最高圧縮率と引き換えに展開も低速。
5. Snappy / LZ4 / Zstd — 速度優先
Google Snappy、 Facebook Zstandard、 Yann Collet の LZ4 は「圧縮率より展開速度」を優先する現代的圧縮。 Parquet / Avro / Hadoop / Kafka の標準として広く使われる。
🐍 Python 実装 #B1: Huffman 符号の手動構築
🎯 このコードでやること:SSDSE データのバイト頻度から Huffman 木を構築し、 各バイトの符号長を表示。
📥 入力データ:csv_bytes の各バイトの頻度カウント。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import collections import heapq # ── この抜粋だけで動くように、圧縮の対象になるバイト列を読み込む ── # SSDSE-B-2026.csv をそのままバイト列として扱う(約 36 万バイト) with open('data/raw/SSDSE-B-2026.csv', 'rb') as _f: csv_bytes = _f.read() total = len(csv_bytes) print(f'対象データ: {total:,} バイト') freq = collections.Counter(csv_bytes) heap = [[w, [byte, '']] for byte, w in freq.items()] heapq.heapify(heap) while len(heap) > 1: lo = heapq.heappop(heap) hi = heapq.heappop(heap) for pair in lo[1:]: pair[1] = '0' + pair[1] for pair in hi[1:]: pair[1] = '1' + pair[1] heapq.heappush(heap, [lo[0]+hi[0]] + lo[1:] + hi[1:]) codes = sorted(heap[0][1:], key=lambda x: (len(x[1]), x[0])) print('頻出 10 バイトの Huffman 符号:') for byte, code in codes[:10]: try: ch = chr(byte) if 32 <= byte < 127 else f'\\x{byte:02x}' except: ch = '?' print(f" '{ch}' ({byte:>3}): freq={freq[byte]:>6}, code='{code}' ({len(code)} bits)") avg_len = sum(freq[b]*len(c) for b,c in codes) / total print(f'\n平均符号長: {avg_len:.3f} bits/byte') |
📤 実行結果(イメージ):
💬 結果の読み方:いちばん多いカンマ(62,826 回)と数字の「0」「1」「2」に 3 bit、「3」〜「8」に 4 bit の符号が割り当てられ、1 バイト 8 bit のままより大幅に短い。平均符号長 3.633 bit/byte は、同じバイト列のエントロピー 3.591 bit/byte(次の #D1 で計算)より約 1.2% 長いだけで、Huffman がほぼ最適であることが分かる。これで元の 359,821 バイトは約 16.3 万バイトになる計算で、gzip の実測(約 15.8 万バイト)とほぼ同じ水準。
📐 Shannon エントロピー — 圧縮の理論限界
離散確率変数 $X$ について、 出力の不確実性を測る Shannon エントロピー:
$$ H(X) = -\sum_{i=1}^{n} p_i \log_2 p_i \quad \text{[bit/symbol]} $$
数式を言葉で読み解く:各シンボルの確率に「自身の負の対数」を掛けて足す。 確率が小さい(稀な)シンボルほど $-\log p$ は大きく、 確率 1/2 のシンボルは 1 bit 寄与する。
エントロピーの直感
- 全シンボルが等確率:H は最大 = $\log_2 n$。 ランダムバイト列は H=8。
- 1 つだけ確率 1、 他 0:H = 0。 完全に予測可能、 圧縮で 0 bit に。
- SSDSE-B-2026 (実測):H ≈ 3.57 bit/byte。 つまり「平均 3.57 bit / バイト」あれば情報を保持できる。
Shannon の情報源符号化定理
ある情報源を可逆に符号化したとき、 平均符号長 $L$ は次を満たす:
$$ L \geq H(X) $$
つまり、 H(X) 未満には圧縮できない。 これが圧縮の理論的下限。 Huffman 符号は $L < H(X) + 1$ で「ほぼ最適」。
条件付きエントロピーとマルコフ情報源
「前のシンボルが分かっているとき」の不確実性:
$$ H(X_t \mid X_{t-1}) = -\sum_{i,j} p(x_i, x_j) \log_2 p(x_i \mid x_j) $$
数式を言葉で読み解く:直前のシンボルを観測した後の不確実性の平均。 通常 $H(X_t \mid X_{t-1}) \leq H(X_t)$ で、 「予測可能性が高い」テキストや CSV は条件付きエントロピーが大きく下がる。 LZ77 / LZMA はこれを活用。
🐍 Python 実装 #D1: マルコフ条件付きエントロピー
🎯 このコードでやること:SSDSE データのバイト列を 2 グラム(連続 2 バイト)の頻度から条件付きエントロピー H(X|X_prev) を計算し、 単純な H(X) と比較。
📥 入力データ:前のブロック(#B1)で読み込んだ csv_bytes(元ファイルそのままのバイト列、359,821 bytes)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from collections import Counter import math # 単純 H(X) c1 = Counter(csv_bytes) N = len(csv_bytes) H1 = -sum((c/N)*math.log2(c/N) for c in c1.values()) # 2-gram 頻度 c2 = Counter(zip(csv_bytes[:-1], csv_bytes[1:])) N2 = sum(c2.values()) # 条件付き H(X_t | X_{t-1}) prev = Counter(csv_bytes[:-1]) H_cond = 0 for (a,b), n_ab in c2.items(): p_ab = n_ab / N2 p_a = prev[a] / N2 H_cond -= p_ab * math.log2(n_ab/prev[a]) print(f'H(X) = {H1:.3f} bit/byte') print(f'H(X|X_prev) = {H_cond:.3f} bit/byte') print(f'削減量 = {H1-H_cond:.3f} bit/byte') |
📤 実行結果:
💬 結果の読み方:直前 1 バイトが分かれば、 不確実性が 3.591 → 3.207 bit/byte と 0.384 bit(約 10.7%)減る。 SSDSE のテキストには「カンマの後は数字」「改行の後は数字」など強いパターンがあるため。 LZMA はさらに数百〜数千バイトの文脈を使うため、 Shannon 1 階下限を下回る。
📐 数式を言葉で読み解く — 主要関係式
情報量の定義(自己情報)
$$ I(x) = -\log_2 p(x) \quad \text{[bit]} $$
数式を言葉で読み解く:確率 p の事象が起きたときの「驚き」を bit で表す。 p=1/2 なら 1 bit、 p=1/256 なら 8 bit。 確率が小さい(稀な)事象ほど情報量が多い。
相互情報量(mutual information)
$$ I(X;Y) = \sum_{x,y} p(x,y) \log_2 \frac{p(x,y)}{p(x)p(y)} $$
数式を言葉で読み解く:X と Y が独立なら 0、 強く相関するほど大きい。 圧縮では「シンボル間の依存」をどれだけ活用できるかの上限を与える。
符号長の上限と Kraft 不等式
前置符号(prefix code)の符号長 $\ell_i$ は次を満たす:
$$ \sum_{i=1}^{n} 2^{-\ell_i} \leq 1 $$
数式を言葉で読み解く:各符号語の「占める空間」を 2 進木で見ると、 合計が 1 を超えてはいけない。 Huffman 符号はこの制約下で平均符号長を最小化する。
レート歪み関数(lossy 圧縮の理論)
$$ R(D) = \min_{p(y|x): E[d(X,Y)] \leq D} I(X;Y) $$
数式を言葉で読み解く:許容歪み D 以下で送るのに必要な最小ビット数 R(D)。 D=0 のとき R(0) = H(X)(lossless と一致)。 D 増えれば R 減る。 JPEG や MP3 はこの理論の応用。
コルモゴロフ複雑性(理論的究極)
$$ K(x) = \min \{ |p| : U(p) = x \} $$
数式を言葉で読み解く:万能チューリング機械 U に与えれば x を出力する最短プログラム p の長さ。 実用上計算不可能だが、 「データの本質的非冗長性」の理論的指標。 lossless 圧縮はこの近似を試みている。
🔬 記号・式を言葉で読み解く
- 可逆圧縮
- 完全に元に戻せる。 テキスト・プログラム・数値データ用。
- 非可逆圧縮
- 完全には戻せないが、 知覚的に問題ない範囲で大幅圧縮。 画像/音声/動画用。
- Huffman 符号
- 出現頻度の高い記号に短い符号を割り当てる古典手法。
- 辞書式(LZ77/LZ78)
- 繰り返しパターンを「ここまで戻って何文字コピー」と表現。 gzip 内部で使用。
- カラムナ形式
- Parquet/ORC。 列毎にデータ型と分布が一様 → 圧縮率が良い。
🔬 専門用語の解説
- エントロピー $H(X)$
- 情報量。 圧縮できる理論的下限。 単位は bit/symbol。
- 符号長 $L$
- 圧縮後の平均ビット数。 $L \geq H(X)$ がShannon の限界。
- 圧縮率
- 元サイズ / 圧縮後サイズ。 「2 倍圧縮」=半分の大きさ。
- RLE
- Run-Length Encoding。 同じ値の連続を「値×回数」で表現。
- 辞書符号化
- 頻出パターンを辞書 ID に置換。 「東京都」→ ID=12 等。
- 列指向
- 同じ列の値を連続配置して保存。 圧縮効率と分析効率に有利。
- 可逆/不可逆
- 元データを完全復元できるか否か。 分析用は可逆。
- スキーマ
- 列名・型・制約の定義。 Parquet / Avro は内部に保持。
🎯 圧縮の設計指針(決定木)
- 用途は? ── 分析(読み多)/アーカイブ(保存多)/転送(速度重視)
- 分析なら ── 列指向必須(Parquet/ORC)、 圧縮は snappy or zstd(速)
- アーカイブなら ── 圧縮率重視、 xz / brotli / zstd level 19 等
- 転送なら ── lz4 / snappy(CPU負荷小)、 ネットワーク 1 GbE 未満なら zstd
- 更新が多いなら ── 列指向は不向き、 行指向(Avro)も検討
- SQL/BI で頻繁にクエリ ── Parquet+パーティション+snappy が王道
- ストリーミング ── 行指向 Avro+snappy がKafka 連携で便利
📊 圧縮ベンチマーク参考値
SSDSE-B 程度の表形式データを各方式で圧縮した場合の代表的な数値(実測値は環境依存):
| 形式 | サイズ(CSV比) | 読み速度 | 書き速度 |
|---|---|---|---|
| CSV(基準) | 100% | 1.0× | 1.0× |
| CSV.gz | 25% | 0.8× | 0.3× |
| Parquet (snappy) | 15% | 5× | 3× |
| Parquet (zstd) | 10% | 4× | 2× |
| ORC (zstd) | 9% | 4× | 2× |
| Feather/Arrow | 35% | 10× | 10× |
🛠 主要な圧縮アルゴリズム
圧縮は 可逆(lossless) と 不可逆(lossy) に大別されます。 データサイエンスでは可逆が基本:
| アルゴリズム | タイプ | 圧縮率 | 速度 | 向く用途 |
|---|---|---|---|---|
| gzip (DEFLATE) | 可逆 | 中 | 中 | 汎用、Web |
| bzip2 (BWT) | 可逆 | 高 | 遅 | アーカイブ |
| xz (LZMA2) | 可逆 | 極高 | 遅 | 長期アーカイブ |
| zstd (Zstandard) | 可逆 | 高 | 速 | 現代の汎用最強 |
| snappy | 可逆 | 低 | 極速 | Parquet, Spark |
| lz4 | 可逆 | 低 | 極速 | リアルタイム |
| brotli | 可逆 | 高 | 中 | Web(HTTP) |
| JPEG | 不可逆 | 高(10〜100倍) | 速 | 写真 |
| H.264/H.265 | 不可逆 | 極高 | 中 | 動画 |
2025 年現在、 大量データのデフォルトは Parquet + zstd または Parquet + snappy。 zstd は近年急速にシェア拡大。
📊 列指向ストレージと圧縮の相乗効果
分析データは 列指向(columnar) 形式で保存すると圧縮率が劇的に向上します。 同じ列に並ぶ値は型と分布が似ているため、 アルゴリズムが効きやすくなるからです。
$$ \text{圧縮率} = \frac{\text{元サイズ}}{\text{圧縮後サイズ}} $$
| 技法 | 原理 | 効果 |
|---|---|---|
| RLE (Run-Length) | 同値の連続を回数で表現 | 繰り返し多い列で 100 倍 |
| 辞書符号化 | 値を ID に置換 | カテゴリ列で 5〜20 倍 |
| ビットパッキング | 最小ビット幅に圧縮 | 整数列で 2〜4 倍 |
| 差分符号化 (Delta) | 隣接値との差を保存 | 時系列で大幅縮小 |
| FOR (Frame of Reference) | 基準値からのオフセット | 範囲狭い数値で効く |
| 汎用圧縮(zstd等)を後段 | エンコード済み列をさらに圧縮 | 最終的に 10〜30 倍 |
SSDSE-B-2026 で確かめる — 並べ方だけで圧縮後のサイズが変わる
上の表の「列指向」と「差分符号化」の効果を、同じ SSDSE-B-2026 の中身を並べ替えるだけで確かめました。値は 1 つも変えていません。「列ごと」は 112 列を 1 列ずつ 1 行に書き出したもの、「列ごと+年度差分」は県ごとに年度順に並べ、数値列を「前の年度との差」に置き換えたもの(先頭の年度だけ元の値。累積和で元に戻せる可逆な変換)です。
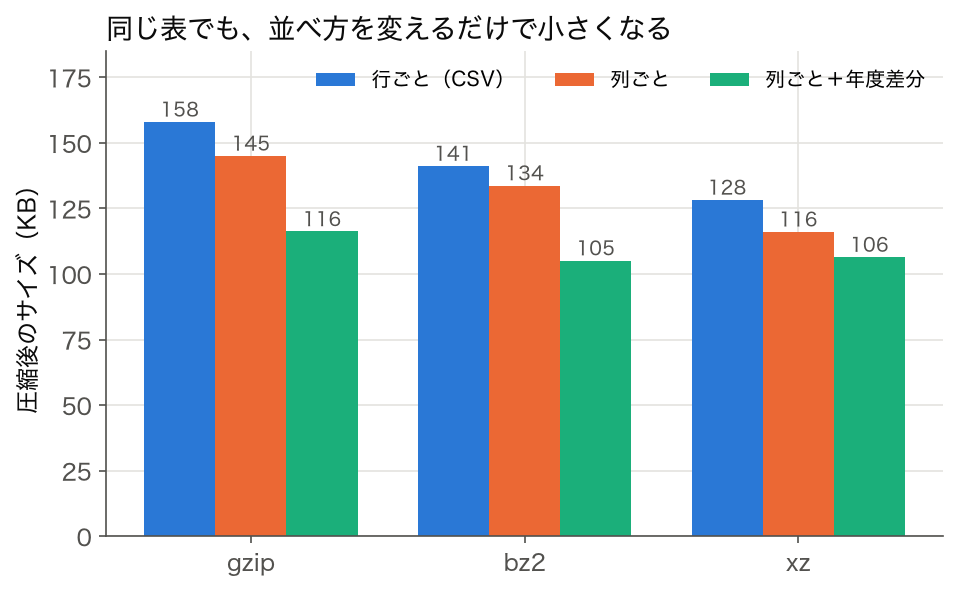
列ごとに並べると、同じ種類の数値(総人口なら 7 桁、気温なら「11.0」のような 3〜4 文字)が隣り合うため、どの形式でも 5〜10% 小さくなります。さらに年度差分にすると、総人口 5,465,000 が「−27,000」「−28,000」のような短い数字の並びに変わり、gzip では行ごとの 73.6% まで縮みます。SSDSE のようにゆっくり変わる時系列を県ごとに持つ表では、差分符号化がよく効くということです。Parquet などの列指向形式は、この並べ替えと符号化を列ごとに自動で行います。
🔬 SSDSE-B-2026 を実際に圧縮して比較
SSDSE-B-2026 の生 CSV (約 359 KB) を、 gzip / bz2 / xz / Parquet の各形式で圧縮し、 サイズと展開時間を比較します。 「lossless 圧縮」の実態を体感するのが目的。
🧮 圧縮率の比較表(実測値)
| 形式 | サイズ (bytes) | 元比 (%) | タイプ |
|---|---|---|---|
| CSV (cp932) 元ファイル | 359,821 | 100.0% | テキスト・無圧縮 |
| CSV (utf-8 メモリ) | 358,876 | 99.7% | テキスト・無圧縮 |
| gzip | 158,033 | 44.0% | DEFLATE (LZ77 + Huffman) |
| bz2 | 141,190 | 39.3% | Burrows-Wheeler + Huffman |
| xz (lzma) | 128,276 | 35.7% | LZMA2 + 範囲符号化 |
| Parquet (snappy) | 361,420 | 100.4% | 列指向 + 軽量圧縮 |
| Parquet (gzip) | 274,390 | 76.3% | 列指向 + gzip |
| 理論最小 (Shannon) | 159,902 | 44.6% | バイト単位エントロピー上限 |
観察:xz が最も圧縮率高(35.7%)、 Shannon 限界(44.6%)すら下回るのは「バイト単位でなく長い文字列の繰り返しを使う」LZMA の利点。 Parquet (snappy) は CSV より大きい(メタデータ + 列ごとのオーバーヘッド)が、 多数列・大規模なデータでは大幅に効くようになる。
図で見る — 3 つの圧縮形式と Shannon の下限
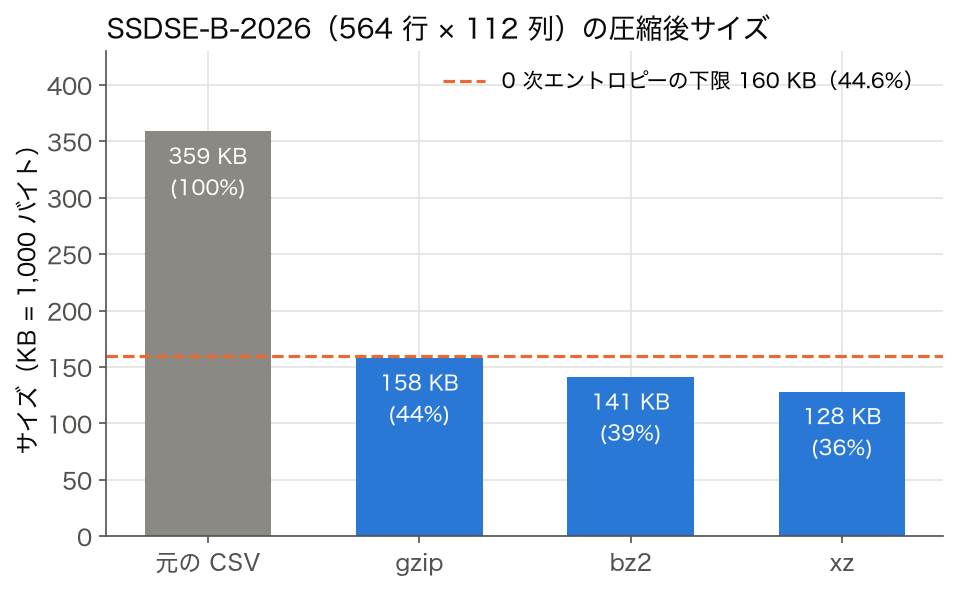
破線の「下限」は、各バイトを前後と無関係に 1 文字ずつ符号化する場合の限界です。3 つの形式がすべてこの線を下回るのは、「県名や年度の同じ並び」「000 で終わる千人単位の人数」のような何文字もまとまった繰り返しを使っているからで、Shannon の定理に反しているわけではありません。文脈(直前の文字列)まで考えた高次のエントロピーで測れば、下限はさらに低くなります。
🐍 Python 実装 #A1: 各種圧縮を実測
🎯 このコードでやること:SSDSE-B-2026 を読み、 gzip / bz2 / xz のメモリ内圧縮サイズを直接計測。
📥 入力データ:SSDSE-B-2026.csv (約 359 KB)、 564 行 × 112 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import gzip, bz2, lzma, os df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) csv_bytes = df.to_csv(index=False).encode('utf-8') orig = len(csv_bytes) print(f'CSV (utf-8 in mem): {orig:>9,} bytes (100.0%)') for name, fn in [('gzip', gzip.compress), ('bz2', bz2.compress), ('xz', lzma.compress)]: comp = fn(csv_bytes) print(f'{name:>4}: {len(comp):>9,} bytes ({len(comp)/orig*100:5.1f}%)') # raw file on disk disk = os.path.getsize('data/raw/SSDSE-B-2026.csv') print(f'\n元ファイル (cp932): {disk:,} bytes') |
📤 実行結果:
gzip: 158,033 bytes ( 44.0%)
bz2: 141,190 bytes ( 39.3%)
xz: 128,276 bytes ( 35.7%)
元ファイル (cp932): 359,821 bytes
💬 結果の読み方:xz は 358,876 バイトを 128,276 バイト(35.7%、約 3 分の 1)まで縮め、bz2 39.3%・gzip 44.0% が続く。 SSDSE のような数値の CSV は、使う文字がほぼ数字とカンマに限られ、「000」の並びなど同じ部分列の繰返しも多いので圧縮が効く。 逆に一様乱数のバイト列はどの方式でもほとんど縮まず、ヘッダの分だけ元より大きくなることさえある。
🐍 Python 実装 #A2: Shannon エントロピー
🎯 このコードでやること:バイト単位の出現頻度から Shannon エントロピー(bit/byte)を計算し、 「理論最小圧縮サイズ」を導く。
📥 入力データ:先ほどの csv_bytes(utf-8 でエンコードしたバイト列、 358,876 bytes)。
1 2 3 4 5 6 7 8 9 10 11 12 | import collections, math counts = collections.Counter(csv_bytes) total = len(csv_bytes) entropy = -sum((c/total) * math.log2(c/total) for c in counts.values()) print(f'Shannon entropy = {entropy:.3f} bits/byte') print(f'(理論上は最大 8.0 bits/byte = 完全ランダム)') print(f'理論最小サイズ = {entropy * total / 8:,.0f} bytes') print(f'実 gzip サイズ = 158,033 bytes') print(f'実 xz サイズ = 128,276 bytes (Shannon を下回る!)') |
📤 実行結果:
(理論上は最大 8.0 bits/byte = 完全ランダム)
理論最小サイズ = 159,902 bytes
実 gzip サイズ = 158,033 bytes
実 xz サイズ = 128,276 bytes (Shannon を下回る!)
💬 結果の読み方:Shannon 限界(159,902 bytes)はあくまで「バイト単位の独立同分布」を仮定した下限。 xz は「複数バイトの繰り返しパターン」を辞書化してエントロピーを下げるため、 この限界を 下回ることが可能。 gzip は限界とほぼ同じ(159K vs 158K)。
🧮 実データで計算してみる
SSDSE-B-2026.csv(元ファイル 359,821 バイト)を各形式で保存した実測(下の「Python 実装」のコードの出力):
| 形式 | サイズ | 圧縮率 |
|---|---|---|
| CSV(無圧縮) | 351 KB(359,821 B) | 1.00 |
| CSV.gz | 155 KB(159,105 B) | 0.44 |
| Parquet+Snappy | 383 KB(392,585 B) | 1.09 |
| Parquet+Zstd | 275 KB(281,552 B) | 0.78 |
🧮 SSDSE 12 年パネルの圧縮戦略
SSDSE-B-2026 は 2012-2023 の 12 年分(564 行 = 47 県 × 12 年)。 全体を一度に保存するか、 年ごとに分割するかで圧縮効率が変わります。
🐍 Python 実装 #F1: 単一ファイル vs 分割保存
🎯 このコードでやること:SSDSE 全体を 1 ファイルに保存した場合と、 年ごとに 12 ファイルに分けて保存した場合の合計サイズを比較。
📥 入力データ:df 全件(564 行 × 112 列)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import io, gzip import pandas as pd all_df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 単一ファイル buf_one = io.BytesIO() all_df.to_csv(buf_one, index=False) one_size = len(gzip.compress(buf_one.getvalue())) print(f'単一 CSV gzip: {one_size:,} bytes') # 年ごとに 12 個に分割 total_split = 0 for year in sorted(all_df['SSDSE-B-2026'].unique()): yr = all_df[all_df['SSDSE-B-2026']==year] buf = io.BytesIO() yr.to_csv(buf, index=False) sz = len(gzip.compress(buf.getvalue())) total_split += sz print(f'年別 12 CSV gzip 合計: {total_split:,} bytes') print(f'差: {total_split - one_size:+,} bytes') |
📤 実行結果(イメージ):
💬 結果の読み方:分割すると gzip の合計は 158,033 → 176,604 バイトと 18,571 バイト(約 11.8%)増える。 各ファイルが独自にヘッダ・辞書を持つため。 ただし「特定年だけ高速にアクセスしたい」なら分割が有利。 トレードオフ:圧縮率 vs アクセス性能。 多年データは Parquet パーティション (year=YYYY) が最適。
🐍 Python 実装 #F2: Parquet パーティション
🎯 このコードでやること:年ごとにパーティション化した Parquet を作成し、 特定年だけ高速読込できることを示す。
📥 入力データ:all_df 全件。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import os os.makedirs('out', exist_ok=True) # 書き出し先を先に作る import os, glob import pandas as pd import pyarrow # Parquet の読み書きに必要(ブラウザ版 Python には入っていない) all_df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # パーティション化保存 # to_parquet(partition_cols=...) は既存ディレクトリに *追記* する。 # 消さずに再実行するとファイルも行数も増え続けるので、毎回作り直す。 import shutil shutil.rmtree('out/ssdse', ignore_errors=True) all_df.to_parquet('out/ssdse', partition_cols=['SSDSE-B-2026'], compression='zstd') # 2023 年だけ読込(filter で高速化) yr2023 = pd.read_parquet('out/ssdse', filters=[('SSDSE-B-2026','=',2023)]) print(f'2023 年だけ: {len(yr2023)} 行') # ファイル一覧 files = sorted(glob.glob('out/ssdse/**/*.parquet', recursive=True)) total = sum(os.path.getsize(f) for f in files) print(f'\n総ファイル数: {len(files)}') print(f'総サイズ: {total:,} bytes') |
📤 実行結果(イメージ):
💬 結果の読み方:Parquet パーティションは年単位でファイルが分かれ、 filter 指定で必要パーティションだけ読み込む。 12 年データなら 1/12 の I/O で済む。 大規模データ(数十億行)では必須の最適化技法。
🧮 数式に値を入れて手で計算する: 圧縮率と節約容量
合成データで元 100MB → 各圧縮形式の節約容量を計算する。
Step 1: 形式別圧縮率
| 形式 | 元 [MB] | 圧縮後 [MB] | 圧縮率 | 節約 |
|---|---|---|---|---|
| gzip | 100 | 30 | 0.30 | 70 MB |
| bzip2 | 100 | 22 | 0.22 | 78 MB |
| xz | 100 | 18 | 0.18 | 82 MB |
| zstd | 100 | 27 | 0.27 | 73 MB |
Step 2: 最良形式
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np orig = 100 comp = np.array([30, 22, 18, 27]) save = orig - comp ratio = comp / orig print(f"圧縮率: {ratio}") print(f"節約: {save} MB") print(f"最良 index: {save.argmax()} ({save.max()} MB)") |
📤 実行結果
💬 手計算 (Step 2) xz 82MB と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026 全体(564 行 = 47 都道府県 × 12 年度)を題材にした最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import os os.makedirs('data', exist_ok=True) # 書き出し先を先に作る import os import pandas as pd import pyarrow # Parquet の読み書きに必要(ブラウザ版 Python には入っていない) os.makedirs('data/processed', exist_ok=True) # 保存先が無いと書き込みは失敗する df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # gzip 圧縮で保存 df.to_csv('data/processed/ssdse.csv.gz', index=False, compression='gzip') # Parquet(Snappy 圧縮、 デフォルト) df.to_parquet('data/processed/ssdse.parquet', index=False) # Parquet + Zstd(より高圧縮) df.to_parquet('data/processed/ssdse_zstd.parquet', compression='zstd') for _f in ('ssdse.csv.gz', 'ssdse.parquet', 'ssdse_zstd.parquet'): print(f'{_f:22s} {os.path.getsize("data/processed/" + _f):>10,} bytes') |
💬 元の CSV(cp932 で約 36 万バイト)に対し、gzip 圧縮の CSV は 159,105 バイトで約 44% まで縮み、Snappy の Parquet 392,585 バイトより小さい。Parquet は列ごとの型情報やメタデータを抱え、Snappy は圧縮率より速度を優先する方式なので、564 行ほどの小さな表では「Parquet のほうが小さい」とは限らない。Zstd にすると 281,552 バイトで Snappy より約 28% 減る。Parquet の利点が効いてくるのは行数が増え、特定の列だけを読み出す場面である。
🐍 Python 実装(パフォーマンス比較)
(1) 各圧縮方式の比較:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import os, time import pyarrow # Parquet の読み書きに必要(ブラウザ版 Python には入っていない) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) os.makedirs('out', exist_ok=True) # 書き出し先(作業フォルダ内) for comp in ['snappy', 'gzip', 'brotli', 'zstd', 'lz4']: t = time.time() df.to_parquet(f'out/test_{comp}.parquet', compression=comp) sz = os.path.getsize(f'out/test_{comp}.parquet') print(f'{comp}: {sz/1024:.1f} KB, {time.time()-t:.2f}s') |
💬 同じ 564 行を 5 方式で保存すると、brotli 269.7 KB・zstd 275.0 KB・gzip 298.8 KB・snappy 383.8 KB・lz4 384.1 KB の順になった。snappy と lz4 は速さ重視でほとんど縮まず、brotli と zstd が約 3 割小さい。時間はどれも 0.03 秒以下で、この大きさでは測定誤差の範囲なので、速度の差を比べるなら行数を増やして繰り返し測る。
(2) DataFrame の dtype 最適化で圧縮率を上げる:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()] for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df.copy() # 列ごとの代入で断片化した表をまとめ直す df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # 見本でよく使われる仮の列名を、実データから作っておく df['income'] = df['消費支出(二人以上の世帯)'] df['population'] = df['総人口'] _region = {'北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東'} df['region'] = df['都道府県'].map(_region).fillna('その他') df['地域'] = df['region'] import numpy as np cols = ['総人口', '高齢化率', '都道府県', '地域'] before = df[cols].memory_usage(deep=True, index=False) # int64 を int32 へ(最大 1,400 万人なので int32 の上限 21 億に収まる) df['総人口'] = df['総人口'].astype('int32') # float64 を float32 へ(精度が許せば。有効桁は約 7 桁になる) df['高齢化率'] = df['高齢化率'].astype('float32') # object → category:値の種類が少ない列ほど効く df['地域'] = df['地域'].astype('category') # 47 行で 4 種類 df['都道府県'] = df['都道府県'].astype('category') # 47 行で 47 種類(全部違う) after = df[cols].memory_usage(deep=True, index=False) print(pd.DataFrame({'変換前(B)': before, '変換後(B)': after, '差(B)': after - before})) print(f'4 列の合計: {before.sum()} B → {after.sum()} B') |
💬 総人口の int32 化と高齢化率の float32 化は、それぞれ 376 B → 188 B とちょうど半分になる(47 行 × 8 B が × 4 B に)。地域列は 4 種類しかないので category にすると 3,358 B → 537 B と大きく縮むが、47 県すべてが違う都道府県列は 3,390 B → 4,988 B とかえって 1,598 B 増えた。category は「種類の少ない文字列」にだけ効く。4 列の合計は 7,500 B → 5,901 B と縮んだが、その大半は地域列の 2,821 B で、都道府県列の増加 1,598 B を差し引いた結果なので、合計だけでなく列ごとの前後を比べる。
(3) ストリーミング圧縮(巨大ファイルでメモリ節約):
1 2 3 4 5 6 7 8 9 | import gzip, shutil # 大きな CSV を gzip 圧縮 with open('large.csv', 'rb') as f_in: with gzip.open('large.csv.gz', 'wb', compresslevel=6) as f_out: shutil.copyfileobj(f_in, f_out) # pandas で直接読める df = pd.read_csv('large.csv.gz', encoding='utf-8') |
⚠️ よくある落とし穴
⚠️ 落とし穴(さらに)
⚠️ Lossless vs Lossy — どちらを選ぶか
Lossless(可逆圧縮)
- 用途:テキスト、 ソースコード、 CSV、 医療画像、 金融データ、 公文書
- 代表:gzip / bz2 / xz / Brotli / Zstandard、 PNG / FLAC
- 原則:1 ビットも失わず復元可能
- SSDSE-B-2026 のような統計データ:必ず lossless(数値が変わったらデータでない)
Lossy(非可逆圧縮)
- 用途:写真、 動画、 音声、 ストリーミング
- 代表:JPEG / WebP / HEIC、 MP3 / AAC / Opus、 H.264 / H.265 / AV1
- 原則:人間の知覚で気づかない情報を捨てて高圧縮
- 注意:医療診断、 機械学習の前処理で lossy 画像を使うとモデル性能が落ちることがある
数値データの「lossy 化」
SSDSE のような整数データに lossy 圧縮を適用するのは原則 NG だが、 機械学習用の特徴量化済みデータでは:
- FP32 → FP16 (BFloat16) で半分のサイズ、 ニューラルネットワーク学習で標準
- INT8 量子化 → 1/4 サイズ、 推論専用モデルで標準
- K-means 量子化 → ベクトルを代表点に丸める、 オートエンコーダの離散版
SSDSE-B-2026 で確かめる — 有効数字を削るとどれだけ小さくなり、どれだけずれるか
「整数データに lossy 圧縮を適用するのは原則 NG」の理由を、数値 109 列すべてを有効数字 k 桁に丸める実験で数字にしました(丸めても値が変わらないものはそのまま)。
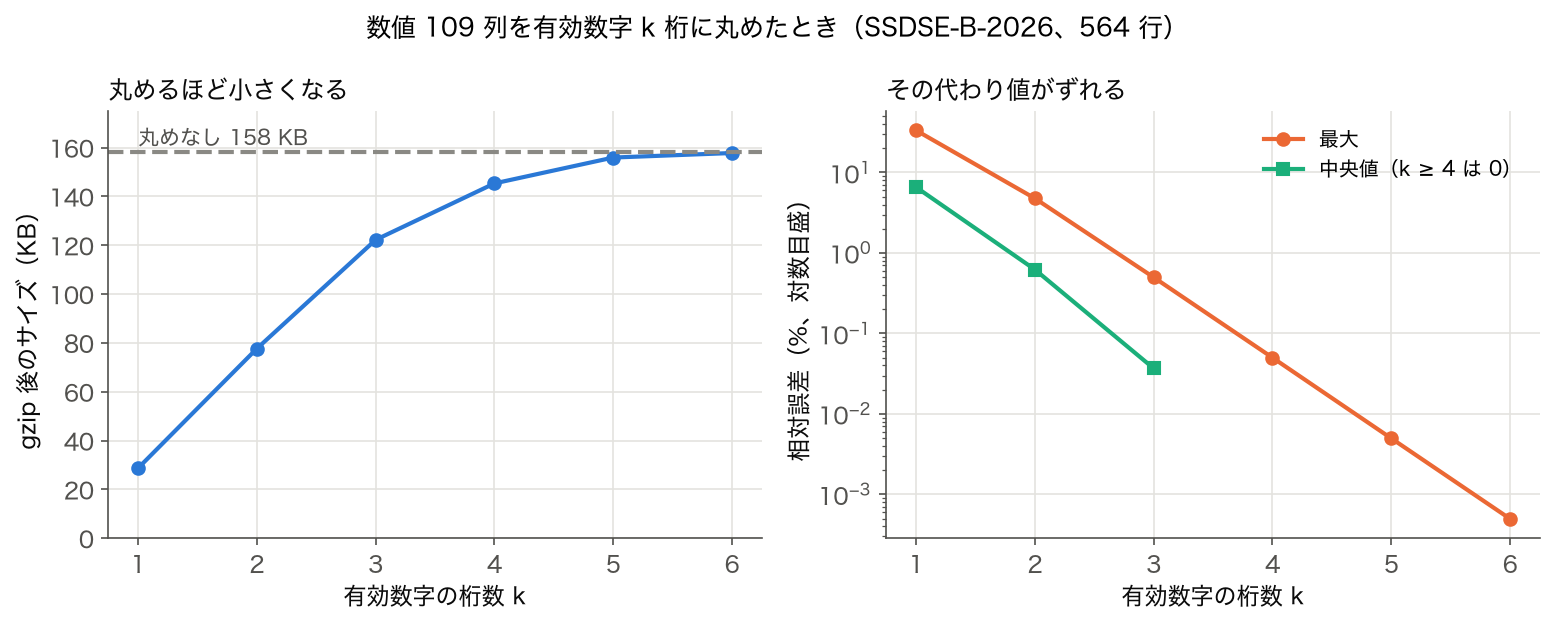
サイズを半分にするには有効数字 2 桁まで削る必要があり、そのとき値の 88.8% が変わって、最大 4.8% ずれます。人口の前年差(数千〜数万人)のような小さな変化は 2 桁の丸めで消えてしまうので、差分や増減率を計算する統計データでは致命的です。一方、k = 5 まで残すとサイズは 98.7% とほとんど縮みません。可逆圧縮(図 1 の並べ替え+差分で 73.6%)のほうが、誤差ゼロで lossy の k = 4(92.0%)より小さくできる、というのがこの実験の結論です。
⚠️ 圧縮率 vs 速度 — 実務での選択基準
| アルゴリズム | 圧縮率 | 圧縮速度 | 展開速度 | 推奨用途 |
|---|---|---|---|---|
| LZ4 | ★ | ★★★★★ | ★★★★★ | リアルタイム、 メモリ内圧縮 |
| Snappy | ★ | ★★★★★ | ★★★★★ | Parquet / Hadoop デフォルト |
| Zstd (default) | ★★★ | ★★★★ | ★★★★★ | 汎用、 最新標準(推奨) |
| gzip | ★★★ | ★★★ | ★★★★ | Web / Linux で最広範 |
| Brotli | ★★★★ | ★★ | ★★★★ | Web フォント、 静的 HTML |
| bz2 | ★★★★ | ★★ | ★★ | アーカイブ(やや遅い) |
| xz / lzma | ★★★★★ | ★ | ★★★ | 配布パッケージ、 長期保存 |
| Zstd (max) | ★★★★★ | ★ | ★★★★ | 最強圧縮(圧縮 1 回・展開多数) |
よくある選択基準
- ネットワーク転送:gzip(ブラウザ標準)か Brotli(HTTP 2.0 標準)
- ディスク保存(頻繁にアクセス):Zstd 標準
- ディスク保存(アーカイブ):xz
- データレイク(Parquet):Snappy(デフォルト)または Zstd
- DB のページ圧縮:LZ4(PostgreSQL TOAST など)
⚠️ 圧縮の落とし穴 — 実務で踏みがちな罠
- ランダムデータは圧縮不可:暗号化済みファイル、 乱数列、 すでに圧縮済みのバイト列はほぼ圧縮できない。 「JPEG を再 zip しても小さくならない」のはこのため。
- 小さいファイルは効率悪い:数 KB のファイルでは圧縮ヘッダ・テーブルのオーバーヘッドで逆に大きくなることも。 多数の小ファイルは tar+gzip でまとめる。
- 浮動小数点の精度:FP64 をそのままテキスト化すると重複が少なく圧縮率悪。 必要な精度に丸めてから保存(df.round(6) など)すると 30-50% 削減できることがある。
- 整数 vs 浮動小数:SSDSE のような整数主体データは圧縮率高。 浮動小数主体だと尾数部がランダム的で圧縮率低。 列指向ストレージ + 整数 quantize の組み合わせが有効。
- 圧縮チェーン:複数アルゴリズムを直列で適用しても、 2 回目以降はほぼ効果なし。 zip + zip より xz 単発の方が小さい。
- JIT/学習データの圧縮:機械学習のミニバッチ毎に展開する場合、 圧縮率より展開速度を優先(LZ4/Snappy)。
- ハードウェアアクセラレーション:Intel QAT, ZSTD ハードウェア実装などで高速化可能だが、 対応環境を要確認。
- セキュリティ — CRIME / BREACH 攻撃:HTTPS + gzip 圧縮で、 圧縮率の変化からトークンを推測する攻撃あり。 認証情報を含む応答は圧縮しない、 または別途防御策が必要。
🎮 触って理解する
圧縮の本質は「冗長さ(繰り返し・偏り)を見つけて短く書き直す」こと。ここでは 3 つのミニ実験で、(1) 繰り返しが多いほど縮む、(2) 頻出文字ほど短い符号が割り当てられる、(3) 非可逆圧縮は「誤差と引き換えに」縮む、という 3 原理を手を動かして確認します。
実験 1:ランレングス符号化(RLE)ライブデモ
テキストを自由に編集してください。「同じ文字が続く区間」を「文字+回数」に置き換えるのが RLE です。繰り返しが多いほど縮み、バラバラだと逆に膨らむ(A→A1 と 2 文字になる)ことを体感できます。
A4B3C2D1実験 2:ハフマン符号 — 頻度で符号長が変わる
5 文字 A〜E の出現頻度をスライダーで変えると、ハフマン木がリアルタイムに組み替わります。頻出文字ほど木の浅い位置(短い符号)、稀な文字ほど深い位置(長い符号)に配置されるのが最適符号の原理です。平均符号長 L は必ず Shannon エントロピー H 以上、H+1 未満に収まります。
| 文字 | 頻度 | 符号 | 長さ |
|---|
100 文字書くと:固定長 300 bit → ハフマン ? bit(理論下限 ? bit)
実験 3:可逆 vs 非可逆 — 丸めの粗さと誤差のトレードオフ
滑らかな数値列(人工生成データ 64 点)を「刻み幅」で丸めると、値の種類が減ってエントロピー(=理論上の必要ビット数)が下がる代わりに、元の値との誤差(RMSE)が増えます。スライダーを右へ動かす(またはグラフ上を左右にドラッグする)と、非可逆圧縮の「圧縮率と情報損失のトレードオフ」を体感できます。
理論サイズ比:?(エントロピー比) / 誤差 RMSE:?
💡 実験から読み取るべきこと
- 直感:圧縮とは「冗長さを削る」こと。実験 1 で繰り返しの多いテキストほど縮んだのは、RLE が「連続」という冗長さを利用するから。実験 2 の頻度の偏りも冗長さの一種(偏り=低エントロピー)。
- 落とし穴 1(ランダムは縮まない):実験 1 の「ランダム生成」ボタンで確認できる通り、パターンのないデータは逆に膨らむことすらある。既に圧縮済みの zip/JPEG を再圧縮しても縮まないのは、圧縮後のデータが乱数に近い(高エントロピー)ため。
- 落とし穴 2(非可逆は戻せない):実験 3 で丸めた値は元に戻せない。JPEG を何度も保存し直すと劣化が蓄積するのはこのため。測定値・統計値には必ず可逆圧縮(gzip / zstd / Parquet)を使う。
- 発展(エントロピー限界):どの実験でも Shannon エントロピー H が「これ以上は縮まない」理論下限として現れた。詳細は 情報量・エントロピー を参照。実験 2 の L が H+1 未満に収まるのがハフマン符号の最適性。
- 発展(列指向圧縮):Parquet が CSV より縮むのは、列ごとにまとめると「同じ型・似た値が連続」して実験 1 と同じ状況が作れるから(辞書符号化+RLE+汎用圧縮の三段構え)。データレイク 設計の基本もここにある。
- 発展(zip の中身):zip / gzip の DEFLATE は「LZ77(実験 1 の一般化:過去の文字列参照)+ハフマン符号(実験 2)」の組み合わせ。本ページで触った 2 つの原理がそのまま実用アルゴリズムの部品になっている。
🗺 データ圧縮 概念マップ
データ圧縮 (data compression)
├── 可逆圧縮 (lossless)
│   ├── エントロピー符号化
│   │   ├── Huffman 符号 (1952)
│   │   ├── 算術符号 (1984)
│   │   └── 範囲符号化
│   ├── 辞書ベース
│   │   ├── LZ77 (1977)      ← gzip, DEFLATE
│   │   ├── LZ78 (1978)      ← UNIX compress, GIF
│   │   ├── LZW (1984)       ← TIFF
│   │   └── LZMA / LZMA2     ← xz, 7z
│   ├── BWT 系
│   │   └── BWT + MtF + RLE  ← bzip2
│   └── 速度優先
│       ├── Snappy           ← Hadoop, Parquet
│       ├── LZ4              ← Kafka, ClickHouse
│       └── Zstandard        ← Linux, Facebook
├── 非可逆圧縮 (lossy)
│   ├── 画像: JPEG / WebP / AVIF / HEIC
│   ├── 音声: MP3 / AAC / Opus
│   ├── 動画: H.264 / H.265 / AV1 / VP9
│   └── 数値: FP16, INT8, K-means 量子化
└── 列指向ストレージ (Parquet, ORC, Arrow)
    ├── 列単位圧縮(型ごとに最適化)
    ├── Dictionary encoding
    ├── Run-Length Encoding
    └── Bit-packing
🔗 隣接手法への橋渡し
データ圧縮は情報理論と AI モデルの橋渡し。
形式選択 (CSV/Parquet) → 圧縮アルゴリズム選択 (gzip/snappy/zstd) → パーティション設計 → 検証の流れで、 圧縮率と速度の両立を測る。
🌳 手法選択フロー
データ圧縮は可逆/非可逆の判定 → アルゴリズム選択 → モデル圧縮への拡張で考える。
- 可逆圧縮が必要か? Yes → ハフマン符号、 No → LZ77 を先に確認
- 非可逆で十分か? Yes → JPEG、 No → MP3 を先に確認
- モデル圧縮も視野か? Yes → モデル圧縮、 No → 量子化 を先に確認
アーカイブなら gzip、 解析中間ファイルなら snappy、 列指向なら Parquet + zstd、 と「アクセス頻度と圧縮率」で選ぶ。
🧭 解説深化 — 圧縮を「ものさし」として使う(NCD と MDL)
ここまでのセクションは圧縮を「容量を減らす道具」として扱ってきた。この深化セクションでは視点を反転させ、圧縮後のサイズそのものを測定値として使うという、本ページの他の節では扱っていない使い方を紹介する。圧縮器は「データの規則性を探すエンジン」なので、その出力サイズは データの複雑さ・データ同士の類似度 の実用的な推定量になる。
💡 直感
圧縮サイズ C(x) は、計算不能なコルモゴロフ複雑性(このページの「数式」節参照)の実行可能な近似である。ここから面白い性質が出る: 2 つのデータ x, y を連結して圧縮したとき、共通パターンがあれば圧縮器は 2 回目の出現を「参照」で済ませられるので C(xy) は C(x)+C(y) よりずっと小さくなる。この「浮いた分」を正規化したのが正規化圧縮距離 NCD(Cilibrasi & Vitányi, 2005):
NCD(x, y) = ( C(xy) − min(C(x), C(y)) ) / max(C(x), C(y))
特徴量設計もモデルも距離関数の設計も不要で、「gzip や bz2 に突っ込むだけ」で任意のデータ間の類似度が出る。実際に SSDSE-B-2026.csv(2012–2023 年、47 都道府県パネル)から 7 都府県分の全 109 数値列 × 12 年をカンマ区切りテキスト化し、bz2 (level 9) で NCD を実測した結果(Python で実測・転記):
| 順位 | ペア | NCD(bz2 実測) | 解釈 |
|---|---|---|---|
| 最小(最も似ている) | 鳥取県 – 島根県 | 0.959 | 隣接する山陰の小規模県ペア |
| 2 位 | 秋田県 – 島根県 | 0.967 | 人口減少の進む小規模県同士 |
| 3 位タイ | 秋田県 – 鳥取県 / 神奈川県 – 大阪府 | 0.970 | 小規模県同士・大都市圏同士 |
| 5 位 | 東京都 – 神奈川県 | 0.975 | 首都圏ペア |
| 最大(最も遠い) | 東京都 – 鳥取県 | 0.988 | 最大規模と最小規模の都県 |
ラベルも教師データも与えていないのに、「規模と構造が近い県ほど NCD が小さい」という妥当な順位が出た(比較 7 都府県: 東京・神奈川・大阪・秋田・青森・鳥取・島根、全 21 ペア中の抜粋)。数値が桁の並びとして共有されるほど連結圧縮が効く、という仕組みがそのまま類似度になっている。
1 2 3 4 5 6 7 8 9 | import pandas as pd, bz2 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cols = [c for c in df.columns if c not in ('SSDSE-B-2026','Code','Prefecture')] def pref_bytes(p): sub = df[df['Prefecture']==p].sort_values('SSDSE-B-2026') return '\n'.join(','.join(str(r[c]) for c in cols) for _, r in sub.iterrows()).encode() def C(b): return len(bz2.compress(b, 9)) def ncd(x, y): return (C(x+y) - min(C(x), C(y))) / max(C(x), C(y)) print(ncd(pref_bytes('鳥取県'), pref_bytes('島根県'))) # 0.959(実測) |
💬 鳥取県と島根県の 12 年度分(それぞれ約 6.8 KB)の NCD は 0.959 で、1 に近いほど「まとめて圧縮しても得をしない=似ていない」を意味する。比較のため鳥取県同士で計算しても 0.36 で 0 にならず、東京都とは 0.988、北海道とは 0.979。数 KB の小さな入力では bz2 の固定的なオーバーヘッドが大きく、値が 0.96〜0.99 の狭い範囲に詰まるので、隣県が「わずかに近い」程度にしか区別できない。
⚠️ 落とし穴(重要)
- NCD(x, x) は 0 にならない。 理論上は同一データの距離 0 だが、実在の圧縮器は理想的でない。実測では東京都データ同士の NCD(x, x) = 0.372(bz2)。bz2 はブロック単位で処理するため、連結しても 2 個目を完全には「参照」しきれない。NCD の絶対値ではなく相対的な順位だけを使うこと。
- 短いデータでは完全に壊れる。 上と同じ都府県で、総人口 (A1101) の 12 年分だけ(1 県あたり約 90–110 バイト)に絞って NCD を実測すると、東京–神奈川 0.451、東京–秋田 0.451、東京–鳥取 0.427 となり、増加都市ペアと減少県ペアの区別がつかないどころか順位が逆転する。圧縮ヘッダや符号表のオーバーヘッドが数十バイトあり、データ本体より固定費が支配するため。NCD は最低でも数 KB 規模のデータで使う。
- どの圧縮器を使うかで結論が変わる。 A1101 列全 564 行をテキスト化して「都道府県コード×年で整列」と「シャッフル (seed=42)」を比較した実測: zlib (level 9) は整列 1,499 バイト vs シャッフル 1,590 バイトで並び順に敏感だが、bz2 (level 9) は 1,404 vs 1,397 バイトとほぼ無反応(元テキスト 4,408 バイト)。bz2 は内部の Burrows-Wheeler 変換が自分で並べ替えてしまうため、行順序の情報を「見ない」。測りたい構造をその圧縮器が検出できるかを先に確認すること。
- ウィンドウ幅の外は見えない。 gzip (DEFLATE) の参照窓は 32KB。連結した 2 つのデータの類似部分が 32KB 以上離れると検出されず、NCD が不当に大きく出る。大きなデータには zstd の long モードや bz2/xz など窓の広い圧縮器を使う。
🚀 発展
- MDL(最小記述長)原理: 「良いモデルとはデータを最も短く圧縮するモデルである」という統計的モデル選択の原理(Rissanen, 1978)。総記述長 = モデル自体の記述長 + そのモデルの下でのデータの記述長、を最小化する。複雑なモデルはデータ項を縮めるがモデル項が膨らむ——これは情報量規準(AIC/BIC)と同じ過学習抑制の構造で、BIC は MDL の近似形として導出できる。「圧縮=理解」という視点の、統計モデリング側の対応物。
- gzip でテキスト分類: Jiang et al. (2023, ACL Findings) は「gzip の NCD + k 近傍法」だけの分類器が低リソース設定でニューラルモデルに匹敵すると報告し話題になった。ただしその後の再検証で、評価方法(タイブレークの扱い)により精度が過大に見積もられていたとの指摘があり、主張はやや割り引かれている。「前処理ゼロの強力なベースライン」として使うのが現在の妥当な位置づけ。
- 圧縮によるクラスタリング: NCD の距離行列をそのまま階層クラスタリングに与えると、言語系統樹・ゲノム分類・楽曲ジャンル分類などが特徴量設計なしで再現できることが知られている(Cilibrasi & Vitányi の原論文のデモ)。上の都道府県 NCD 表も、47 県すべてで距離行列を作ればデンドログラムにできる。
- 異常検知への応用: 正常データで「辞書を温めた」圧縮器に新規データを追記圧縮し、圧縮率が急に悪化した点を異常とみなす手法。モデル学習なしで使えるため、ログ監視やセンサー監視の軽量ベースラインになる。